Solana HFT 低延遲架構
資料不斷到達,應用程式用於決策的價格卻仍然過時。在 Solana HFT 應用程式中,既要檢查計算本身花費的時間,也要檢查已接收的資料在參與決策之前等待了多久。之前的更新可能還在等待處理,某次日誌寫入可能尚未完成,另一個市場的更新也可能正在持有鎖。程式碼的組織方式會改變這些等待。
本文透過五種模式,追蹤收到的資料在哪裡等待,以及設計改變後哪些工作可以繼續向前推進。你也可以從與自己應用程式相符的症狀入手,直接閱讀對應章節。
| 應用程式中出現的現象 | 需要檢查的設計 |
|---|---|
| 應用程式執行越久,未處理的資料越多 | 1. 到達速率、處理速率與等待上限 |
| 儲存紀錄時,無法處理下一個價格 | 2. 將決策必需的工作與分析日誌分離 |
| 市場A的更新讓市場B的更新等待 | 3. 拆分保護獨立狀態的鎖 |
| 每次資料到達都重複相同的準備工作 | 4. 提前準備不變的部分並重複使用 |
| 連線恢復後,決策仍然使用舊值 | 5. 區分連線恢復與決策狀態恢復 |
每一節末尾都提供可複製的指令,用來將相應改善套用到你的應用程式。可以把它交給能夠讀取專案程式碼的 AI 代理。
圖中的資料條數、價格、操作次數和持續時間都是用於說明的模型,不代表實測效能或交易結果。
點選圖解即可開啟原始尺寸圖片。
1. 對比到達量與處理能力,並設定等待上限
假設應用程式在每個等長的時間區間內接收六個事件,並能處理其中兩個。第一個區間結束時,還有四個事件未處理。資料等待處理的地方就是佇列。
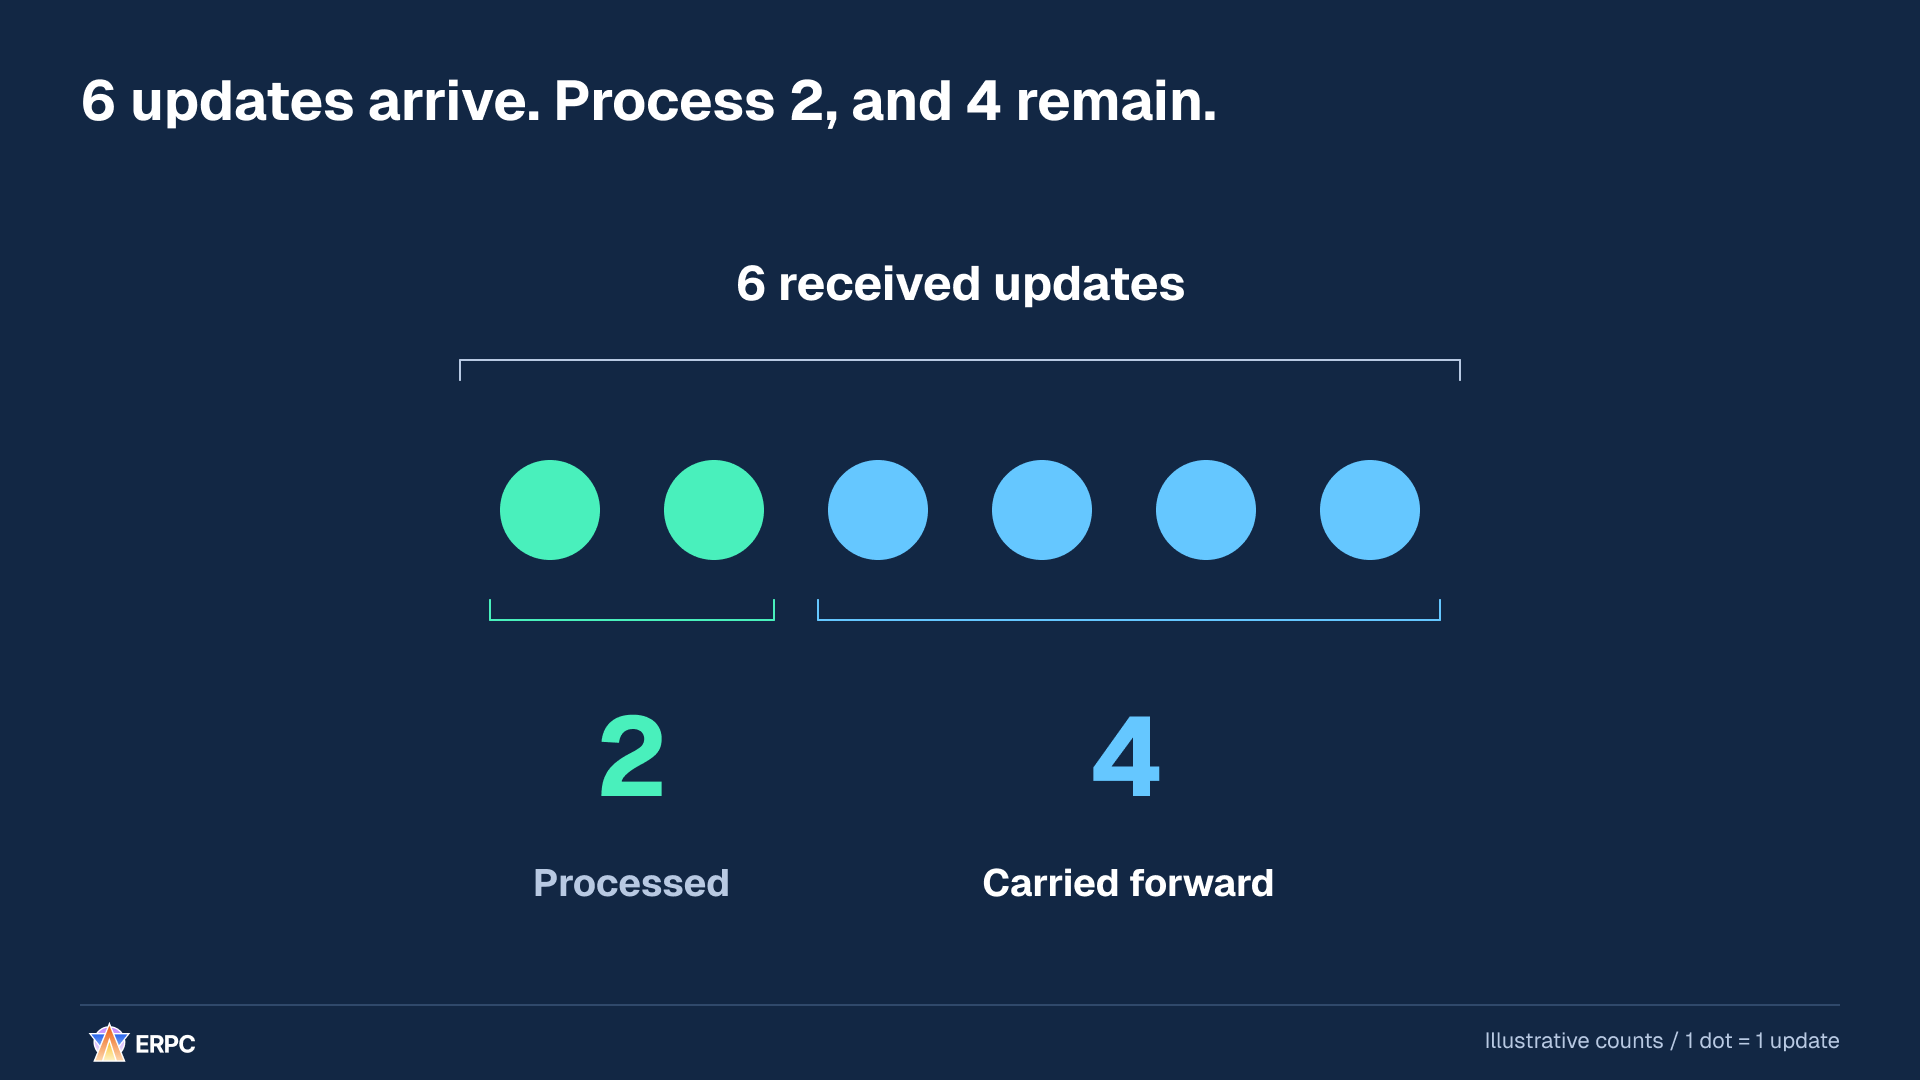
處理工作正在推進,但仍有四個事件尚未用於決策。
現在按相同的比例,將到達量放大到60,000個事件。處理20,000個後,還剩40,000個等待。圖的右側每個點代表100個事件,每組100個點代表10,000個事件。兩組已處理,四組仍在等待。
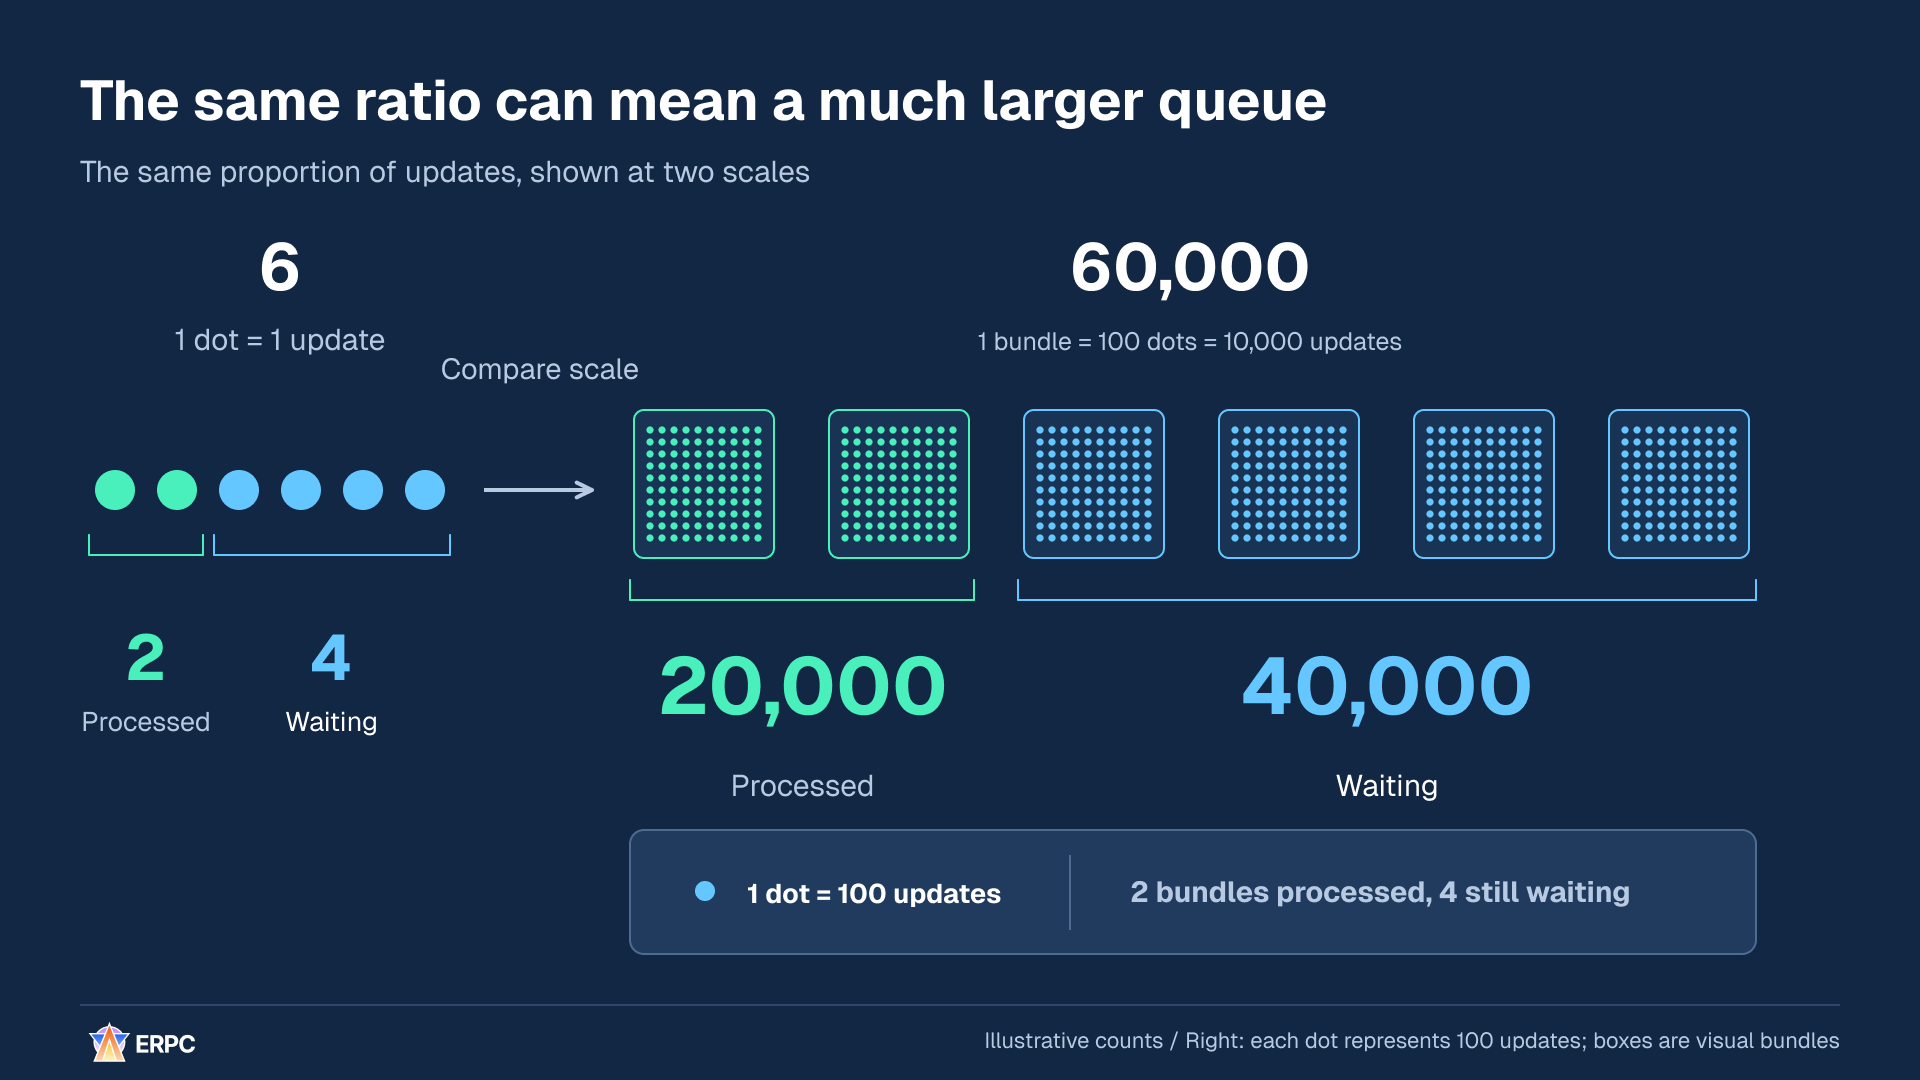
右側的分組用於表示資料量,並不代表應用程式按這些批次進行處理。
下一個區間開始時,已有40,000個事件在等待。又到達60,000個,處理20,000個後,剩下80,000個。再下一個區間結束時,積壓達到120,000個。新到達的價格必須排在佇列中已有的工作之後等待。
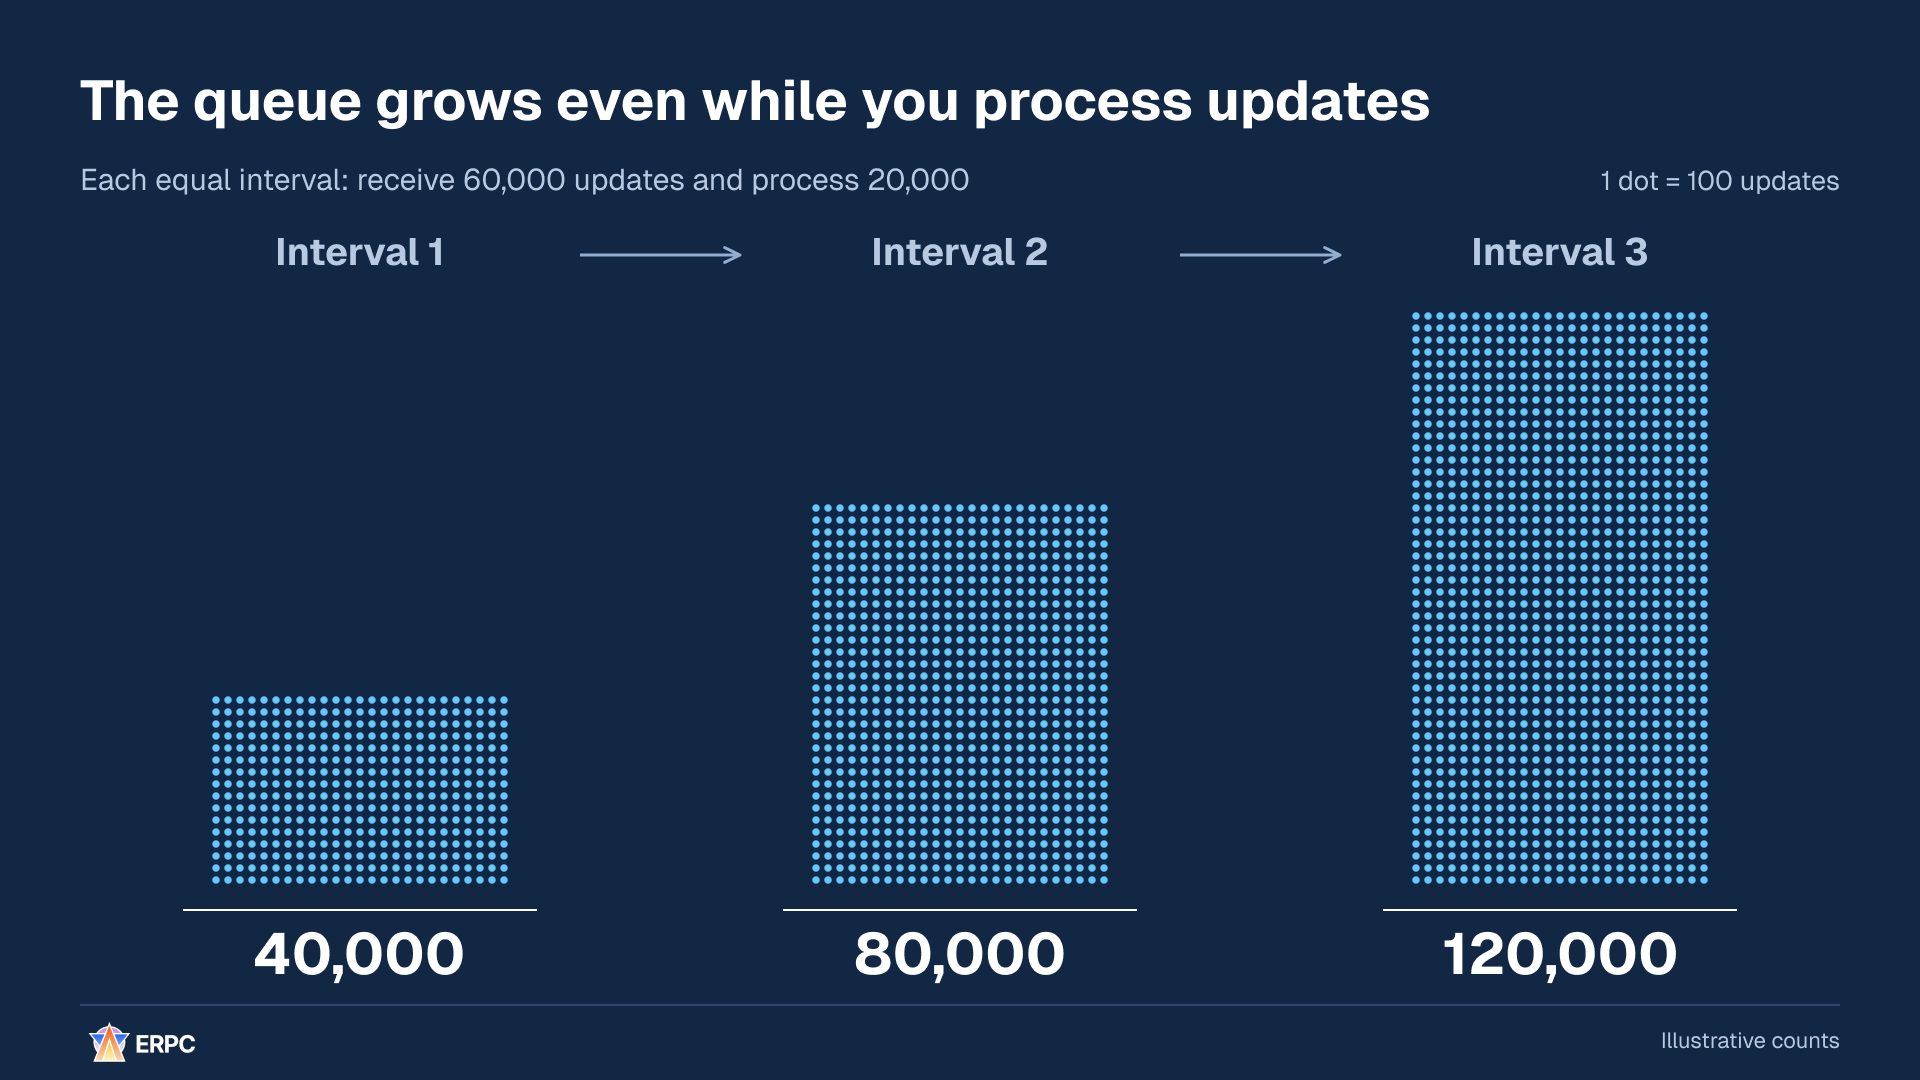
只要到達量持續超過處理能力,積壓就會不斷增長。
佇列有助於吸收突發流量,也就是資料在短時間內集中到達的情況。增大佇列容量,無法解決本例中這種持續的處理能力不足。除了保留的條目數和位元組數,還應觀察最舊條目已等待多久,並設定可接受的上限。如果已不滿足所需的新鮮度,即使沒有遺失更新,也應暫停依賴這些值的新交易決策。
達到上限後應該怎樣處理?下一張圖中,八個可用位置全部佔滿後,又到達了兩個更新。如果這兩個更新無法保留,而且是決策所必需的,應用程式就無法正確更新自己儲存的值。應暫停依賴這些值的新交易決策,待所需更新恢復後再繼續。
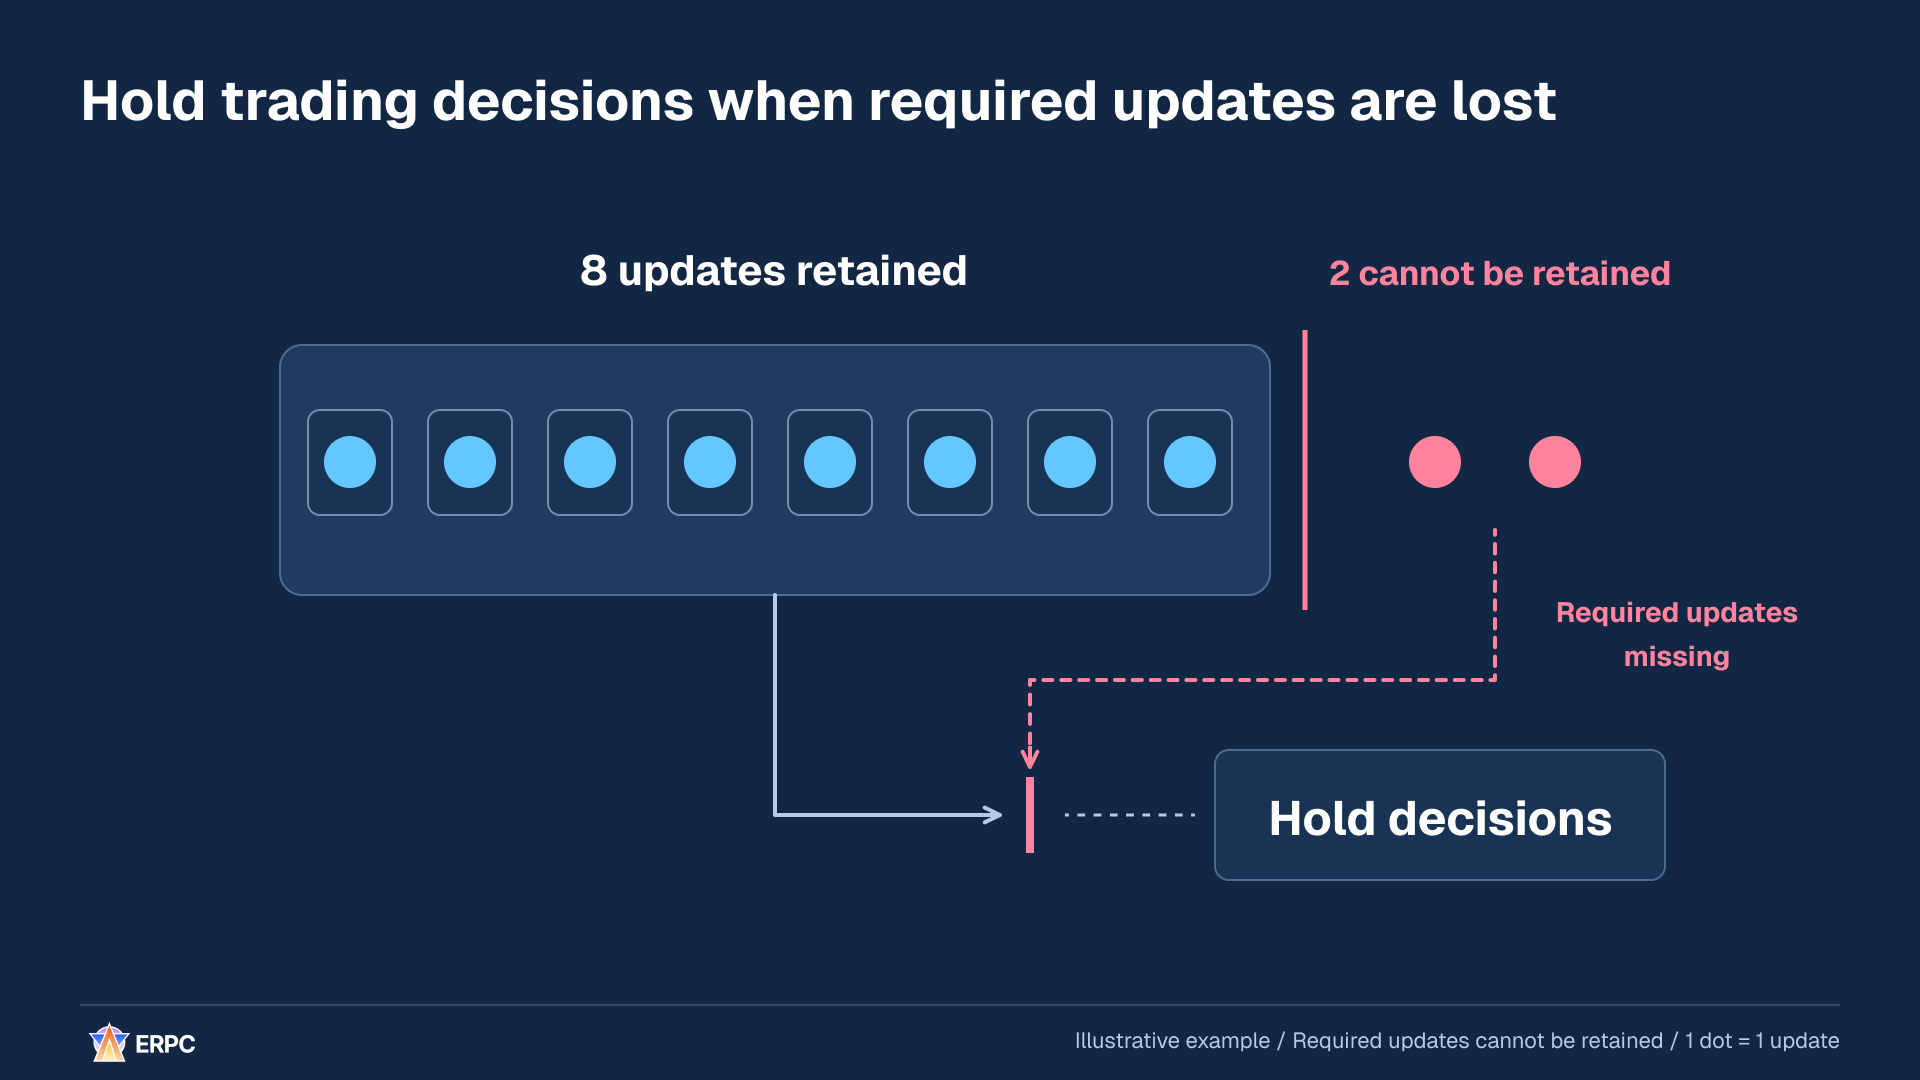
佇列設計也必須明確達到上限之後的行為。
檢查能否減少工作量或提高處理能力。如果消費者只需要同一物件最新的完整狀態,可能可以將中間值合併為最新值。但如果處理過程需要累積增量或使用中間事件,省略更新就會改變結果。
暫停接收也可能只是把等待移到上游。應結合 gRPC 流量控制、縮小訂閱資料範圍的伺服器端過濾器,以及應用程式實際的處理能力一起考慮。gRPC 流量控制用於調節傳送和接收的節奏。[3][4]
如果希望改善接收佇列的積壓與資料新鮮度,可以複製以下指令。
text
改善這個應用程式在處理能力跟不上接收量、決策所用資料變舊時的輸入處理方式。

閱讀 README、開發指令、相依項目,以及接收 → 佇列 → 狀態更新 → 決策的程式碼。使用既有語言、執行環境與 SDK。確認更新包含完整狀態還是增量、必需的套用順序,以及新鮮度要求。

1. 儲存不含機密資訊、可重現的輸入,並記錄改動前的基準值。也要檢查進入佇列之前的等待。測量同一時間區間內流入與流出的項目數及位元組數、積壓工作量、最舊等待項目已等待的時間,以及正在執行的工作量。
2. 定義並實作項目數、位元組數、等待時間與同時執行數的上限,說明每項上限的依據。要求不明確時應說明假設。檢查能否減少不必要的接收或處理,以及處理能力是否足夠。不要把單純擴大佇列視為解決持續處理能力不足的方法。
3. 定義佇列已滿時的行為。如果無法保留必需更新,或即使沒有遺失更新也失去了必需的新鮮度,應暫停依賴這些值的新交易決策。繼續更新及恢復狀態,並確認恢復決策的條件。
4. 如果合併中間值,應確認同一對象最新的完整狀態足以維持結果。不要悄悄捨棄必需的增量或事件。如果暫停接收,應檢查提供方的流量控制行為,以及等待會轉移到哪裡。
5. 在相同條件下重播正常輸入、突發流量、持續超載與佇列滿後的恢復。比較到達率與處理率、最舊項目已等待的時間、從接收到決策完成的 p50/p95/p99、CPU 與記憶體、遺漏或捨棄的更新。將已套用的狀態及決策與預期結果核對。單一主機內的經過時間應使用單調時鐘,並說明測量的起點與終點。

沿用既有核准、權限與開發流程。不要僅憑這些指令,就認為取得了修改正式環境、簽訂付費合約或進行真實交易的額外權限。不要輸出私鑰、驗證資訊或客戶資料。

最後回報改動、比較條件、改動前後的測量值、正確性檢查與剩餘限制。無法測量的值應標示為未測量。
改善這個應用程式在處理能力跟不上接收量、決策所用資料變舊時的輸入處理方式。
閱讀 README、開發指令、相依項目,以及接收 → 佇列 → 狀態更新 → 決策的程式碼。使用既有語言、執行環境與 SDK。確認更新包含完整狀態還是增量、必需的套用順序,以及新鮮度要求。
1. 儲存不含機密資訊、可重現的輸入,並記錄改動前的基準值。也要檢查進入佇列之前的等待。測量同一時間區間內流入與流出的項目數及位元組數、積壓工作量、最舊等待項目已等待的時間,以及正在執行的工作量。
2. 定義並實作項目數、位元組數、等待時間與同時執行數的上限,說明每項上限的依據。要求不明確時應說明假設。檢查能否減少不必要的接收或處理,以及處理能力是否足夠。不要把單純擴大佇列視為解決持續處理能力不足的方法。
3. 定義佇列已滿時的行為。如果無法保留必需更新,或即使沒有遺失更新也失去了必需的新鮮度,應暫停依賴這些值的新交易決策。繼續更新及恢復狀態,並確認恢復決策的條件。
4. 如果合併中間值,應確認同一對象最新的完整狀態足以維持結果。不要悄悄捨棄必需的增量或事件。如果暫停接收,應檢查提供方的流量控制行為,以及等待會轉移到哪裡。
5. 在相同條件下重播正常輸入、突發流量、持續超載與佇列滿後的恢復。比較到達率與處理率、最舊項目已等待的時間、從接收到決策完成的 p50/p95/p99、CPU 與記憶體、遺漏或捨棄的更新。將已套用的狀態及決策與預期結果核對。單一主機內的經過時間應使用單調時鐘,並說明測量的起點與終點。
沿用既有核准、權限與開發流程。不要僅憑這些指令,就認為取得了修改正式環境、簽訂付費合約或進行真實交易的額外權限。不要輸出私鑰、驗證資訊或客戶資料。
最後回報改動、比較條件、改動前後的測量值、正確性檢查與剩餘限制。無法測量的值應標示為未測量。2. 不必等紀錄儲存完成,就能處理下一個價格
假設某個市場的價格從100變為101。應用程式已將價格更新為100,完成決策,正在儲存一筆分析紀錄。如果處理輸入資料的迴圈要等這次儲存結束,那麼即使新的更新已經到達,它也無法套用101。應用程式儲存的價格仍然是100。
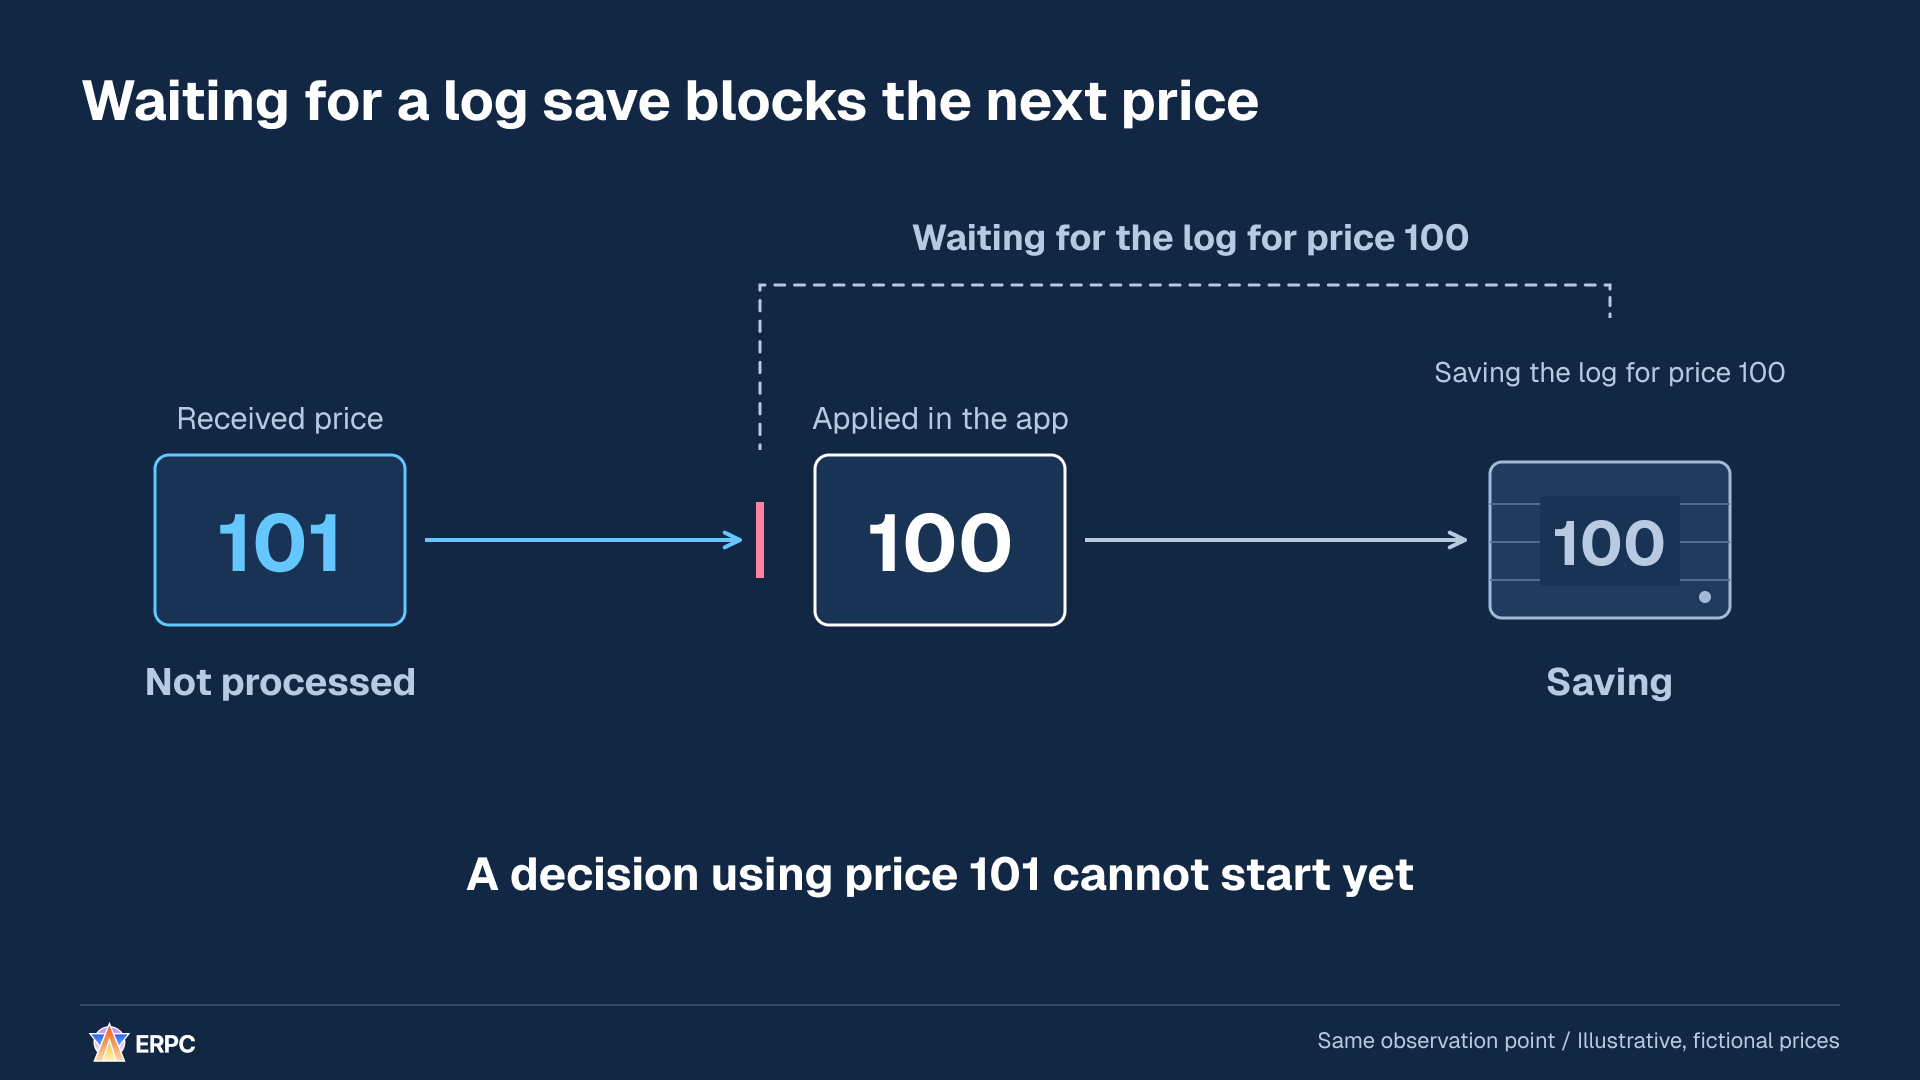
101無法開始處理的原因,是在等待100的紀錄儲存完成。
現在,把分析紀錄交給一個尚有容量的輔助佇列,再由獨立的處理操作負責儲存。交接完成後,接收迴圈就可以回到下一個輸入。在100的紀錄仍在儲存時,它已經可以套用101並開始決策。
下面的對比保持100的儲存時間、101的到達時間,以及處理101所需的時間相同。改變的是:是否必須等儲存結束,才能轉向下一個輸入。
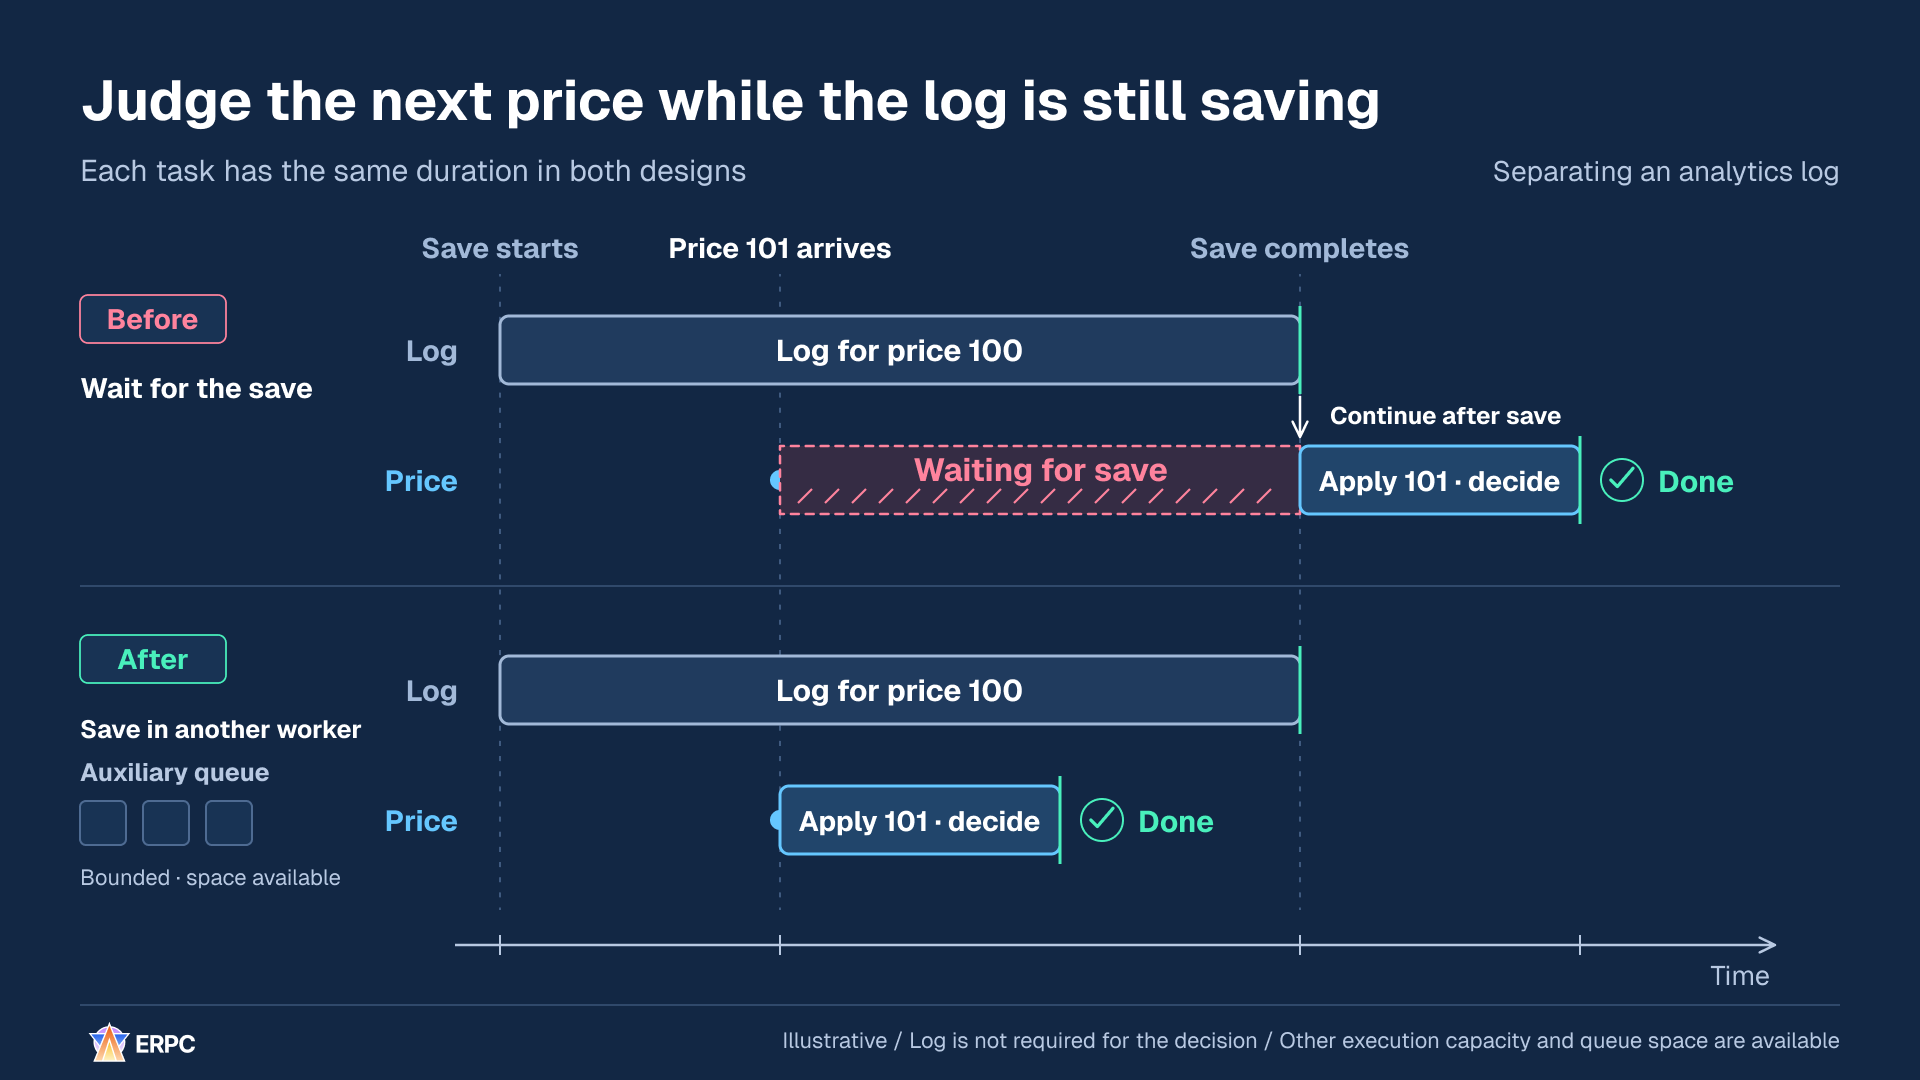
即使沒有縮短101本身的處理工作,也可以減少它開始之前的等待。
從接收資料到決策、再到提交所必經的處理路徑,稱為熱路徑(hot path)。本例將無需阻塞決策的分析日誌移出了這條路徑。餘額檢查、風險限額檢查,以及為了保證正確性必須完成的儲存,仍應放在需求規定的位置。
儲存工作依然存在,因此輔助佇列也需要容量和等待時間上限。獨立任務不一定執行在獨立的 CPU 上。Tokio 中長時間佔用 CPU 或發生阻塞的操作,以及 Node.js 事件迴圈中的長時間同步操作,都可能阻礙其他工作的推進。移動工作時,要確認它實際上在哪裡執行。[1][2]
如果希望將分析紀錄的儲存等待從決策路徑分離,可以複製以下指令。
text
改善這個應用程式中因等待分析紀錄儲存完成,而無法套用下一次更新或將其用於決策的問題。

閱讀 README、開發指令、相依項目與接收迴圈。使用既有語言、執行環境與儲存函式庫。找出等待儲存完成的位置,確認工作實際執行在哪些執行緒、任務或事件迴圈中。

1. 準備不含機密資訊、可重現的輸入。記錄接收、狀態套用、決策開始與完成、儲存開始與完成的時刻,以及目前結果。
2. 根據要求確認儲存完成是否為決策或恢復的前提。餘額檢查、風險檢查與正確性必需的持久化儲存,必須保留在需要的位置。分離那些可以稍後完成儲存的分析紀錄。
3. 定義紀錄的交接方式,防止後續狀態變化改變要記錄的值。實作有界輔助佇列與負責儲存的消費端。說明項目數、位元組數、等待時間上限;佇列滿、儲存失敗、重試與關閉時的行為;以及紀錄保留要求。在保留要求尚未明確時,不要捨棄紀錄。
4. 不要假設獨立的任務就會在另一顆 CPU 上執行。檢查同步 I/O 與長時間 CPU 工作實際在哪裡執行。如果使用 worker 等機制,應限制同時執行數,並將轉換、複製與交接等待納入評估。
5. 使用相同輸入與到達節奏,重現正常儲存、慢速儲存、失敗、輔助佇列已滿與關閉。比較從接收到決策完成的 p50/p95/p99、儲存端的等待與積壓、CPU 與記憶體、遺漏或重複紀錄。驗證狀態與決策的正確性,以及紀錄保留要求。單一主機內的經過時間應使用單調時鐘,並說明測量的起點與終點。

沿用既有核准、權限與開發流程。不要僅憑這些指令,就認為取得了修改正式環境、簽訂付費合約或進行真實交易的額外權限。不要輸出私鑰、驗證資訊或客戶資料。

最後回報改動、比較條件、改動前後的測量值、正確性檢查與剩餘限制。無法測量的值應標示為未測量。
改善這個應用程式中因等待分析紀錄儲存完成,而無法套用下一次更新或將其用於決策的問題。
閱讀 README、開發指令、相依項目與接收迴圈。使用既有語言、執行環境與儲存函式庫。找出等待儲存完成的位置,確認工作實際執行在哪些執行緒、任務或事件迴圈中。
1. 準備不含機密資訊、可重現的輸入。記錄接收、狀態套用、決策開始與完成、儲存開始與完成的時刻,以及目前結果。
2. 根據要求確認儲存完成是否為決策或恢復的前提。餘額檢查、風險檢查與正確性必需的持久化儲存,必須保留在需要的位置。分離那些可以稍後完成儲存的分析紀錄。
3. 定義紀錄的交接方式,防止後續狀態變化改變要記錄的值。實作有界輔助佇列與負責儲存的消費端。說明項目數、位元組數、等待時間上限;佇列滿、儲存失敗、重試與關閉時的行為;以及紀錄保留要求。在保留要求尚未明確時,不要捨棄紀錄。
4. 不要假設獨立的任務就會在另一顆 CPU 上執行。檢查同步 I/O 與長時間 CPU 工作實際在哪裡執行。如果使用 worker 等機制,應限制同時執行數,並將轉換、複製與交接等待納入評估。
5. 使用相同輸入與到達節奏,重現正常儲存、慢速儲存、失敗、輔助佇列已滿與關閉。比較從接收到決策完成的 p50/p95/p99、儲存端的等待與積壓、CPU 與記憶體、遺漏或重複紀錄。驗證狀態與決策的正確性,以及紀錄保留要求。單一主機內的經過時間應使用單調時鐘,並說明測量的起點與終點。
沿用既有核准、權限與開發流程。不要僅憑這些指令,就認為取得了修改正式環境、簽訂付費合約或進行真實交易的額外權限。不要輸出私鑰、驗證資訊或客戶資料。
最後回報改動、比較條件、改動前後的測量值、正確性檢查與剩餘限制。無法測量的值應標示為未測量。3. 不要讓獨立更新等待同一把鎖
假設應用程式可以獨立更新市場A和市場B的價格。A的更新開始後,B的更新到達。如果同一個 mutex 同時保護A和B,B就必須等A釋放這把鎖。
mutex 是互斥鎖,同一時刻只授予一個操作存取受保護資料的權利。如果其他操作正在使用它,試圖獲取同一把鎖的操作就需要等待。[17]
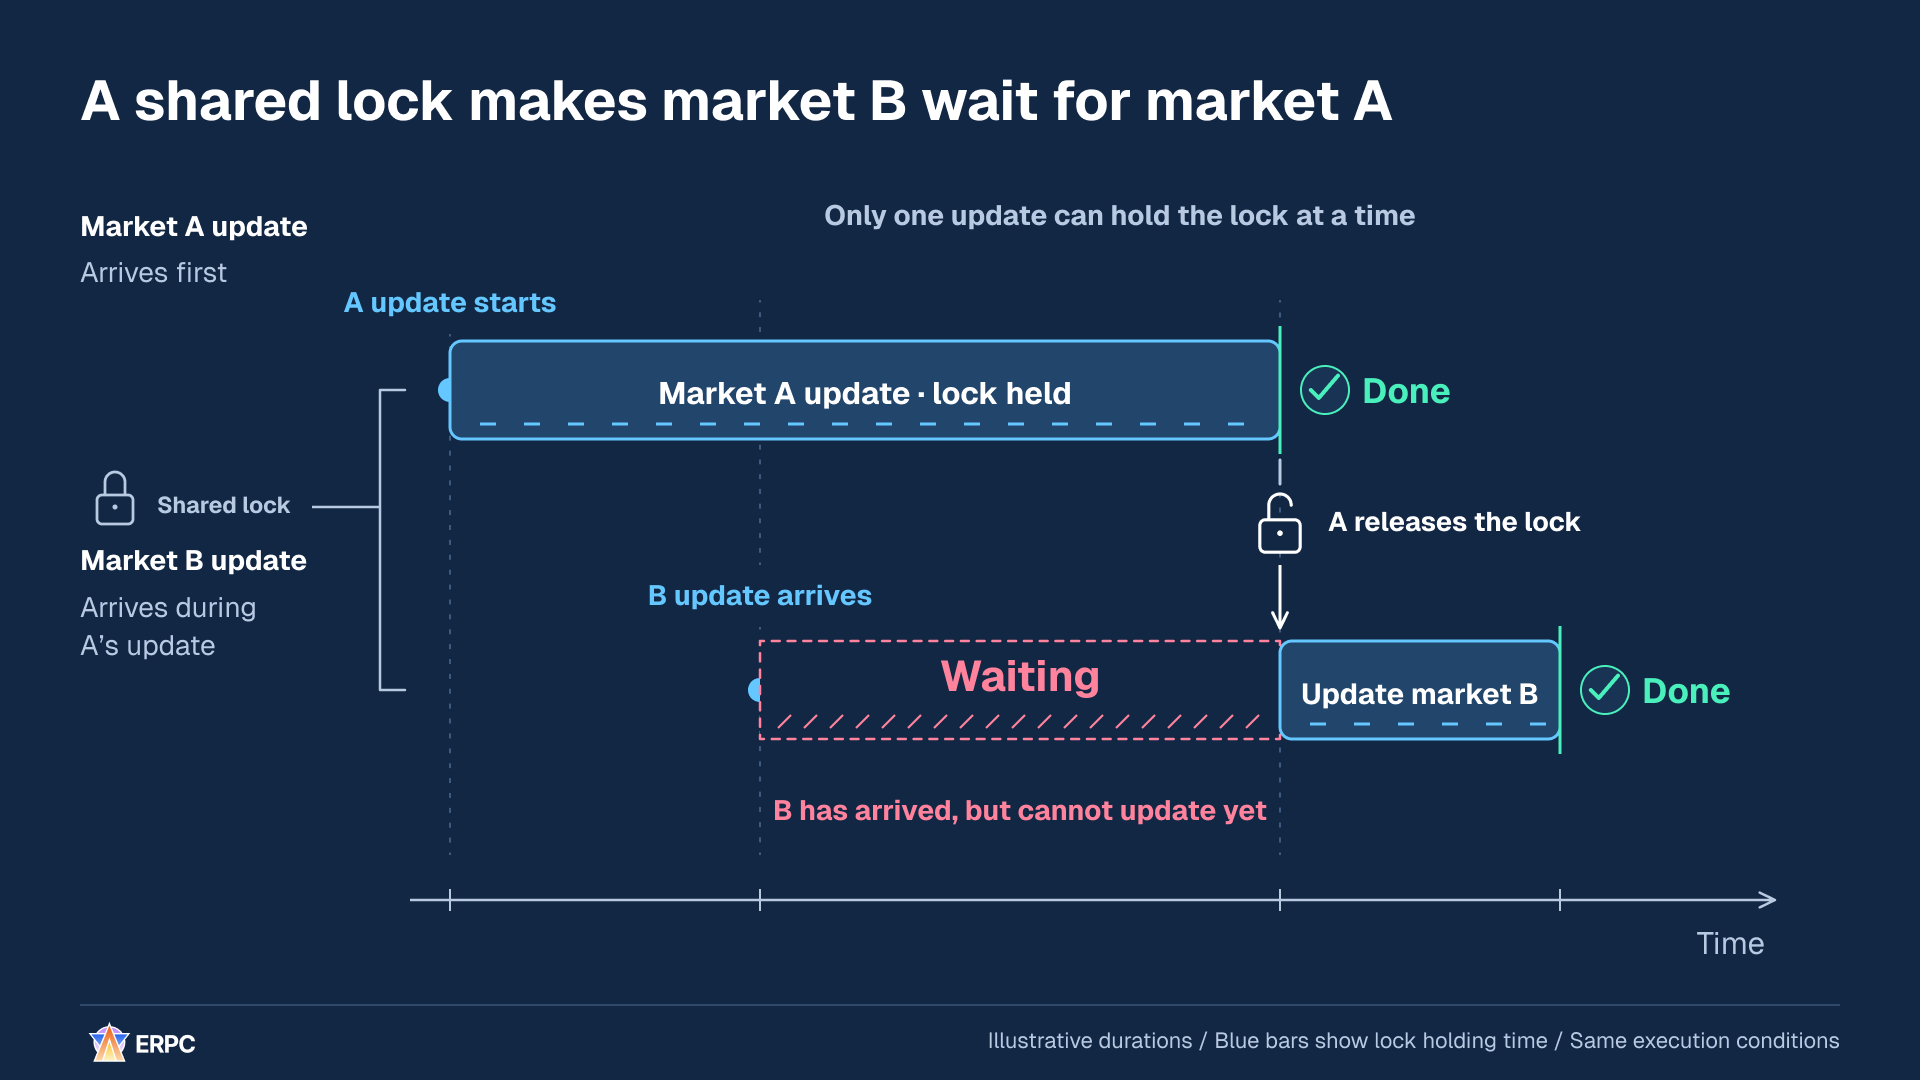
B的資料已經到達,卻在等待A持有的共享鎖。
如果A和B各自修改不同的值,一種選擇是用不同的鎖分別保護它們。下一張圖的上半部分使用共享鎖,下半部分使用獨立鎖。上下兩部分中,A和B的到達位置及持有鎖時間完全相同。本例假設B的鎖空閒,且有可用於執行B的處理能力。Tokio 官方教學也介紹了針對獨立鍵資料的 mutex 分片。[18]
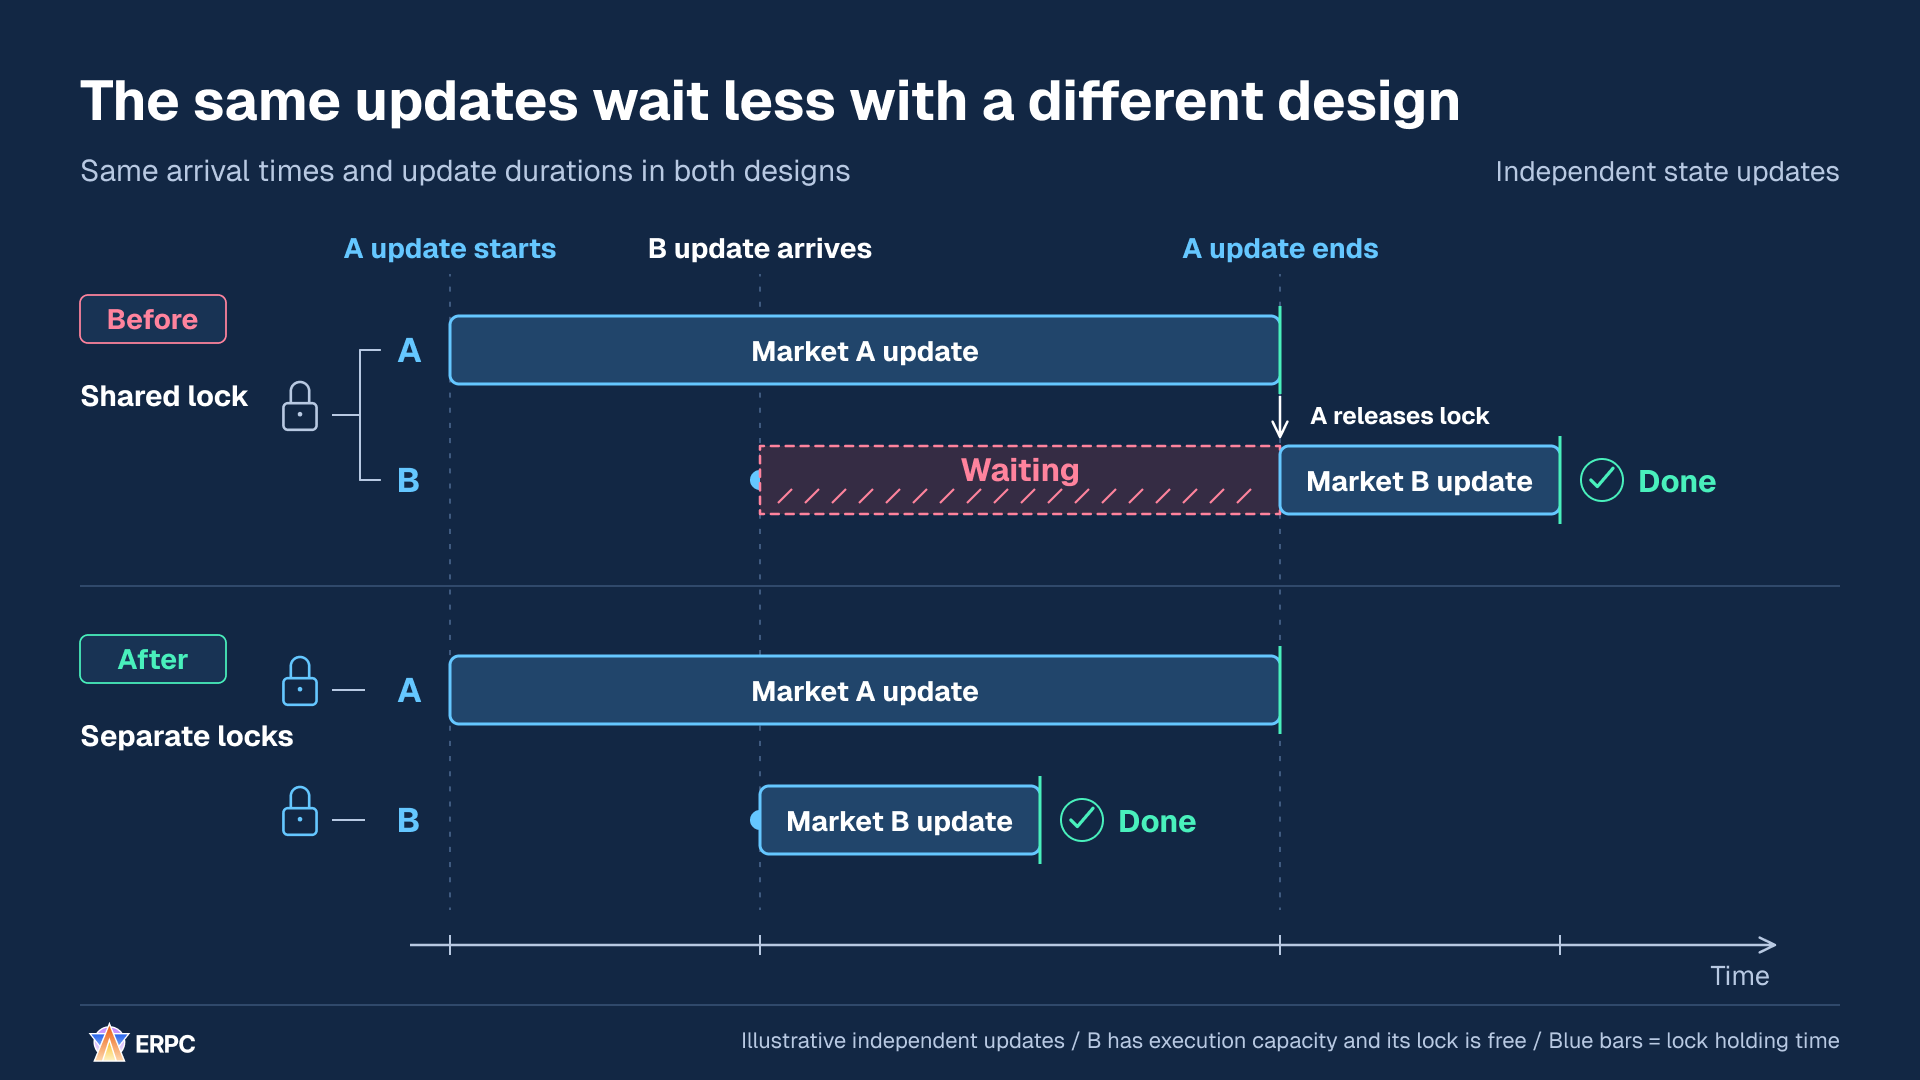
B的藍色條帶長度相同。消除的是它前面的粉色等待區間。
藍色條帶表示從取得鎖到釋放鎖的時間。本例中,A仍在更新時,B就已完成。拆分鎖無法消除B自己的鎖被佔用造成的等待,也無法消除其他工作佔滿可用執行資源造成的等待。
拆分鎖之前,先明確哪些更新相互獨立。即使A和B的價格可以分別更新,使用兩個價格或共享餘額的決策,仍需要一致地讀取所需值的機制。即使在同一執行緒上,操作在 await 處暫停期間,值也可能改變。應定義一次決策讀取哪些版本、如何讀取,以及更新按什麼順序套用。
例如,如果A和B讀取同一個餘額並各自建構訂單,兩者可能都打算使用同一筆資金。共享值仍需單獨保護,例如由一個唯一的擁有者依序為每個訂單檢查餘額並預留資金。
另一種選擇是讓每份狀態只有一個更新擁有者,再把更新訊息傳送給它。這就是 Single Writer 原則。拆分鎖與選擇單一寫入者是兩個獨立的設計決策。LMAX Disruptor 介紹了 Single Writer 和處理依賴關係,Tokio 則介紹了透過向專用任務傳送訊息來管理狀態。[5][18]
如果希望減少獨立更新之間的鎖等待,可以複製以下指令。
text
改善這個應用程式中某個市場或鍵的更新,讓另一個獨立更新等待同一把共享鎖的問題。

閱讀 README、開發指令、相依項目,以及讀寫狀態、取得鎖或透過 await 等待其他工作的程式碼。使用既有語言與執行環境。確認誰負責更新每個值,以及每次決策讀取哪些值的組合。

1. 儲存不含機密資訊、可重現的輸入,並記錄改動前的基準值。對於存在爭用的鎖,記錄各鍵的到達、取得等待、持有時間、更新順序,以及決策所用的狀態版本。
2. 區分可以獨立更新的值,與必須一起保護一致性的值。拆分保護獨立狀態的鎖,明確定義各鍵的套用順序與寫入責任。控制鎖或處理負責者的數量,避免無限增加。
3. 保護跨市場決策,以及共享餘額或資金預留。將餘額檢查與資金預留作為一個協調的操作確認,防止多個訂單各自假設同一筆資金都能使用。如果需要多把鎖,應定義取得順序。
4. 檢查 await 前後的狀態變化,以及平行解碼的完成順序。定義決策讀取哪些版本、如何讀取。不要讓解碼完成順序取代必需的套用順序。拆鎖後仍須檢查執行資源限制或同一鍵的爭用,是否繼續造成等待。
5. 使用相同輸入與到達順序,重播獨立鍵、單一鍵集中更新、共享資金預留競爭,以及工作暫停與恢復的情況。比較鎖等待、從接收到決策完成的 p50/p95/p99、CPU 與記憶體。驗證必需的更新順序、決策時狀態的一致性,以及沒有重複預留資金。單一主機內的經過時間應使用單調時鐘,並說明測量的起點與終點。

沿用既有核准、權限與開發流程。不要僅憑這些指令,就認為取得了修改正式環境、簽訂付費合約或進行真實交易的額外權限。不要輸出私鑰、驗證資訊或客戶資料。

最後回報改動、比較條件、改動前後的測量值、正確性檢查與剩餘限制。無法測量的值應標示為未測量。
改善這個應用程式中某個市場或鍵的更新,讓另一個獨立更新等待同一把共享鎖的問題。
閱讀 README、開發指令、相依項目,以及讀寫狀態、取得鎖或透過 await 等待其他工作的程式碼。使用既有語言與執行環境。確認誰負責更新每個值,以及每次決策讀取哪些值的組合。
1. 儲存不含機密資訊、可重現的輸入,並記錄改動前的基準值。對於存在爭用的鎖,記錄各鍵的到達、取得等待、持有時間、更新順序,以及決策所用的狀態版本。
2. 區分可以獨立更新的值,與必須一起保護一致性的值。拆分保護獨立狀態的鎖,明確定義各鍵的套用順序與寫入責任。控制鎖或處理負責者的數量,避免無限增加。
3. 保護跨市場決策,以及共享餘額或資金預留。將餘額檢查與資金預留作為一個協調的操作確認,防止多個訂單各自假設同一筆資金都能使用。如果需要多把鎖,應定義取得順序。
4. 檢查 await 前後的狀態變化,以及平行解碼的完成順序。定義決策讀取哪些版本、如何讀取。不要讓解碼完成順序取代必需的套用順序。拆鎖後仍須檢查執行資源限制或同一鍵的爭用,是否繼續造成等待。
5. 使用相同輸入與到達順序,重播獨立鍵、單一鍵集中更新、共享資金預留競爭,以及工作暫停與恢復的情況。比較鎖等待、從接收到決策完成的 p50/p95/p99、CPU 與記憶體。驗證必需的更新順序、決策時狀態的一致性,以及沒有重複預留資金。單一主機內的經過時間應使用單調時鐘,並說明測量的起點與終點。
沿用既有核准、權限與開發流程。不要僅憑這些指令,就認為取得了修改正式環境、簽訂付費合約或進行真實交易的額外權限。不要輸出私鑰、驗證資訊或客戶資料。
最後回報改動、比較條件、改動前後的測量值、正確性檢查與剩餘限制。無法測量的值應標示為未測量。4. 提前準備不變的部分,減少資料到達後的工作
假設每次價格更新,應用程式都會解析同一個固定ID,用相同輸入推導固定地址,並配置工作記憶體。這種工作記憶體也稱為緩衝區。重複進行這三項準備,就把處理不變資訊的時間放到了每次決策的路徑上。
輸入不變的準備工作,可以在資料到達前完成並重複使用。資料到達後,應用程式檢查本次事件中發生變化的資訊,建構最終要傳送的訊息,並對該內容簽章。
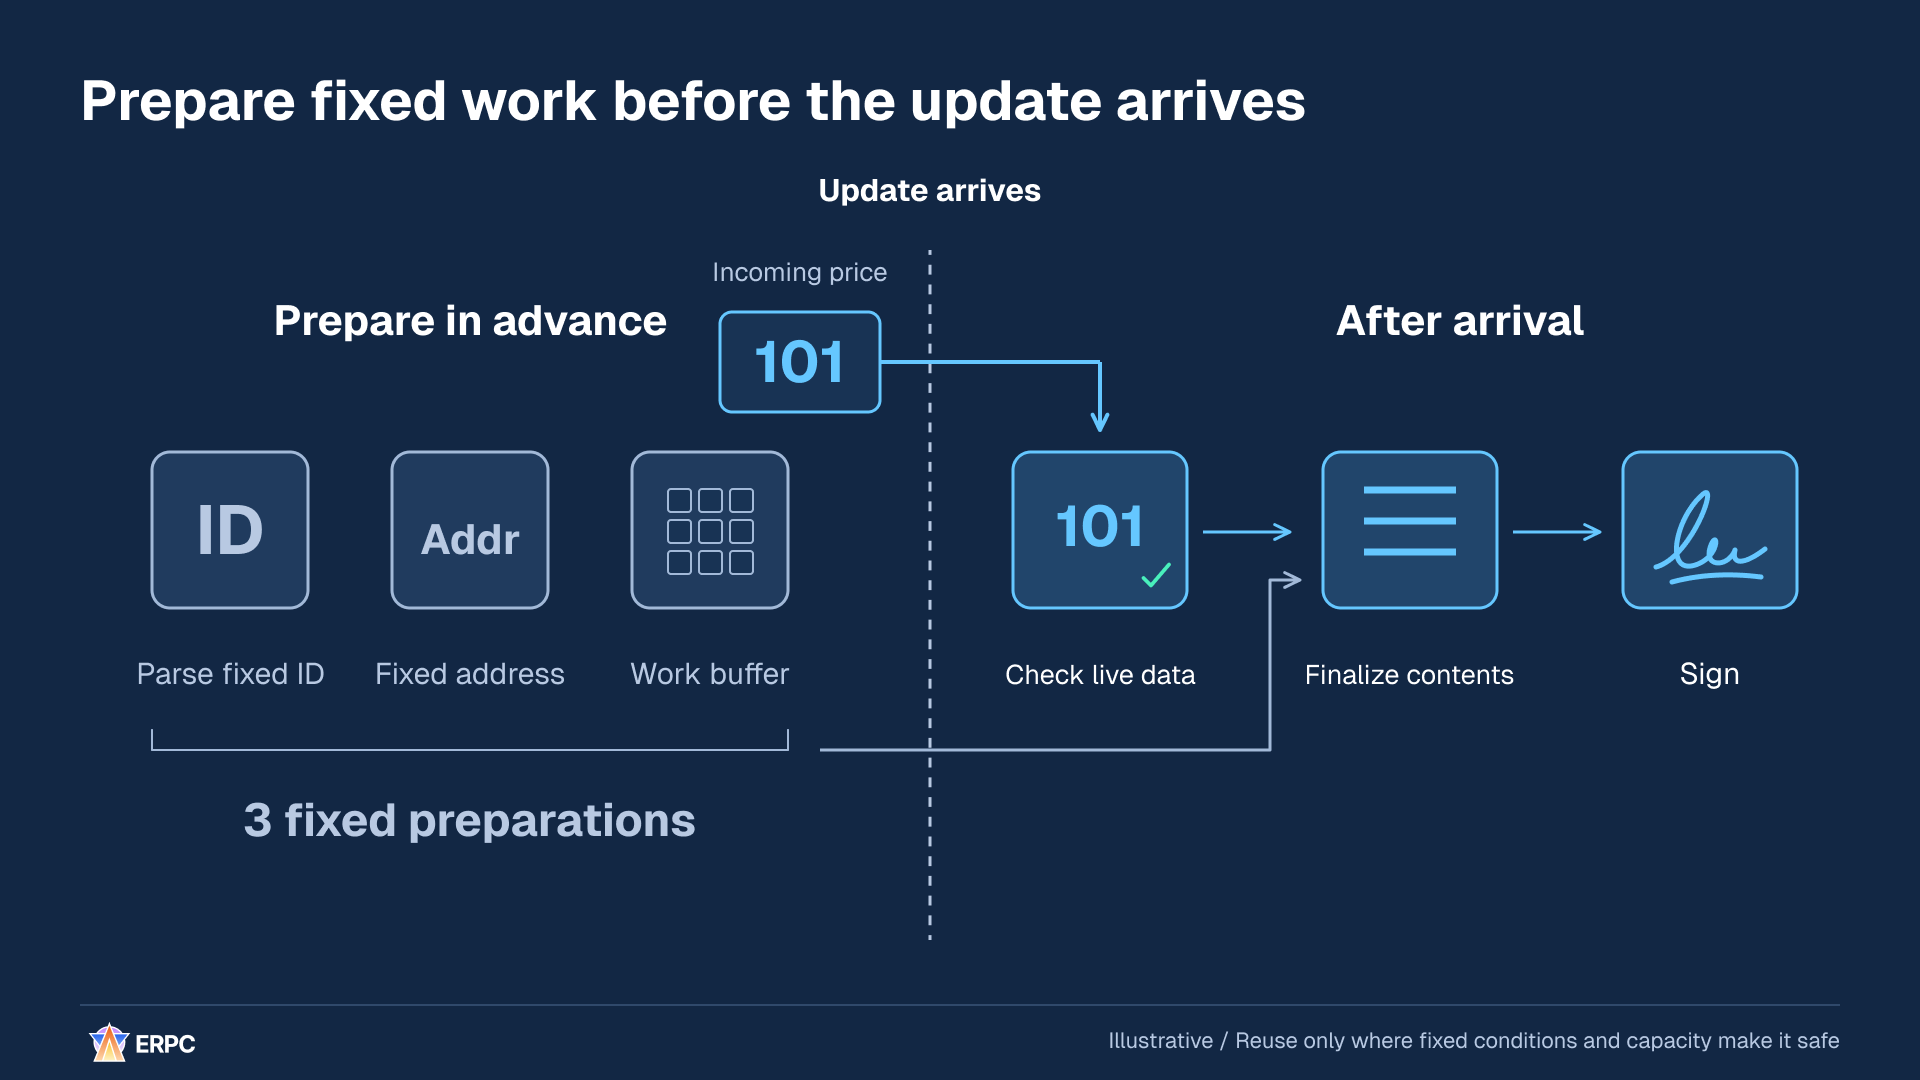
將不變的準備工作提前,同時把對目前內容的驗證和簽章保留在資料到達之後。
數一數處理三個更新時會發生什麼。每個事件都準備三類內容,需要九次準備操作。只準備一次這三類內容,再按順序重複使用,只需要三次。兩種設計都仍然接收三個事件,逐個處理,並產生三個輸出。
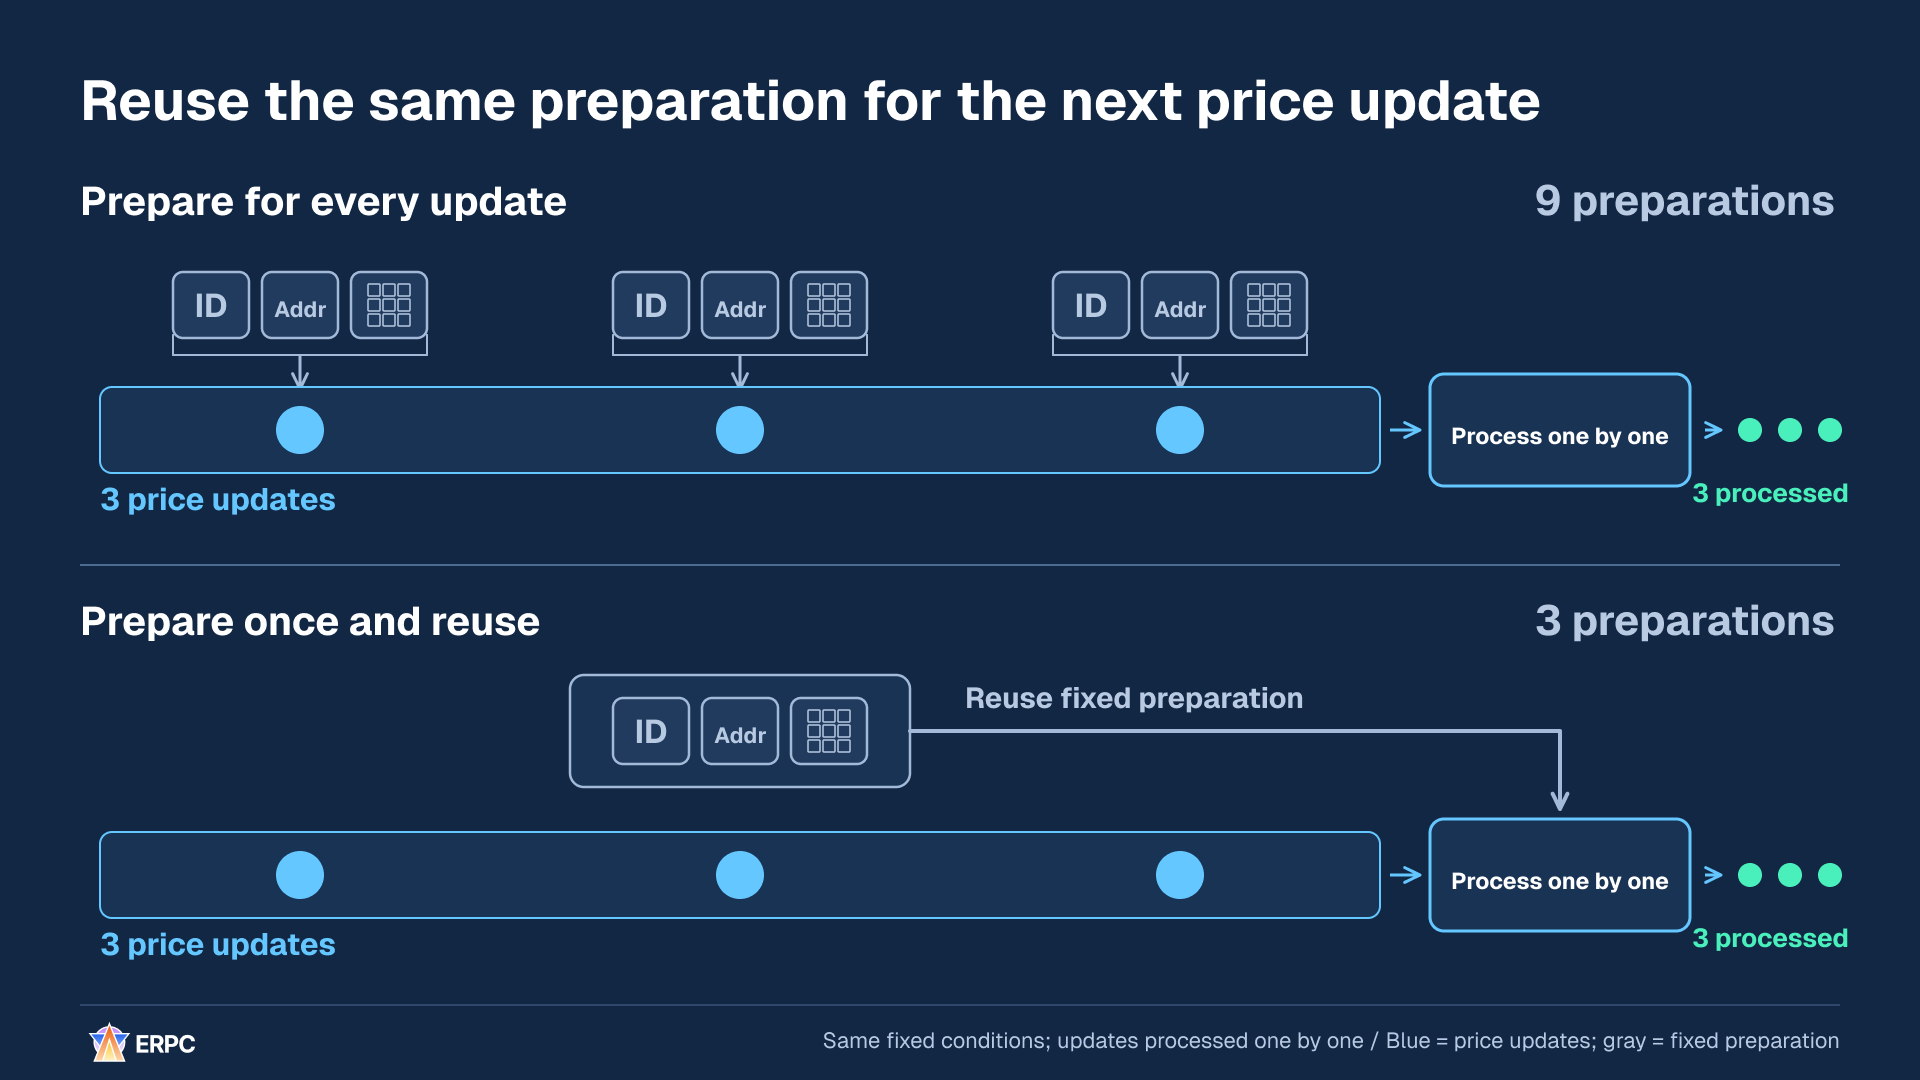
本例中,事件數仍然是三個,而固定準備從九次減少為三次。
這個對比假設固定條件不變,而且工作記憶體可以按順序安全重複使用。每次仍然需要用目前事件更新其中的內容。如果多個操作並行執行,應為每個操作使用獨立區域,或透過管理存取權限的記憶體池,避免相互覆蓋同一塊記憶體。
將同一個例子擴展到1,000個事件。每個事件都準備三類內容,需要3,000次準備操作;共同準備只做一次,則需要三次。兩種設計都接收1,000個事件,逐個處理,並產生1,000個輸出。要區分準備次數與實際處理的事件數。
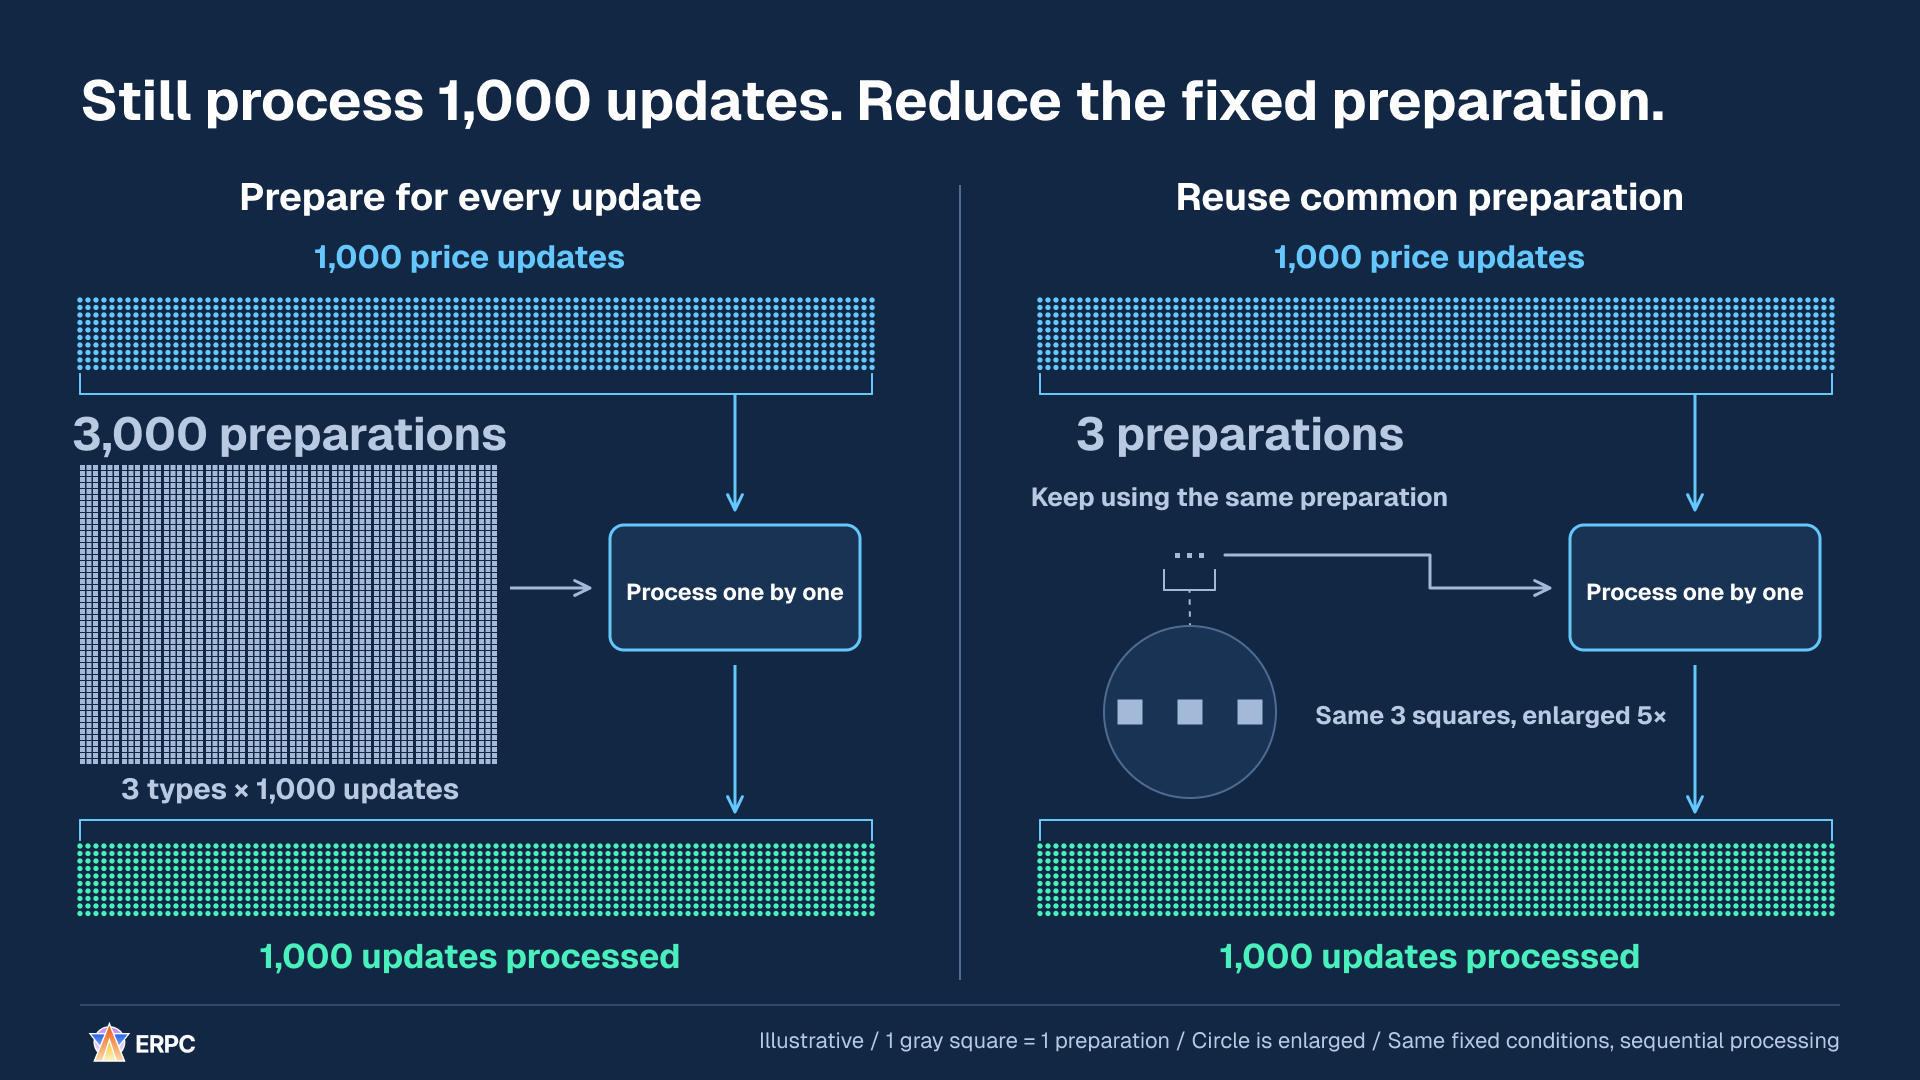
減少的是重複的固定準備。驗證、決策、簽章及其他工作依然存在,因此這些次數的比例並不等於整個應用程式的加速比例。
需要定義重複使用持續有效的條件。如果推導固定地址的某個輸入改變,就必須重新計算地址。價格、數量、餘額、參照的帳戶狀態、風險限額和 blockhash,都必須在決策使用時有效。如果應用程式維護持續更新的本機狀態,就要檢查其版本、新鮮度和有效性。這不一定意味著每次決策都要透過 RPC 重新取得全部資料。
Solana 的 getLatestBlockhash 會回傳 blockhash 及其 lastValidBlockHeight。檢查過期時,要區分區塊高度與 slot。[7] 簽章前先確定訊息的最終內容。如果簽章後修改了訊息,就要針對更新後的內容重新產生簽章。[19]
如果希望提前執行並重複使用不變的準備工作,可以複製以下指令。
text
檢查每次輸入都重複進行相同解析、地址推導或記憶體配置的工作,並將可重複使用的準備提前到接收之前。

閱讀 README、開發指令、相依項目,以及接收 → 準備 → 決策 → 訊息建構 → 簽章的程式碼。使用既有語言、執行環境與 SDK。確認每項準備的輸入、輸出、擁有者與有效期間。

1. 儲存不含機密資訊、可重現的輸入。記錄事件與輸出數量、每項準備的執行次數與耗時、配置的記憶體,以及從接收到決策完成的時間。
2. 找出輸入不變的準備,在初始化或其他適當的較早階段執行,並重複使用結果。實作重複使用的索引鍵、輸入或設定變化時的失效與重新計算,以及快取與緩衝區池的上限。
3. 根據目前輸入更新可重複使用的工作記憶體。對於同時執行的工作,使用獨立區域或受管理的借用,避免仍在使用的區域遭到覆寫或歸還。
4. 根據決策要求驗證價格、數量、餘額、帳戶狀態、風險條件與 blockhash。使用持續更新的本機狀態時,檢查版本與新鮮度。在 Solana 中,透過 lastValidBlockHeight 檢查 blockhash 過期時,應區分區塊高度與 slot。先確定最終訊息,再簽章;如果簽章後內容改變,應對更新後的訊息重新簽章。
5. 使用相同輸入,比較準備次數與耗時、從接收到決策完成的 p50/p95/p99、CPU 與記憶體,以及輸出。也要重現輸入或設定變化、過期與同時執行,檢查是否重複使用了過時結果或發生記憶體衝突。不要將準備次數的比例當作整體加速倍數。單一主機內的經過時間應使用單調時鐘,並說明測量的起點與終點。

沿用既有核准、權限與開發流程。不要僅憑這些指令,就認為取得了修改正式環境、簽訂付費合約或進行真實交易的額外權限。不要輸出私鑰、驗證資訊或客戶資料。

最後回報改動、比較條件、改動前後的測量值、正確性檢查與剩餘限制。無法測量的值應標示為未測量。
檢查每次輸入都重複進行相同解析、地址推導或記憶體配置的工作,並將可重複使用的準備提前到接收之前。
閱讀 README、開發指令、相依項目,以及接收 → 準備 → 決策 → 訊息建構 → 簽章的程式碼。使用既有語言、執行環境與 SDK。確認每項準備的輸入、輸出、擁有者與有效期間。
1. 儲存不含機密資訊、可重現的輸入。記錄事件與輸出數量、每項準備的執行次數與耗時、配置的記憶體,以及從接收到決策完成的時間。
2. 找出輸入不變的準備,在初始化或其他適當的較早階段執行,並重複使用結果。實作重複使用的索引鍵、輸入或設定變化時的失效與重新計算,以及快取與緩衝區池的上限。
3. 根據目前輸入更新可重複使用的工作記憶體。對於同時執行的工作,使用獨立區域或受管理的借用,避免仍在使用的區域遭到覆寫或歸還。
4. 根據決策要求驗證價格、數量、餘額、帳戶狀態、風險條件與 blockhash。使用持續更新的本機狀態時,檢查版本與新鮮度。在 Solana 中,透過 lastValidBlockHeight 檢查 blockhash 過期時,應區分區塊高度與 slot。先確定最終訊息,再簽章;如果簽章後內容改變,應對更新後的訊息重新簽章。
5. 使用相同輸入,比較準備次數與耗時、從接收到決策完成的 p50/p95/p99、CPU 與記憶體,以及輸出。也要重現輸入或設定變化、過期與同時執行,檢查是否重複使用了過時結果或發生記憶體衝突。不要將準備次數的比例當作整體加速倍數。單一主機內的經過時間應使用單調時鐘,並說明測量的起點與終點。
沿用既有核准、權限與開發流程。不要僅憑這些指令,就認為取得了修改正式環境、簽訂付費合約或進行真實交易的額外權限。不要輸出私鑰、驗證資訊或客戶資料。
最後回報改動、比較條件、改動前後的測量值、正確性檢查與剩餘限制。無法測量的值應標示為未測量。5. 遺漏必需更新後,不要繼續進行決策
假設同一資產有兩個市場,應用程式計算價格差 B−A。斷開連線期間,市場A從100變為105,應用程式錯過了這次更新。如果重新連線後只收到B的價格104,就會計算104−100,結果為+4。使用A更新後的值,計算結果則為104−105,即-1。連正負號都變了。
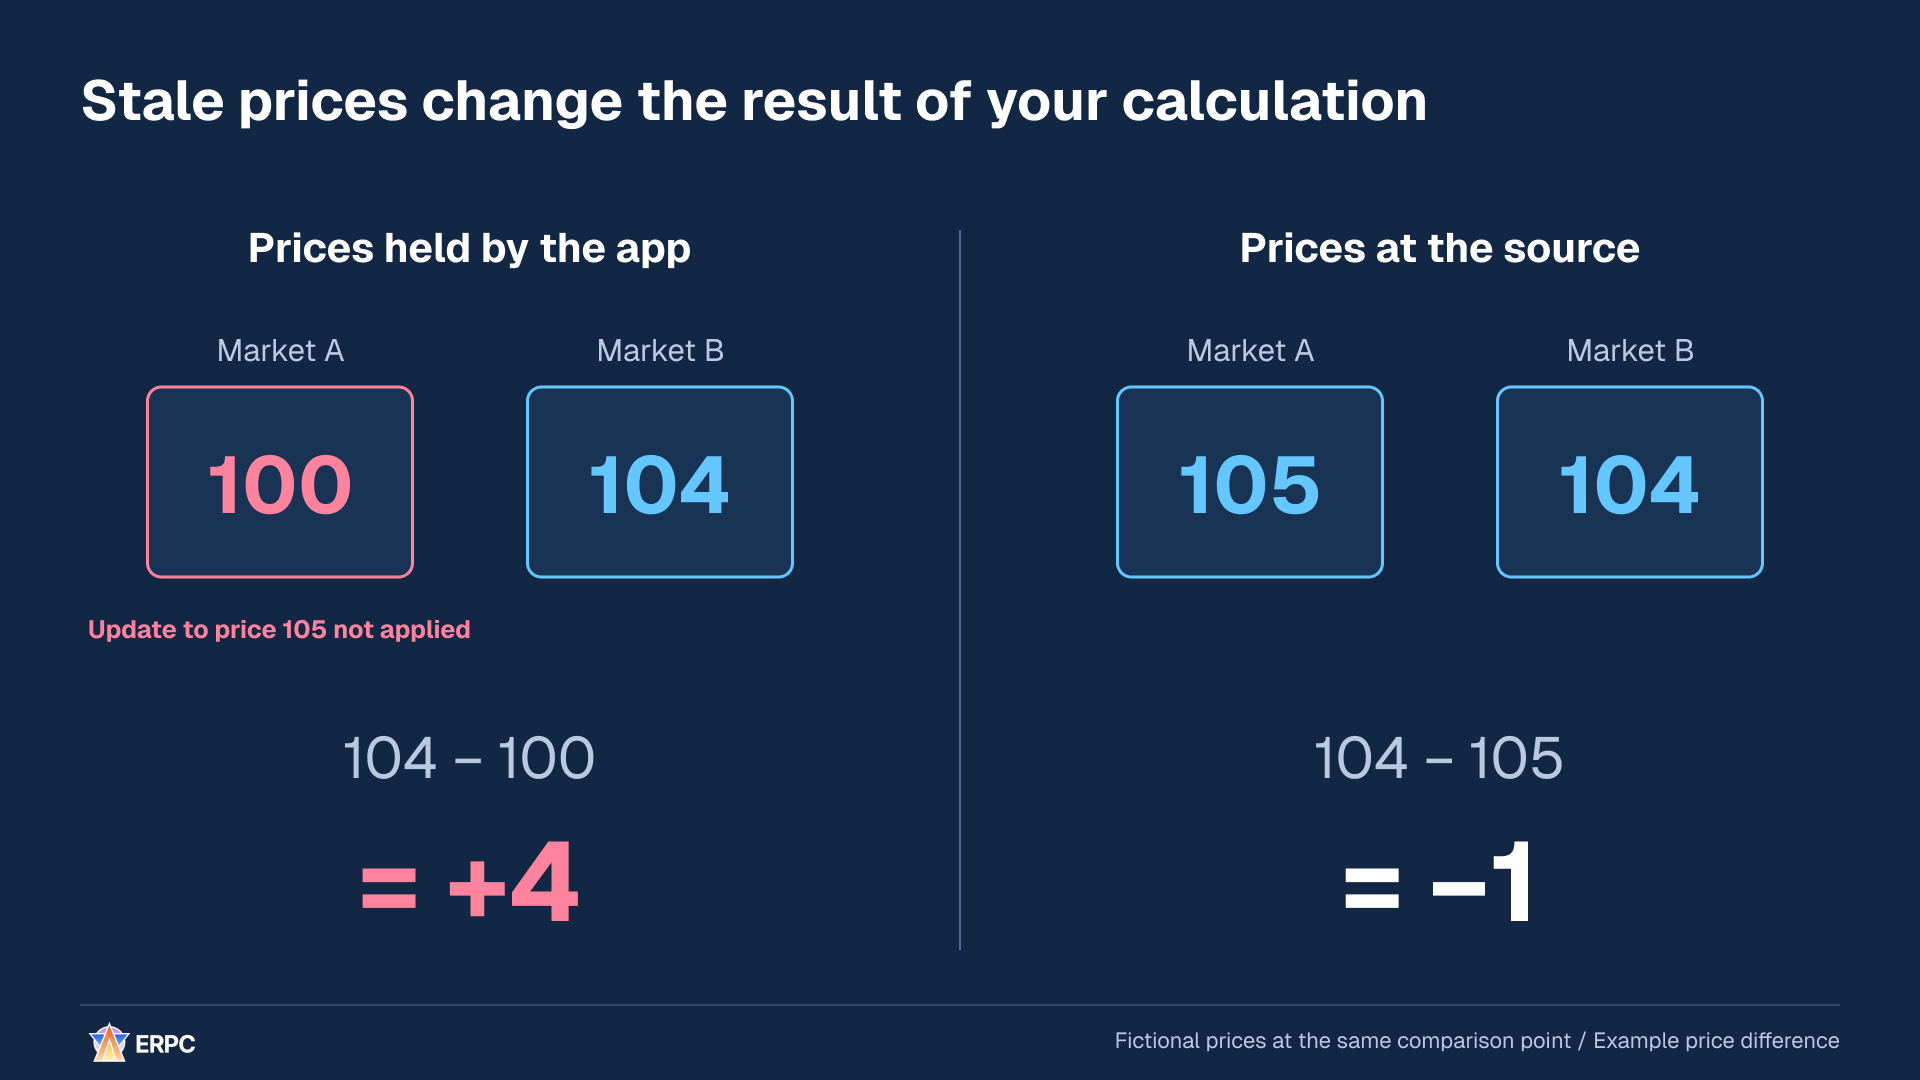
同樣的計算,會因為使用A的舊值100還是更新後的105而產生不同結果。
這個模型只展示價格差,沒有包含手續費、成交條件或其他因素,也不代表交易利潤。重點在於:恢復連線,並不一定意味著恢復了決策所需的全部更新。
在本例中,應先暫停使用A和B價格的新交易決策,再用恢復得到的105替換A的舊值100。接著,確認決策所需的更新都已套用到A和B,並滿足要求的順序和新鮮度條件。只有必要檢查全部完成後才恢復;如果無法完成檢查,就繼續保持暫停。
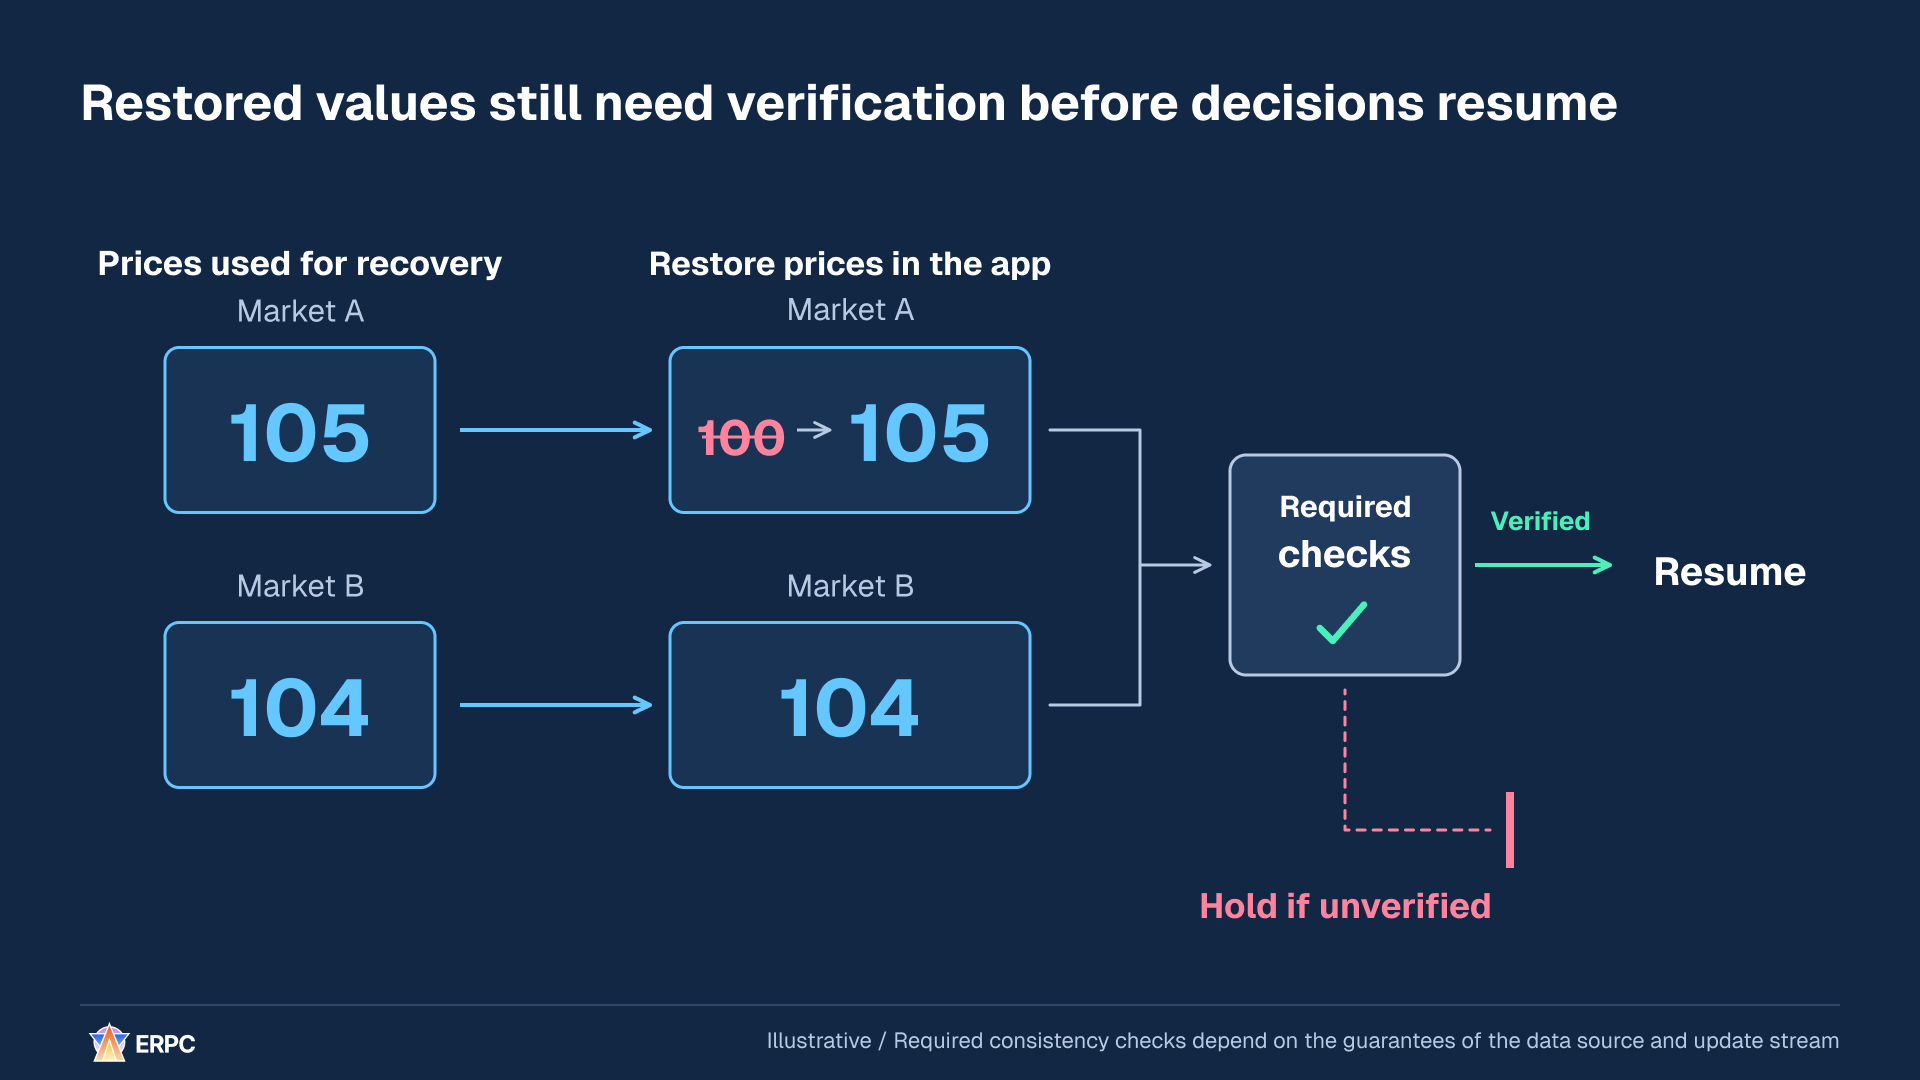
要把更新數值與確認這些數值可以用於決策分開處理。
一種常見的恢復機制是快照,即某一時點的狀態集合。將快照與連續更新串流銜接時,要明確哪些更新已包含在快照中,以及之後應套用哪些更新。這能避免重複套用已包含的增量,或遺漏銜接邊界處的更新。具體方法必須遵循所選 API 對訂閱開始、識別、重新取得和重播所提供的保證。
Yellowstone 訊息包含 slot 和 write_version 等欄位。[16] 僅憑這些欄位存在,不能認為它們保證了跨提供方可用的順序,或完整的缺口偵測。不要把 slot 差值直接換算為遺失的更新數或延遲秒數。應根據所選提供方的保證,驗證狀態是否已正確銜接。
還要考慮恢復前已經開始的計算。某個操作使用舊狀態開始,卻在恢復後才結束,其結果可能覆蓋新狀態。一種方法是在恢復前後為狀態指定世代編號,並拒絕舊一代的結果。如果使用 processed 狀態,還應把回滾,也就是該狀態不再被採用的情況,納入重新檢查狀態的條件。[6]
如果希望重新連線後先恢復有效狀態,再恢復決策,可以複製以下指令。
text
防止這個應用程式僅因連線已恢復,就根據舊狀態重新進行交易決策。實作恢復決策之前所需的狀態恢復。

閱讀 README、開發指令、相依項目,以及訂閱、初始取得、更新套用、重新連線與決策的程式碼。使用既有語言、執行環境與 SDK。核實提供方、commitment、更新語義,以及順序、識別、重新取得與重播方面的實際保證。

1. 區分連線狀態、資料有效性,以及是否允許恢復決策。一旦確認遺漏必需更新或新鮮度不足,應暫停依賴該狀態的新交易決策,同時繼續必要的接收、更新與恢復。
2. 如果使用快照,應根據提供方的保證確認其包含哪些更新,以及與後續資料流的邊界。防止增量重複套用、邊界遺漏與錯誤的套用順序。不要用假設補足未提供的保證。不要將 slot 或 write_version 當作可無條件用於偵測更新遺漏的序號。
3. 不要僅因重新取得了值就恢復決策。實作受影響決策所要求的更新、順序、新鮮度與一致性檢查;檢查無法完成時,維持暫停。使用世代或等效機制,防止恢復前啟動、較晚完成的舊計算或訂單提案被套用或傳送。恢復時應根據驗證後的狀態重新決策。如果使用 processed 狀態,應處理回滾後的失效與恢復。
4. 使用不含機密資訊、可重現的輸入,重現斷線期間錯過的更新、重複、亂序、舊資料、反覆重新連線,以及舊世代工作的完成。驗證從連線恢復到驗證完成期間,決策始終暫停,並確認驗證後的狀態與預期結果一致。
5. 記錄恢復時間、因狀態無效而遭到阻止的決策嘗試次數與暫停時間、重新套用或排除的更新、正常情況下從接收到決策完成的時間、CPU 與記憶體。不要在未說明的情況下,從測量中排除暫停期間或遺漏更新。說明測量邊界,以及哪些情況能偵測、哪些不能。單一主機內的經過時間應使用單調時鐘。

沿用既有核准、權限與開發流程。不要僅憑這些指令,就認為取得了修改正式環境、簽訂付費合約或進行真實交易的額外權限。不要輸出私鑰、驗證資訊或客戶資料。

最後回報改動、比較條件、改動前後的測量值、正確性檢查與剩餘限制。無法測量的值應標示為未測量。
防止這個應用程式僅因連線已恢復,就根據舊狀態重新進行交易決策。實作恢復決策之前所需的狀態恢復。
閱讀 README、開發指令、相依項目,以及訂閱、初始取得、更新套用、重新連線與決策的程式碼。使用既有語言、執行環境與 SDK。核實提供方、commitment、更新語義,以及順序、識別、重新取得與重播方面的實際保證。
1. 區分連線狀態、資料有效性,以及是否允許恢復決策。一旦確認遺漏必需更新或新鮮度不足,應暫停依賴該狀態的新交易決策,同時繼續必要的接收、更新與恢復。
2. 如果使用快照,應根據提供方的保證確認其包含哪些更新,以及與後續資料流的邊界。防止增量重複套用、邊界遺漏與錯誤的套用順序。不要用假設補足未提供的保證。不要將 slot 或 write_version 當作可無條件用於偵測更新遺漏的序號。
3. 不要僅因重新取得了值就恢復決策。實作受影響決策所要求的更新、順序、新鮮度與一致性檢查;檢查無法完成時,維持暫停。使用世代或等效機制,防止恢復前啟動、較晚完成的舊計算或訂單提案被套用或傳送。恢復時應根據驗證後的狀態重新決策。如果使用 processed 狀態,應處理回滾後的失效與恢復。
4. 使用不含機密資訊、可重現的輸入,重現斷線期間錯過的更新、重複、亂序、舊資料、反覆重新連線,以及舊世代工作的完成。驗證從連線恢復到驗證完成期間,決策始終暫停,並確認驗證後的狀態與預期結果一致。
5. 記錄恢復時間、因狀態無效而遭到阻止的決策嘗試次數與暫停時間、重新套用或排除的更新、正常情況下從接收到決策完成的時間、CPU 與記憶體。不要在未說明的情況下,從測量中排除暫停期間或遺漏更新。說明測量邊界,以及哪些情況能偵測、哪些不能。單一主機內的經過時間應使用單調時鐘。
沿用既有核准、權限與開發流程。不要僅憑這些指令,就認為取得了修改正式環境、簽訂付費合約或進行真實交易的額外權限。不要輸出私鑰、驗證資訊或客戶資料。
最後回報改動、比較條件、改動前後的測量值、正確性檢查與剩餘限制。無法測量的值應標示為未測量。從六個維度比較語言的優勢
實作這五種設計,需要決定誰更新資料、在哪裡配置記憶體、複製什麼,以及哪些操作會等待。計算快、容易控制突然的等待、能夠快速製作原型,是不同的優勢。選擇語言時,應依照希望改善的部分進行比較。
透過公開基準測試比較執行時間
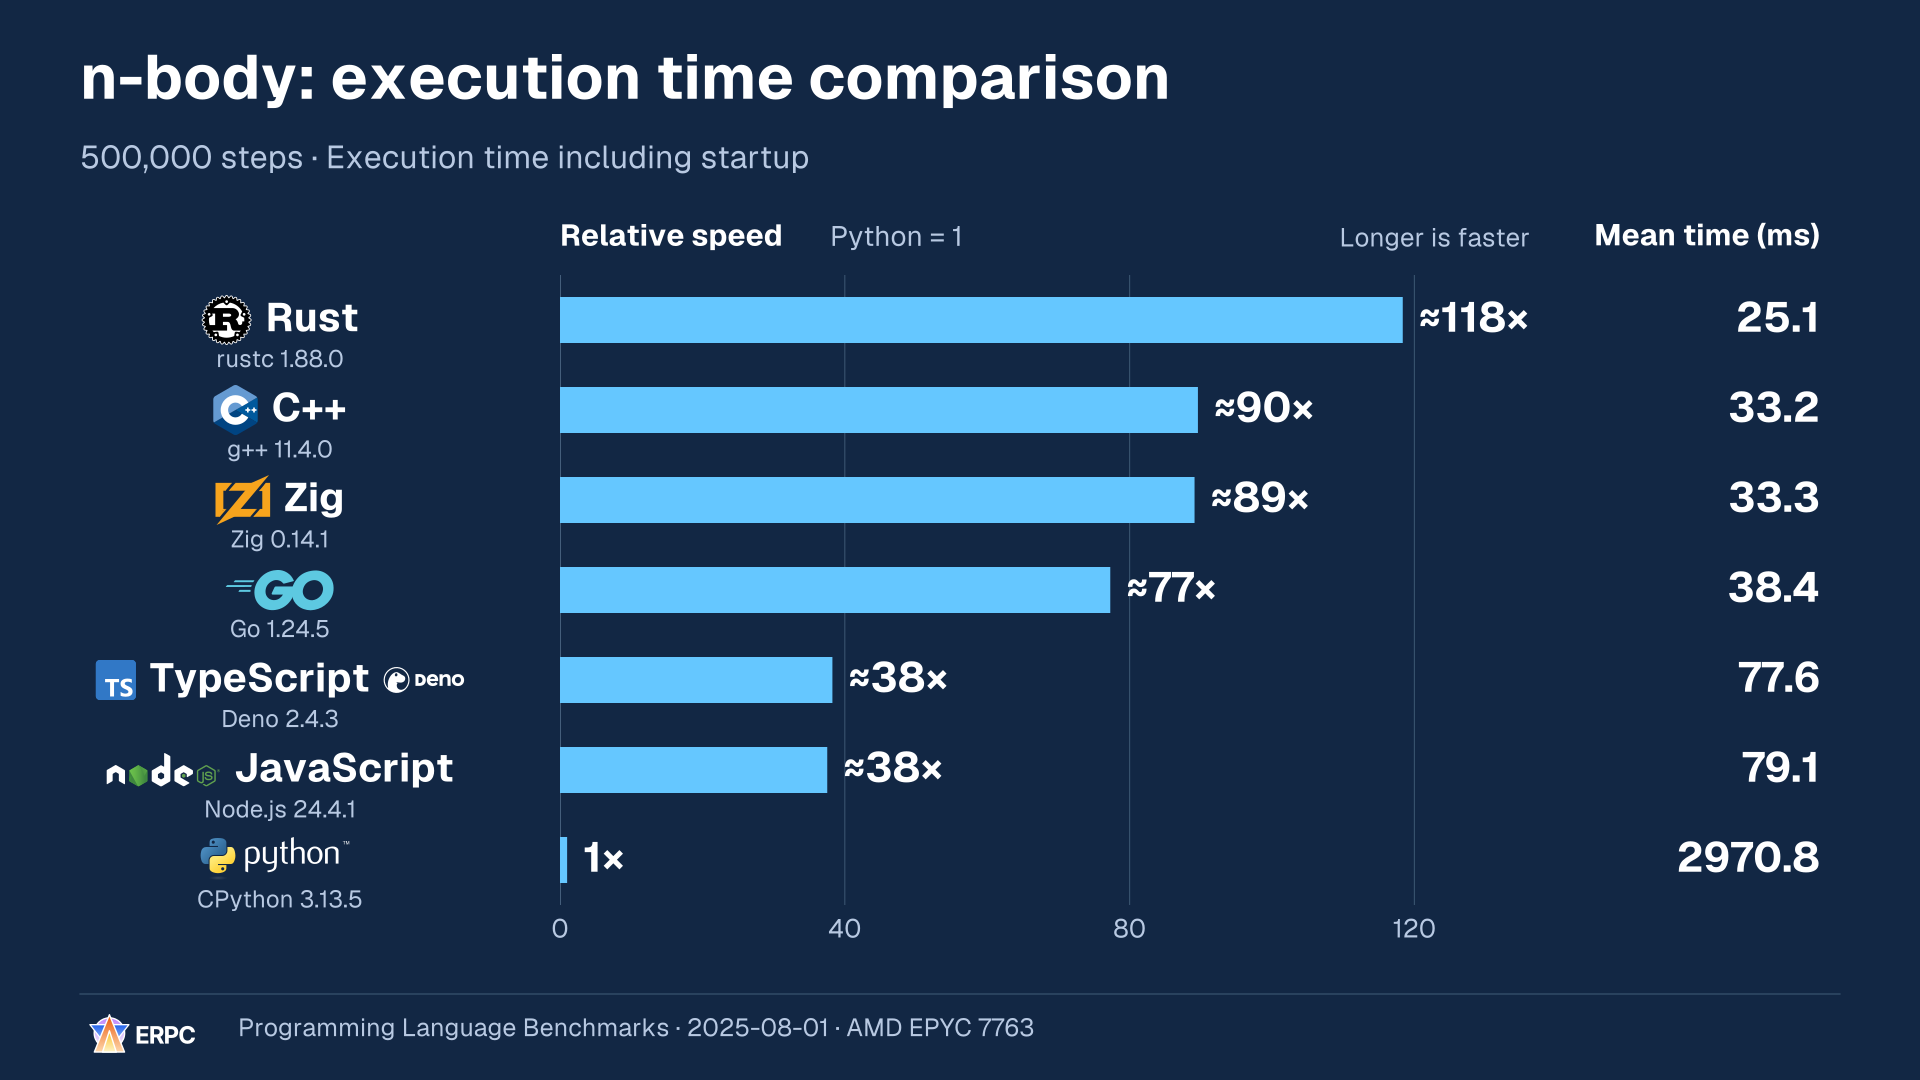
這是2025年8月1日的公開測量,計算5個天體共50萬步。平均執行時間是指從程式啟動到處理完成所需時間的平均值。它包含啟動處理與執行中的程式碼最佳化,不包含事前建置的時間。1,000ms等於1秒。[27][29]
| 語言 / 執行環境 | 平均執行時間 | 相對速度(Python = 1) |
|---|---|---|
| Rust / rustc 1.88.0 | 25.1ms | 約118 |
| C++ / g++ 11.4.0 | 33.2ms | 約90 |
| Zig / Zig 0.14.1 | 33.3ms | 約89 |
| Go / Go 1.24.5 | 38.4ms | 約77 |
| TypeScript / Deno 2.4.3 | 77.6ms | 約38 |
| JavaScript / Node.js 24.4.1 | 79.1ms | 約38 |
| Python / CPython 3.13.5 | 2970.8ms | 1 |
相對速度由四捨五入前的平均執行時間計算,以 Python 為1。 對每種語言及執行環境,我們從穩定版中選擇符合條件的最小公開平均值:數值計算採用單一執行緒,不使用明確的 SIMD 指令、向量型別或外部數值計算函式庫。程式碼與最佳化方式存在差異;Zig 使用 ReleaseFast。TypeScript 以包含 Deno/V8 的執行檔運作,JavaScript 則在 Node.js 上執行。[28]
相近的數值應理解為相近的結果,不應僅憑這一項任務替語言整體排名。它沒有直接測量啟動後持續運作的交易機器人的處理時間,也沒有直接測量訂單到達目的地前的延遲。
記錄的環境是 AMD EPYC 7763、4個可用核心的 Linux。公開測量程式碼設定為每種條件重複3次,每次啟動新處理程序。當時執行的確切提交版本及每次測量的原始資料未能驗證,因此這裡介紹的是公開平均值。[28][29]
從六個面向比較設計上的優勢
以下圖表是針對鏈下 Solana 用戶端、分為三級的編輯選型參考。「計算速度」維度考察在所比較的語言與實作中,如何加速自行撰寫的大量資料讀取與計算。它不對主要時間花在網路等待上的完整應用程式,也不對交給高速外部函式庫的計算進行排名。
Rust、Go、C++、Zig 都是最佳化後原生執行的有力候選。這不代表速度相同;更細的順序需要測量實際工作負載。V8 也會將經常執行的函式轉換為機器碼。僅用「JavaScript 是直譯執行,所以慢」來說明並不準確。[20][21]
「計算速度」「延遲控制」與「記憶體控制」三個維度表示計算與控制方面的優勢。「安全性支援」「原型開發便利性」與「Solana SDK」表示開發支援方面的優勢。六個軸並不都代表處理速度。
所有六邊形使用相同的軸與刻度。越靠外,表示該維度的定性優勢越強。這些不是實測速度或比例,3級也不代表1級的三倍。應逐項比較希望改善的維度,而不是把多邊形面積當作綜合分數。
| 維度 | 比較內容 |
|---|---|
| 計算速度 | 在所比較的實作中,加速自行撰寫的大量資料讀取與計算有哪些選項 |
| 延遲控制 | 能在多大程度上直接將記憶體配置、回收、執行期間的程式碼最佳化等工作移出重要處理,以限制突然的等待 |
| 記憶體控制 | 能直接設計資料配置方式、擁有權與生命週期、記憶體配置、重複使用與回收的範圍 |
| 安全性支援 | 語言功能、執行環境與標準工具,在防止記憶體生命週期與共享記憶體誤用方面提供的協助 |
| 原型開發便利性 | 執行小型應用程式並嘗試修改的容易程度;這是隨經驗與既有程式碼而變的編輯評估 |
| Solana SDK | 從 Solana 官方文件找到並開始使用適合該用途的用戶端 SDK 與範例的容易程度 |
控制類維度評估直接設計的空間,安全性維度評估可用支援,SDK 維度評估從官方文件出發的使用路徑。同一級別也可能對應不同的機制與保證。[8][13][20][21][26]
以下總覽將 Rust、Go、TypeScript、Python、C++、Zig 這6種語言排列為橫向3欄、縱向2列。先比較關注的維度,再透過後面的個別圖表與說明確認執行條件與適合的用途。
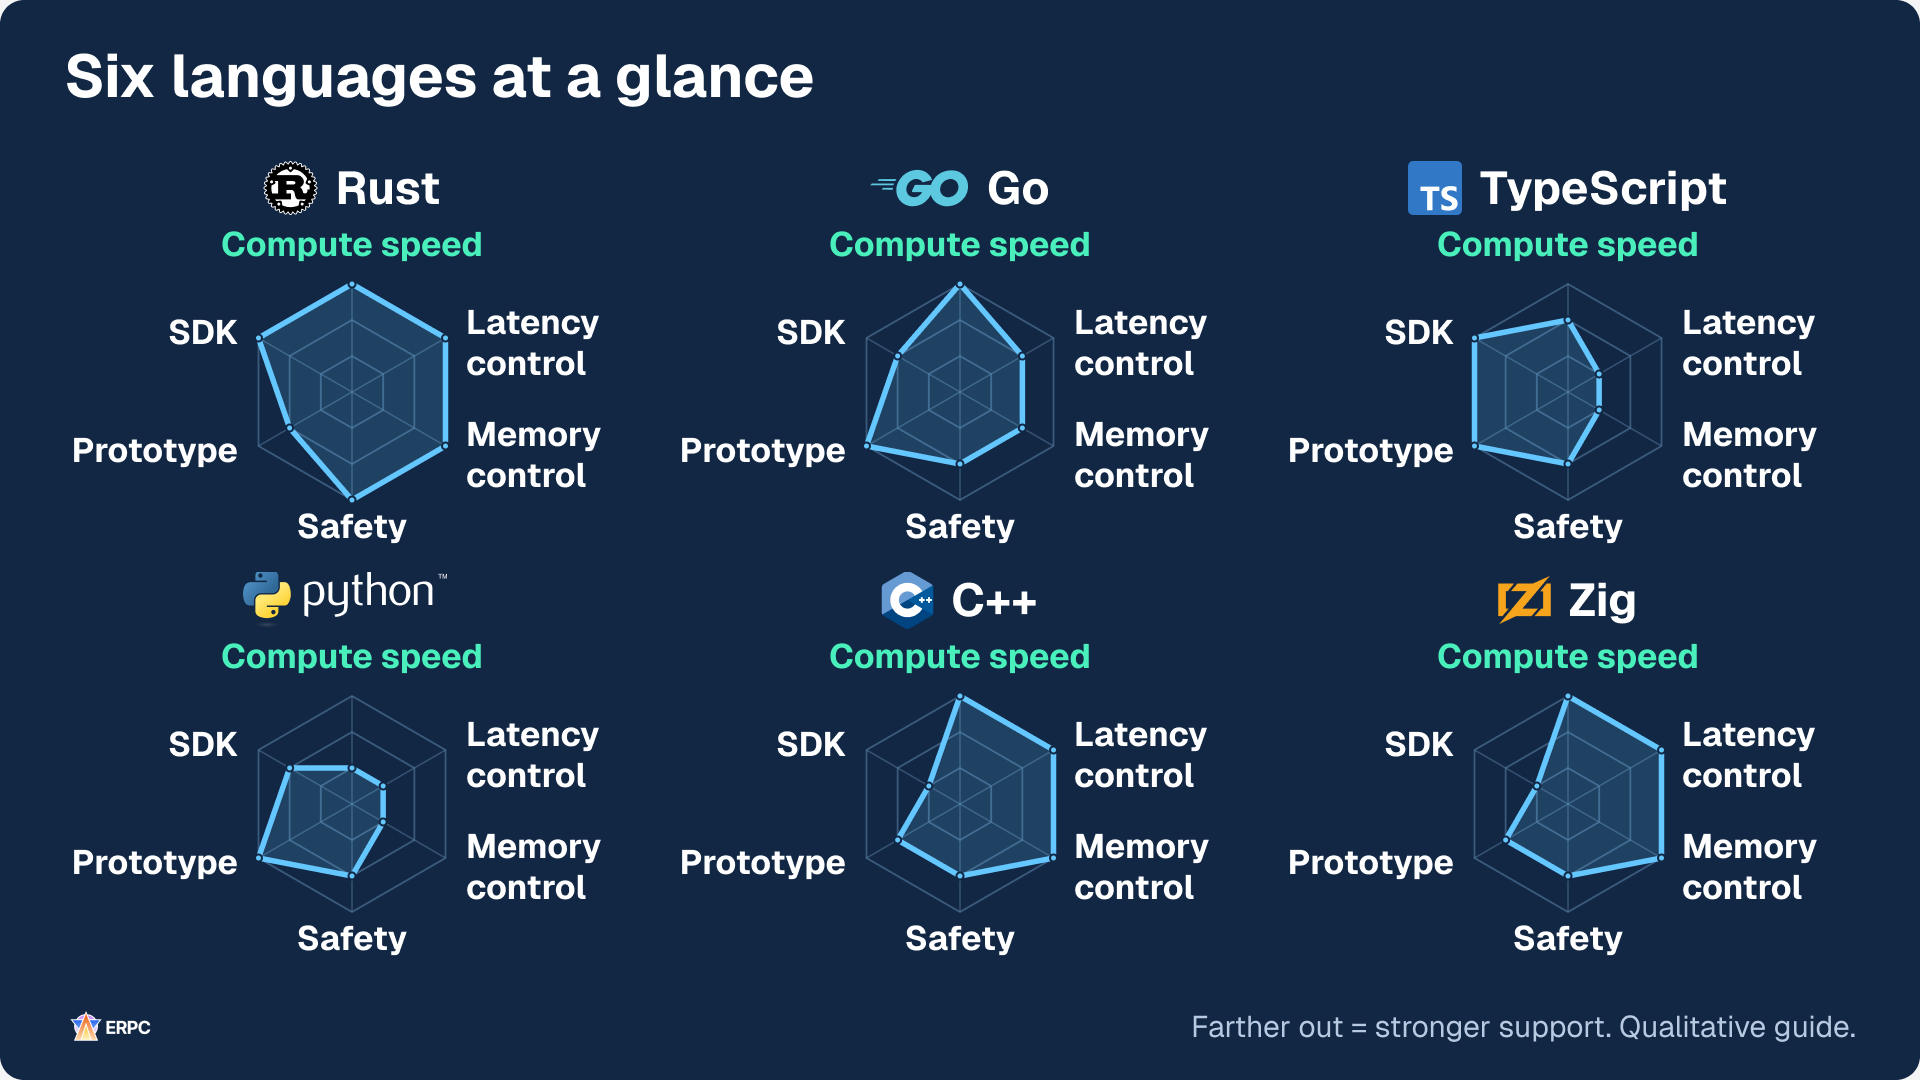
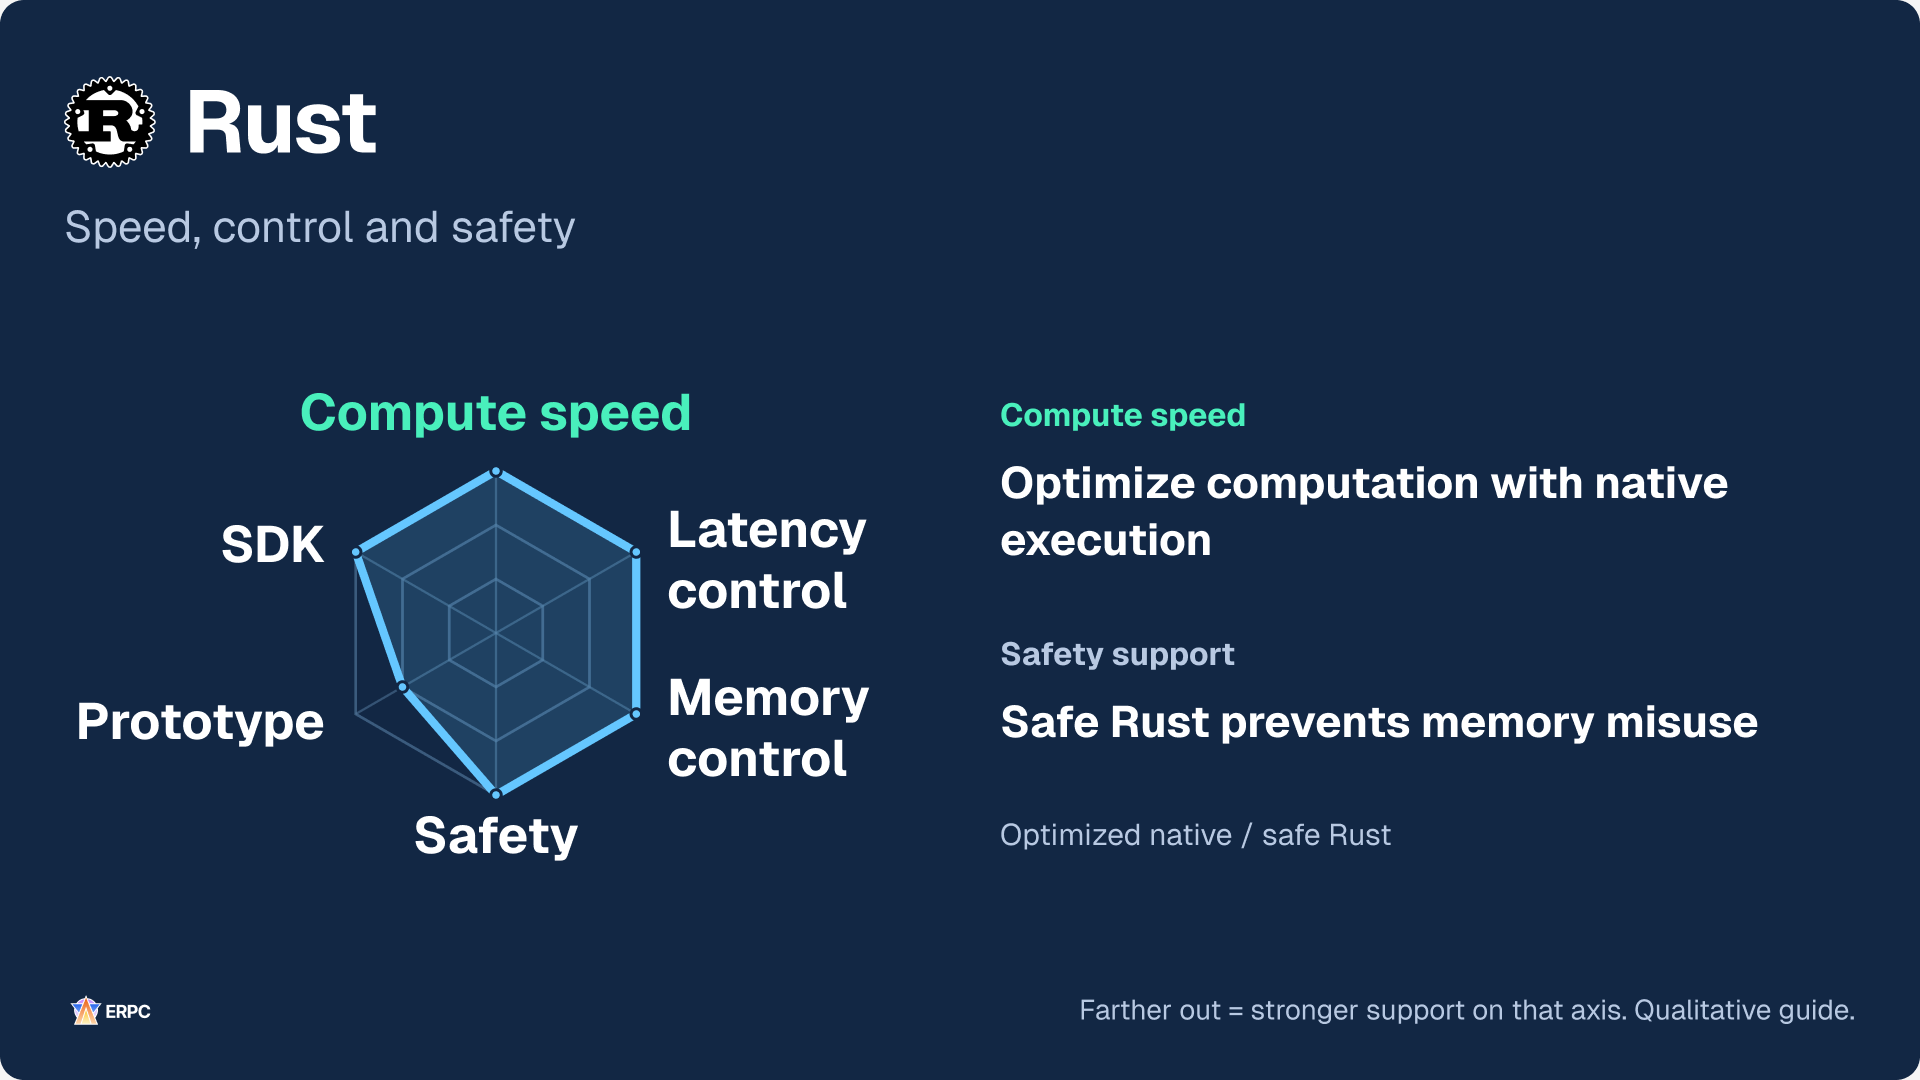
Rust 將重要路徑上的資料配置、記憶體配置與重複使用控制,和擁有權及借用檢查結合。其一般記憶體管理不需要追蹤式 GC。[8] safe Rust 防止資料競爭的保證,並不保證沒有一般的競爭條件、死結或錯誤的決策邏輯。unsafe 程式碼與外部語言介面需要另外驗證。[22] 複製、配置、釋放、鎖與作業系統等待仍會發生,因此要以真實輸入與負載檢查。
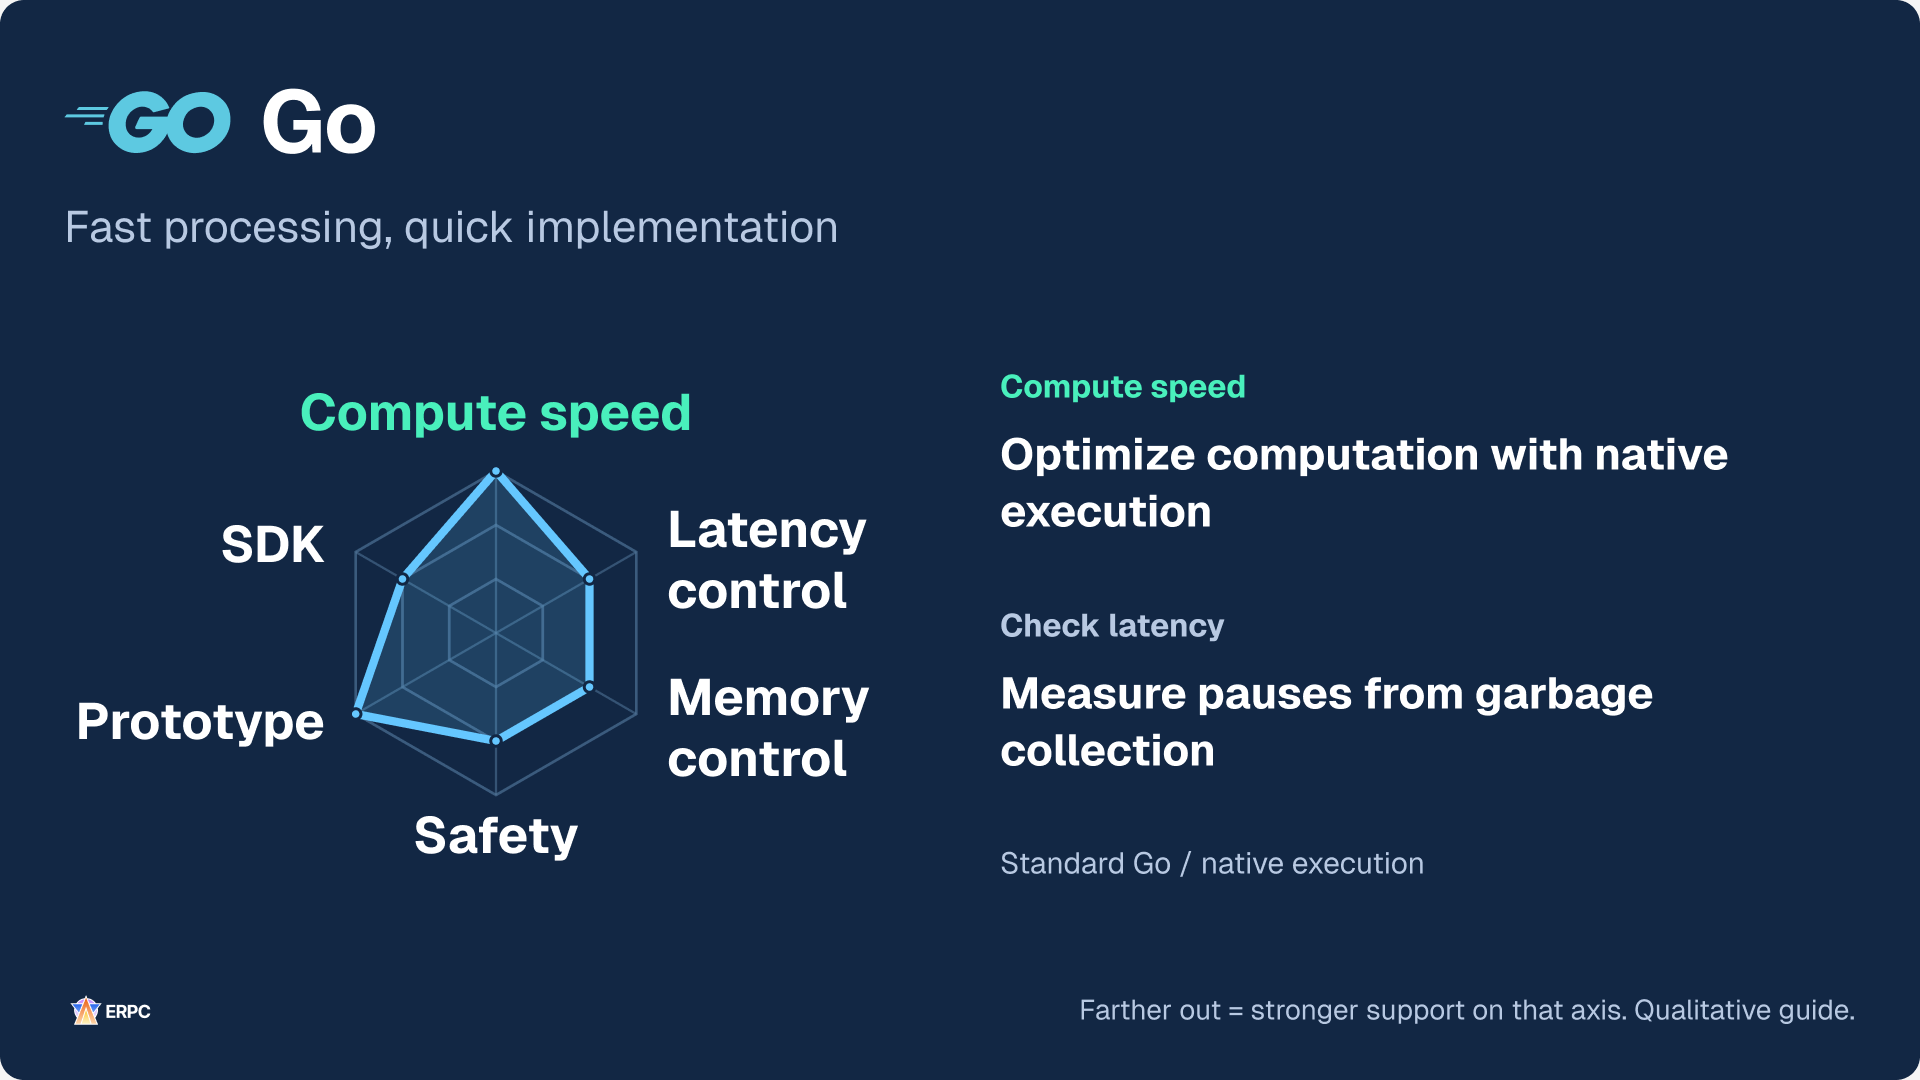
Go 也是原生編譯執行的候選。它有助於建構並行服務與處理流程,執行環境則支援記憶體管理等操作。[20] GC 的大部分工作並行進行,但仍須測量配置量,以及回收帶來的 CPU、記憶體與延遲成本。CPU 處理的潛力,與能否直接控制回收時機,應分別看待。[13]
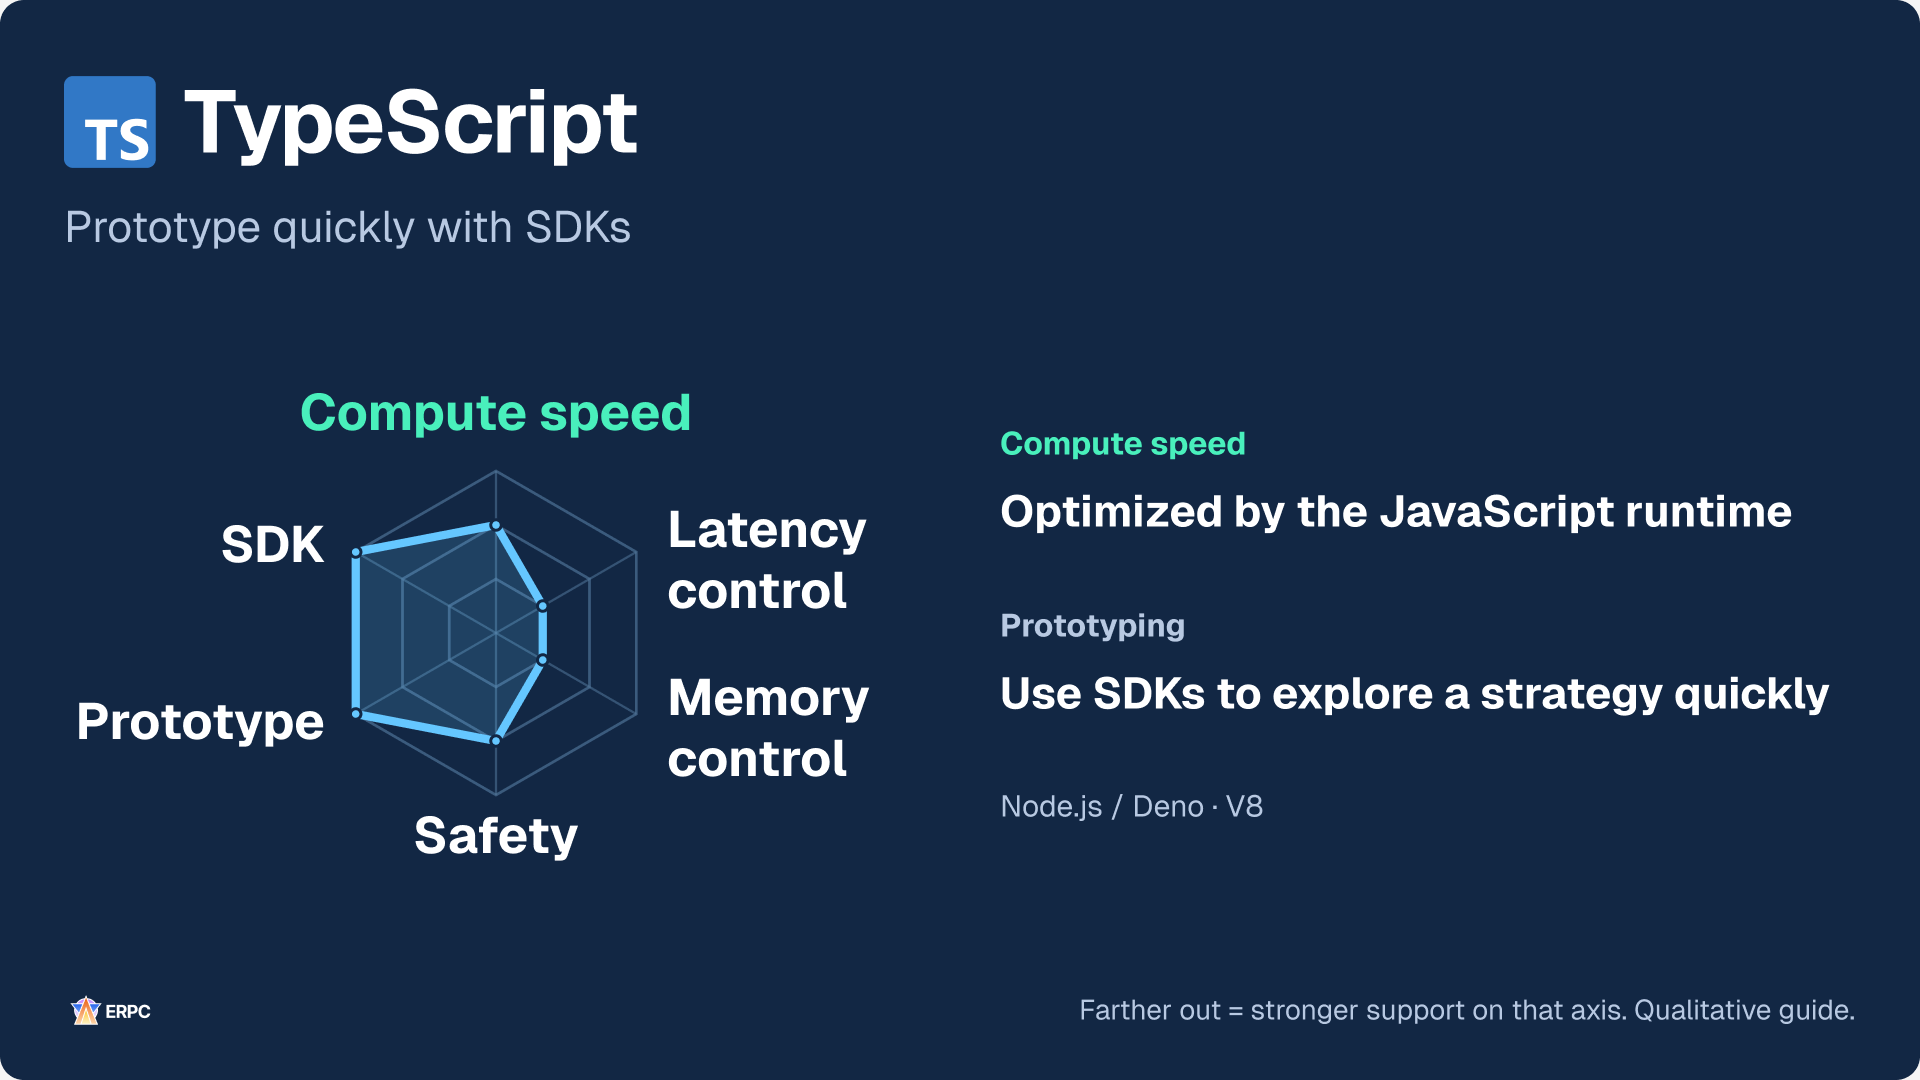
TypeScript 是語言,Node.js 與 Deno 是執行環境。此圖依 V8 執行的 JavaScript 評估。型別註記不會保留在執行的程式碼中,因此加入型別本身不會加快 CPU 工作。外部資料仍須在執行期間驗證。[9][10][21] 這些選項可用於 API 整合、設定、監控、Web UI,以及符合所需效能的串流處理。
Node.js 的 worker_threads 與 Deno 的 Web Workers 可以將 CPU 工作移到不同的執行環境脈絡。Node.js 文件建議使用 worker 池,而不是每項任務都建立一個 worker。除了目的端的計算,也要將轉換、複製與提交工作前的等待納入比較。[11][12]
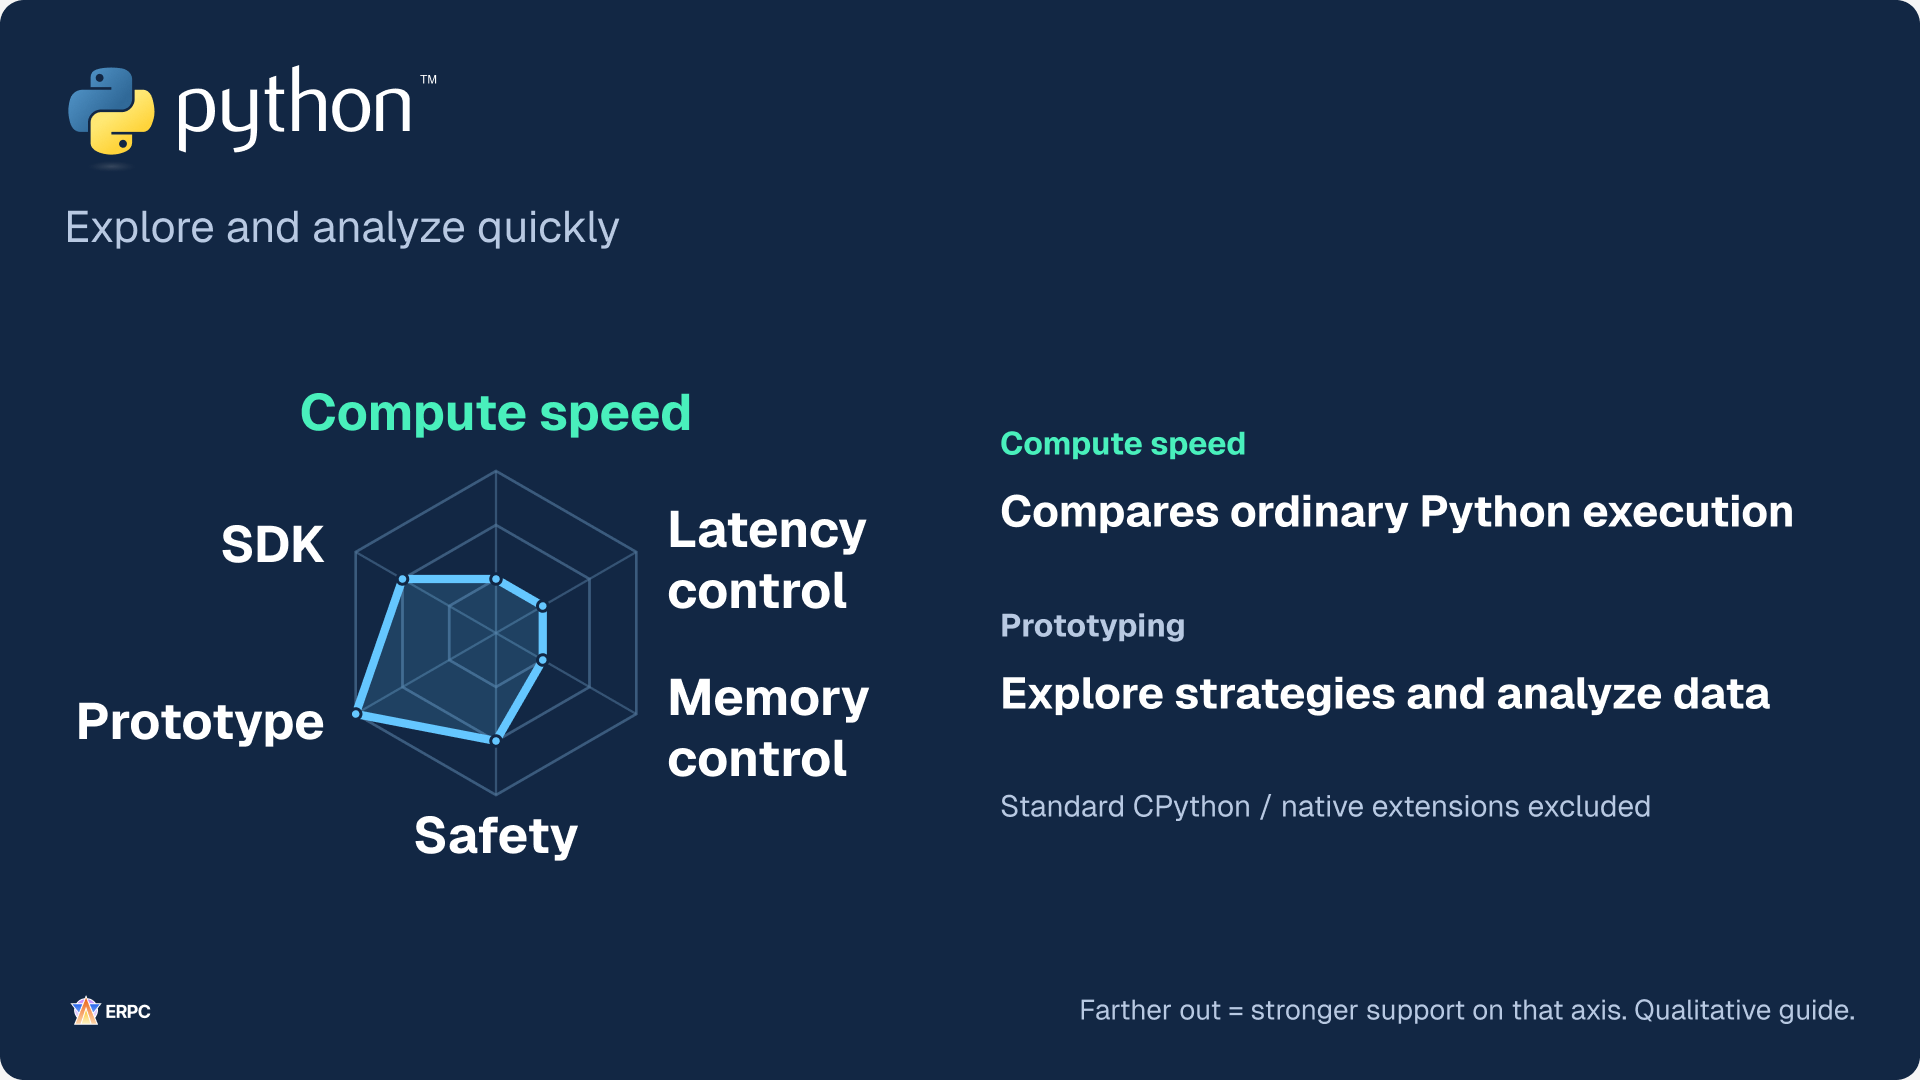
Python 適合研究、分析、驗證,以及使用既有函式庫的工作。此處 CPU 評估針對以 Python 撰寫、在一般 CPython 內執行的迴圈。交給編譯後程式碼的計算,例如 NumPy 操作,是另一種情況。[23] 應檢查包含 free-threaded 建置在內的實際設定,不要只根據語言名稱判斷。[14] 如果將一部分移到 Rust 或其他實作,應測量邊界上的轉換與複製,並驗證整個應用程式是否受益。
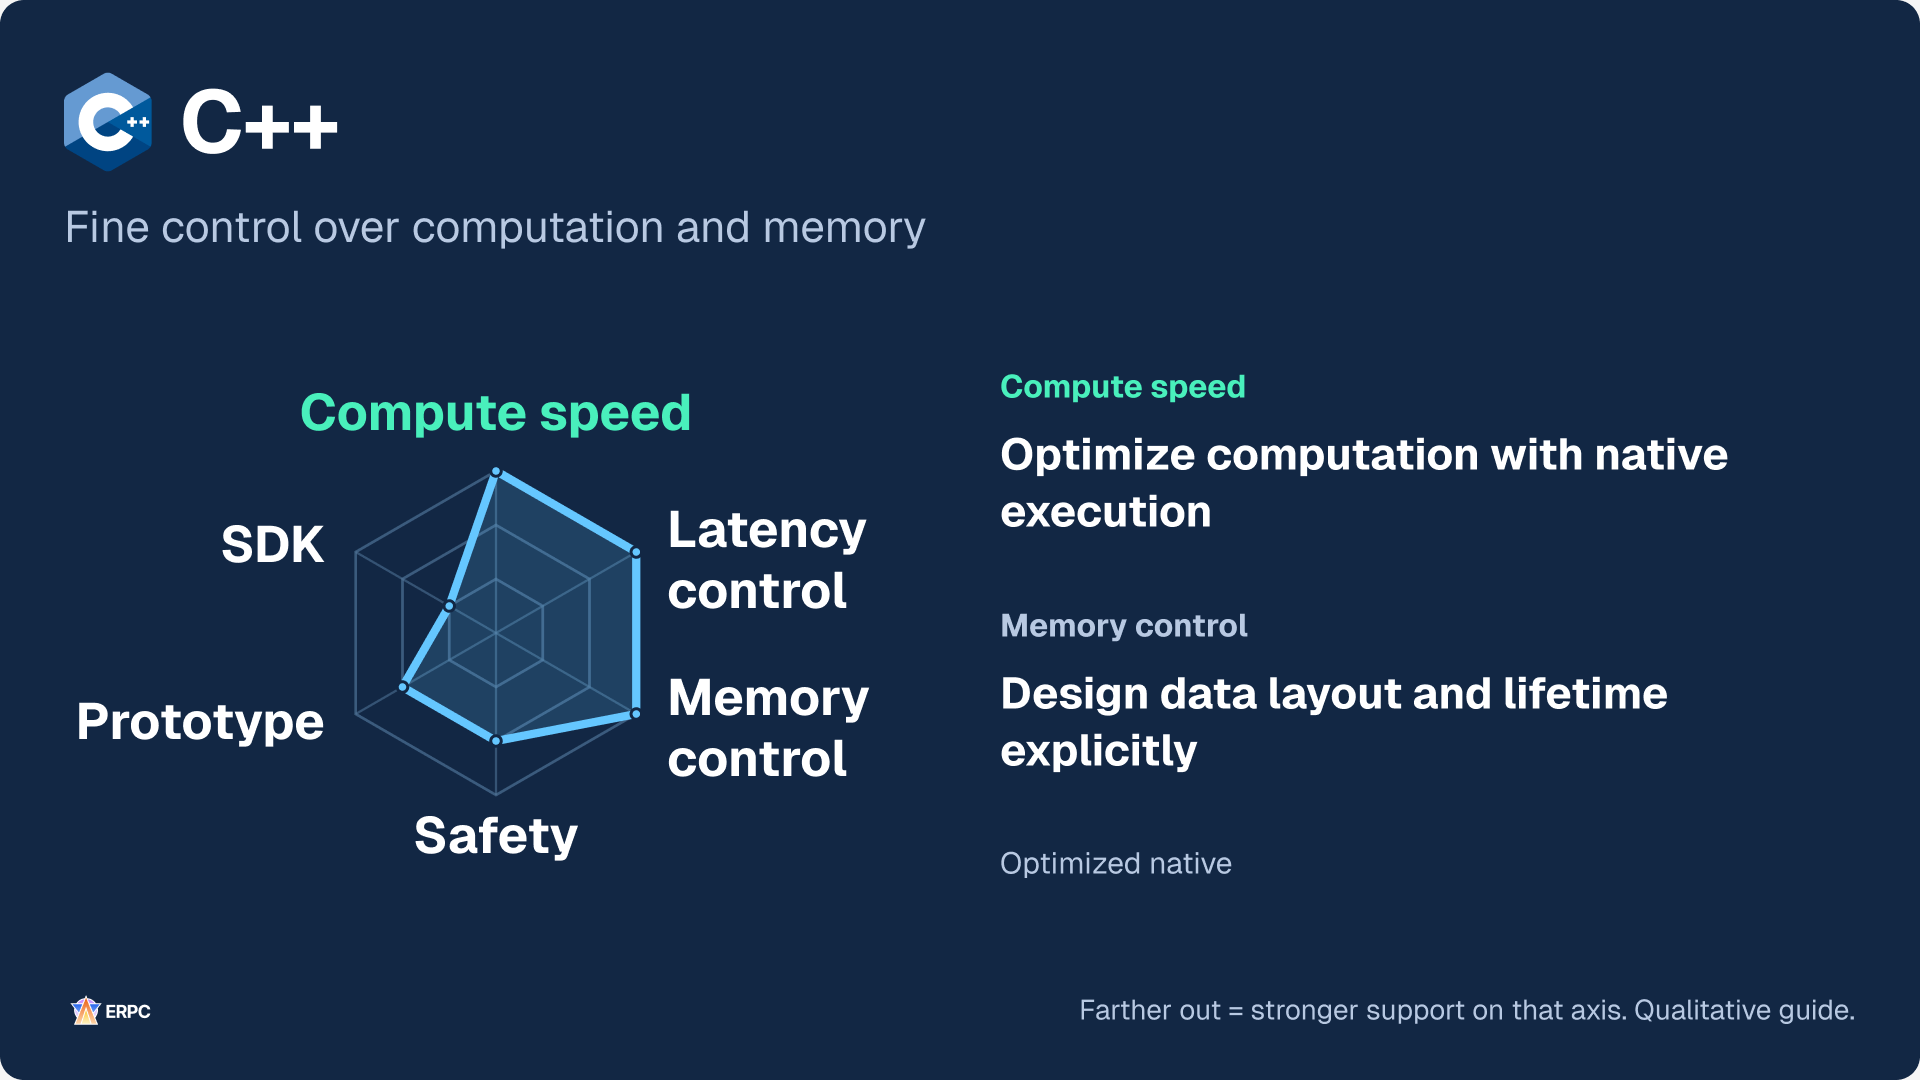
C++ 將低階控制與抽象、既有函式庫結合。RAII 與智慧指標有助於管理資源生命週期,但使用它們並不保證所有記憶體生命週期或共享記憶體安全問題都獲得解決。[24] 安全性的中層評估,也不表示它與 Go 等選項的受管理記憶體具有相同保證。
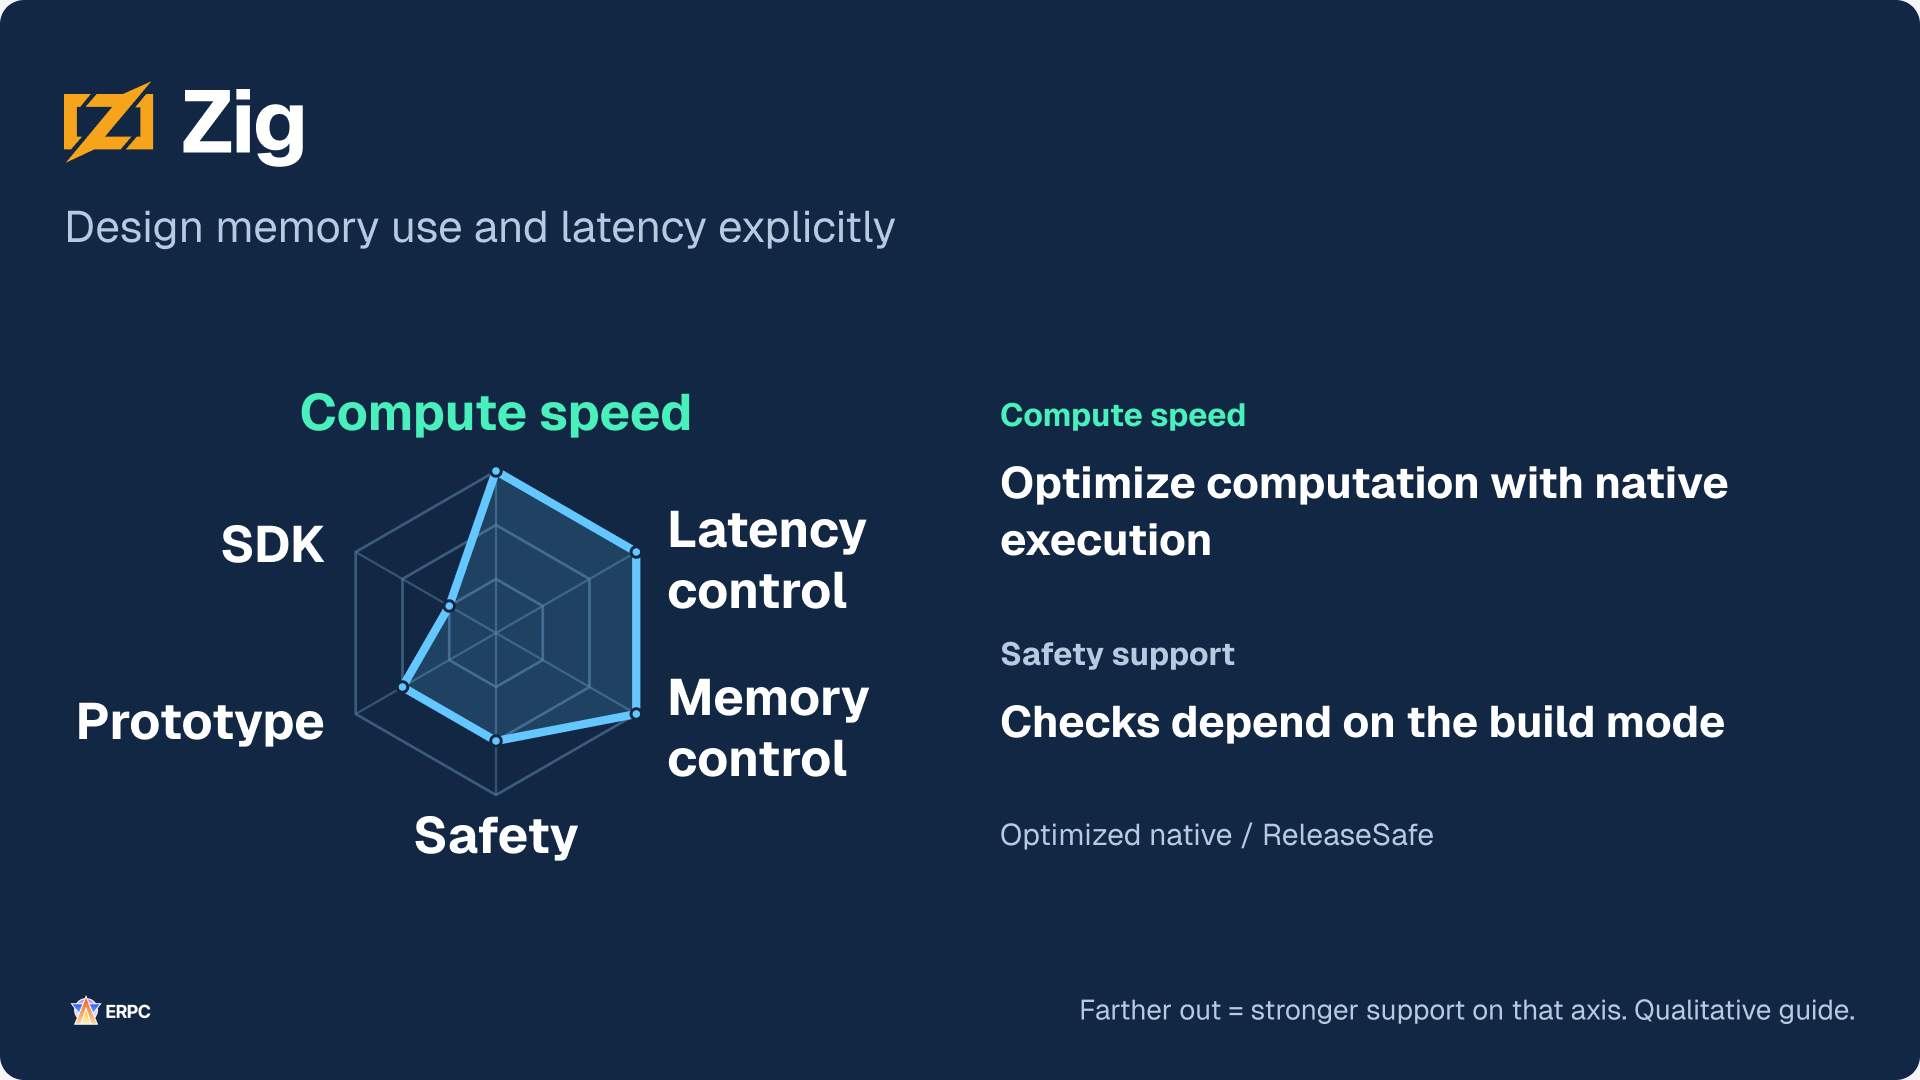
Zig 支援明確安排記憶體配置與配置器選擇。此特徵圖以 ReleaseSafe 的檢查為前提。ReleaseFast 與 ReleaseSmall 的預設檢查不同,而 ReleaseSafe 也無法偵測所有無效行為。[25] 與 C++ 有相同的多邊形形狀,並不代表機制相同。
Solana SDK 維度以官方文件中 TypeScript、Rust 的使用路徑,以及其中列出的 Go、Python 用戶端為依據。它不是一般函式庫的數量或品質排名,也不表示 C++、Zig 沒有函式庫。針對實際採用的 SDK,應檢查必需 API、維護與跟進更新的情況,以及與所選執行環境的相容性,包括 Deno。[26]
測量應用程式在哪些地方花費時間,再依該部分所需的優勢選擇工具。先在目前語言中減少等待與重複工作。如果需要更細的控制,也可以將相關部分移到其他語言。
在相同條件下比較改動前後
每節的指令都涵蓋對應改善的實作與驗證。如果要實施多項改善,應保留每項改動與測量結果的對應關係。將改動一起套用,會更難區分哪項改動影響了哪個結果。
改進前後應使用相同輸入、訂閱條件、負載和輸出要求。對於從接收到決策完成的時間,除了中位數 p50,也應觀察 p95 和 p99。p99 是99%的測量事件能夠在其內完成的閾值。它有助於同時看到典型處理情況和分布中較慢的一側。
把各階段的 p99 相加,並不能得到端到端 p99。應直接測量每個事件從接收到決策完成的總時間,同時觀察佇列等待、CPU 和記憶體使用、遺漏或丟棄的更新,以及決策結果是否一致。
在單台主機內測量經過的時間時,應使用單調時鐘,避免系統牆鐘被校正後出現倒退。如果 SDK 在解碼完成後才呼叫回呼,那麼回呼開始前也已經發生了處理。要明確每項測量從哪裡開始、到哪裡結束,才能分別考慮資料傳輸延遲和應用程式延遲。
也要檢查提交之後發生了什麼。sendTransaction 回傳成功,並不保證交易已被叢集處理或確認。[15] 將接收、決策、提交被接受,以及觀察到的鏈上結果關聯起來,有助於找出下一個改進位置。
讓快速傳輸轉化為及時決策
快速傳輸資料,以及應用程式能夠及時完成必需決策,兩者都很重要。ERPC 會持續改進資料傳輸基礎設施,並提供幫助改善其上執行軟體的資訊。
先在同一環境中驗證應用程式改動。然後,在有需要時,使用相同程式碼對比不同部署位置或資源,以區分各自的影響。使用 ERPC 按小時計費時,應提前定義假設、比較條件和使用時長,並在目前 Dashboard 中確認價格與可用性。
參考資料與相關連結
- [1] Tokio / CPU 密集型任務與阻塞
- [2] Node.js / 不要阻塞事件迴圈
- [3] gRPC / 流量控制
- [4] Yellowstone gRPC / 訊息與訂閱規範
- [5] LMAX Disruptor / 設計與使用
- [6] Solana / Commitment
- [7] Solana / getLatestBlockhash
- [8] Rust / 所有權
- [9] TypeScript / 執行階段行為與型別擦除
- [10] Deno / TypeScript
- [11] Node.js / Worker threads
- [12] Deno / Web Workers
- [13] Go / 垃圾回收器
- [14] Python / Free threading
- [15] Solana / sendTransaction
- [16] Yellowstone gRPC / 訊息定義
- [17] Rust / std::sync::Mutex
- [18] Tokio / 共享狀態與 mutex 分片
- [19] Solana / 交易結構與簽章
- [20] Go / 常見問題
- [21] V8 / 概觀
- [22] Rust / 資料競爭與競爭條件
- [23] NumPy / 什麼是 NumPy?
- [24] C++ / 核心指南
- [25] Zig / 語言參考
- [26] Solana / 用戶端 SDK
- [27] Programming-Language-Benchmarks / nbody
- [28] Programming-Language-Benchmarks / Measurement code (2025-07-31): execution, defaults, aggregation, Zig build, Deno configuration.
- [29] Programming-Language-Benchmarks / Published measurement data (2025-08-01)
- 標誌與來源: Rust © Rust Foundation (CC BY 4.0, 形狀和顏色未作修改); Zig © Zig project (CC BY-SA 4.0, 形狀和顏色未作修改).
- 其他標誌: Go © The Go Authors; TypeScript © Microsoft; Python © Python Software Foundation; C++ by Jeremy Kratz / Standard C++ Foundation; Node.js / OpenJS Foundation and Node.js contributors; Deno / Deno Land Inc..
- ERPC
- ERPC Web Dashboard