Архитектура с низкой задержкой для Solana HFT
Данные поступают, но цены, на основе которых приложение принимает решения, всё ещё устарели. В приложении для Solana HFT нужно учитывать и время вычислений, и время, которое полученные данные проводят в ожидании, прежде чем повлияют на решение. Предыдущие обновления могут ещё ждать обработки, запись лога может не завершиться, а обновление другого рынка может удерживать блокировку. Организация кода влияет на эти задержки.
На примере пяти архитектурных паттернов эта статья показывает, где входящие данные ждут и какая работа может продолжиться после изменения архитектуры. Можно начать с симптома, который наблюдается в вашем приложении, и сразу перейти к соответствующему разделу.
| Что происходит в приложении | Какой аспект архитектуры проверить |
|---|---|
| Чем дольше работает приложение, тем больше накапливается необработанных данных | 1. Скорость поступления, скорость обработки и ограничения времени ожидания |
| Следующую цену нельзя обработать, пока сохраняется запись | 2. Отделение работы, необходимой для решения, от аналитического логирования |
| Обновление рынка A заставляет ждать обновление рынка B | 3. Разделение блокировок, защищающих независимые состояния |
| При каждом поступлении повторяется одна и та же подготовка | 4. Предварительная подготовка и повторное использование неизменных частей |
| После восстановления соединения решения по-прежнему используют старые значения | 5. Разделение восстановления соединения и восстановления состояния для принятия решений |
В конце каждого раздела есть инструкции, которые можно скопировать, чтобы применить соответствующее улучшение к своему приложению. Передайте их AI-агенту, который может читать код проекта.
Количества, цены, число операций и длительности на схемах представляют собой иллюстративные модели. Они не отражают измеренную производительность или результаты торговли.
Нажмите на схему, чтобы открыть изображение в полном размере.
1. Сопоставьте поступление данных с возможностями обработки и ограничьте ожидание
Рассмотрим приложение, которое за каждый интервал одинаковой длительности получает шесть событий и может обработать два. В конце первого интервала четыре события остаются необработанными. Очередь представляет собой место, где данные ожидают обработки.
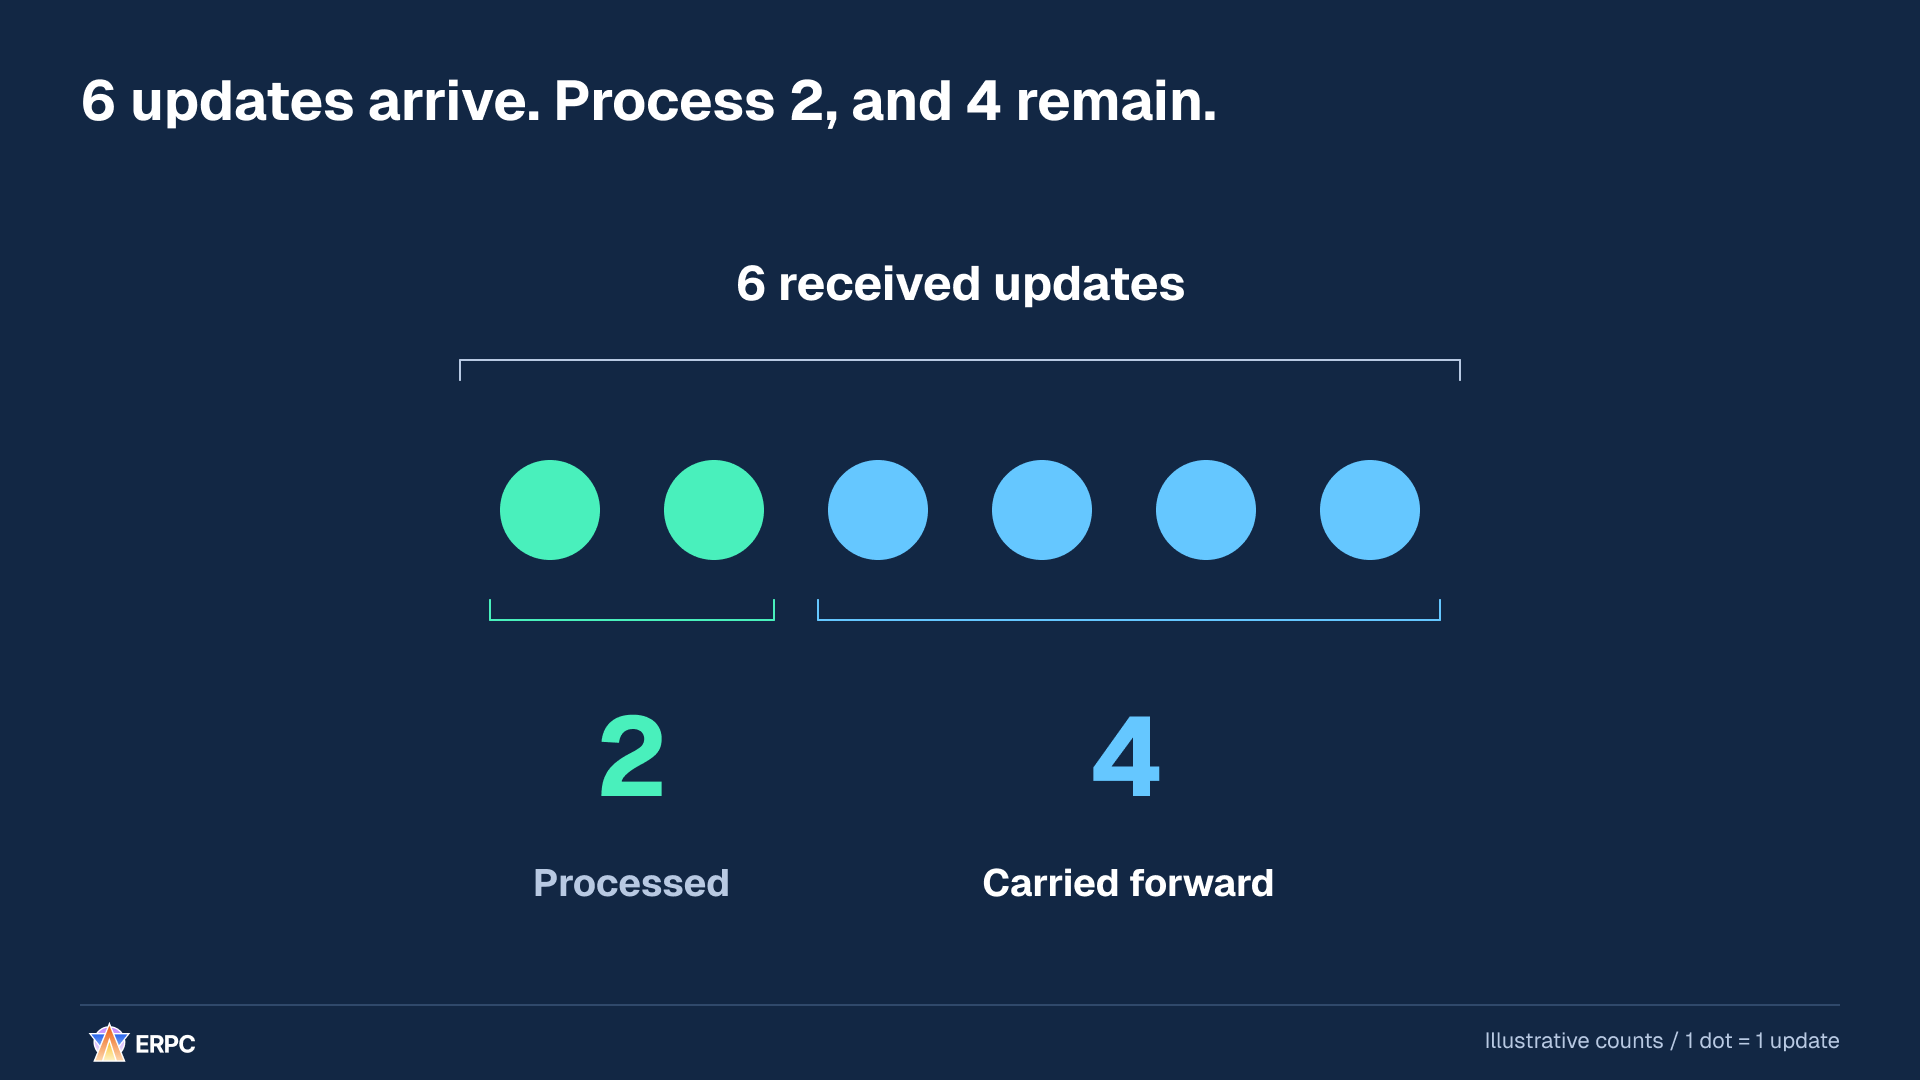
Обработка продвигается, но четыре события ещё не использованы для принятия решений.
Теперь увеличим масштаб при том же соотношении до 60 000 входящих событий. После обработки 20 000 ещё 40 000 ждут. В правой части схемы каждая точка обозначает 100 событий, а каждая группа из 100 точек обозначает 10 000 событий. Две группы обработаны, четыре группы продолжают ждать.
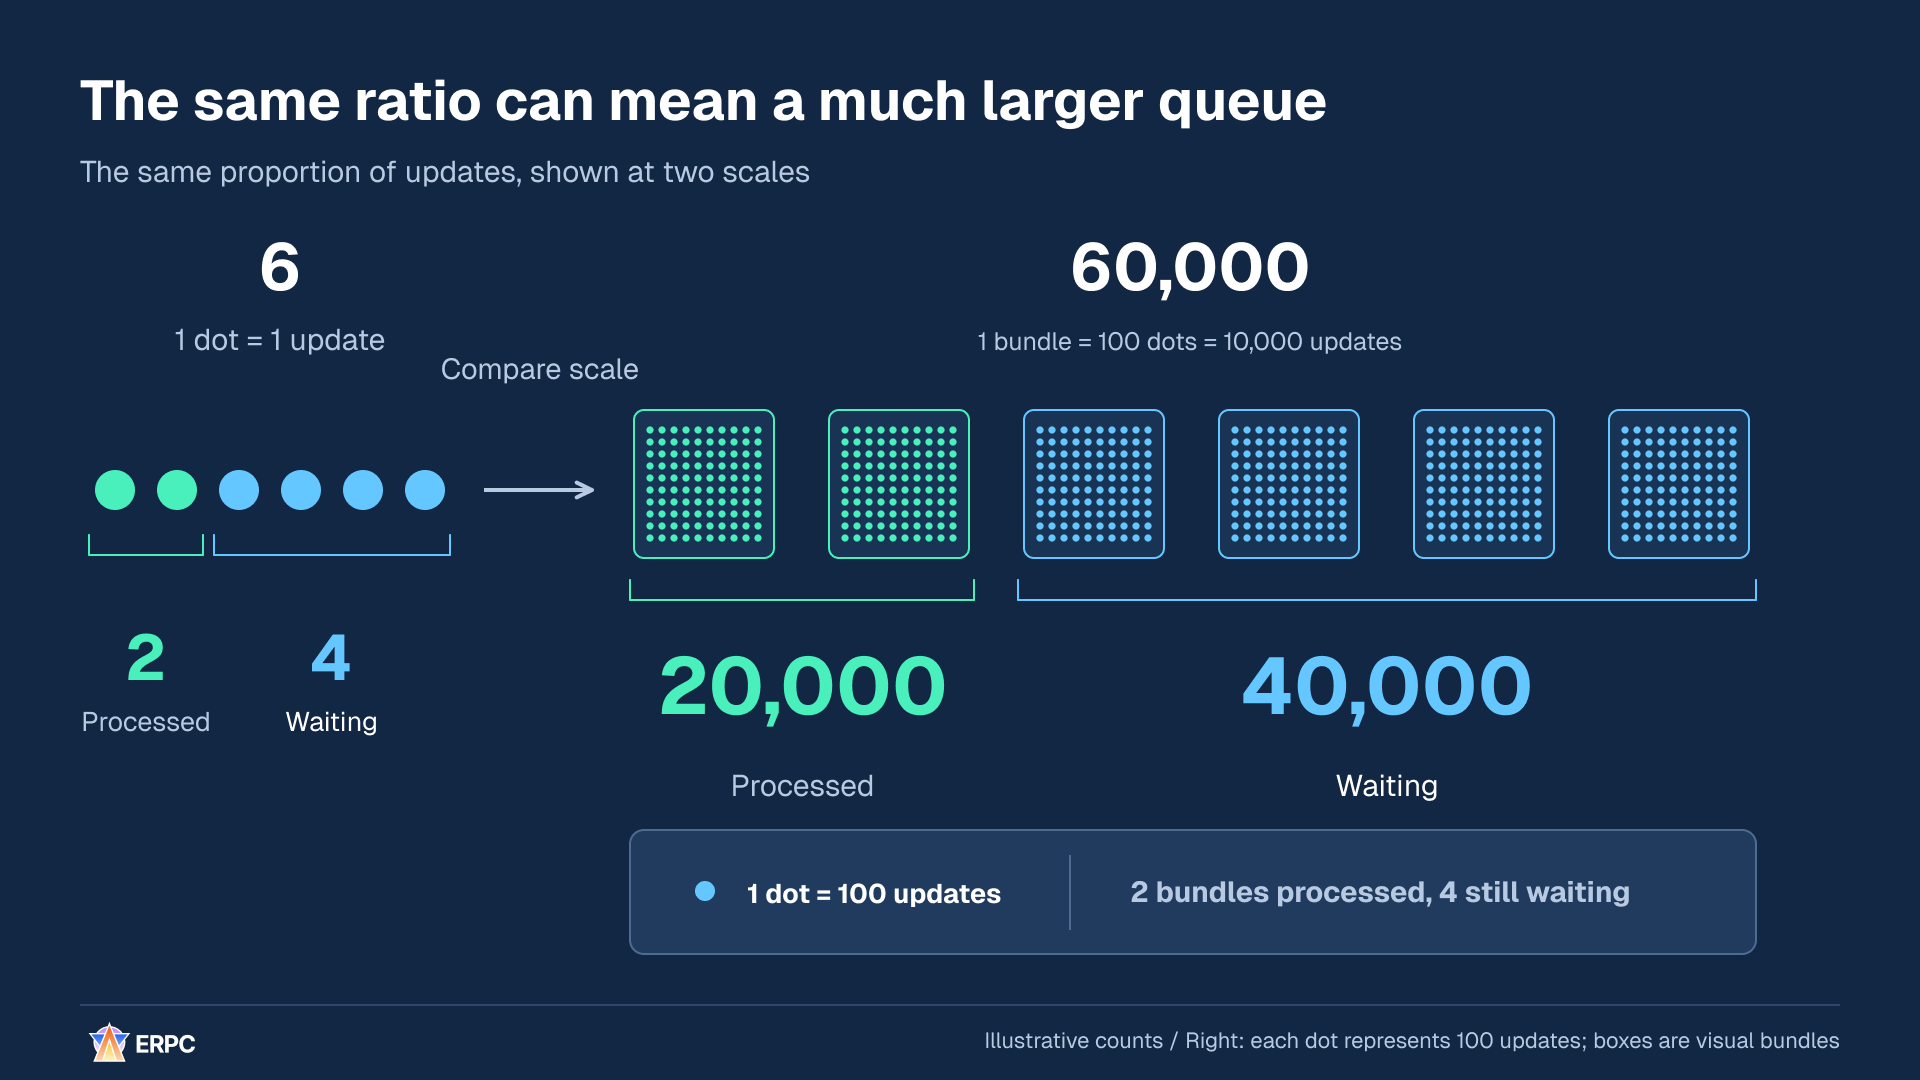
Группы справа помогают показать объём. Они не обозначают пакеты обработки в приложении.
Следующий интервал начинается с уже ожидающих 40 000 событий. Поступает ещё 60 000, обрабатывается 20 000, и остаётся 80 000. Следующий интервал заканчивается с 120 000. Новые цены вынуждены ждать за работой, которая уже стоит в очереди.
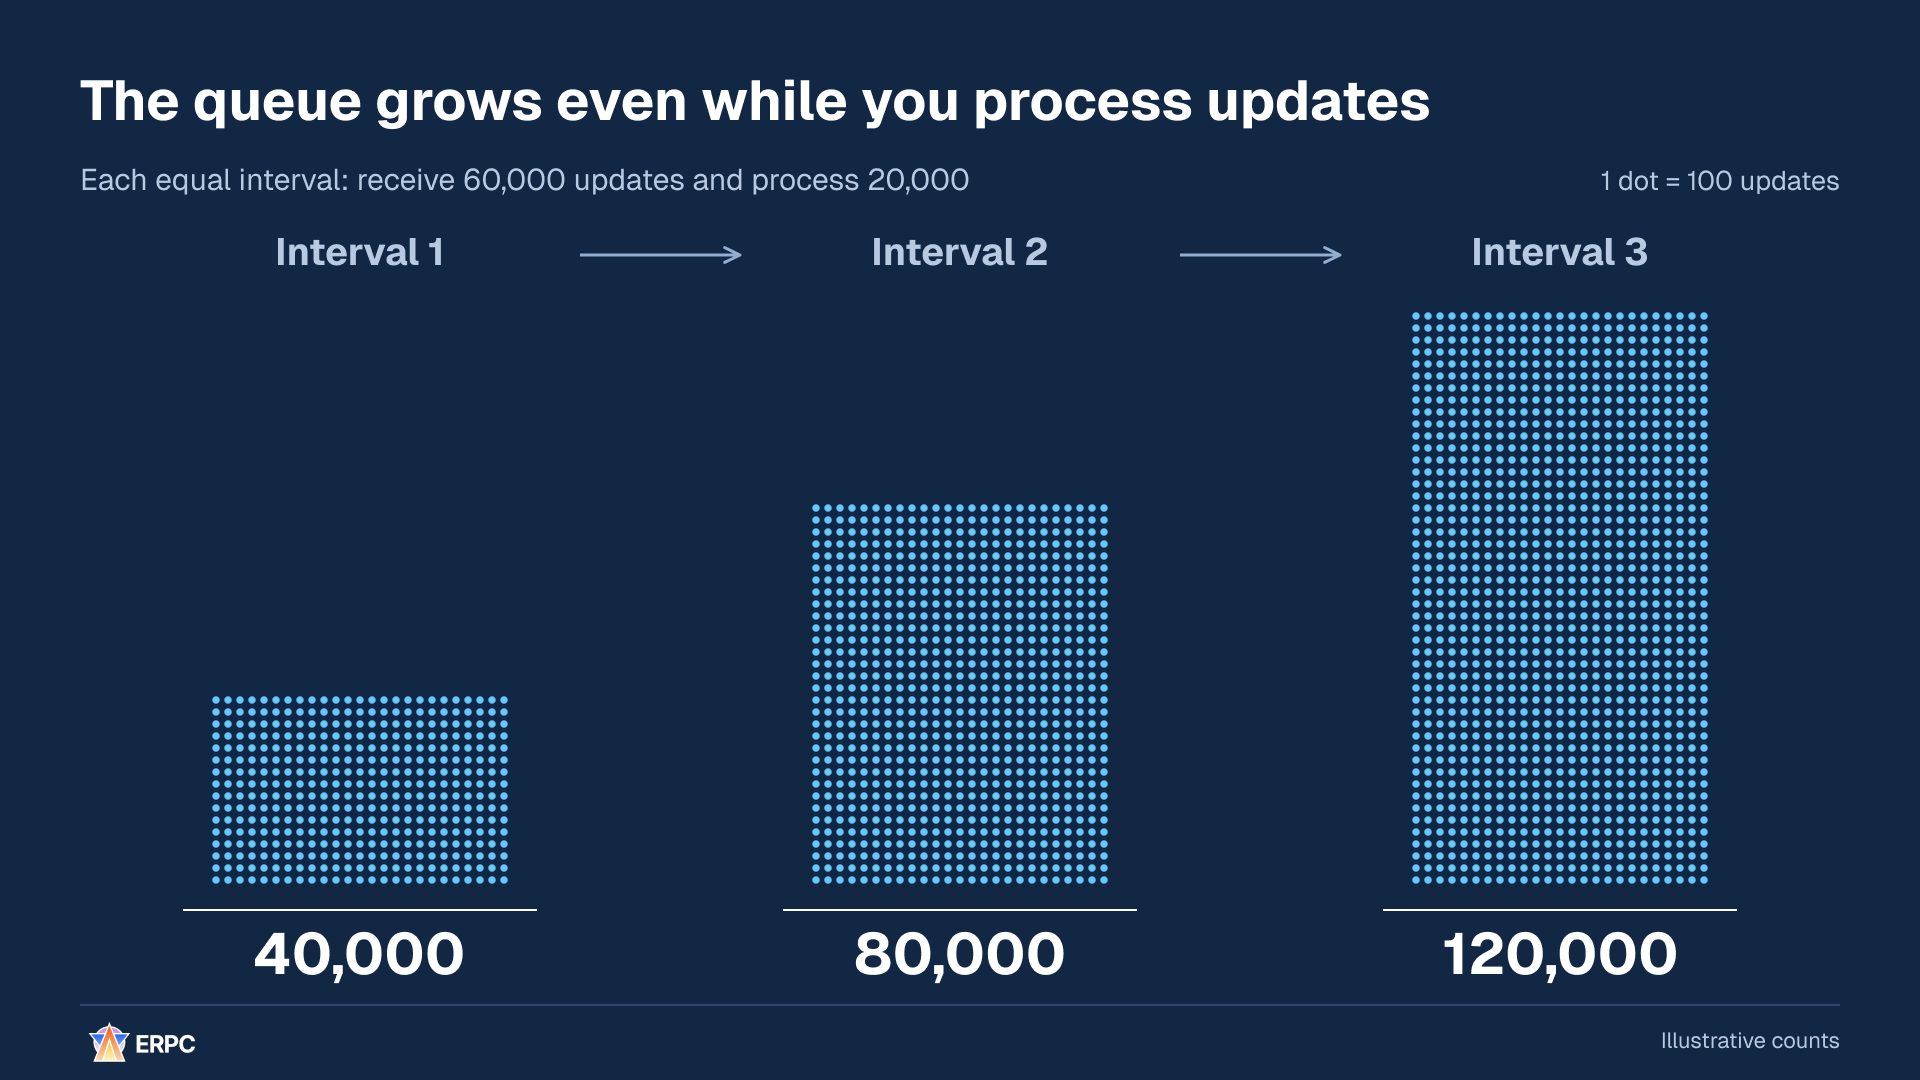
Если поступление данных постоянно превышает возможности обработки, очередь продолжает расти.
Очередь помогает сглаживать всплески: короткие периоды, когда данные поступают особенно интенсивно. Увеличение её ёмкости не устраняет устойчивый дефицит производительности, как в этом примере. Помимо числа хранимых элементов и байтов, отслеживайте, сколько ждёт самый старый элемент, и задайте допустимый предел. Если данные больше не отвечают требованиям к свежести, приостановите новые торговые решения, зависящие от этих значений, даже если ни одно обновление не потеряно.
Что должно произойти при достижении предела? На следующей схеме все восемь доступных мест уже заняты, когда поступают ещё два обновления. Если сохранить их нельзя, а для решения они необходимы, приложение больше не может корректно обновлять хранимые значения. Приостановите новые торговые решения, зависящие от этих значений, и возобновите их после восстановления необходимых обновлений.
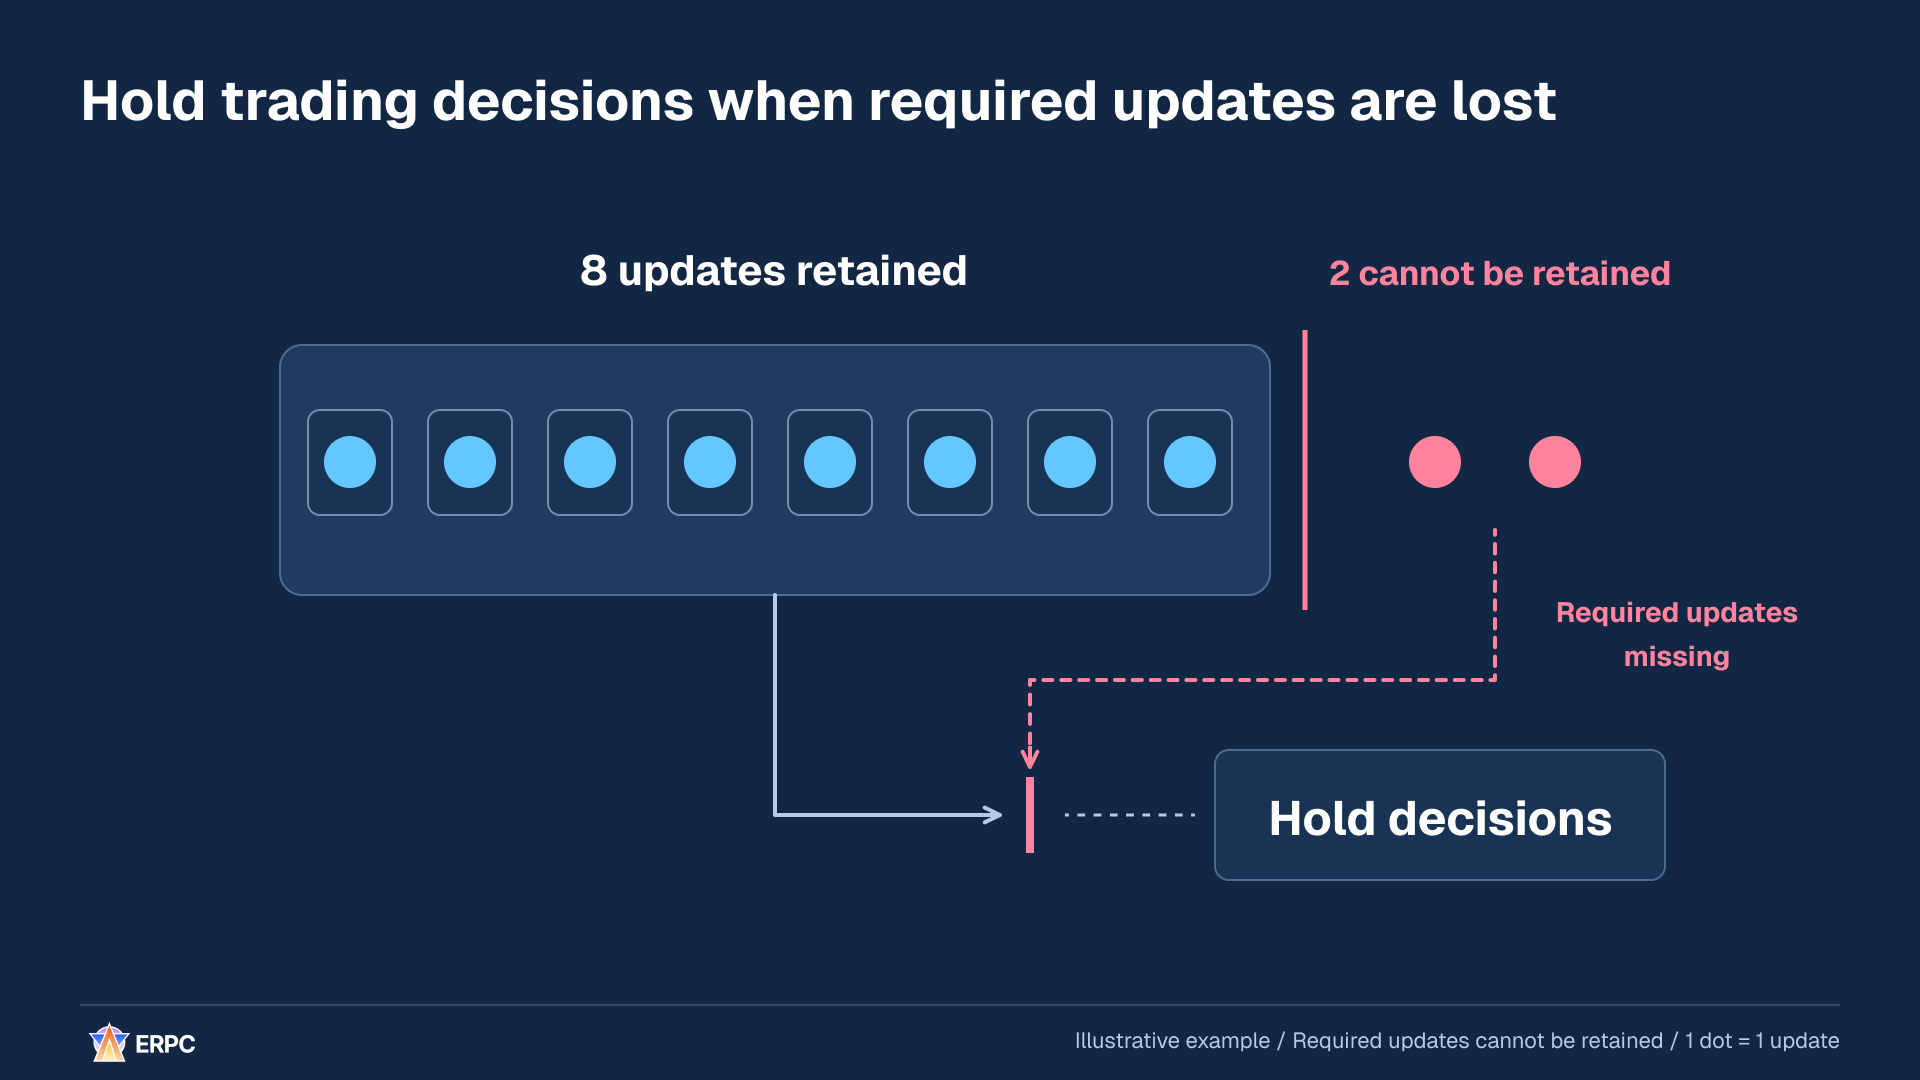
Архитектура очереди должна определять и то, что происходит после достижения её предела.
Проверьте, можно ли сократить объём работы или увеличить возможности обработки. Если потребителю нужно только последнее полное состояние одного и того же объекта, промежуточные значения иногда можно объединить, оставив последнее. Но если процесс накапливает изменения или использует промежуточные события, пропуск обновлений меняет результат.
Приостановка приёма также может перенести ожидание выше по потоку. Рассматривайте управление потоком gRPC, регулирующее темп отправки и приёма, вместе с серверными фильтрами, сужающими подписку, и реальными возможностями обработки приложения.[3][4]
Чтобы устранить накопление данных во входной очереди и улучшить их актуальность, скопируйте эти инструкции.
text
Улучшите обработку поступающих данных в этом приложении, когда обработка отстаёт, а данные для принятия решений устаревают.

Прочитайте README, инструкции по разработке, зависимости и код пути получение → очередь → обновление состояния → решение. Работайте с существующими языком, средой выполнения и SDK. Установите, содержат ли обновления полное состояние или изменения, каков необходимый порядок применения и какие требования предъявляются к актуальности.

1. Сохраните воспроизводимые входные данные без конфиденциальной информации и зафиксируйте исходные показатели. Исследуйте также ожидание до попадания в очередь. За один и тот же интервал измерьте число входящих и выходящих элементов и байтов, объём работы в очереди, возраст самого старого ожидающего элемента и работу в процессе выполнения.
2. Определите и реализуйте ограничения на элементы, байты, время ожидания и параллелизм, обосновав каждое. Укажите допущения там, где требования неизвестны. Проверьте, можно ли сократить ненужное получение или обработку и достаточно ли возможностей обработки. Не считайте одно лишь увеличение очереди решением устойчивого дефицита производительности обработки.
3. Определите поведение при заполнении очереди. Если необходимые обновления невозможно сохранить или требуемая актуальность утрачена даже без пропуска обновлений, приостановите новые торговые решения, зависящие от этих значений. Продолжайте обновление и восстановление состояния и проверяйте условия возобновления.
4. При объединении промежуточных значений установите, что последнего полного состояния той же сущности достаточно для сохранения результата. Не отбрасывайте молча необходимые изменения или события. Если получение приостанавливается, проверьте поведение управления потоком у провайдера и куда перемещается ожидание.
5. Воспроизведите обычный поток, всплески, устойчивую перегрузку и восстановление после заполнения очереди в сопоставимых условиях. Сравните скорости поступления и обработки, возраст самого старого элемента, p50/p95/p99 от получения до завершения решения, CPU и память, пропущенные или отброшенные обновления. Сопоставьте применённое состояние и решения с ожидаемыми результатами. Для измерения прошедшего времени внутри одного хоста используйте монотонные часы и укажите начальную и конечную точки измерения.

Сохраняйте существующие согласования, полномочия и процедуры разработки. Не считайте эти инструкции сами по себе дополнительным разрешением изменять производственную среду, заключать платные договоры или совершать реальные торговые операции. Не выводите приватные ключи, учётные данные или данные клиентов.

Сообщите об изменениях, условиях сравнения, измерениях до и после, проверках корректности и оставшихся ограничениях. Значения, которые нельзя измерить, отметьте как неизмеренные.
Улучшите обработку поступающих данных в этом приложении, когда обработка отстаёт, а данные для принятия решений устаревают.
Прочитайте README, инструкции по разработке, зависимости и код пути получение → очередь → обновление состояния → решение. Работайте с существующими языком, средой выполнения и SDK. Установите, содержат ли обновления полное состояние или изменения, каков необходимый порядок применения и какие требования предъявляются к актуальности.
1. Сохраните воспроизводимые входные данные без конфиденциальной информации и зафиксируйте исходные показатели. Исследуйте также ожидание до попадания в очередь. За один и тот же интервал измерьте число входящих и выходящих элементов и байтов, объём работы в очереди, возраст самого старого ожидающего элемента и работу в процессе выполнения.
2. Определите и реализуйте ограничения на элементы, байты, время ожидания и параллелизм, обосновав каждое. Укажите допущения там, где требования неизвестны. Проверьте, можно ли сократить ненужное получение или обработку и достаточно ли возможностей обработки. Не считайте одно лишь увеличение очереди решением устойчивого дефицита производительности обработки.
3. Определите поведение при заполнении очереди. Если необходимые обновления невозможно сохранить или требуемая актуальность утрачена даже без пропуска обновлений, приостановите новые торговые решения, зависящие от этих значений. Продолжайте обновление и восстановление состояния и проверяйте условия возобновления.
4. При объединении промежуточных значений установите, что последнего полного состояния той же сущности достаточно для сохранения результата. Не отбрасывайте молча необходимые изменения или события. Если получение приостанавливается, проверьте поведение управления потоком у провайдера и куда перемещается ожидание.
5. Воспроизведите обычный поток, всплески, устойчивую перегрузку и восстановление после заполнения очереди в сопоставимых условиях. Сравните скорости поступления и обработки, возраст самого старого элемента, p50/p95/p99 от получения до завершения решения, CPU и память, пропущенные или отброшенные обновления. Сопоставьте применённое состояние и решения с ожидаемыми результатами. Для измерения прошедшего времени внутри одного хоста используйте монотонные часы и укажите начальную и конечную точки измерения.
Сохраняйте существующие согласования, полномочия и процедуры разработки. Не считайте эти инструкции сами по себе дополнительным разрешением изменять производственную среду, заключать платные договоры или совершать реальные торговые операции. Не выводите приватные ключи, учётные данные или данные клиентов.
Сообщите об изменениях, условиях сравнения, измерениях до и после, проверках корректности и оставшихся ограничениях. Значения, которые нельзя измерить, отметьте как неизмеренные.2. Обрабатывайте следующую цену, не дожидаясь сохранения записи
Рассмотрим изменение рыночной цены со 100 на 101. Приложение уже применило 100, завершило принятие решения и сохраняет аналитическую запись. Если цикл обработки входящих данных ждёт завершения сохранения, он не сможет применить 101, даже когда обновление поступит. В приложении останется цена 100.
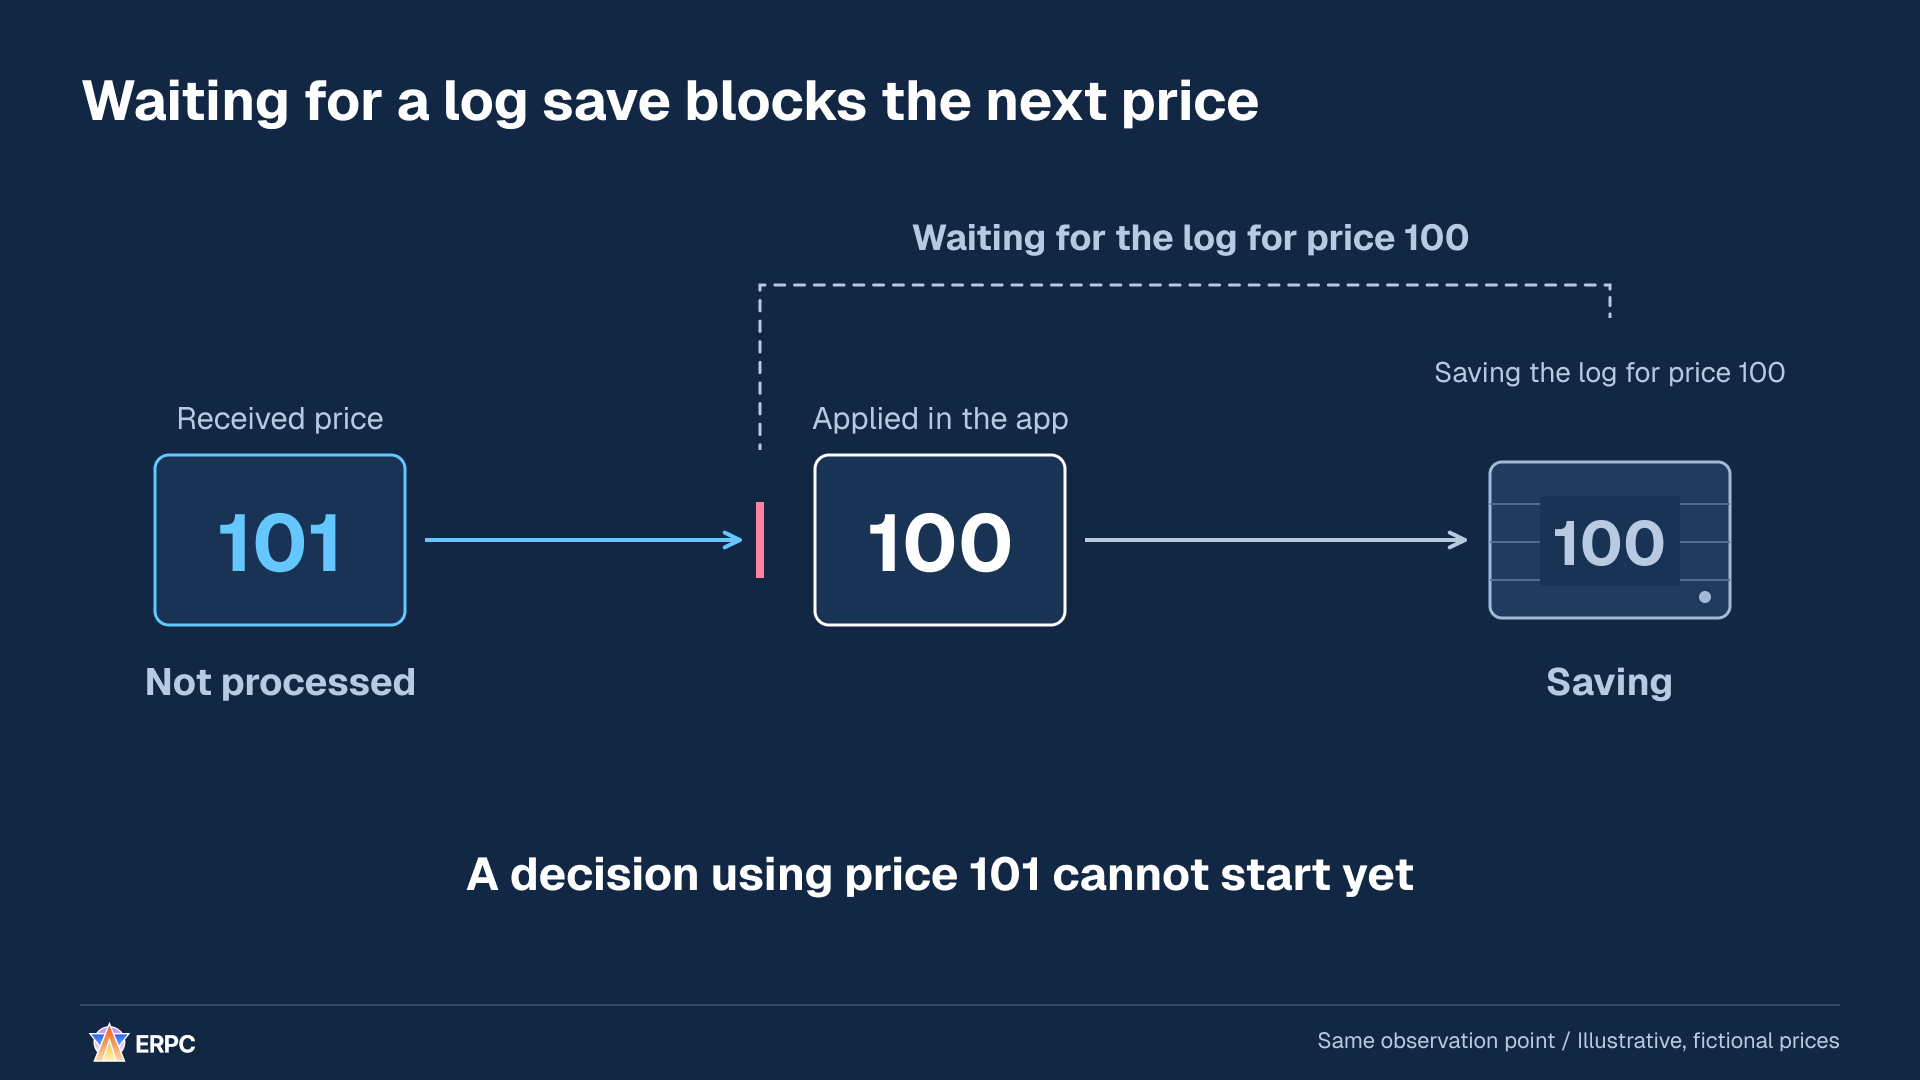
Обработка 101 не начинается из-за ожидания записи для 100.
Теперь передадим аналитическую запись во вспомогательную очередь, где есть свободное место, а сохранение поручим отдельной операции. После завершения передачи принимающий цикл может вернуться к следующему входному событию. Он сможет применить 101 и перейти к решению, пока сохранение для 100 ещё продолжается.
В следующем сравнении длительность сохранения для 100, момент поступления 101 и время обработки 101 одинаковы. Меняется только то, зависит ли переход к следующему входному событию от завершения сохранения.
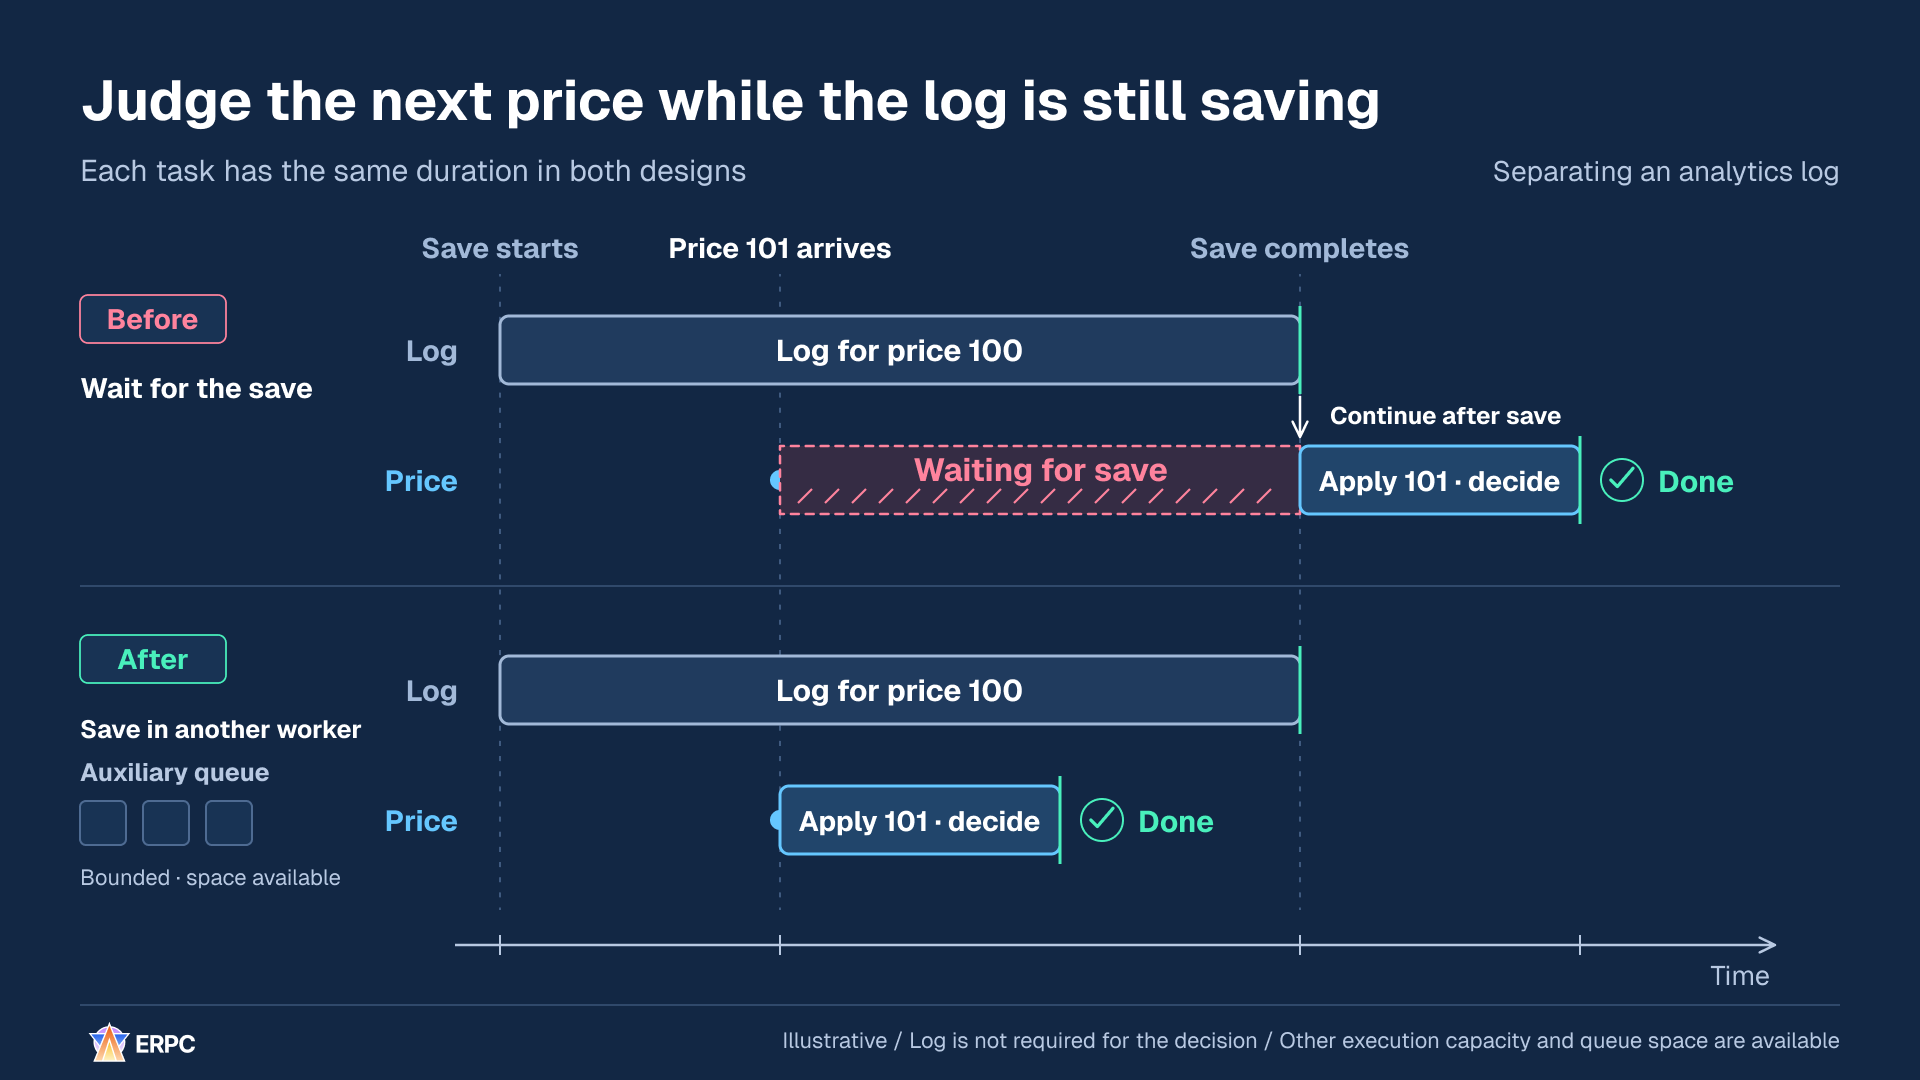
Даже не сокращая саму работу для 101, можно уменьшить ожидание до её начала.
Путь обработки, необходимый от получения данных до принятия решения и отправки, называется hot path. В этом примере с него убирается аналитическое логирование, которое не обязано задерживать решение. Проверки баланса, проверки лимитов риска и сохранение, которое должно завершиться для обеспечения корректности, остаются там, где этого требуют условия работы.
Работа по сохранению никуда не исчезает, поэтому вспомогательной очереди тоже нужны ограничения ёмкости и времени ожидания. Отдельная задача не обязательно выполняется на отдельном CPU. Длительные вычислительные или блокирующие операции в Tokio, как и длительные синхронные операции в цикле событий Node.js, могут мешать продвижению другой работы. Перенося работу, проверяйте, где она действительно будет выполняться.[1][2]
Чтобы отделить ожидание сохранения аналитических записей от пути принятия решений, скопируйте эти инструкции.
text
Улучшите это приложение там, где ожидание сохранения аналитических записей мешает применить следующее обновление или использовать его для решения.

Прочитайте README, инструкции по разработке, зависимости и принимающий цикл. Работайте с существующими языком, средой выполнения и библиотекой хранения. Найдите ожидания завершения сохранения и определите потоки, задачи или циклы событий, в которых работа действительно выполняется.

1. Подготовьте воспроизводимые входные данные без конфиденциальной информации. Зафиксируйте получение, применение к состоянию, начало и завершение решения, начало и завершение сохранения и текущие результаты.
2. На основании требований установите, обязательно ли завершение сохранения для решений или восстановления. Оставьте проверки баланса, риска и необходимое для корректности долговременное сохранение там, где они нужны. Отделите аналитические записи, сохранение которых может завершиться позже.
3. Определите передачу записей так, чтобы последующие изменения состояния не могли изменить записываемые значения. Реализуйте ограниченную вспомогательную очередь и обработчик, сохраняющий её элементы. Укажите ограничения на элементы, байты и время ожидания; поведение при заполнении очереди, ошибках сохранения, повторных попытках и завершении работы; требования к хранению. Не отбрасывайте записи, пока требования к их хранению неизвестны.
4. Не предполагайте, что отдельная задача выполняется на другом CPU. Проверьте место выполнения синхронного I/O и длительных вычислений. При использовании рабочих потоков или аналогичных механизмов ограничьте параллелизм и учитывайте преобразование, копирование и ожидание передачи работы.
5. На одинаковых входных данных и с одинаковым темпом поступления воспроизведите обычное и медленное сохранение, ошибки, заполнение вспомогательной очереди и завершение работы. Сравните p50/p95/p99 от получения до завершения решения, ожидание и накопление на стороне сохранения, CPU и память, отсутствующие или дублирующиеся записи. Проверьте корректность состояния и решений и соблюдение требований к хранению записей. Для измерения прошедшего времени внутри одного хоста используйте монотонные часы и укажите начальную и конечную точки измерения.

Сохраняйте существующие согласования, полномочия и процедуры разработки. Не считайте эти инструкции сами по себе дополнительным разрешением изменять производственную среду, заключать платные договоры или совершать реальные торговые операции. Не выводите приватные ключи, учётные данные или данные клиентов.

Сообщите об изменениях, условиях сравнения, измерениях до и после, проверках корректности и оставшихся ограничениях. Значения, которые нельзя измерить, отметьте как неизмеренные.
Улучшите это приложение там, где ожидание сохранения аналитических записей мешает применить следующее обновление или использовать его для решения.
Прочитайте README, инструкции по разработке, зависимости и принимающий цикл. Работайте с существующими языком, средой выполнения и библиотекой хранения. Найдите ожидания завершения сохранения и определите потоки, задачи или циклы событий, в которых работа действительно выполняется.
1. Подготовьте воспроизводимые входные данные без конфиденциальной информации. Зафиксируйте получение, применение к состоянию, начало и завершение решения, начало и завершение сохранения и текущие результаты.
2. На основании требований установите, обязательно ли завершение сохранения для решений или восстановления. Оставьте проверки баланса, риска и необходимое для корректности долговременное сохранение там, где они нужны. Отделите аналитические записи, сохранение которых может завершиться позже.
3. Определите передачу записей так, чтобы последующие изменения состояния не могли изменить записываемые значения. Реализуйте ограниченную вспомогательную очередь и обработчик, сохраняющий её элементы. Укажите ограничения на элементы, байты и время ожидания; поведение при заполнении очереди, ошибках сохранения, повторных попытках и завершении работы; требования к хранению. Не отбрасывайте записи, пока требования к их хранению неизвестны.
4. Не предполагайте, что отдельная задача выполняется на другом CPU. Проверьте место выполнения синхронного I/O и длительных вычислений. При использовании рабочих потоков или аналогичных механизмов ограничьте параллелизм и учитывайте преобразование, копирование и ожидание передачи работы.
5. На одинаковых входных данных и с одинаковым темпом поступления воспроизведите обычное и медленное сохранение, ошибки, заполнение вспомогательной очереди и завершение работы. Сравните p50/p95/p99 от получения до завершения решения, ожидание и накопление на стороне сохранения, CPU и память, отсутствующие или дублирующиеся записи. Проверьте корректность состояния и решений и соблюдение требований к хранению записей. Для измерения прошедшего времени внутри одного хоста используйте монотонные часы и укажите начальную и конечную точки измерения.
Сохраняйте существующие согласования, полномочия и процедуры разработки. Не считайте эти инструкции сами по себе дополнительным разрешением изменять производственную среду, заключать платные договоры или совершать реальные торговые операции. Не выводите приватные ключи, учётные данные или данные клиентов.
Сообщите об изменениях, условиях сравнения, измерениях до и после, проверках корректности и оставшихся ограничениях. Значения, которые нельзя измерить, отметьте как неизмеренные.3. Не заставляйте независимые обновления ждать одну блокировку
Рассмотрим приложение, в котором цены рынков A и B можно обновлять независимо. Обновление B поступает после начала обновления A. Если один mutex защищает и A, и B, обновление B вынуждено ждать, пока A освободит эту блокировку.
Mutex предоставляет право доступа к защищённым данным только одной операции в каждый момент времени. Если им уже пользуется другая операция, попытка захватить ту же блокировку приводит к ожиданию.[17]
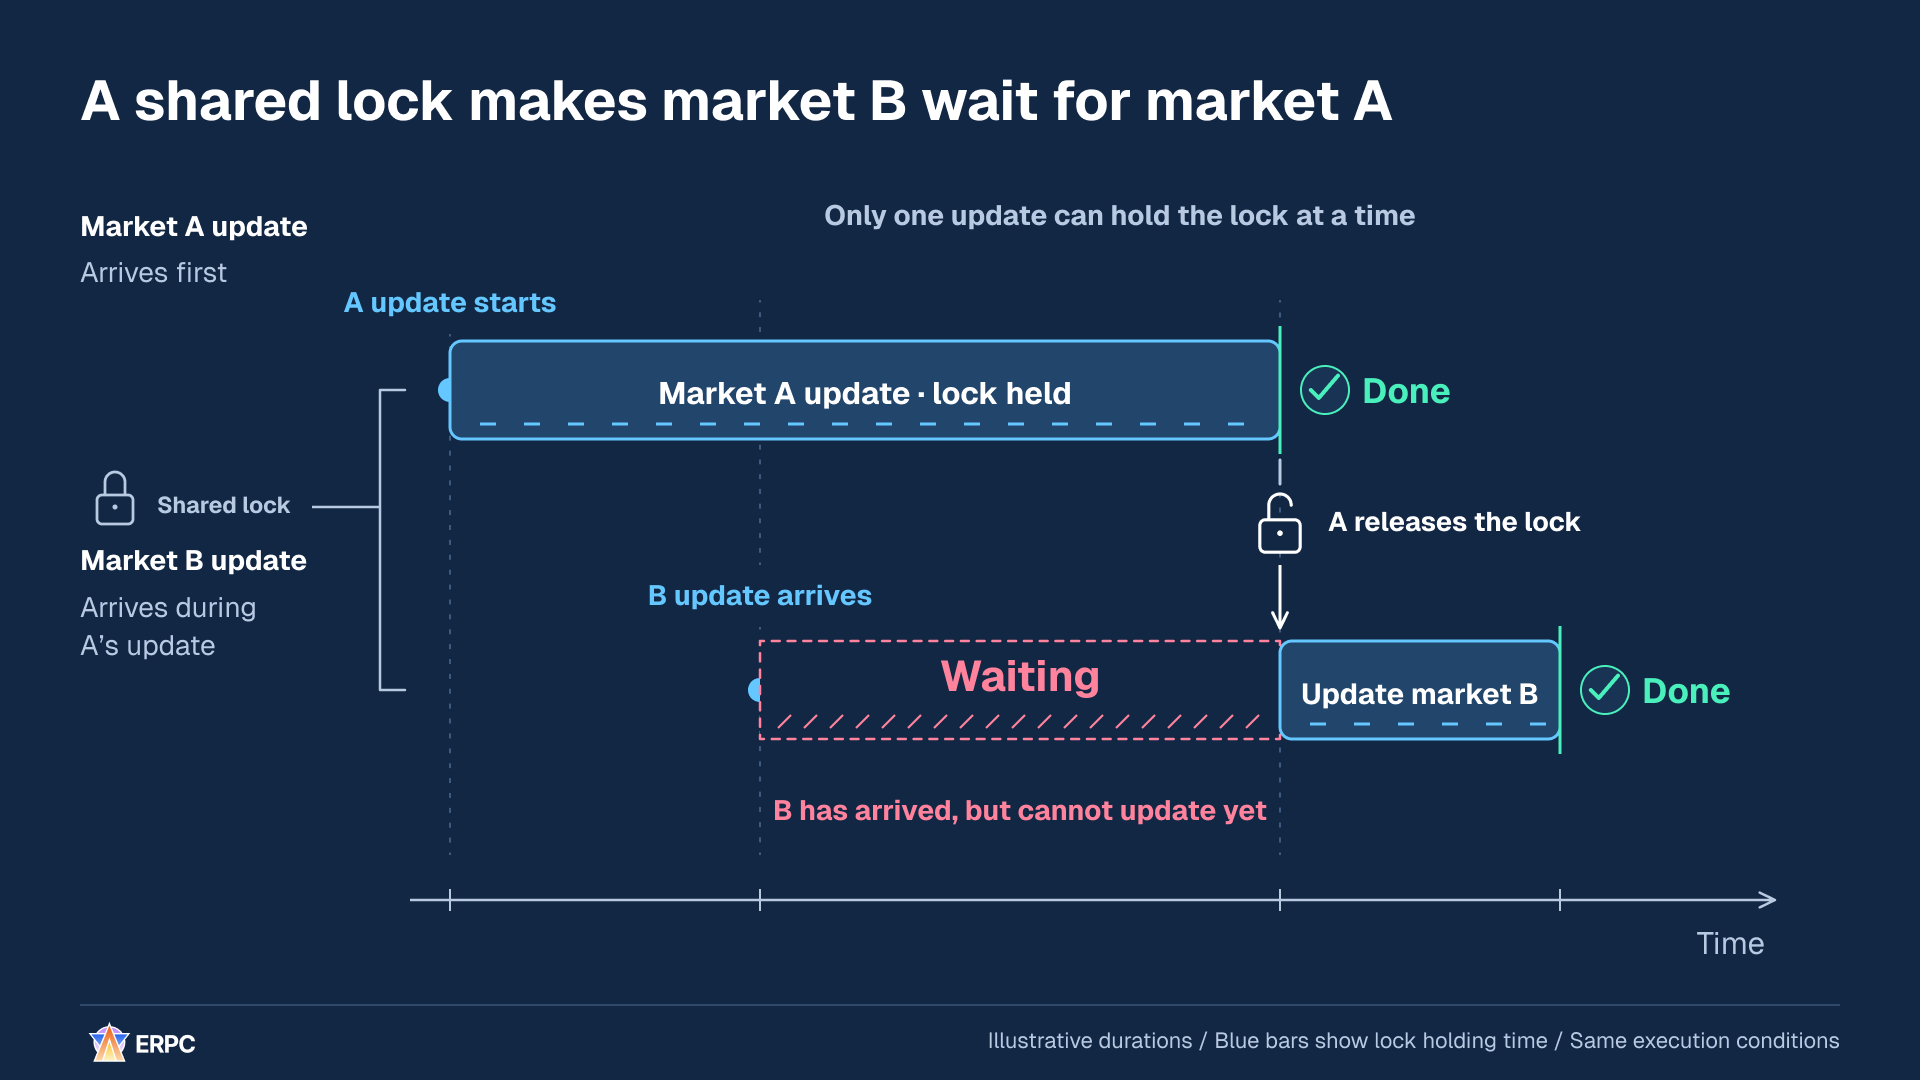
Данные B уже поступили, но ждут общую блокировку, которую удерживает A.
Если A и B изменяют отдельные значения, один из вариантов заключается в защите разными блокировками. В верхней половине следующей схемы используется общая блокировка, в нижней половине блокировки разделены. Моменты поступления и длительности удержания блокировок для A и B одинаковы в обеих половинах. Пример предполагает, что блокировка B свободна и для B есть доступные вычислительные ресурсы. Официальное руководство Tokio также описывает разделение mutex для данных с независимыми ключами.[18]
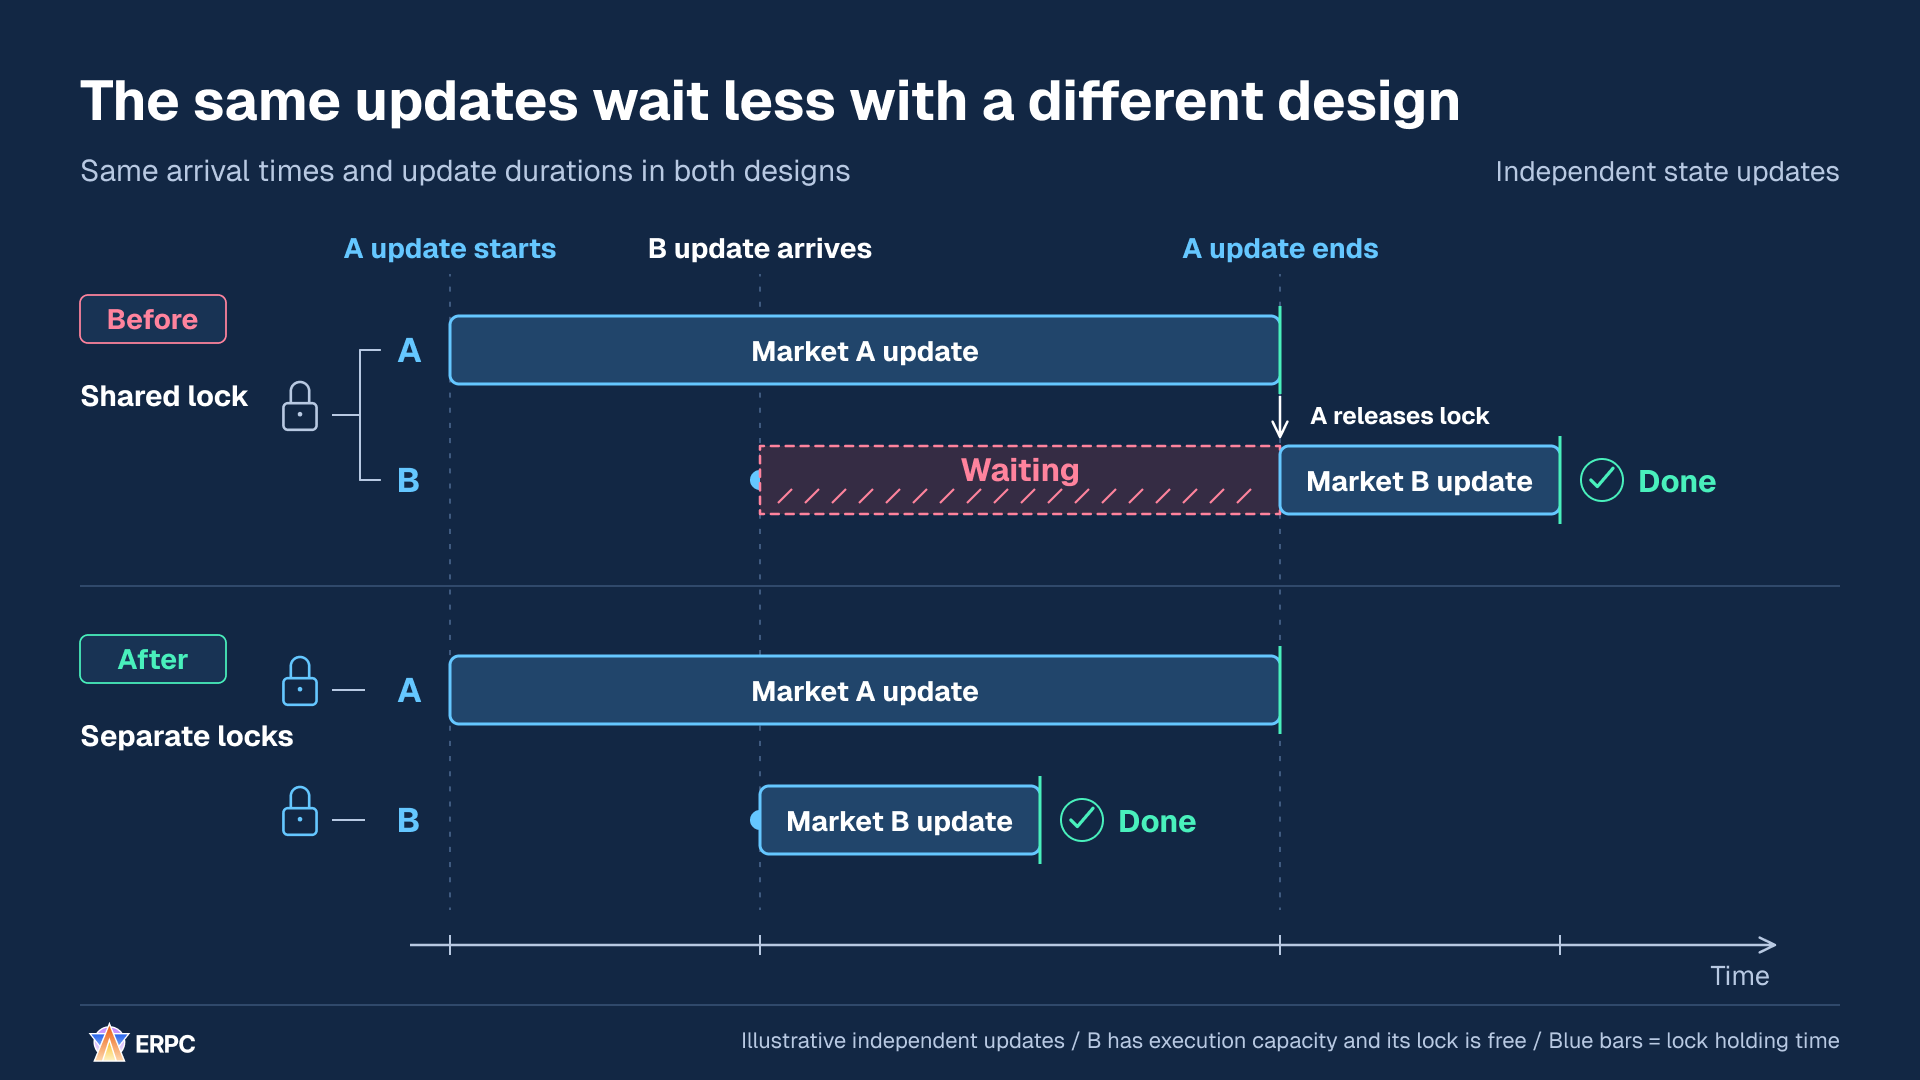
Синяя полоса B имеет ту же длину. Исчезает розовый интервал ожидания перед ней.
Синяя полоса показывает время от захвата блокировки до её освобождения. В этом примере B заканчивает, пока A ещё обновляется. Раздельные блокировки не устраняют ожидание, вызванное занятостью собственной блокировки B или тем, что доступные вычислительные ресурсы заняты другой работой.
Прежде чем разделять блокировку, установите, какие обновления независимы. Даже если цены A и B можно обновлять отдельно, решению, использующему обе цены или общий баланс, всё равно нужен способ согласованно прочитать необходимые значения. Пока операция приостановлена на await, значения могут измениться даже в том же потоке. Определите, какие версии читает решение, как именно оно их читает и в каком порядке применяются обновления.
Например, если A и B читают один и тот же баланс и каждое строит ордер, оба могут рассчитывать потратить одни и те же средства. Общим значениям по-прежнему нужна собственная защита: например, единственный владелец, который последовательно для каждого ордера проверяет баланс и резервирует средства.
Другой вариант состоит в том, чтобы назначить каждому состоянию единственного владельца обновления и отправлять ему сообщения об изменениях. Это принцип Single Writer. Разделение блокировок и выбор единственного писателя являются отдельными архитектурными решениями. LMAX Disruptor описывает Single Writer и зависимости обработки, а Tokio описывает управление состоянием через сообщения выделенной задаче.[5][18]
Чтобы сократить ожидание блокировок между независимыми обновлениями, скопируйте эти инструкции.
text
Улучшите это приложение там, где обновление одного рынка или ключа заставляет независимое обновление ждать ту же общую блокировку.

Прочитайте README, инструкции по разработке, зависимости и код, который читает или записывает состояние, захватывает блокировки или ожидает другую работу через await. Используйте существующие язык и среду выполнения. Определите, кто обновляет каждое значение и какие наборы значений читает каждое решение.

1. Сохраните воспроизводимые входные данные без конфиденциальной информации и зафиксируйте исходные показатели. Для блокировок с конкуренцией регистрируйте поступления по ключам, ожидание захвата, время удержания, порядок обновлений и версии состояния, использованные в решениях.
2. Отделите независимо обновляемые значения от значений, согласованность которых необходимо защищать совместно. Разделите блокировки вокруг независимого состояния и явно определите порядок применения и ответственность за запись для каждого ключа. Держите под контролем число блокировок или ответственных за обработку.
3. Защитите решения, затрагивающие несколько рынков, и общие балансы или резервирование средств. Сделайте проверку баланса и резервирование одной согласованной операцией, чтобы несколько заявок не могли по отдельности считать одни и те же средства доступными. Если нужно несколько блокировок, определите порядок их захвата.
4. Исследуйте изменения состояния по обе стороны await и порядок завершения параллельного декодирования. Определите, какие версии читает решение и как оно их читает. Не допускайте подмены необходимого порядка применения порядком завершения декодирования. После разделения блокировок проверьте, не сохраняется ли ожидание из-за ограниченных ресурсов выполнения или конкуренции по одному ключу.
5. Воспроизведите одинаковые входные данные и порядок поступления с независимыми ключами, концентрацией обновлений на одном ключе, конкурирующими резервированиями общих средств и приостановкой и возобновлением работы. Сравните ожидание блокировок, p50/p95/p99 от получения до завершения решения, CPU и память. Проверьте необходимый порядок обновлений, согласованность состояния при решении и отсутствие двойного резервирования. Для измерения прошедшего времени внутри одного хоста используйте монотонные часы и укажите начальную и конечную точки измерения.

Сохраняйте существующие согласования, полномочия и процедуры разработки. Не считайте эти инструкции сами по себе дополнительным разрешением изменять производственную среду, заключать платные договоры или совершать реальные торговые операции. Не выводите приватные ключи, учётные данные или данные клиентов.

Сообщите об изменениях, условиях сравнения, измерениях до и после, проверках корректности и оставшихся ограничениях. Значения, которые нельзя измерить, отметьте как неизмеренные.
Улучшите это приложение там, где обновление одного рынка или ключа заставляет независимое обновление ждать ту же общую блокировку.
Прочитайте README, инструкции по разработке, зависимости и код, который читает или записывает состояние, захватывает блокировки или ожидает другую работу через await. Используйте существующие язык и среду выполнения. Определите, кто обновляет каждое значение и какие наборы значений читает каждое решение.
1. Сохраните воспроизводимые входные данные без конфиденциальной информации и зафиксируйте исходные показатели. Для блокировок с конкуренцией регистрируйте поступления по ключам, ожидание захвата, время удержания, порядок обновлений и версии состояния, использованные в решениях.
2. Отделите независимо обновляемые значения от значений, согласованность которых необходимо защищать совместно. Разделите блокировки вокруг независимого состояния и явно определите порядок применения и ответственность за запись для каждого ключа. Держите под контролем число блокировок или ответственных за обработку.
3. Защитите решения, затрагивающие несколько рынков, и общие балансы или резервирование средств. Сделайте проверку баланса и резервирование одной согласованной операцией, чтобы несколько заявок не могли по отдельности считать одни и те же средства доступными. Если нужно несколько блокировок, определите порядок их захвата.
4. Исследуйте изменения состояния по обе стороны await и порядок завершения параллельного декодирования. Определите, какие версии читает решение и как оно их читает. Не допускайте подмены необходимого порядка применения порядком завершения декодирования. После разделения блокировок проверьте, не сохраняется ли ожидание из-за ограниченных ресурсов выполнения или конкуренции по одному ключу.
5. Воспроизведите одинаковые входные данные и порядок поступления с независимыми ключами, концентрацией обновлений на одном ключе, конкурирующими резервированиями общих средств и приостановкой и возобновлением работы. Сравните ожидание блокировок, p50/p95/p99 от получения до завершения решения, CPU и память. Проверьте необходимый порядок обновлений, согласованность состояния при решении и отсутствие двойного резервирования. Для измерения прошедшего времени внутри одного хоста используйте монотонные часы и укажите начальную и конечную точки измерения.
Сохраняйте существующие согласования, полномочия и процедуры разработки. Не считайте эти инструкции сами по себе дополнительным разрешением изменять производственную среду, заключать платные договоры или совершать реальные торговые операции. Не выводите приватные ключи, учётные данные или данные клиентов.
Сообщите об изменениях, условиях сравнения, измерениях до и после, проверках корректности и оставшихся ограничениях. Значения, которые нельзя измерить, отметьте как неизмеренные.4. Подготовьте неизменные части заранее, чтобы сократить работу после поступления данных
Предположим, при каждом обновлении цены приложение разбирает один и тот же фиксированный ID, вычисляет фиксированный адрес из одинаковых входных данных и выделяет рабочую память. Эту рабочую память также называют буфером. Повторение этих трёх подготовительных действий добавляет время подготовки неизменной информации на путь к каждому решению.
Подготовку, входные данные которой не меняются, можно завершить до поступления события и использовать повторно. После поступления приложение проверяет информацию, изменившуюся для текущего события, формирует окончательное отправляемое сообщение и подписывает его содержимое.
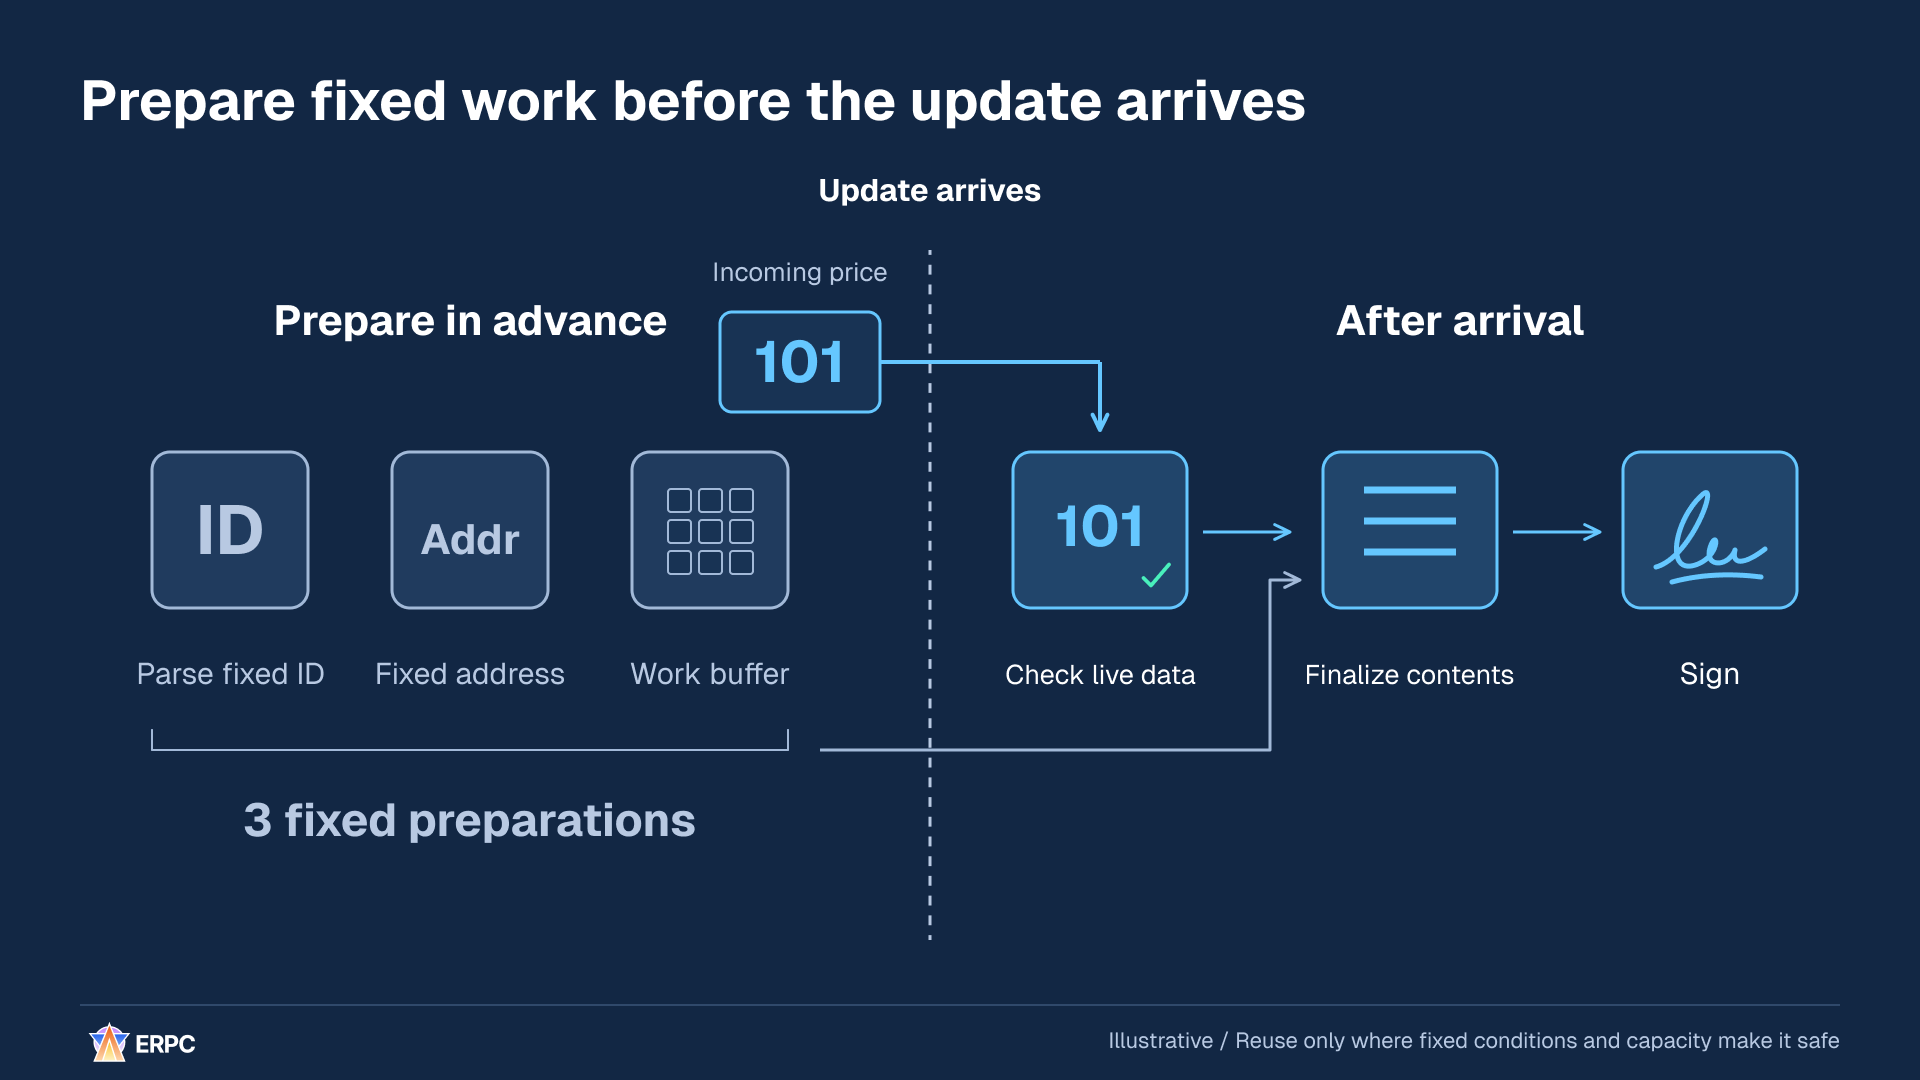
Перенесите неизменную подготовку на более ранний этап, оставив проверку актуального содержимого и подписание после поступления данных.
Посчитаем изменения для трёх обновлений. Если три вида подготовки выполняются для каждого события, получается девять подготовительных операций. Если выполнить эти три вида подготовки один раз и последовательно использовать результаты повторно, получится три операции. При обеих архитектурах поступает три события, они обрабатываются по одному и дают три результата.
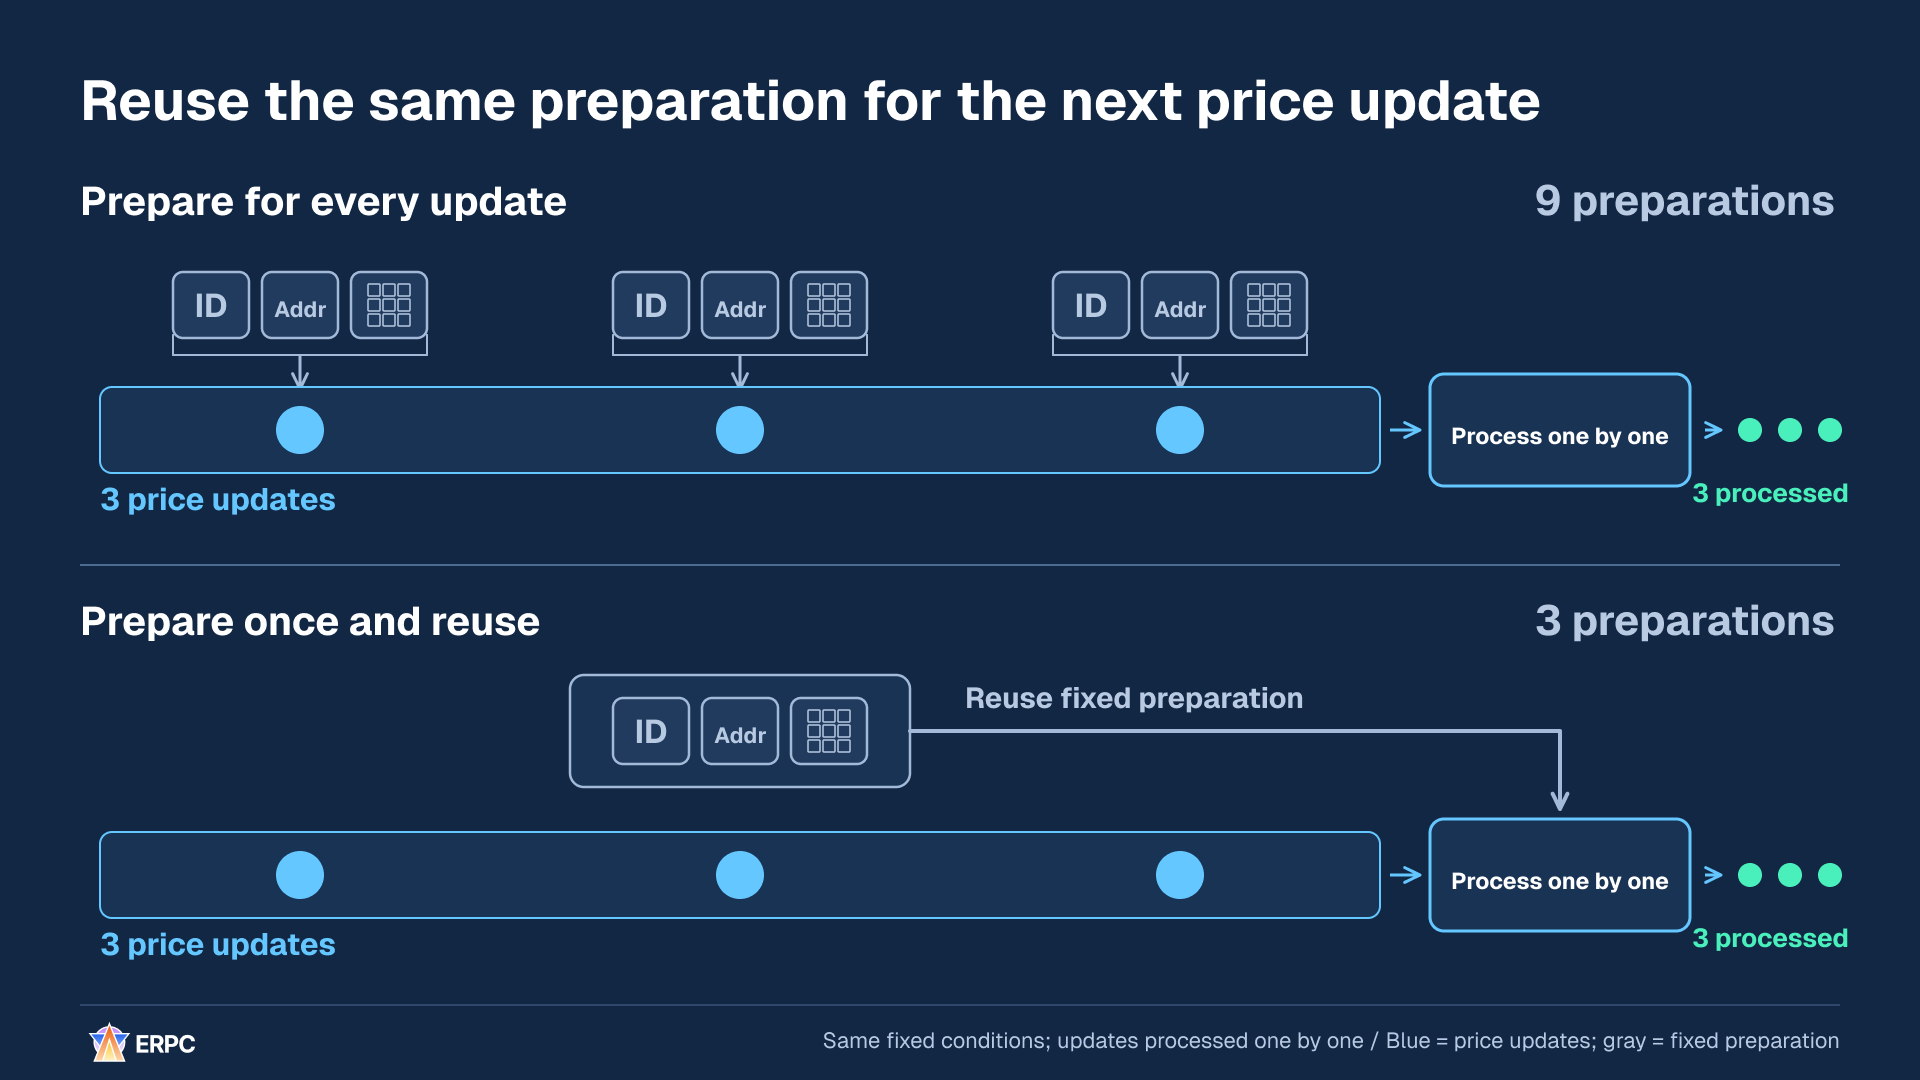
Число событий остаётся равным трём, а число операций фиксированной подготовки в этом примере снижается с девяти до трёх.
Сравнение предполагает, что фиксированные условия не меняются, а рабочую память можно безопасно использовать повторно в последовательной обработке. При этом её содержимое каждый раз обновляется для текущего события. Если несколько операций выполняются одновременно, используйте для каждой отдельную область памяти или пул, управляющий доступом, чтобы операции не перезаписывали одну и ту же память.
Расширим тот же пример до 1 000 событий. Три вида подготовки для каждого события дают 3 000 подготовительных операций; однократная общая подготовка даёт три. Обе архитектуры получают 1 000 событий, обрабатывают их по одному и выдают 1 000 результатов. Учитывайте число подготовительных операций отдельно от числа обрабатываемых событий.
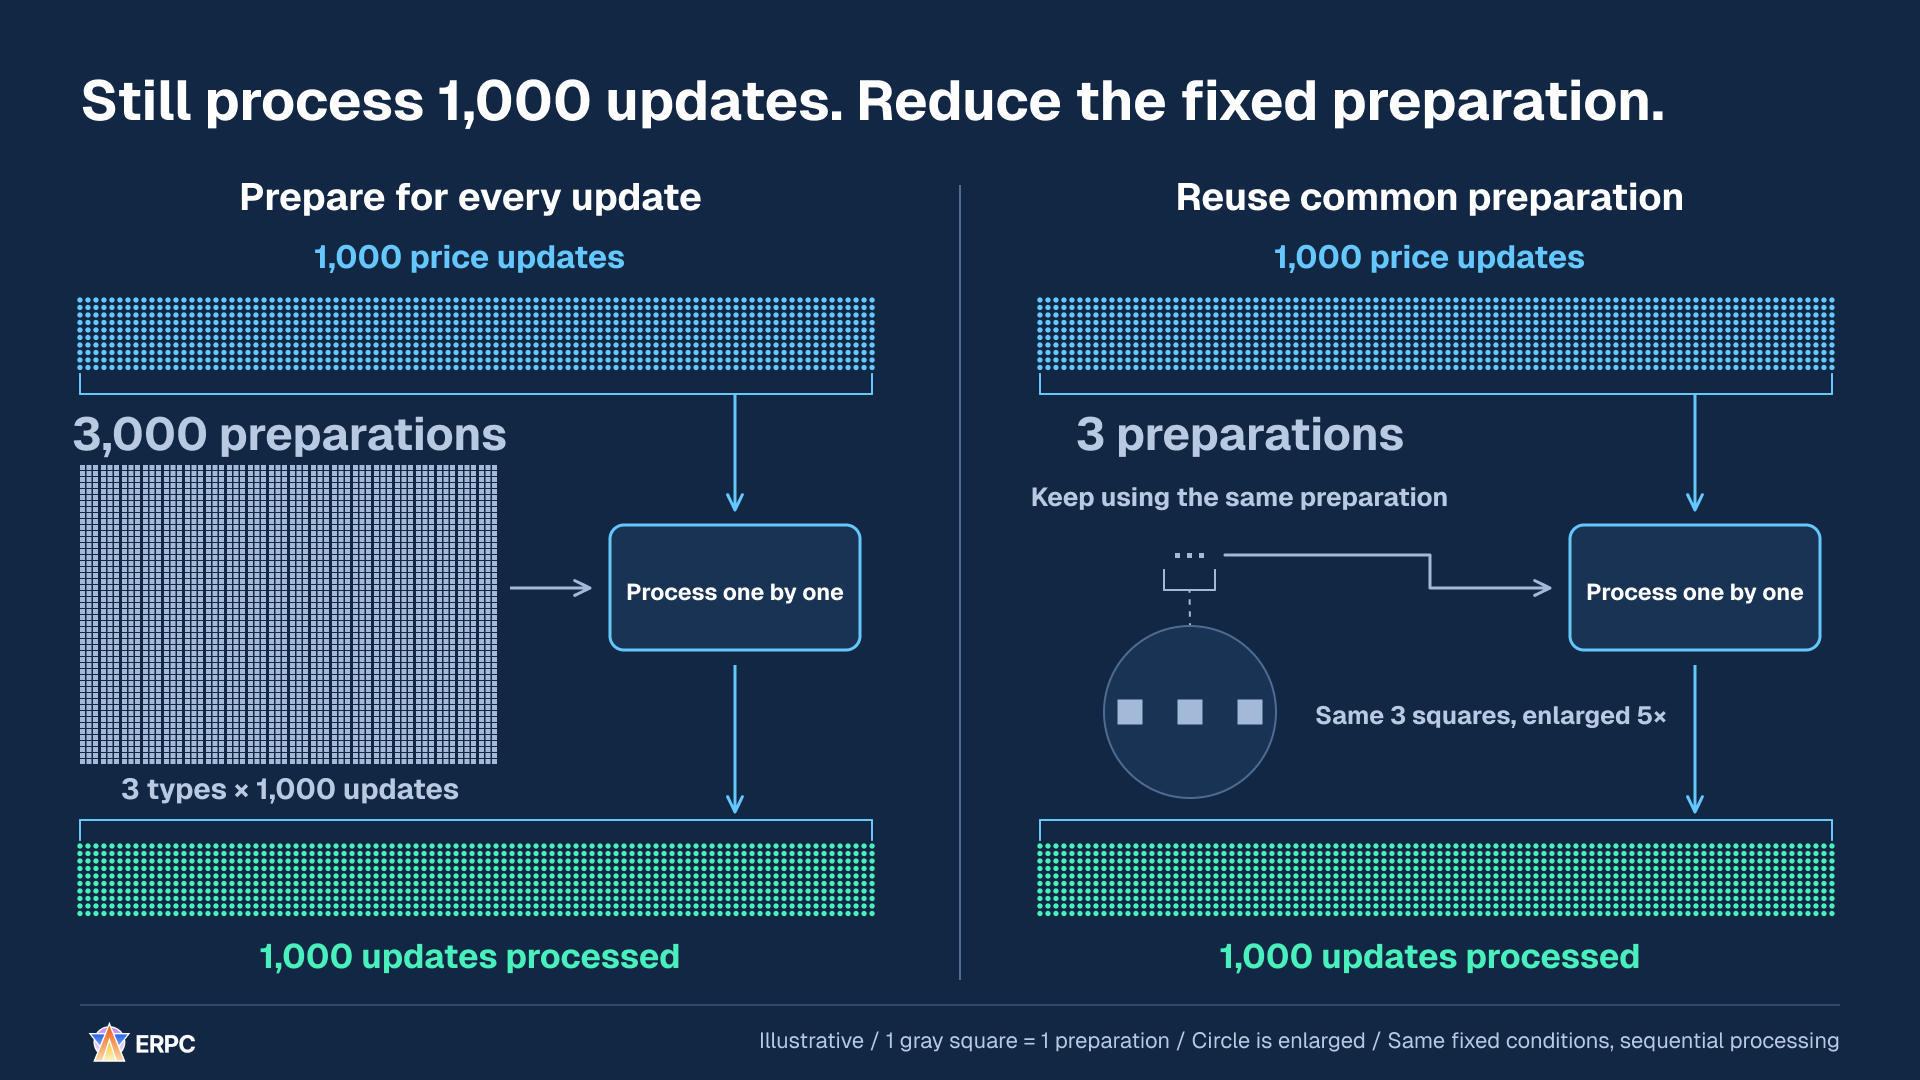
Сокращается повторная фиксированная подготовка. Проверка, принятие решений, подписание и другая работа остаются, поэтому отношение этих количеств не является коэффициентом ускорения всего приложения.
Определите условия, при которых повторное использование остаётся допустимым. Если меняется вход для вычисления фиксированного адреса, адрес необходимо пересчитать. Цены, количества, балансы, состояние используемых аккаунтов, лимиты риска и blockhash должны быть действительны в момент использования при принятии решения. Если приложение поддерживает непрерывно обновляемое локальное состояние, проверяйте его версию, свежесть и валидность. Это не обязательно требует заново получать все данные через RPC для каждого решения.
Solana getLatestBlockhash возвращает blockhash и его lastValidBlockHeight. При проверке срока действия различайте высоту блока и slot.[7] Окончательно сформируйте сообщение до подписания. Если после подписания сообщение изменилось, создайте подписи для обновлённого содержимого.[19]
Чтобы выполнять неизменную подготовку заранее и использовать её повторно, скопируйте эти инструкции.
text
Исследуйте работу, которая при каждом входном событии повторяет тот же разбор, вычисление адреса или выделение памяти, и перенесите повторно используемую подготовку на этап до получения данных.

Прочитайте README, инструкции по разработке, зависимости и код пути получение → подготовка → решение → построение сообщения → подпись. Используйте существующие язык, среду выполнения и SDK. Определите входы, выходы, владельца и срок действия каждой подготовки.

1. Сохраните воспроизводимые входные данные без конфиденциальной информации. Зафиксируйте число событий и выходных результатов, число выполнений и длительность каждой подготовки, выделенную память и время от получения до завершения решения.
2. Найдите подготовку с неизменными входами, выполните её при инициализации или на другом подходящем более раннем этапе и используйте результат повторно. Реализуйте ключи повторного использования, аннулирование и повторное вычисление при изменении входов или конфигурации и ограничения на кеши и пулы буферов.
3. Обновляйте повторно используемую рабочую память для текущего входа. Для параллельной работы используйте отдельные области или управляемое предоставление во временное пользование, чтобы область не перезаписывалась и не возвращалась, пока она ещё используется.
4. Проверяйте цены, количества, балансы, состояние аккаунтов, условия риска и blockhash в соответствии с требованиями решения. При использовании постоянно обновляемого локального состояния проверяйте версию и актуальность. В Solana различайте высоту блока и slot при проверке срока действия blockhash через lastValidBlockHeight. Окончательно сформируйте сообщение до подписания и подпишите обновлённое сообщение заново, если содержимое изменилось после подписи.
5. На одинаковых входных данных сравните число и длительность подготовок, p50/p95/p99 от получения до завершения решения, CPU и память и выходные результаты. Воспроизведите также изменения входов или конфигурации, истечение срока действия и параллельное выполнение, чтобы проверить повторное использование устаревших результатов и конфликты памяти. Не считайте отношение числа подготовок общим ускорением. Для измерения прошедшего времени внутри одного хоста используйте монотонные часы и укажите начальную и конечную точки измерения.

Сохраняйте существующие согласования, полномочия и процедуры разработки. Не считайте эти инструкции сами по себе дополнительным разрешением изменять производственную среду, заключать платные договоры или совершать реальные торговые операции. Не выводите приватные ключи, учётные данные или данные клиентов.

Сообщите об изменениях, условиях сравнения, измерениях до и после, проверках корректности и оставшихся ограничениях. Значения, которые нельзя измерить, отметьте как неизмеренные.
Исследуйте работу, которая при каждом входном событии повторяет тот же разбор, вычисление адреса или выделение памяти, и перенесите повторно используемую подготовку на этап до получения данных.
Прочитайте README, инструкции по разработке, зависимости и код пути получение → подготовка → решение → построение сообщения → подпись. Используйте существующие язык, среду выполнения и SDK. Определите входы, выходы, владельца и срок действия каждой подготовки.
1. Сохраните воспроизводимые входные данные без конфиденциальной информации. Зафиксируйте число событий и выходных результатов, число выполнений и длительность каждой подготовки, выделенную память и время от получения до завершения решения.
2. Найдите подготовку с неизменными входами, выполните её при инициализации или на другом подходящем более раннем этапе и используйте результат повторно. Реализуйте ключи повторного использования, аннулирование и повторное вычисление при изменении входов или конфигурации и ограничения на кеши и пулы буферов.
3. Обновляйте повторно используемую рабочую память для текущего входа. Для параллельной работы используйте отдельные области или управляемое предоставление во временное пользование, чтобы область не перезаписывалась и не возвращалась, пока она ещё используется.
4. Проверяйте цены, количества, балансы, состояние аккаунтов, условия риска и blockhash в соответствии с требованиями решения. При использовании постоянно обновляемого локального состояния проверяйте версию и актуальность. В Solana различайте высоту блока и slot при проверке срока действия blockhash через lastValidBlockHeight. Окончательно сформируйте сообщение до подписания и подпишите обновлённое сообщение заново, если содержимое изменилось после подписи.
5. На одинаковых входных данных сравните число и длительность подготовок, p50/p95/p99 от получения до завершения решения, CPU и память и выходные результаты. Воспроизведите также изменения входов или конфигурации, истечение срока действия и параллельное выполнение, чтобы проверить повторное использование устаревших результатов и конфликты памяти. Не считайте отношение числа подготовок общим ускорением. Для измерения прошедшего времени внутри одного хоста используйте монотонные часы и укажите начальную и конечную точки измерения.
Сохраняйте существующие согласования, полномочия и процедуры разработки. Не считайте эти инструкции сами по себе дополнительным разрешением изменять производственную среду, заключать платные договоры или совершать реальные торговые операции. Не выводите приватные ключи, учётные данные или данные клиентов.
Сообщите об изменениях, условиях сравнения, измерениях до и после, проверках корректности и оставшихся ограничениях. Значения, которые нельзя измерить, отметьте как неизмеренные.5. Не продолжайте принимать решения после потери необходимых обновлений
Рассмотрим два рынка одного актива, для которых приложение вычисляет разность цен B−A. Во время разрыва соединения цена рынка A меняется со 100 на 105, но приложение пропускает обновление. Если после повторного подключения оно получает только цену B, равную 104, оно вычисляет 104−100, то есть +4. С обновлённым значением A получается 104−105, то есть -1. Меняется даже знак.
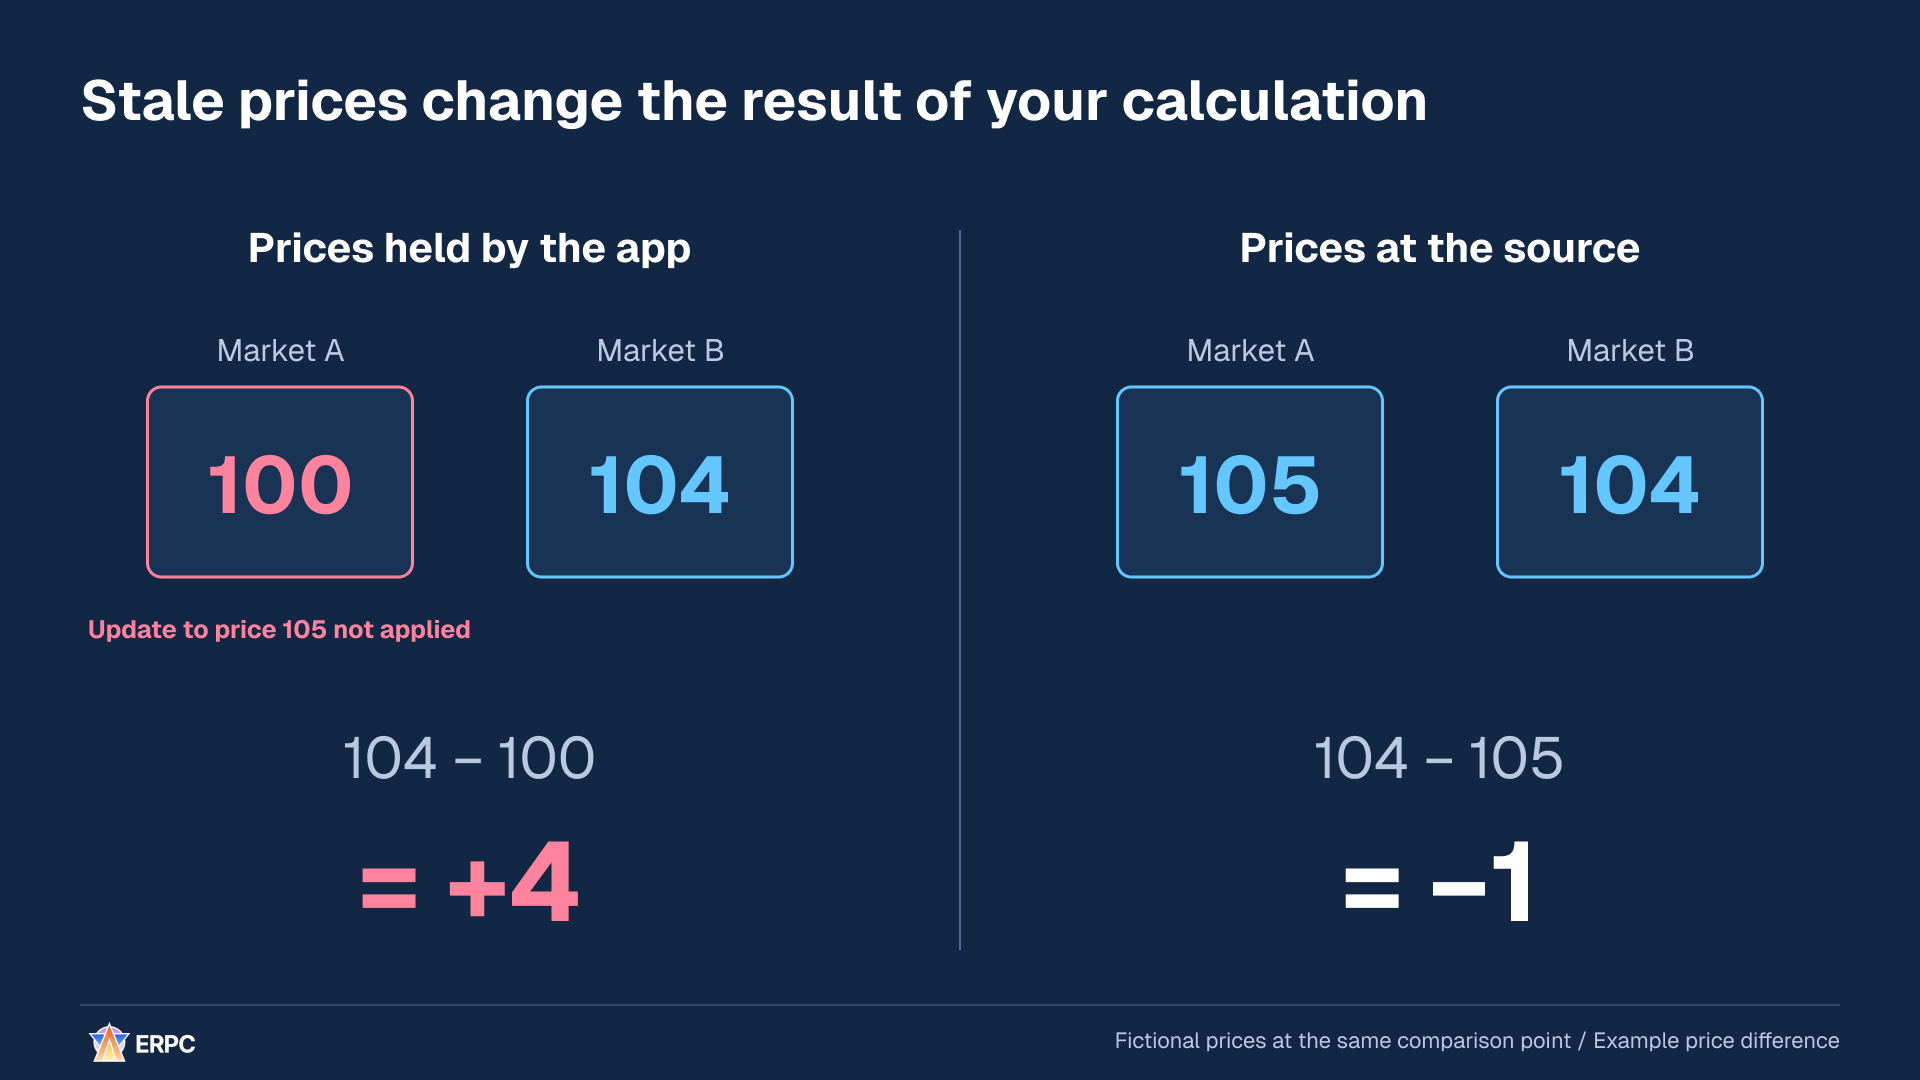
Один и тот же расчёт даёт разный результат в зависимости от того, используется ли старое значение A, равное 100, или обновлённое значение 105.
Эта модель показывает только разницу цен. Она не учитывает комиссии, условия исполнения и другие факторы и не отражает торговую прибыль. Суть в том, что восстановление соединения не обязательно восстанавливает все обновления, необходимые для решения.
В этом примере приостановите новые торговые решения, использующие цены A и B, затем замените старое значение A, равное 100, на восстановленное значение 105. После этого убедитесь, что необходимые для решения обновления применены к A и B, а требования к порядку и свежести выполнены. Возобновляйте решения после завершения необходимых проверок и сохраняйте паузу, если завершить их невозможно.
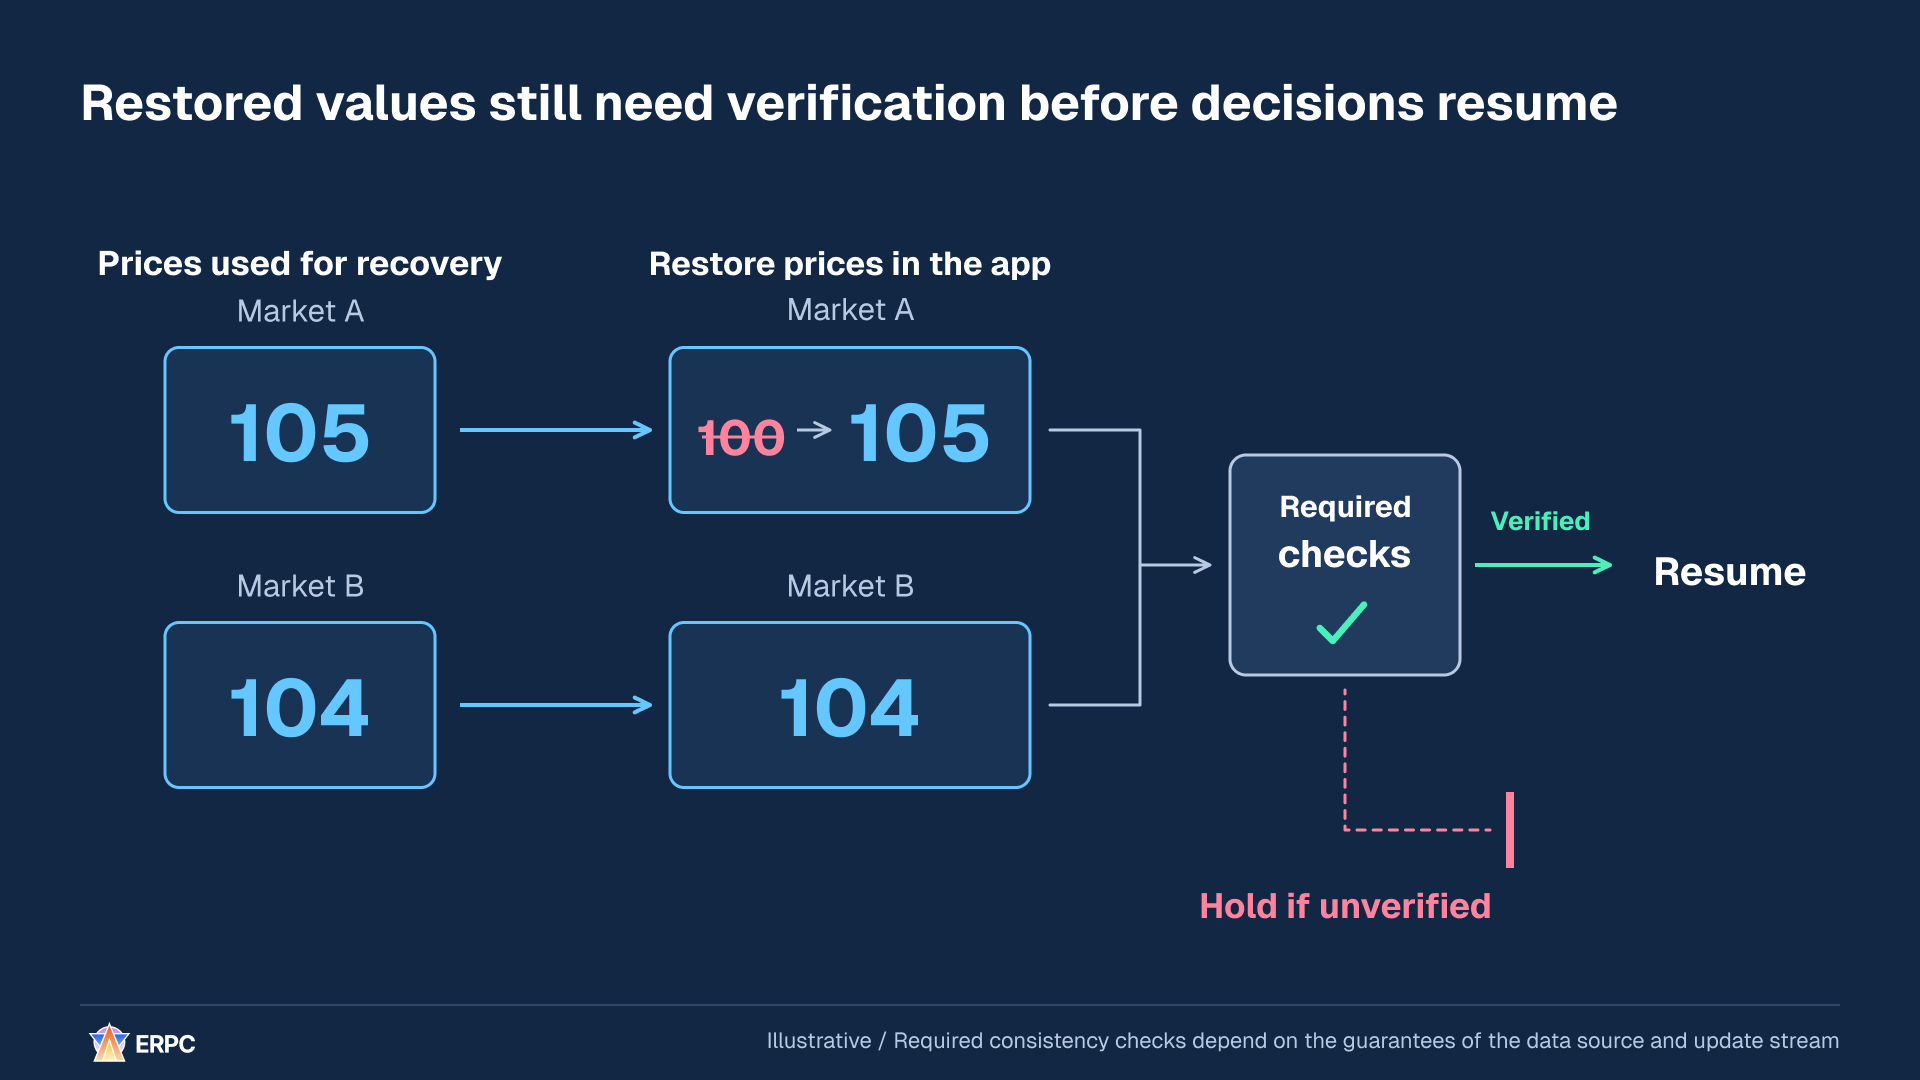
Разделяйте обновление значений и проверку того, что эти значения можно использовать для решений.
Распространённый механизм восстановления основан на snapshot: наборе значений состояния в определённый момент. Соединяя его с непрерывным потоком обновлений, установите, какие обновления уже включены в snapshot, а какие последующие обновления нужно применить. Это позволяет не применить включённое изменение дважды и не потерять обновление на границе. Конкретный способ должен соответствовать гарантиям выбранного API относительно начала подписки, идентификации, повторного получения и воспроизведения данных.
Сообщения Yellowstone содержат такие поля, как slot и write_version.[16] Само наличие этих полей не следует считать гарантией единой последовательности для разных провайдеров или полного обнаружения пропусков. Не переводите разницу slot напрямую в число пропущенных обновлений или секунды задержки. Проверьте, что целостность состояния восстановлена в соответствии с гарантиями выбранного провайдера.
Также учитывайте вычисления, начавшиеся до восстановления. Операция, которая начала работу со старым состоянием, а закончила после восстановления, может перезаписать новое состояние своим результатом. Один из подходов состоит в том, чтобы при восстановлении менять номер поколения состояния и отклонять результаты предыдущего поколения. Если используется состояние processed, включите откаты, при которых это состояние перестаёт быть принятым, в условия пересмотра состояния.[6]
Чтобы восстановить корректное состояние перед возобновлением решений после подключения, скопируйте эти инструкции.
text
Не допускайте возобновления торговых решений на устаревшем состоянии в этом приложении только потому, что соединение восстановилось. Реализуйте восстановление необходимого состояния до возобновления решений.

Прочитайте README, инструкции по разработке, зависимости и код подписки, первоначального получения, применения обновлений, повторного подключения и принятия решений. Используйте существующие язык, среду выполнения и SDK. Проверьте провайдера, commitment, семантику обновлений и фактические гарантии порядка, идентификации, повторного получения и воспроизведения.

1. Разделите статус соединения, корректность данных и разрешение возобновлять решения. Если установлена потеря необходимых обновлений или недостаточная актуальность, приостановите новые торговые решения, зависящие от этого состояния, продолжая необходимые получение, обновление и восстановление.
2. Если используется snapshot, на основании гарантий провайдера установите, какие обновления он включает и где проходит граница с последующим потоком. Предотвратите двойное применение изменений, пропуски на границе и неверный порядок применения. Не заменяйте отсутствующие гарантии предположениями. Не считайте slot или write_version безусловно пригодной последовательностью для обнаружения пропущенных обновлений.
3. Не возобновляйте решения лишь потому, что значения получены. Реализуйте проверки обновлений, порядка, актуальности и согласованности, необходимые затронутым решениям, и сохраняйте паузу, пока проверки не могут быть завершены. Используйте поколения или эквивалентный механизм, чтобы старые вычисления или предложения заявок не применялись и не отправлялись, если работа, начатая до восстановления, завершилась позже. При возобновлении принимайте новые решения на проверенном состоянии. При использовании состояния processed обрабатывайте аннулирование и восстановление после отката.
4. На воспроизводимых входных данных без конфиденциальной информации воспроизведите пропущенные во время отключения обновления, дубликаты, изменения порядка, устаревшие данные, повторные переподключения и завершение работы из старого поколения. Проверьте, что решения остаются приостановленными от восстановления соединения до завершения проверки и что проверенное состояние соответствует ожидаемому результату.
5. Зафиксируйте время восстановления, число попыток принятия решения, подавленных из-за некорректного состояния, и длительность паузы, повторно применённые или исключённые обновления, обычное время от получения до завершения решения, CPU и память. Не исключайте молча периоды паузы или пропущенные обновления из измерений. Укажите границы измерений и то, что можно и нельзя обнаружить. Для измерения прошедшего времени внутри одного хоста используйте монотонные часы.

Сохраняйте существующие согласования, полномочия и процедуры разработки. Не считайте эти инструкции сами по себе дополнительным разрешением изменять производственную среду, заключать платные договоры или совершать реальные торговые операции. Не выводите приватные ключи, учётные данные или данные клиентов.

Сообщите об изменениях, условиях сравнения, измерениях до и после, проверках корректности и оставшихся ограничениях. Значения, которые нельзя измерить, отметьте как неизмеренные.
Не допускайте возобновления торговых решений на устаревшем состоянии в этом приложении только потому, что соединение восстановилось. Реализуйте восстановление необходимого состояния до возобновления решений.
Прочитайте README, инструкции по разработке, зависимости и код подписки, первоначального получения, применения обновлений, повторного подключения и принятия решений. Используйте существующие язык, среду выполнения и SDK. Проверьте провайдера, commitment, семантику обновлений и фактические гарантии порядка, идентификации, повторного получения и воспроизведения.
1. Разделите статус соединения, корректность данных и разрешение возобновлять решения. Если установлена потеря необходимых обновлений или недостаточная актуальность, приостановите новые торговые решения, зависящие от этого состояния, продолжая необходимые получение, обновление и восстановление.
2. Если используется snapshot, на основании гарантий провайдера установите, какие обновления он включает и где проходит граница с последующим потоком. Предотвратите двойное применение изменений, пропуски на границе и неверный порядок применения. Не заменяйте отсутствующие гарантии предположениями. Не считайте slot или write_version безусловно пригодной последовательностью для обнаружения пропущенных обновлений.
3. Не возобновляйте решения лишь потому, что значения получены. Реализуйте проверки обновлений, порядка, актуальности и согласованности, необходимые затронутым решениям, и сохраняйте паузу, пока проверки не могут быть завершены. Используйте поколения или эквивалентный механизм, чтобы старые вычисления или предложения заявок не применялись и не отправлялись, если работа, начатая до восстановления, завершилась позже. При возобновлении принимайте новые решения на проверенном состоянии. При использовании состояния processed обрабатывайте аннулирование и восстановление после отката.
4. На воспроизводимых входных данных без конфиденциальной информации воспроизведите пропущенные во время отключения обновления, дубликаты, изменения порядка, устаревшие данные, повторные переподключения и завершение работы из старого поколения. Проверьте, что решения остаются приостановленными от восстановления соединения до завершения проверки и что проверенное состояние соответствует ожидаемому результату.
5. Зафиксируйте время восстановления, число попыток принятия решения, подавленных из-за некорректного состояния, и длительность паузы, повторно применённые или исключённые обновления, обычное время от получения до завершения решения, CPU и память. Не исключайте молча периоды паузы или пропущенные обновления из измерений. Укажите границы измерений и то, что можно и нельзя обнаружить. Для измерения прошедшего времени внутри одного хоста используйте монотонные часы.
Сохраняйте существующие согласования, полномочия и процедуры разработки. Не считайте эти инструкции сами по себе дополнительным разрешением изменять производственную среду, заключать платные договоры или совершать реальные торговые операции. Не выводите приватные ключи, учётные данные или данные клиентов.
Сообщите об изменениях, условиях сравнения, измерениях до и после, проверках корректности и оставшихся ограничениях. Значения, которые нельзя измерить, отметьте как неизмеренные.Сравните сильные стороны языков по шести осям
Реализация этих пяти подходов означает выбор того, кто обновляет данные, где выделяется память, что копируется и какие операции ждут. Быстрые вычисления, контроль внезапных задержек и быстрое создание прототипов представляют собой разные сильные стороны. Сравнивайте языки в зависимости от того, какую часть вы хотите улучшить.
Сравнение времени выполнения по опубликованному бенчмарку
Эти опубликованные измерения от 1 августа 2025 года выполняют расчёт взаимодействия пяти тел за 500 000 шагов. Среднее время выполнения — это среднее время от запуска программы до завершения. В него входят запуск и оптимизация кода во время выполнения, но не предварительная сборка. 1 000 мс равны одной секунде.[27][29]
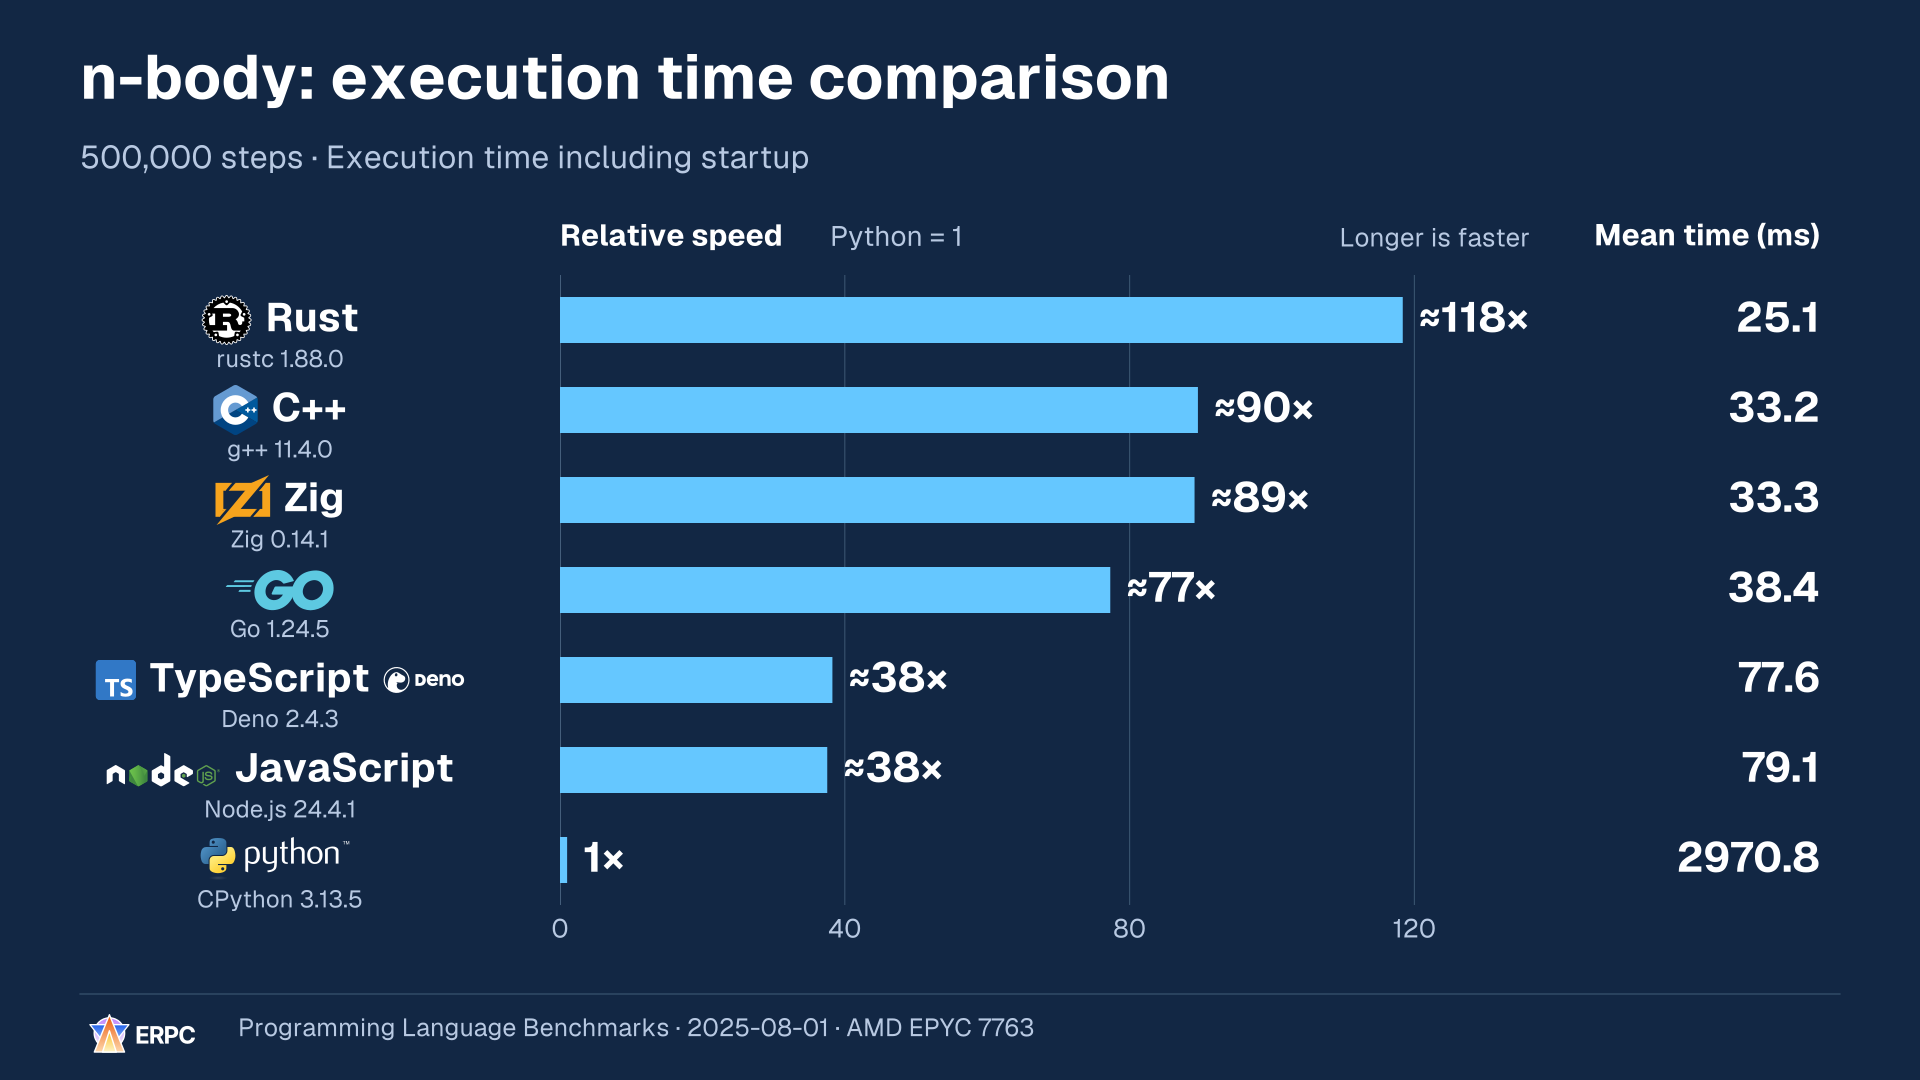
| Язык / среда выполнения | Среднее время выполнения | Относительная скорость (Python = 1) |
|---|---|---|
| Rust / rustc 1.88.0 | 25.1 мс | ≈118 |
| C++ / g++ 11.4.0 | 33.2 мс | ≈90 |
| Zig / Zig 0.14.1 | 33.3 мс | ≈89 |
| Go / Go 1.24.5 | 38.4 мс | ≈77 |
| TypeScript / Deno 2.4.3 | 77.6 мс | ≈38 |
| JavaScript / Node.js 24.4.1 | 79.1 мс | ≈38 |
| Python / CPython 3.13.5 | 2970.8 мс | 1 |
Относительные скорости рассчитаны по неокруглённым средним временам при Python = 1. Для каждого семейства языка и среды выполнения выбирается наименьшее опубликованное среднее среди стабильных реализаций, численные вычисления которых используют один поток без явных SIMD-интринсиков, векторных типов и внешних численных библиотек. Код и оптимизации различаются; Zig использует ReleaseFast. TypeScript запускается как исполняемый файл с Deno/V8, а JavaScript — в Node.js.[28]
Считайте близкие значения сопоставимыми результатами, не превращая эту одну задачу в общий рейтинг языков. Она не измеряет напрямую время обработки у бота, который продолжает работать после запуска, или задержку до поступления заявки в пункт назначения.
Указанная среда — Linux на AMD EPYC 7763 с четырьмя доступными ядрами. Опубликованный измерительный код настроен на три повторения для каждого условия, каждый раз с запуском нового процесса. Точный коммит исторического запуска и отдельные исходные измерения проверить не удалось, поэтому здесь приведены опубликованные средние значения.[28][29]
Сравнение сильных сторон проектирования по шести осям
Следующие диаграммы служат редакционными ориентирами с тремя уровнями оценки при выборе языка для офчейн-клиента Solana. Ось «Скорость вычислений» рассматривает возможности ускорения чтения больших объёмов данных и вычислений, написанных непосредственно на сравниваемом языке и в его реализации. Она не ранжирует приложения целиком, если основное время уходит на ожидание сети, или вычисления, переданные ускоренным внешним библиотекам.
Rust, Go, C++ и Zig являются сильными кандидатами для оптимизированного нативного выполнения. Это не утверждение об одинаковой скорости: более точный порядок требует измерения реальной нагрузки. V8 тоже преобразует часто выполняемые функции в машинный код. Называть JavaScript медленным лишь потому, что он интерпретируется, было бы неточно.[20][21]
Три оси, «Скорость вычислений», «Контроль задержки» и «Контроль памяти», описывают вычисления и контроль. «Поддержка безопасности», «Простота прототипирования» и «Solana SDK» описывают поддержку разработки. Не все шесть осей отражают скорость обработки.
Все шестиугольники используют одинаковые оси и шкалу. Чем дальше от центра, тем сильнее качественная позиция по этой оси. Это не измеренные скорости или отношения: уровень 3 не означает втрое больше уровня 1. Сравнивайте отдельно те оси, которые хотите улучшить, а не считайте площадь многоугольника общей оценкой.
| Ось | Что сравнивается |
|---|---|
| Скорость вычислений | Возможности ускорить собственный код чтения больших объёмов данных и вычислений внутри сравниваемой реализации |
| Контроль задержки | Насколько непосредственно можно вынести из важных участков обработки выделение и освобождение памяти, оптимизацию кода во время выполнения и подобную работу, чтобы ограничить внезапные задержки |
| Контроль памяти | Насколько непосредственно можно проектировать размещение данных, владение и время жизни, выделение, повторное использование и освобождение памяти |
| Поддержка безопасности | Помощь возможностей языка, среды выполнения и стандартных инструментов в предотвращении ошибок времени жизни памяти и разделяемой памяти |
| Простота прототипирования | Насколько просто запустить небольшую программу и проверять изменения; редакционная оценка, зависящая от опыта и существующего кода |
| Solana SDK | Насколько легко официальная документация Solana позволяет найти клиентские SDK и примеры для нужного применения |
Оси контроля оценивают возможности прямого проектирования, ось безопасности оценивает доступную поддержку, а ось SDK оценивает путь от официальной документации. Один и тот же уровень может соответствовать разным механизмам и гарантиям.[8][13][20][21][26]
Обзор сравнивает шесть языков в трёх столбцах и двух строках: Rust, Go, TypeScript, Python, C++ и Zig. Сравните важные для вас оси, затем по отдельным диаграммам и пояснениям ниже проверьте допущения о среде выполнения и подходящие области применения.
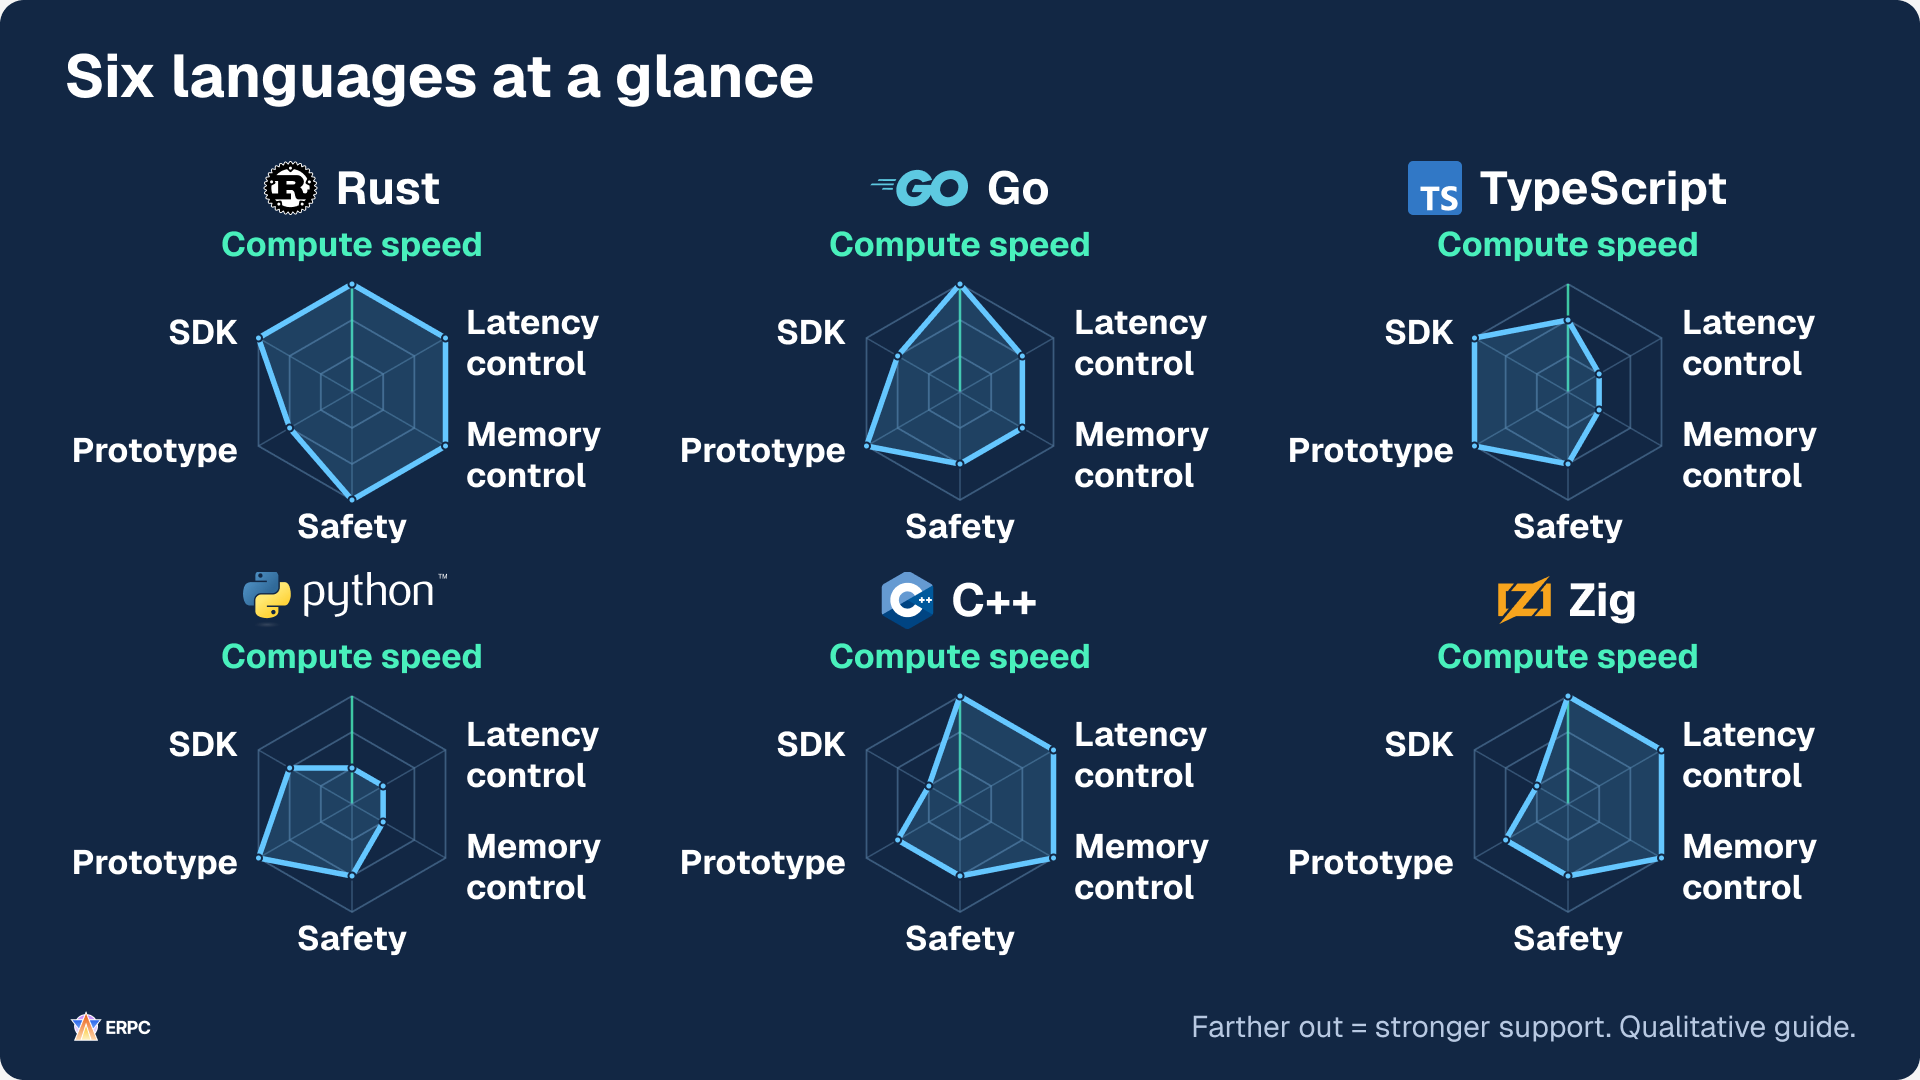
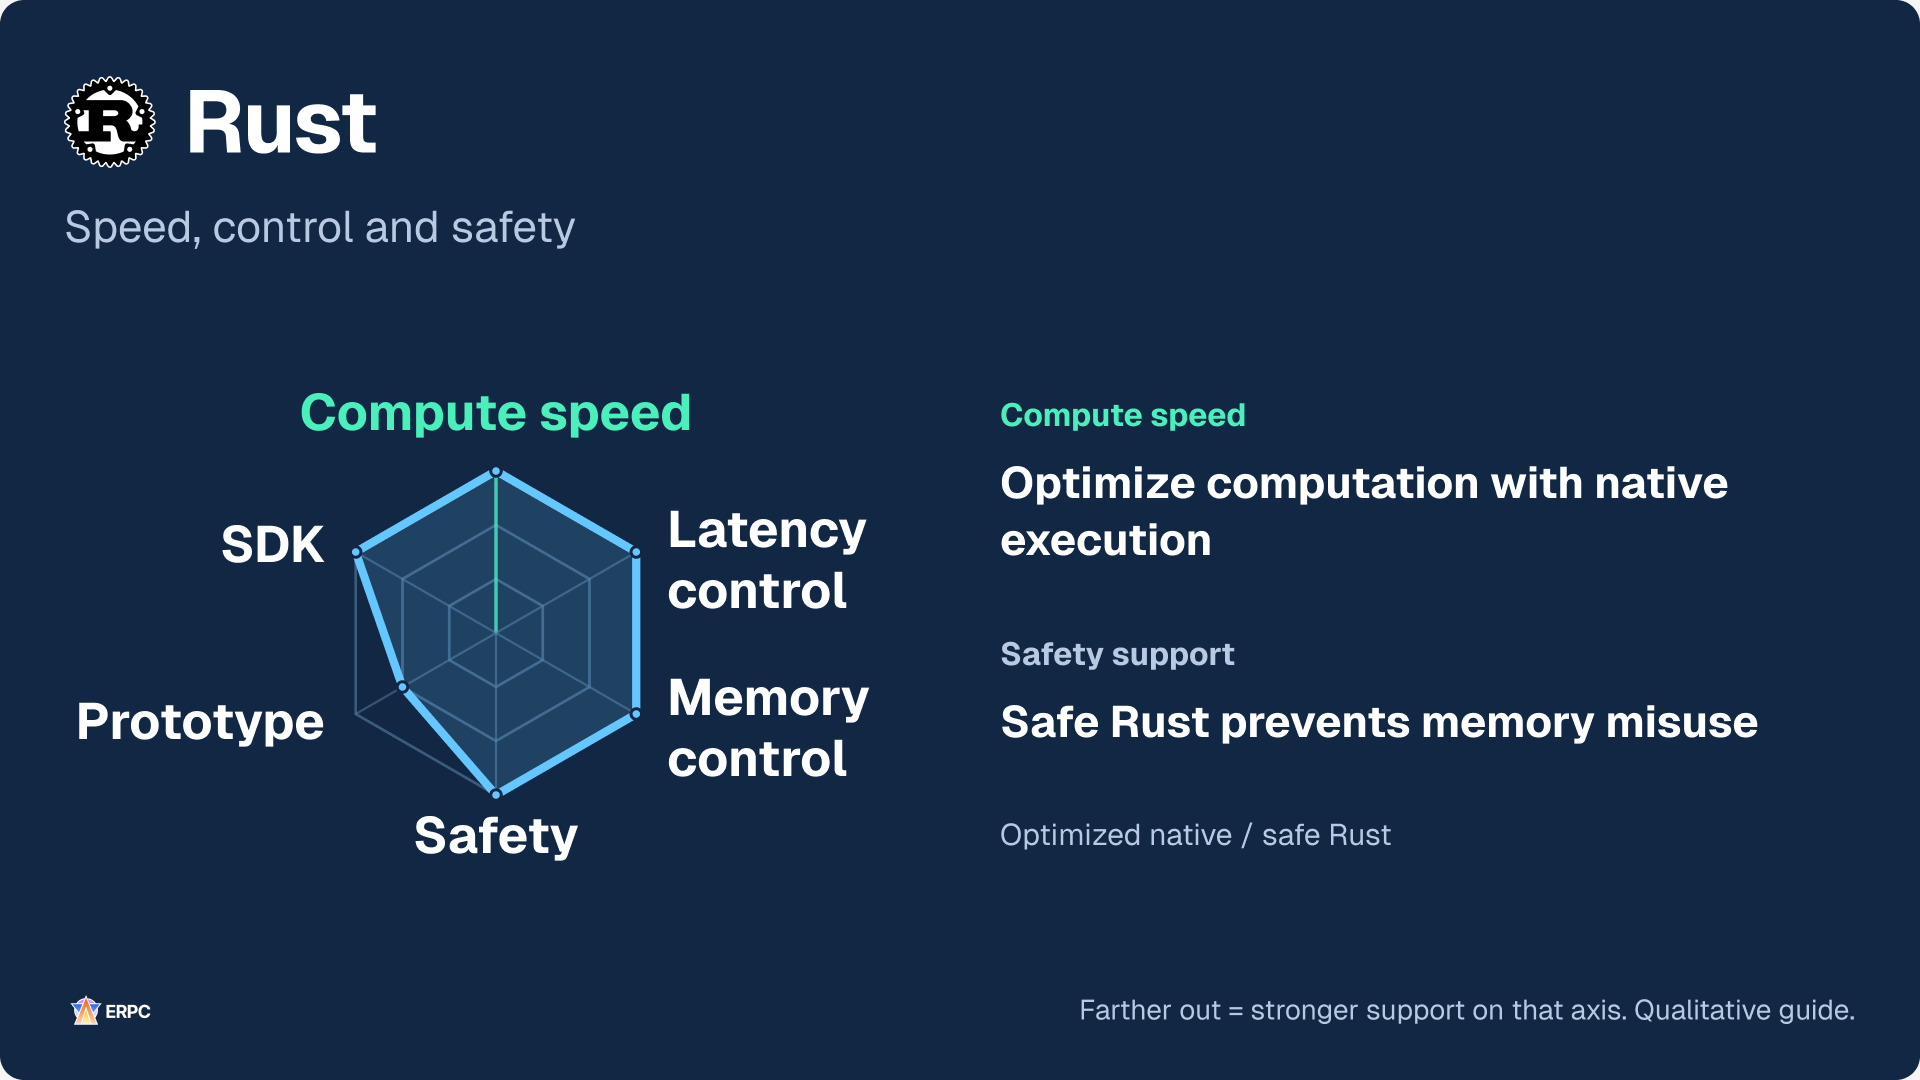
Rust сочетает контроль размещения, выделения и повторного использования памяти на важных путях с проверками владения и заимствования. Его обычному управлению памятью не требуется трассирующий GC.[8] Гарантии safe Rust против гонок данных не гарантируют отсутствия общих состояний гонки, взаимных блокировок или ошибочной логики решений. Unsafe-код и интерфейсы с другими языками требуют отдельной проверки.[22] Копирование, выделение и освобождение памяти, блокировки и ожидание операционной системы сохраняются, поэтому проверяйте реальные входные данные и нагрузку.
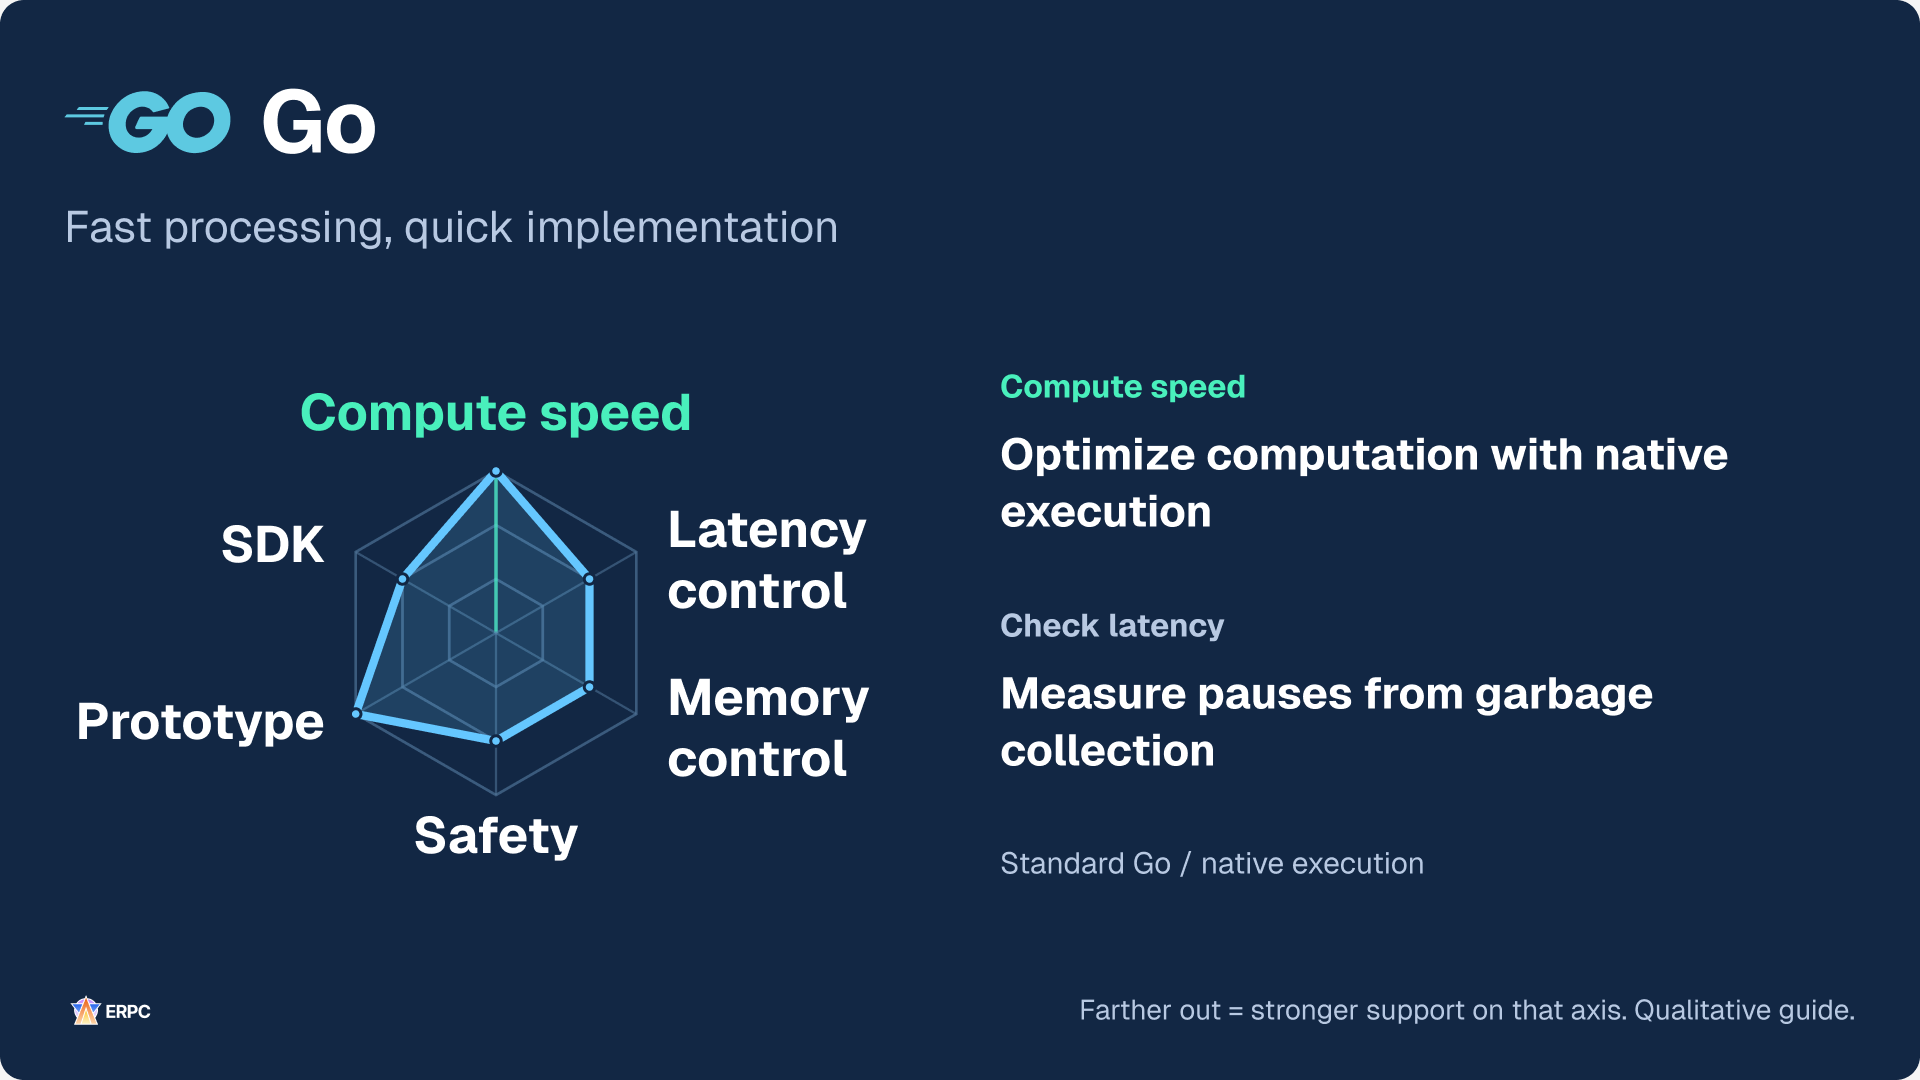
Go также подходит для нативного скомпилированного выполнения. Он помогает строить конкурентные сервисы и обработку, а среда выполнения поддерживает управление памятью и другие операции.[20] Большая часть работы GC выполняется конкурентно, но необходимо измерять выделения и затраты сборки на CPU, память и задержку. Потенциал вычислений на CPU нужно рассматривать отдельно от прямого управления моментом освобождения памяти.[13]
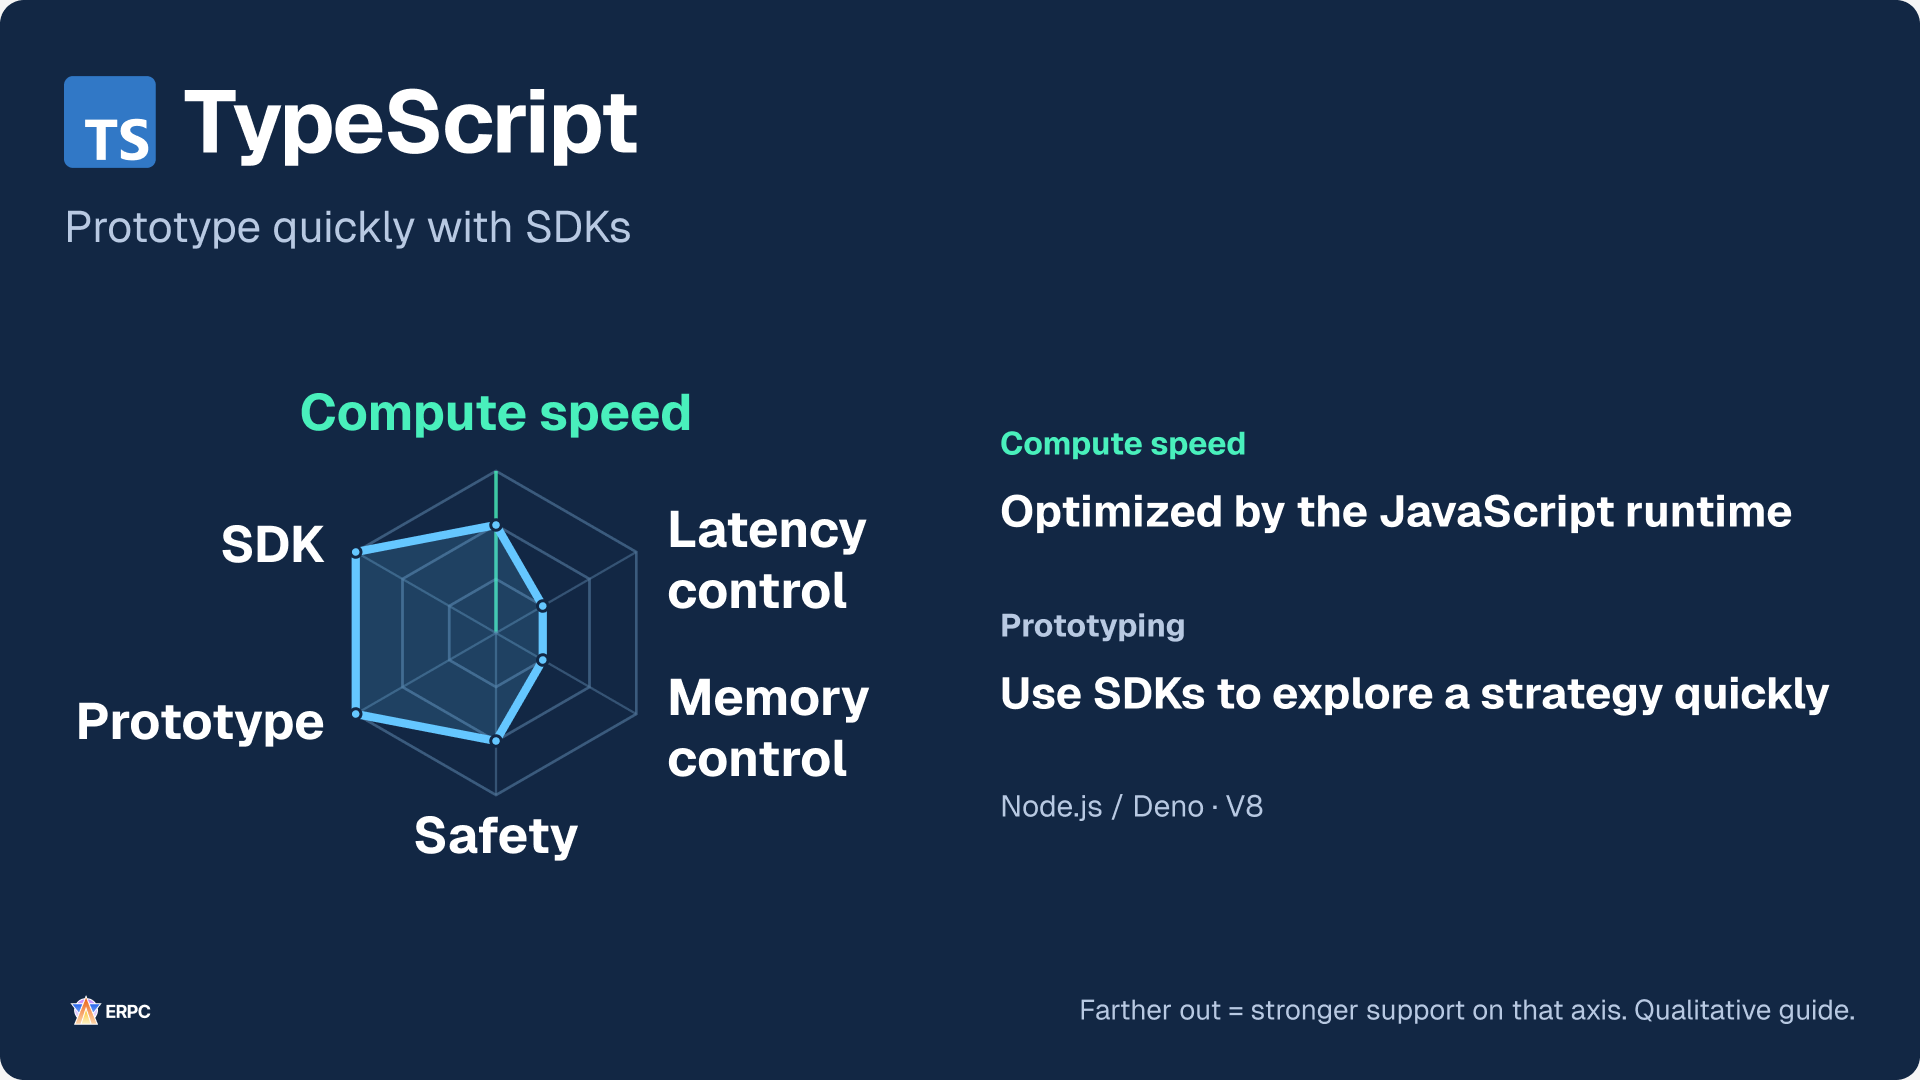
TypeScript является языком, а Node.js и Deno являются средами выполнения. На схеме рассматривается JavaScript, выполняемый V8. Аннотации типов отсутствуют в исполняемом коде, поэтому добавление типов само по себе не ускоряет вычисления на CPU. Внешние данные по-прежнему необходимо проверять во время выполнения.[9][10][21] Эти варианты подходят для интеграции API, конфигурации, мониторинга, веб-интерфейсов и потоковой обработки, удовлетворяющей требованиям производительности.
worker_threads в Node.js и Web Workers в Deno могут перенести вычисления на CPU в другой контекст выполнения. Документация Node.js рекомендует пул рабочих потоков вместо создания нового для каждой задачи. Учитывайте преобразование, копирование и ожидание передачи работы наряду с вычислением в месте назначения.[11][12]
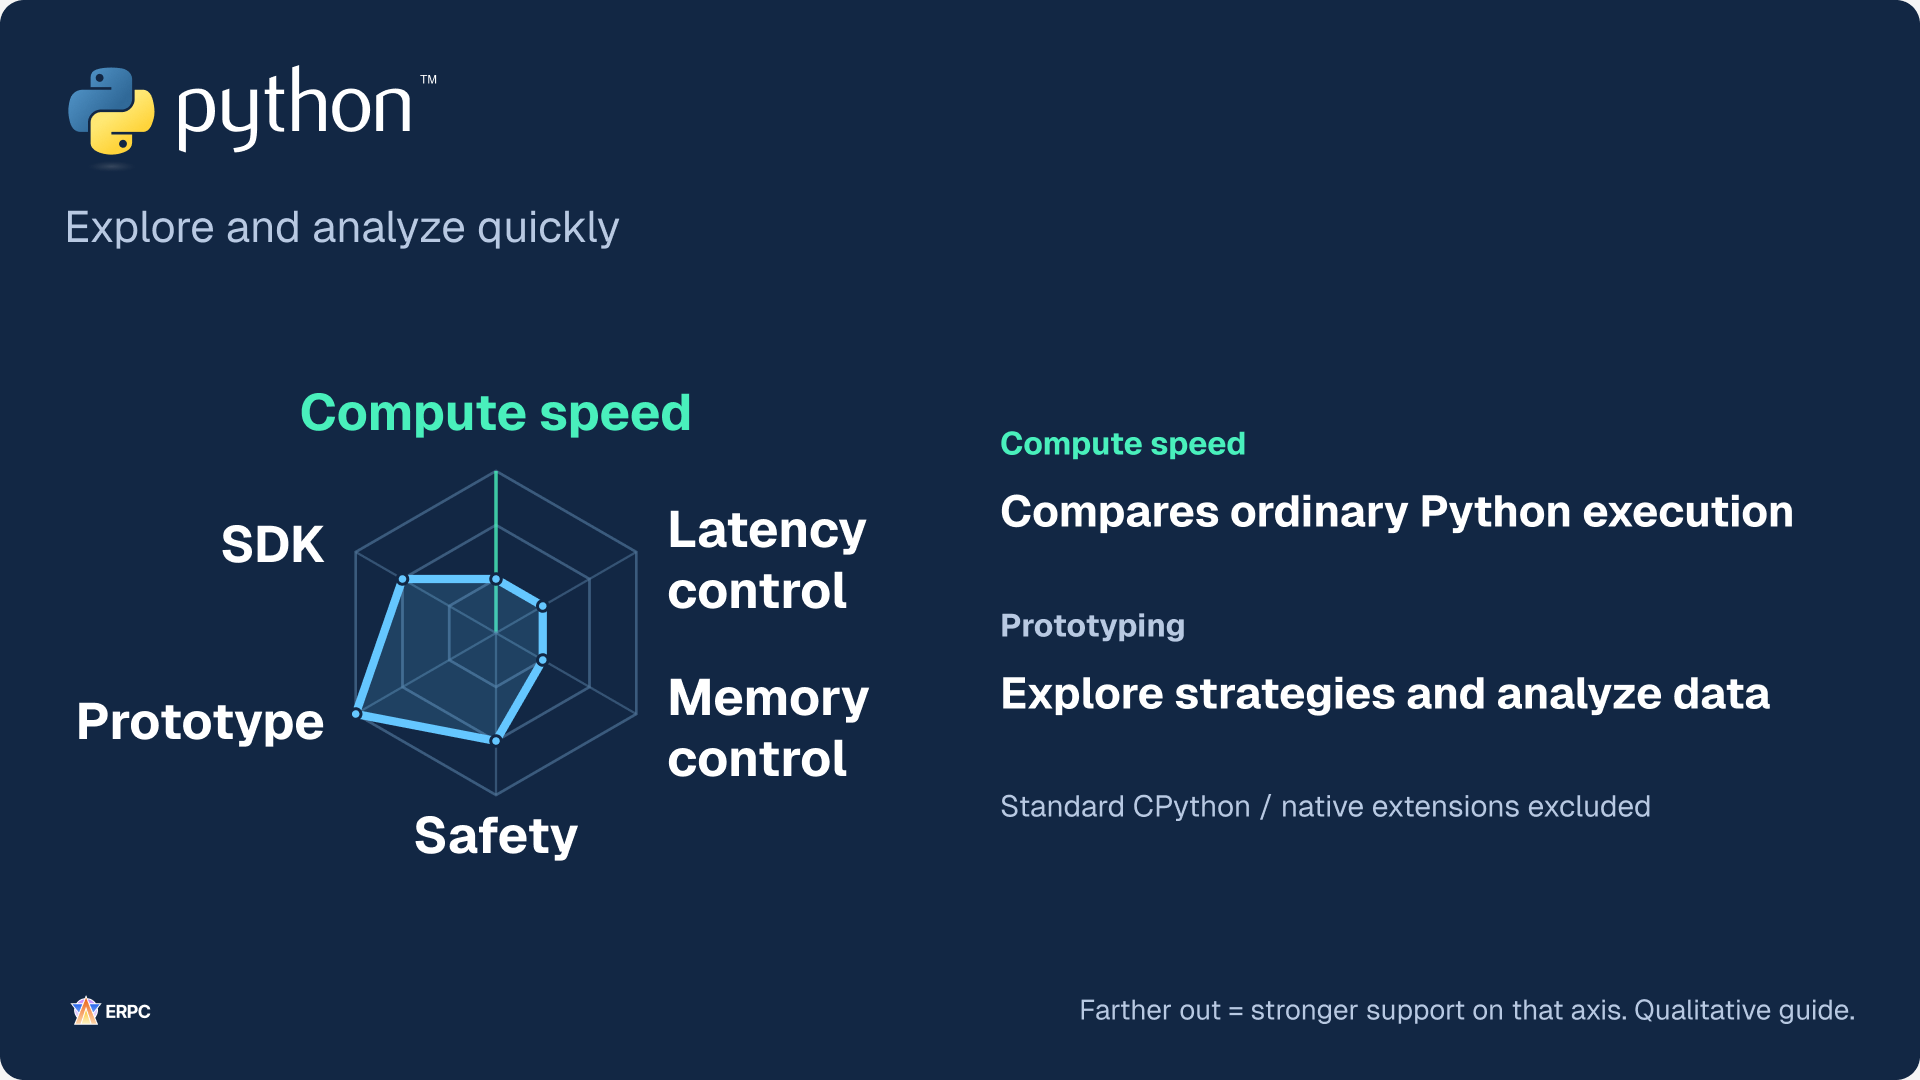
Python подходит для исследований, анализа, проверки и работы с существующими библиотеками. Оценка CPU здесь относится к циклам, написанным на Python и выполняемым внутри обычного CPython. Вычисления, переданные скомпилированному коду, например операции NumPy, относятся к другому случаю.[23] Проверяйте реальную конфигурацию, включая free-threaded сборки, а не принимайте решение лишь по названию языка.[14] При переносе части в Rust или другую реализацию измеряйте преобразование и копирование на границе и проверяйте выигрыш всего приложения.
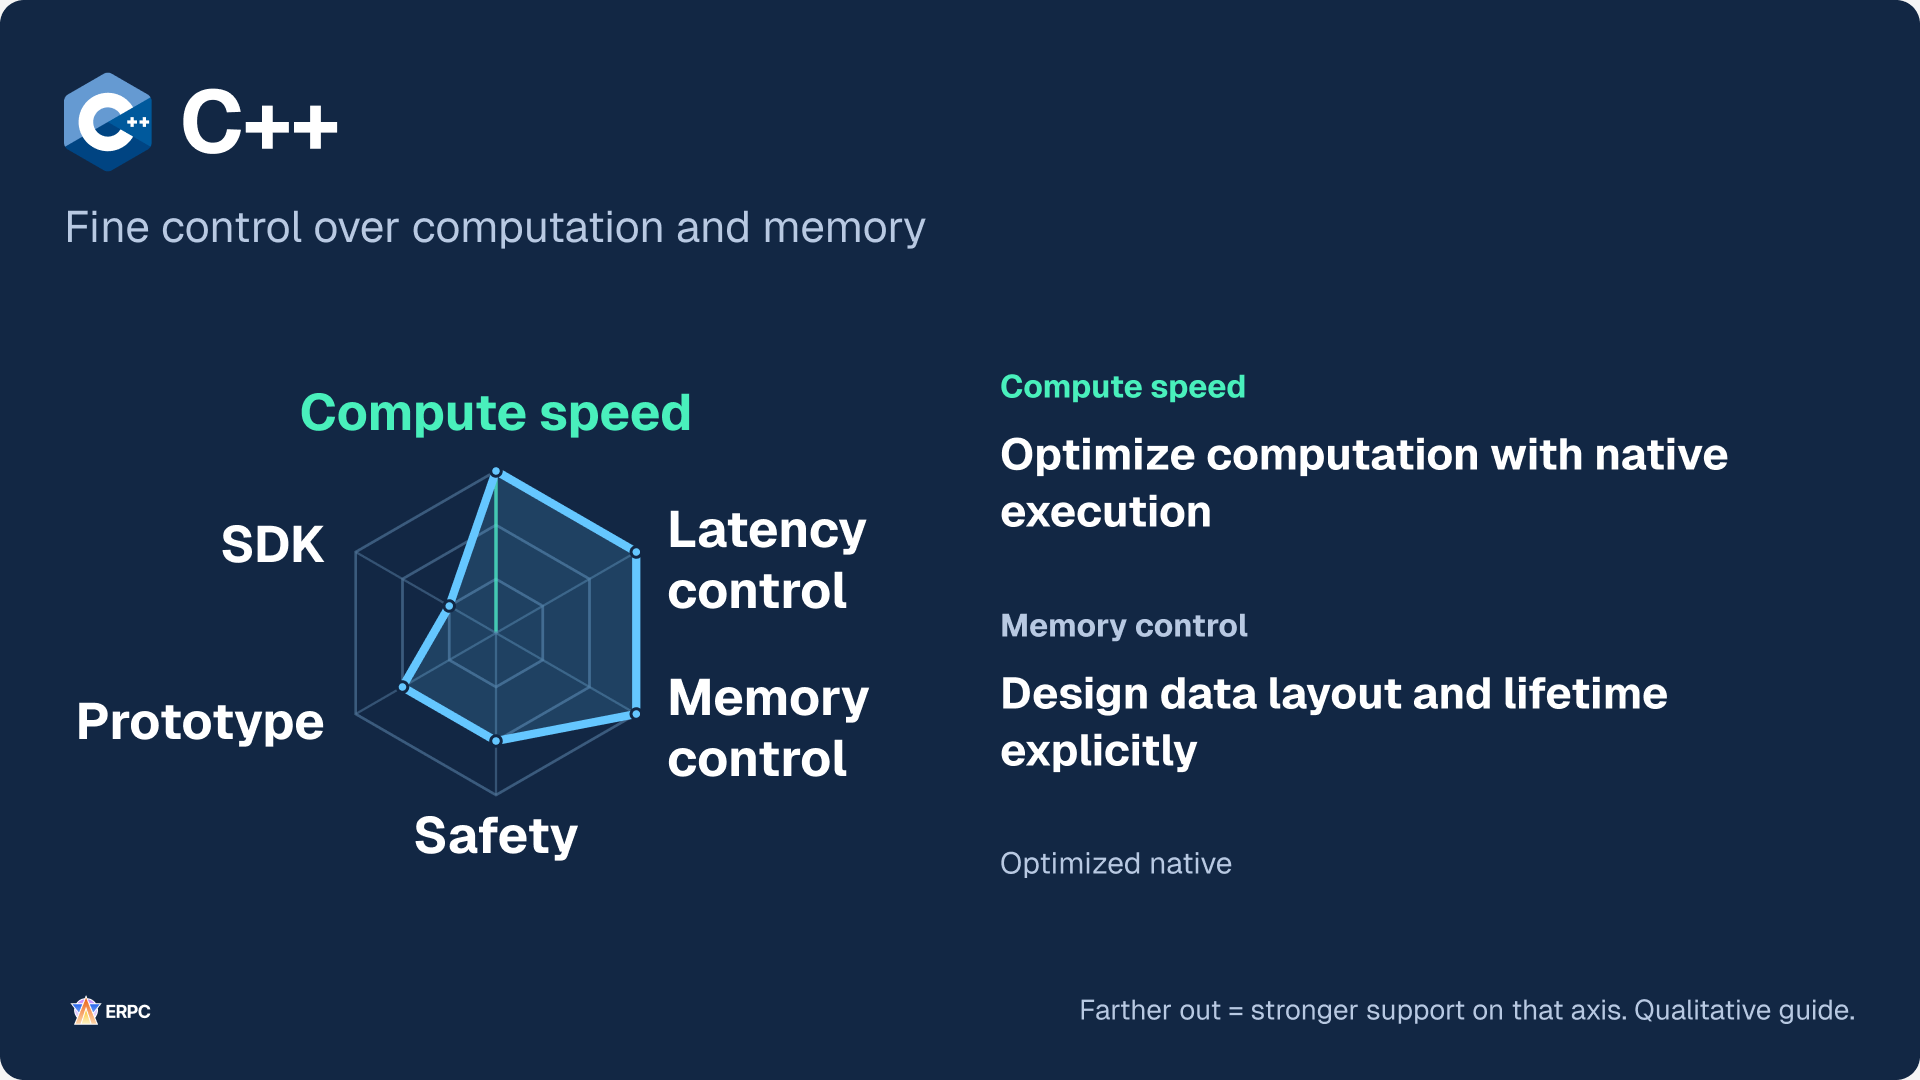
C++ сочетает низкоуровневый контроль с абстракциями и существующими библиотеками. RAII и умные указатели помогают управлять временем жизни ресурсов, но их использование не гарантирует полную безопасность времени жизни памяти или разделяемой памяти.[24] Средний уровень безопасности также не означает те же гарантии, что у управляемой памяти, например в Go.
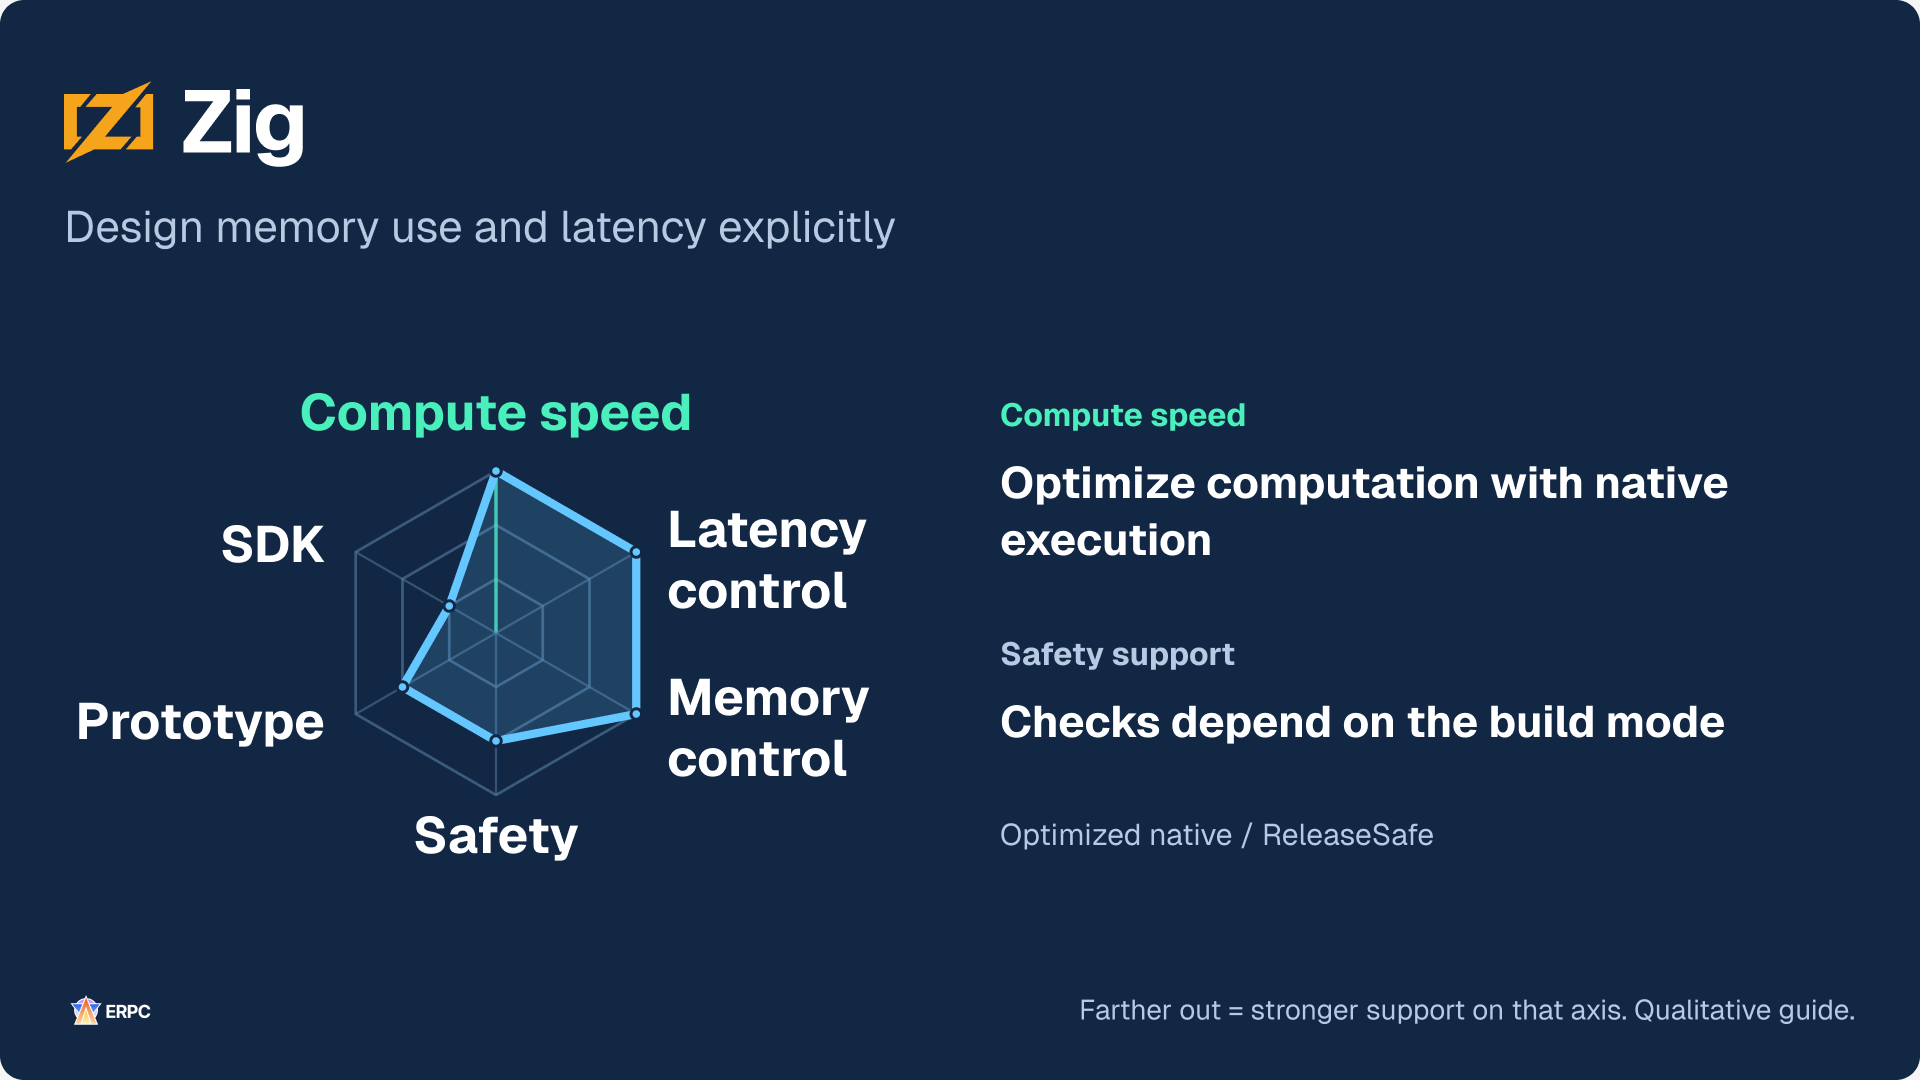
Zig позволяет явно организовать выделение памяти и выбор аллокатора. Этот профиль предполагает проверки ReleaseSafe. В ReleaseFast и ReleaseSmall набор проверок по умолчанию отличается, а ReleaseSafe обнаруживает не все случаи недопустимого поведения.[25] Одинаковая с C++ форма многоугольника не означает идентичных механизмов.
Ось Solana SDK использует пути официальной документации для TypeScript и Rust, а также перечисленные там клиенты Go и Python. Она не ранжирует общее количество или качество библиотек и не утверждает, что у C++ и Zig нет библиотек. Для выбранного SDK проверьте необходимые API, сопровождение и соответствие изменениям, а также совместимость с выбранной средой выполнения, включая Deno.[26]
Измерьте, где приложение тратит время, и выберите сильные стороны, необходимые этому участку. Сначала сократите ожидание и повторную работу на текущем языке. Если нужен более точный контроль, остаётся возможность перенести соответствующую часть на другой язык.
Сравнивайте изменения в одинаковых условиях
Инструкции каждого раздела охватывают реализацию и проверку соответствующего улучшения. Если внедряете несколько улучшений, сохраняйте связь каждого изменения с его измеренными результатами. Одновременное внесение изменений мешает различить, какое из них повлияло на конкретный результат.
Сравнивайте состояние до и после изменения при одинаковых входных данных, условиях подписки, нагрузке и требованиях к результатам. Для времени от получения данных до завершения решения рассматривайте медиану p50 вместе с p95 и p99. p99 представляет собой порог, в который укладываются 99% измеренных событий. Он помогает увидеть медленную часть распределения наряду с типичным временем обработки.
Сумма p99 отдельных этапов не даёт сквозной p99. Измеряйте полную длительность от получения данных до завершения решения для каждого события напрямую, а также ожидание в очередях, использование CPU и памяти, пропущенные или отброшенные обновления и совпадение результатов решений.
При измерении прошедшего времени внутри одного хоста используйте монотонные часы, которые не идут назад при коррекции календарного времени. Если SDK вызывает callback только после декодирования, часть обработки уже произошла до начала callback. Точно указывайте начало и конец каждого измерения, чтобы отдельно рассматривать задержку доставки и задержку приложения.
Проверяйте и то, что происходит после отправки. Успешный ответ sendTransaction не гарантирует обработку или подтверждение кластером.[15] Сопоставление получения данных, решения, принятия отправки и наблюдаемого результата on-chain помогает найти следующий участок для улучшения.
Превратите быструю доставку в своевременные решения
Важны и быстрая доставка, и приложение, которое успевает завершать необходимые решения. ERPC продолжает улучшать инфраструктуру доставки и готовить материалы, помогающие совершенствовать работающее на ней программное обеспечение.
Сначала проверьте изменения приложения в одной и той же среде. Затем при необходимости сравните одинаковый код при разных размещениях или ресурсах, чтобы разделить их влияние. При использовании почасовой оплаты ERPC заранее определите гипотезу, условия сравнения и длительность использования, а актуальные цены и доступность проверьте в Dashboard.
Источники и связанные ссылки
- [1] Tokio / Вычислительно тяжёлые задачи и блокирующие операции
- [2] Node.js / Не блокируйте цикл событий
- [3] gRPC / Управление потоком
- [4] Yellowstone gRPC / Сообщения и спецификации подписок
- [5] LMAX Disruptor / Устройство и использование
- [6] Solana / Commitment
- [7] Solana / getLatestBlockhash
- [8] Rust / Владение
- [9] TypeScript / Поведение во время выполнения и удаление типов
- [10] Deno / TypeScript
- [11] Node.js / Worker threads
- [12] Deno / Web Workers
- [13] Go / Сборщик мусора
- [14] Python / Free threading
- [15] Solana / sendTransaction
- [16] Yellowstone gRPC / Определения сообщений
- [17] Rust / std::sync::Mutex
- [18] Tokio / Общее состояние и разделение mutex
- [19] Solana / Структура транзакции и подписи
- [20] Go / Ответы на частые вопросы
- [21] V8 / Общий обзор
- [22] Rust / Гонки данных и состояния гонки
- [23] NumPy / Что такое NumPy?
- [24] C++ / Основные рекомендации
- [25] Zig / Справочник языка
- [26] Solana / Клиентские SDK
- [27] Programming-Language-Benchmarks / nbody
- [28] Programming-Language-Benchmarks / Measurement code (2025-07-31): execution, defaults, aggregation, Zig build, Deno configuration.
- [29] Programming-Language-Benchmarks / Published measurement data (2025-08-01)
- Логотипы и источники: Rust © Rust Foundation (CC BY 4.0, форма и цвета не изменены); Zig © Zig project (CC BY-SA 4.0, форма и цвета не изменены).
- Другие логотипы: Go © The Go Authors; TypeScript © Microsoft; Python © Python Software Foundation; C++ by Jeremy Kratz / Standard C++ Foundation; Node.js / OpenJS Foundation and Node.js contributors; Deno / Deno Land Inc..
- ERPC
- ERPC Web Dashboard