Solana HFT를 위한 저지연 아키텍처
데이터가 도착하고 있는데도 애플리케이션이 판단에 사용하는 가격은 여전히 오래된 값일 수 있습니다. Solana HFT 애플리케이션에서는 계산에 걸리는 시간과 함께, 수신한 데이터가 판단에 반영되기 전까지 기다리는 시간도 살펴봐야 합니다. 앞선 업데이트가 아직 처리 대기 중이거나, 로그 쓰기가 끝나지 않았거나, 다른 시장의 업데이트가 잠금을 잡고 있을 수 있습니다. 코드를 구성하는 방식에 따라 이러한 대기가 달라집니다.
이 글에서는 다섯 가지 패턴을 통해 수신 데이터가 어디에서 기다리는지, 설계를 바꾸면 어떤 작업이 진행될 수 있는지 살펴봅니다. 자신의 애플리케이션에 해당하는 증상부터 찾아 해당 절로 바로 이동해도 됩니다.
| 애플리케이션에서 나타나는 현상 | 검토할 설계 |
|---|---|
| 실행 시간이 길어질수록 미처리 데이터가 계속 늘어난다 | 1. 도착률, 처리율, 대기 한도 |
| 기록을 저장하는 동안 다음 가격을 처리할 수 없다 | 2. 판단에 필수적인 작업과 분석용 로깅의 분리 |
| 시장 A의 업데이트 때문에 시장 B의 업데이트가 기다린다 | 3. 독립된 상태를 보호하는 잠금의 분리 |
| 데이터가 도착할 때마다 같은 준비를 반복한다 | 4. 변하지 않는 부분의 사전 준비와 재사용 |
| 연결이 복구된 뒤에도 판단에 오래된 값을 사용한다 | 5. 연결 복구와 판단 상태 복구의 구분 |
각 절 끝에는 해당 개선을 자신의 애플리케이션에 적용할 수 있는 복사용 지시문이 있습니다. 프로젝트 코드를 읽을 수 있는 AI 에이전트에게 전달해 사용하세요.
도식에 나오는 데이터 수, 가격, 작업 횟수, 시간은 설명을 위한 모델입니다. 측정된 성능이나 거래 결과를 나타내지 않습니다.
도표를 탭하거나 클릭하면 원본 크기로 볼 수 있습니다.
1. 도착량과 처리 능력을 비교하고 대기 한도를 정한다
길이가 같은 각 시간 구간에 이벤트 여섯 개를 받고 두 개를 처리할 수 있는 애플리케이션을 생각해 보겠습니다. 첫 구간이 끝나면 네 개가 미처리 상태로 남습니다. 데이터가 처리를 기다리는 곳이 큐입니다.
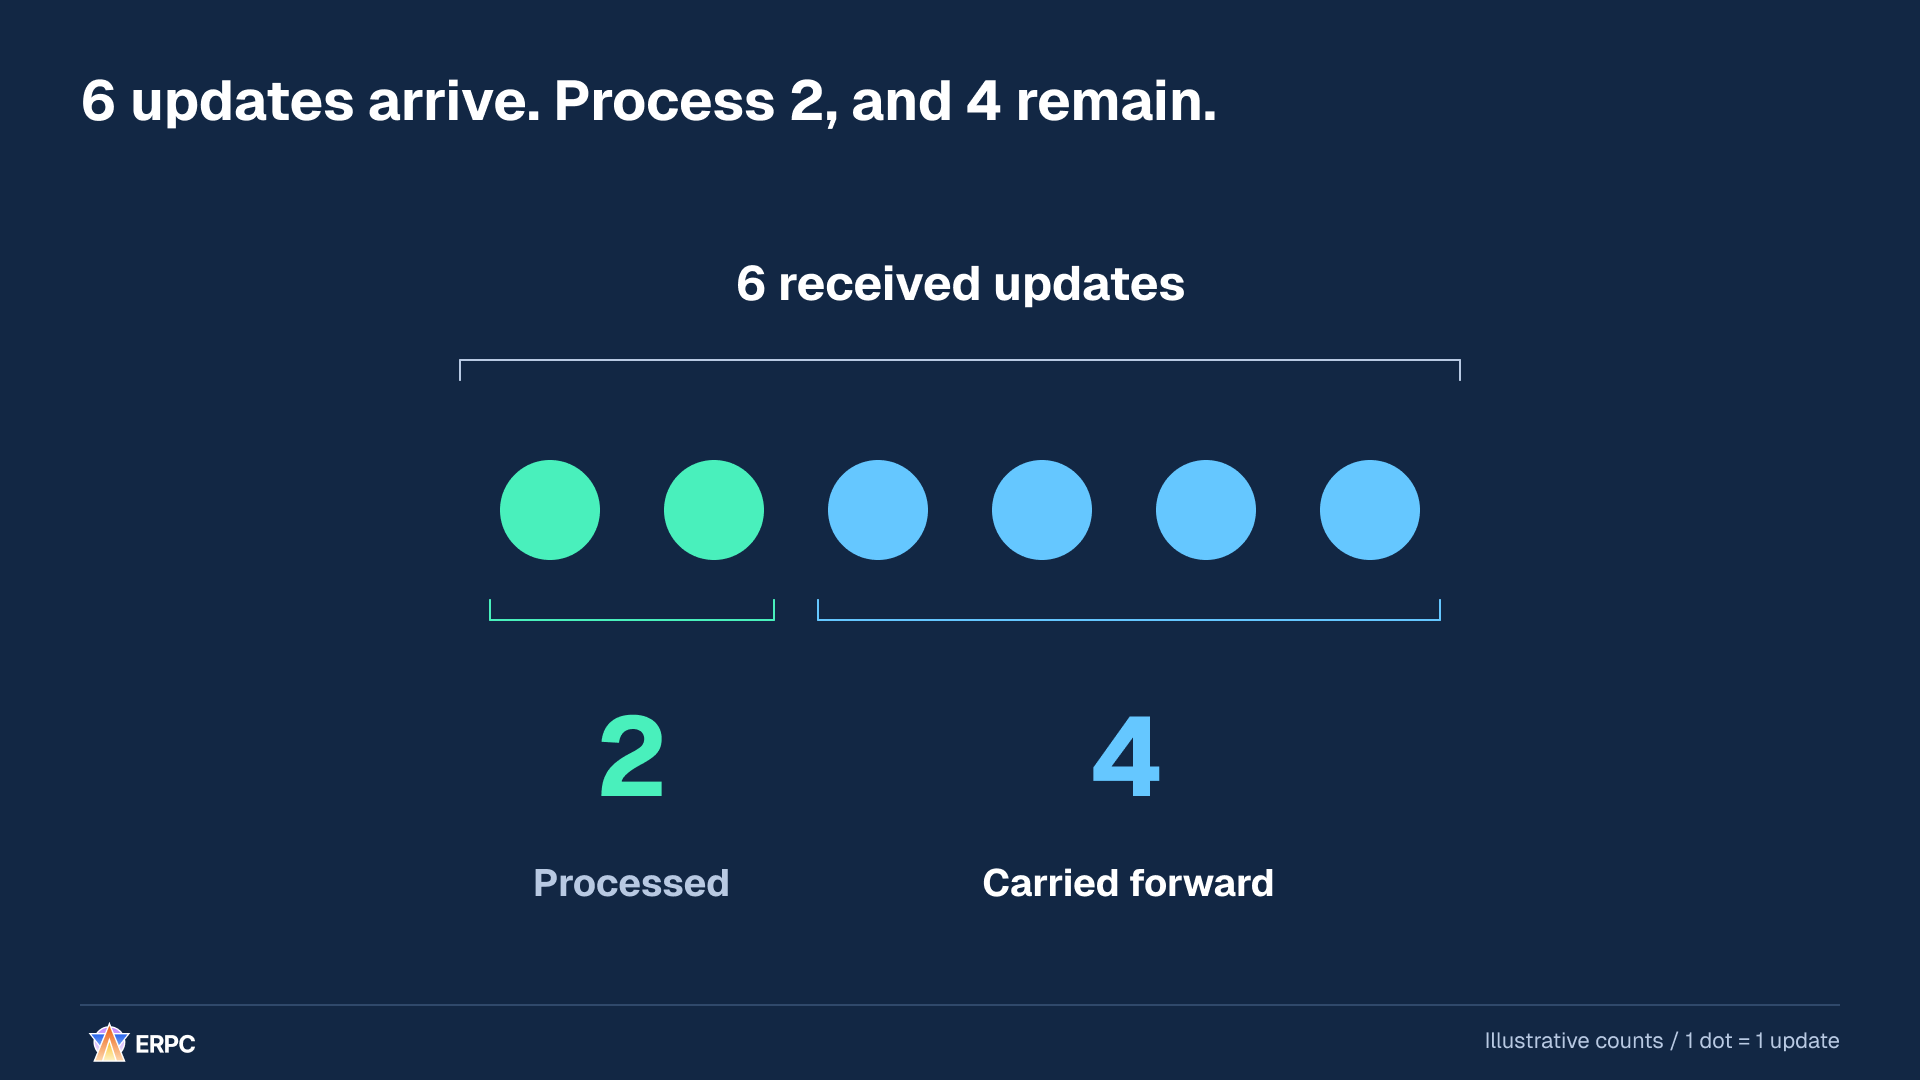
처리는 진행되고 있지만, 네 개의 이벤트는 아직 판단에 사용되지 않았습니다.
같은 비율을 유지한 채 도착량을 60,000개로 늘려 보겠습니다. 20,000개를 처리하면 40,000개가 대기합니다. 도식 오른쪽에서는 점 하나가 이벤트 100개를, 점 100개를 묶은 그룹 하나가 이벤트 10,000개를 나타냅니다. 두 그룹은 처리되었고 네 그룹은 대기 중입니다.
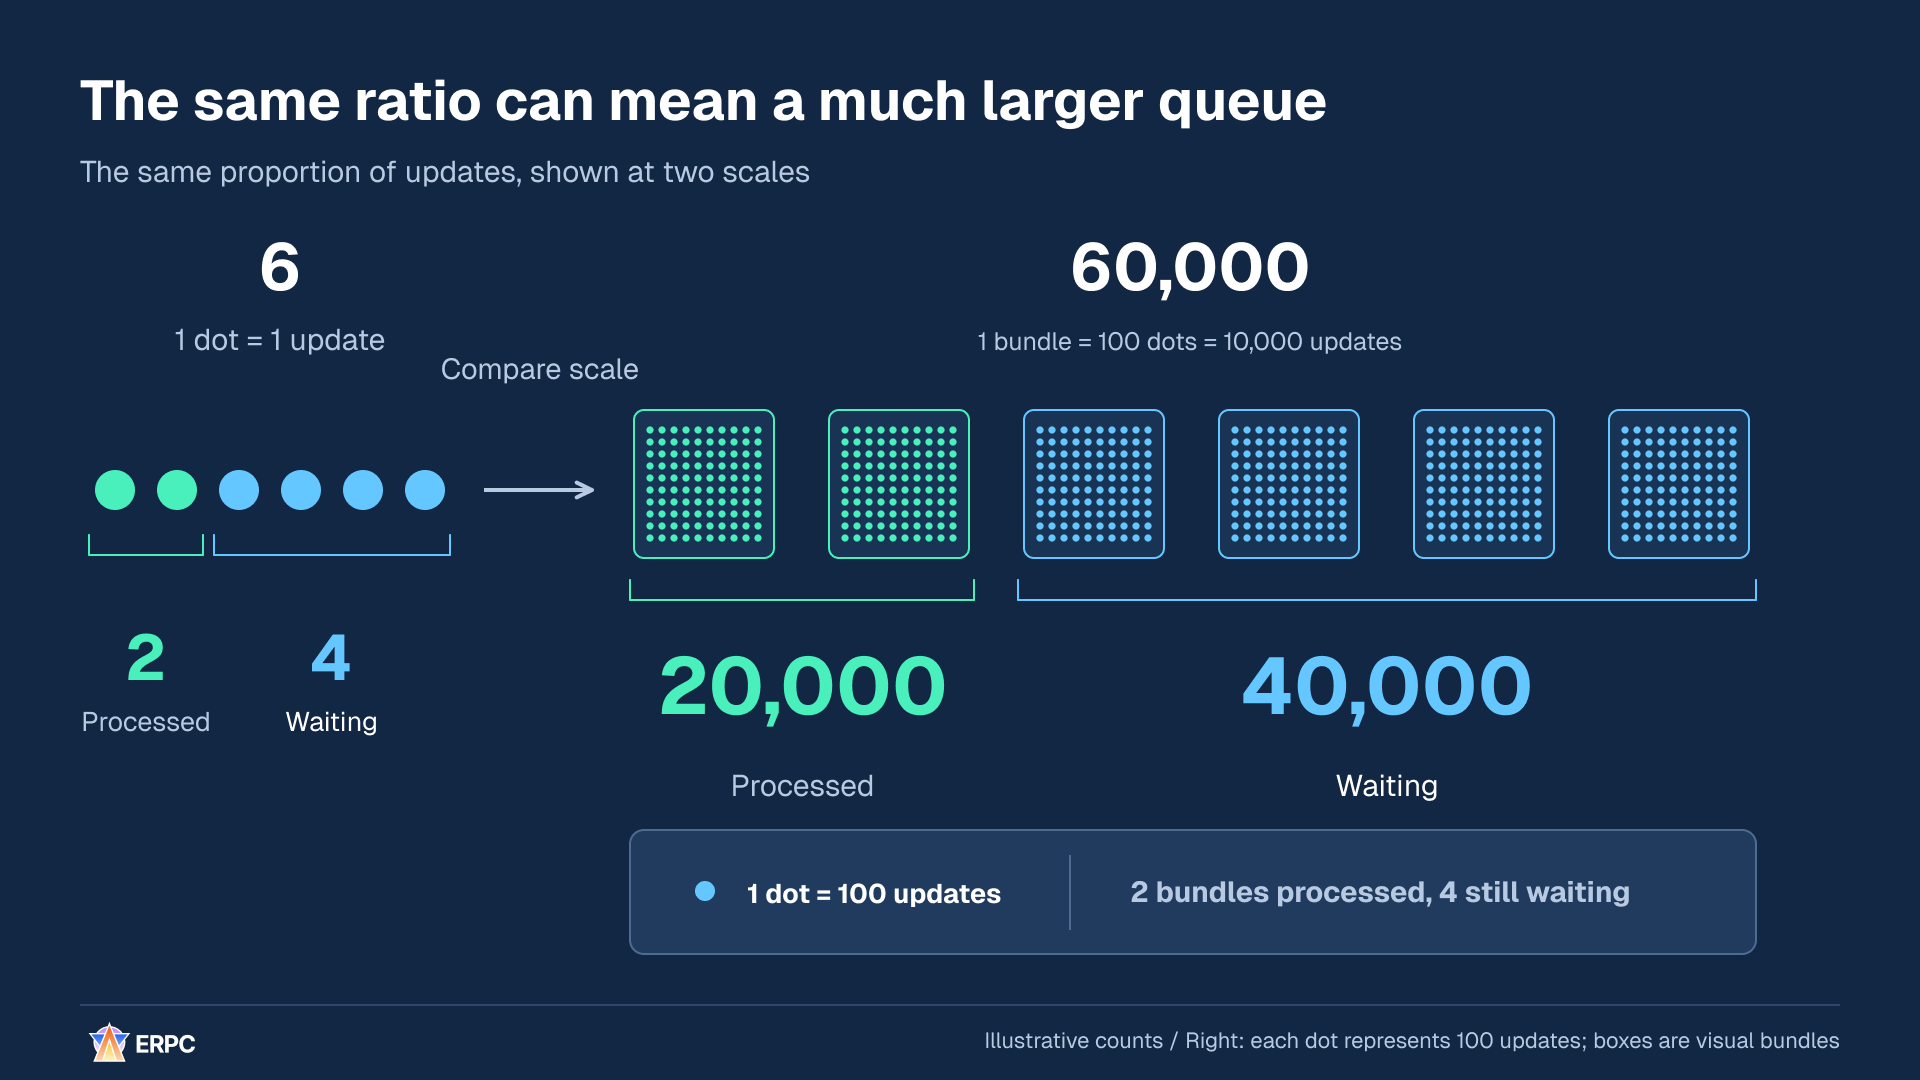
오른쪽의 그룹은 데이터 양을 표현하기 위한 것입니다. 애플리케이션의 처리 배치를 뜻하지 않습니다.
다음 구간은 이미 40,000개가 기다리는 상태에서 시작합니다. 60,000개가 더 도착하고 20,000개를 처리하면 80,000개가 남습니다. 그다음 구간이 끝나면 120,000개가 남습니다. 새로 도착한 가격은 큐에 이미 들어 있는 작업 뒤에서 기다려야 합니다.
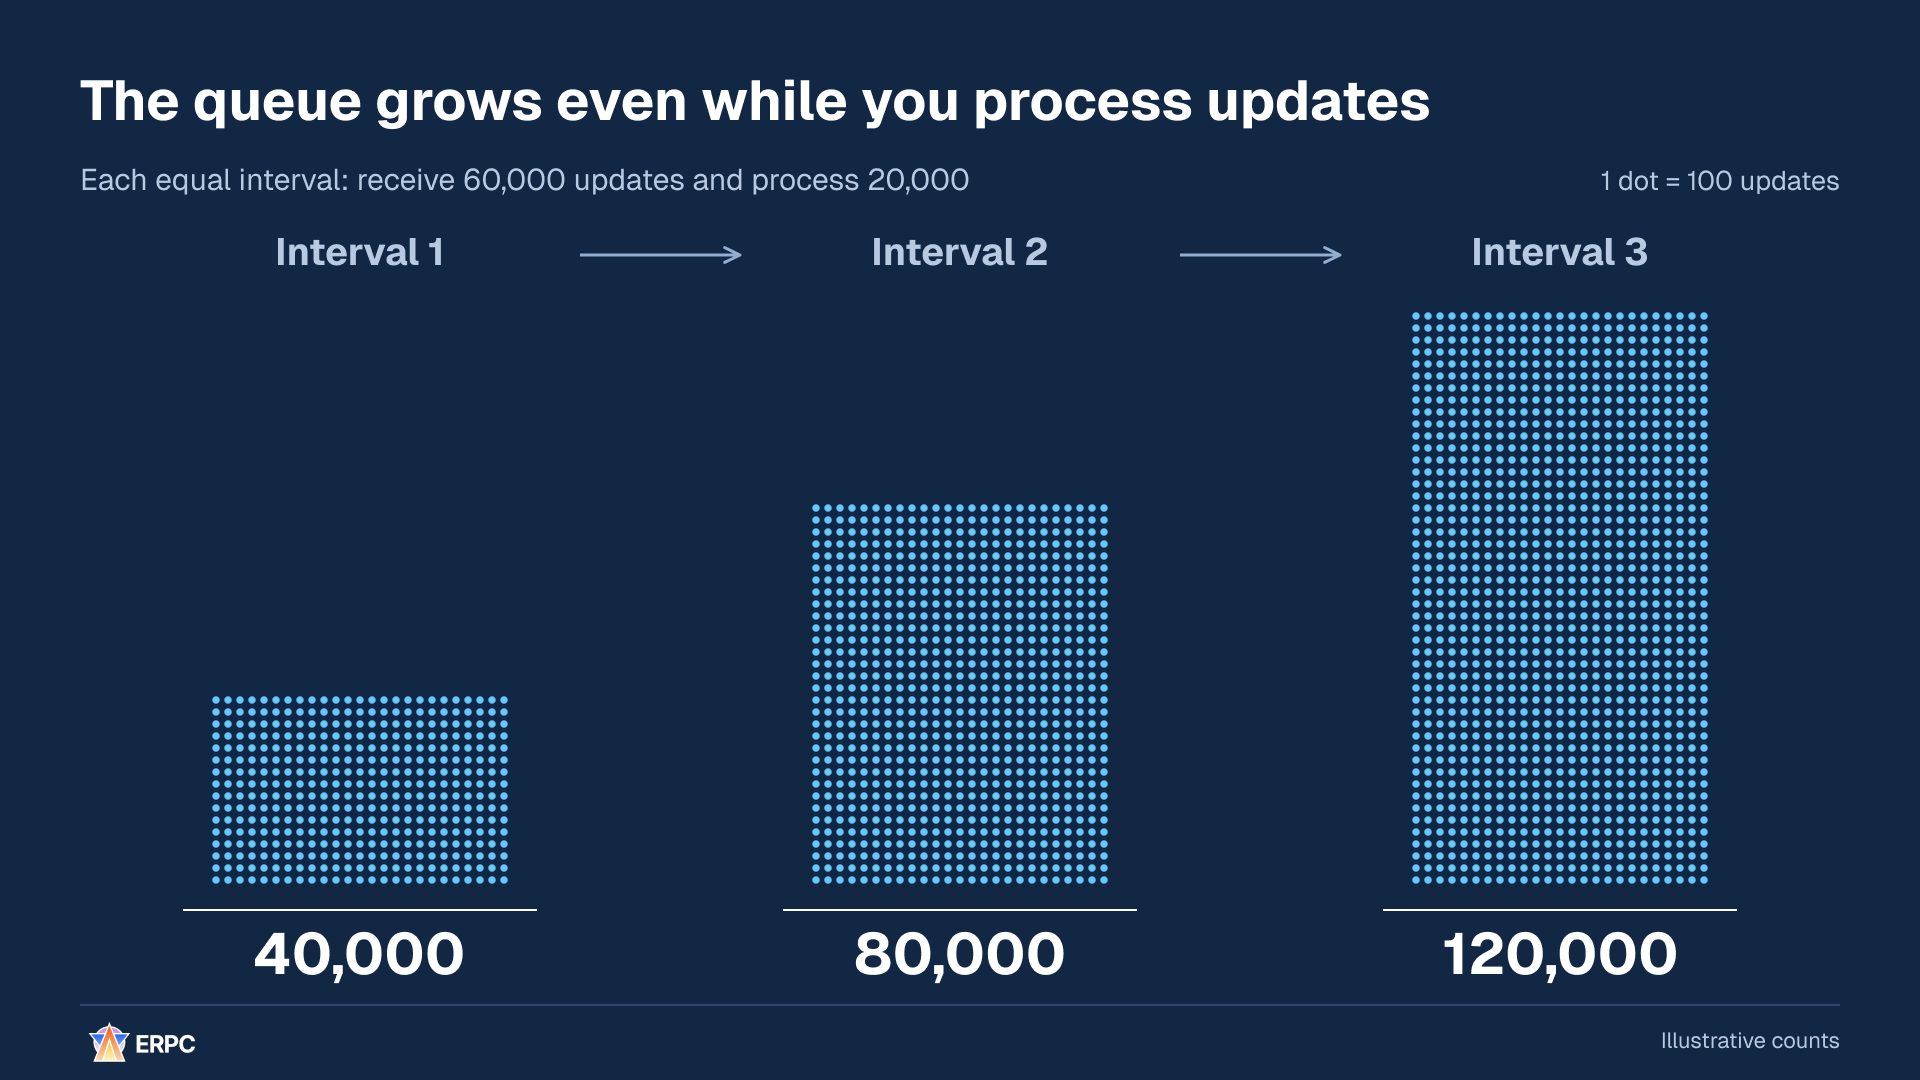
도착량이 처리 능력을 지속해서 넘으면 적체는 계속 커집니다.
큐는 짧은 시간에 도착이 집중되는 버스트를 흡수하는 데 도움이 됩니다. 하지만 큐 용량을 늘려도 이 예처럼 처리 능력이 계속 부족한 문제는 해결되지 않습니다. 보관 중인 항목 수와 바이트 수뿐 아니라 가장 오래된 항목이 얼마나 기다렸는지도 관찰하고 허용 한도를 정해야 합니다. 필요한 최신성 조건을 더 이상 만족하지 못하면, 업데이트가 하나도 유실되지 않았더라도 해당 값에 의존하는 신규 거래 판단을 일시 중지해야 합니다.
한도에 도달하면 어떻게 해야 할까요? 다음 도식에서는 사용 가능한 여덟 칸이 모두 찬 상태에서 업데이트 두 개가 더 도착합니다. 이 두 업데이트를 보관할 수 없고 판단에 반드시 필요하다면, 애플리케이션은 저장된 값을 올바르게 갱신할 수 없습니다. 해당 값에 의존하는 신규 거래 판단을 중지하고, 필요한 업데이트를 복구한 뒤 재개해야 합니다.
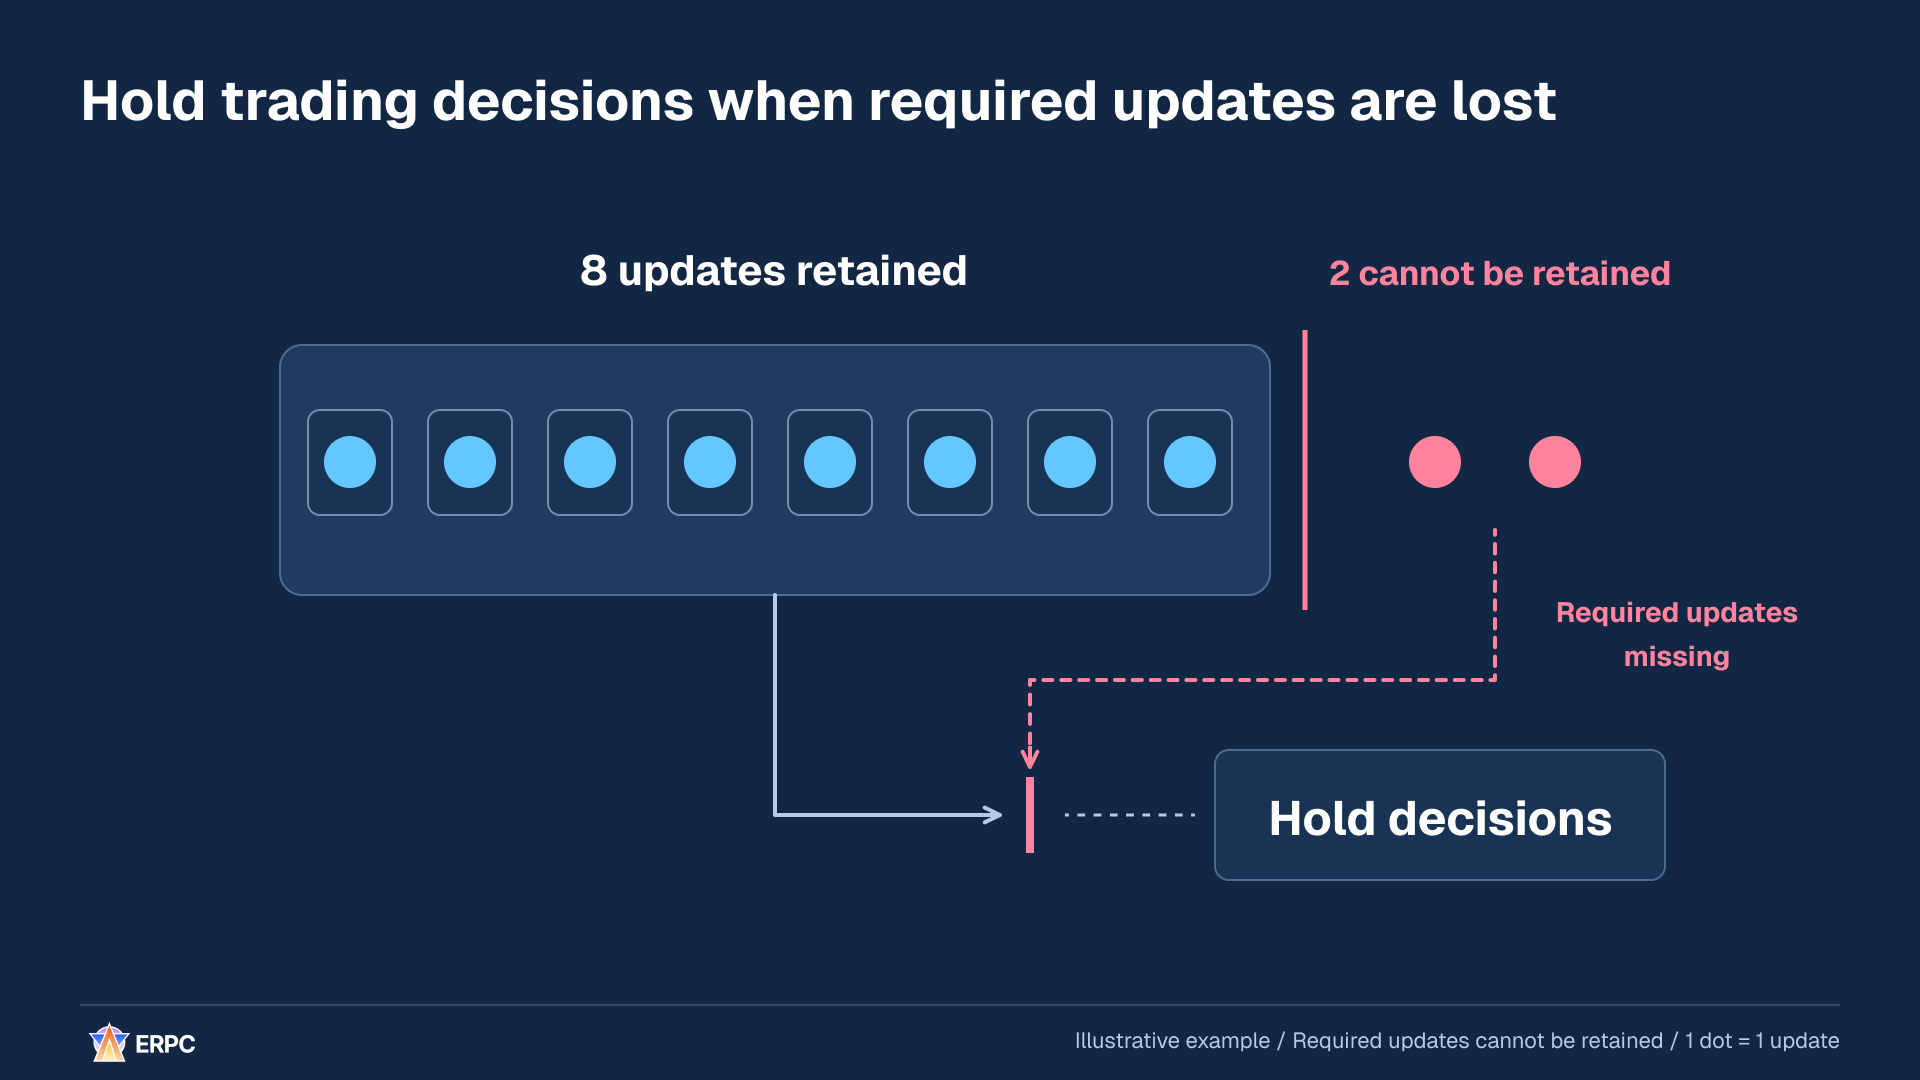
큐 설계에는 한도에 도달한 뒤의 동작도 포함되어야 합니다.
작업량을 줄이거나 처리 능력을 높일 수 있는지 검토하세요. 소비자가 동일한 대상의 최신 전체 상태만 필요로 한다면, 중간값을 최신 값 하나로 합칠 수 있습니다. 반면 델타를 누적하거나 중간 이벤트를 사용하는 처리에서는 업데이트를 생략하면 결과가 달라집니다.
수신을 일시 중지하면 대기가 상류로 옮겨갈 수도 있습니다. 송수신 속도를 조절하는 gRPC 흐름 제어를, 구독 데이터 범위를 좁히는 서버 측 필터와 애플리케이션의 실제 처리 능력과 함께 검토하세요.[3][4]
수신 큐의 적체와 데이터의 최신성을 개선하려면 다음 지시문을 복사하세요.
text
처리가 수신량을 따라가지 못해 판단에 쓰는 데이터가 오래되는 문제를 이 애플리케이션에서 개선하세요.

README, 개발 지침, 의존성, 수신 → 큐 → 상태 업데이트 → 판단 코드를 읽으세요. 기존 언어, 런타임, SDK로 진행하세요. 업데이트가 완전한 상태인지 변경분인지, 필요한 적용 순서와 최신성 요건이 무엇인지 확인하세요.

1. 기밀 정보를 제외한 재현 가능한 입력을 저장하고 변경 전 기준값을 기록하세요. 큐에 들어가기 전의 대기도 살펴보세요. 같은 구간에서 유입·유출 항목 수와 바이트 수, 큐에 쌓인 작업량, 가장 오래 기다리는 항목의 나이, 실행 중인 작업량을 측정하세요.
2. 항목 수, 바이트 수, 대기 시간, 동시 실행 수의 상한을 각각의 근거와 함께 정하고 구현하세요. 요건을 모르면 가정을 명시하세요. 불필요한 수신이나 처리를 줄일 수 있는지, 처리 능력이 충분한지도 확인하세요. 큐를 키운 것만으로 지속적인 처리 능력 부족이 해결됐다고 보지 마세요.
3. 큐가 가득 찼을 때의 동작을 정의하세요. 필요한 업데이트를 보관할 수 없거나, 업데이트 누락이 없어도 필요한 최신성을 잃었다면 해당 값에 의존하는 새로운 거래 판단을 중지하세요. 상태 업데이트와 복구를 계속 진행하고 재개 조건을 확인하세요.
4. 중간 값을 합친다면 같은 대상의 가장 최신인 완전한 상태만으로 결과를 유지할 수 있는지 확인하세요. 필요한 변경분이나 이벤트를 알리지 않고 버리지 마세요. 수신을 중지한다면 제공자의 흐름 제어 동작과 대기가 옮겨가는 위치도 확인하세요.
5. 같은 조건에서 정상 입력, 버스트, 지속적인 과부하, 가득 찬 큐에서의 회복을 재생하세요. 유입률과 처리율, 가장 오래된 항목의 대기 시간, 수신부터 판단 완료까지의 p50/p95/p99, CPU와 메모리, 누락되거나 버려진 업데이트를 비교하세요. 적용된 상태와 판단을 예상 결과에 대조하세요. 한 호스트 안의 경과 시간은 단조 시계로 측정하고 측정의 시작점과 끝점을 명시하세요.

기존 승인, 권한, 개발 절차를 유지하세요. 이 지시문만으로 운영 환경 변경, 유료 계약 체결, 실제 거래 실행에 대한 추가 권한이 생겼다고 해석하지 마세요. 비밀 키, 인증 정보, 고객 데이터를 출력하지 마세요.

변경 사항, 비교 조건, 변경 전후 측정값, 정확성 확인 결과, 남은 제약을 보고하세요. 측정할 수 없는 값은 미측정으로 표시하세요.
처리가 수신량을 따라가지 못해 판단에 쓰는 데이터가 오래되는 문제를 이 애플리케이션에서 개선하세요.
README, 개발 지침, 의존성, 수신 → 큐 → 상태 업데이트 → 판단 코드를 읽으세요. 기존 언어, 런타임, SDK로 진행하세요. 업데이트가 완전한 상태인지 변경분인지, 필요한 적용 순서와 최신성 요건이 무엇인지 확인하세요.
1. 기밀 정보를 제외한 재현 가능한 입력을 저장하고 변경 전 기준값을 기록하세요. 큐에 들어가기 전의 대기도 살펴보세요. 같은 구간에서 유입·유출 항목 수와 바이트 수, 큐에 쌓인 작업량, 가장 오래 기다리는 항목의 나이, 실행 중인 작업량을 측정하세요.
2. 항목 수, 바이트 수, 대기 시간, 동시 실행 수의 상한을 각각의 근거와 함께 정하고 구현하세요. 요건을 모르면 가정을 명시하세요. 불필요한 수신이나 처리를 줄일 수 있는지, 처리 능력이 충분한지도 확인하세요. 큐를 키운 것만으로 지속적인 처리 능력 부족이 해결됐다고 보지 마세요.
3. 큐가 가득 찼을 때의 동작을 정의하세요. 필요한 업데이트를 보관할 수 없거나, 업데이트 누락이 없어도 필요한 최신성을 잃었다면 해당 값에 의존하는 새로운 거래 판단을 중지하세요. 상태 업데이트와 복구를 계속 진행하고 재개 조건을 확인하세요.
4. 중간 값을 합친다면 같은 대상의 가장 최신인 완전한 상태만으로 결과를 유지할 수 있는지 확인하세요. 필요한 변경분이나 이벤트를 알리지 않고 버리지 마세요. 수신을 중지한다면 제공자의 흐름 제어 동작과 대기가 옮겨가는 위치도 확인하세요.
5. 같은 조건에서 정상 입력, 버스트, 지속적인 과부하, 가득 찬 큐에서의 회복을 재생하세요. 유입률과 처리율, 가장 오래된 항목의 대기 시간, 수신부터 판단 완료까지의 p50/p95/p99, CPU와 메모리, 누락되거나 버려진 업데이트를 비교하세요. 적용된 상태와 판단을 예상 결과에 대조하세요. 한 호스트 안의 경과 시간은 단조 시계로 측정하고 측정의 시작점과 끝점을 명시하세요.
기존 승인, 권한, 개발 절차를 유지하세요. 이 지시문만으로 운영 환경 변경, 유료 계약 체결, 실제 거래 실행에 대한 추가 권한이 생겼다고 해석하지 마세요. 비밀 키, 인증 정보, 고객 데이터를 출력하지 마세요.
변경 사항, 비교 조건, 변경 전후 측정값, 정확성 확인 결과, 남은 제약을 보고하세요. 측정할 수 없는 값은 미측정으로 표시하세요.2. 기록 저장을 기다리지 않고 다음 가격을 처리한다
시장 가격이 100에서 101로 바뀌는 상황을 생각해 보겠습니다. 애플리케이션은 100을 반영하고 판단을 끝낸 뒤 분석용 기록을 저장하고 있습니다. 수신 데이터 처리 루프가 저장 완료를 기다린다면, 업데이트가 도착해도 101을 반영할 수 없습니다. 애플리케이션에 저장된 가격은 100으로 남습니다.
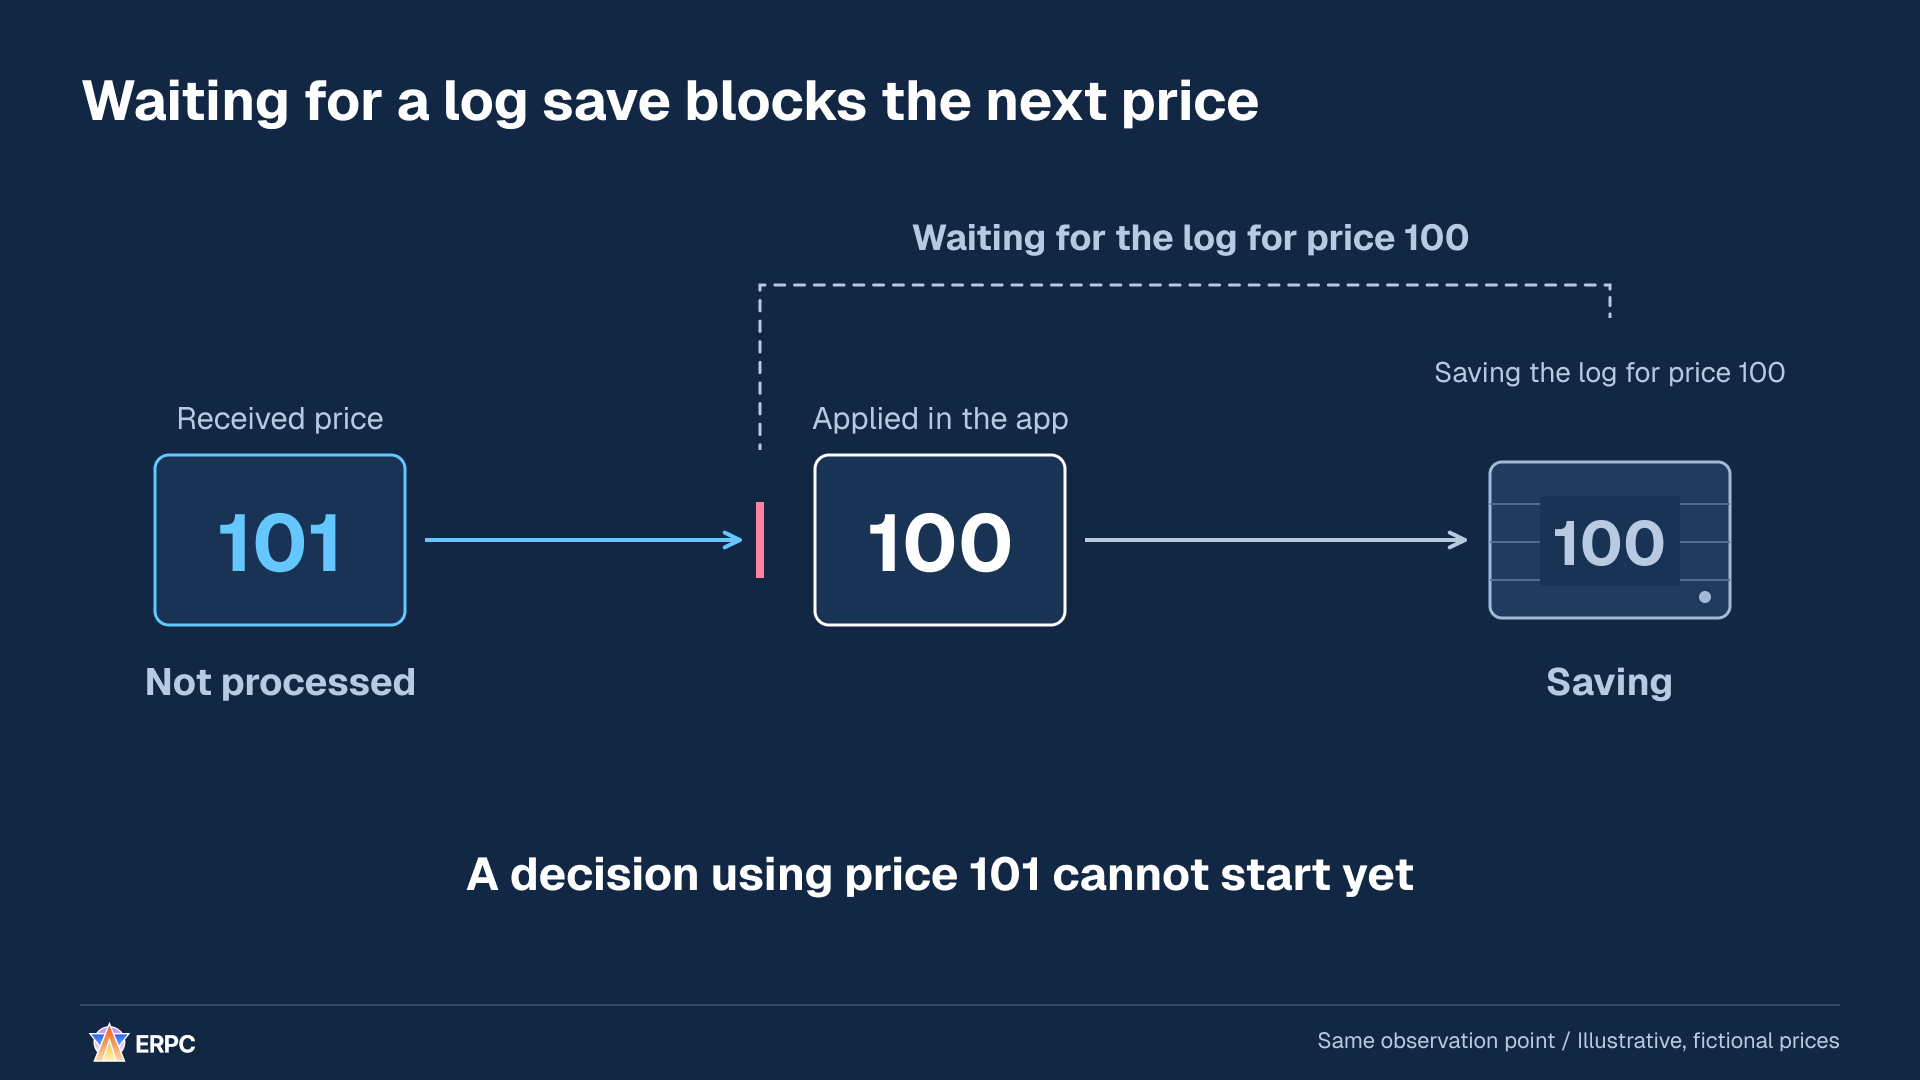
101의 처리를 시작하지 못하는 원인은 100의 기록 저장을 기다리기 때문입니다.
이제 분석용 기록을 여유 용량이 있는 보조 큐에 넘기고, 별도 작업이 저장하게 해 보겠습니다. 전달이 끝나면 수신 루프는 다음 입력으로 돌아갈 수 있습니다. 100의 저장이 진행되는 동안에도 101을 반영하고 판단할 수 있습니다.
다음 비교에서는 100의 저장 시간, 101의 도착 시점, 101의 처리에 필요한 시간을 동일하게 유지했습니다. 달라지는 것은 다음 입력으로 넘어가기 위해 저장 완료를 기다려야 하는지 여부입니다.
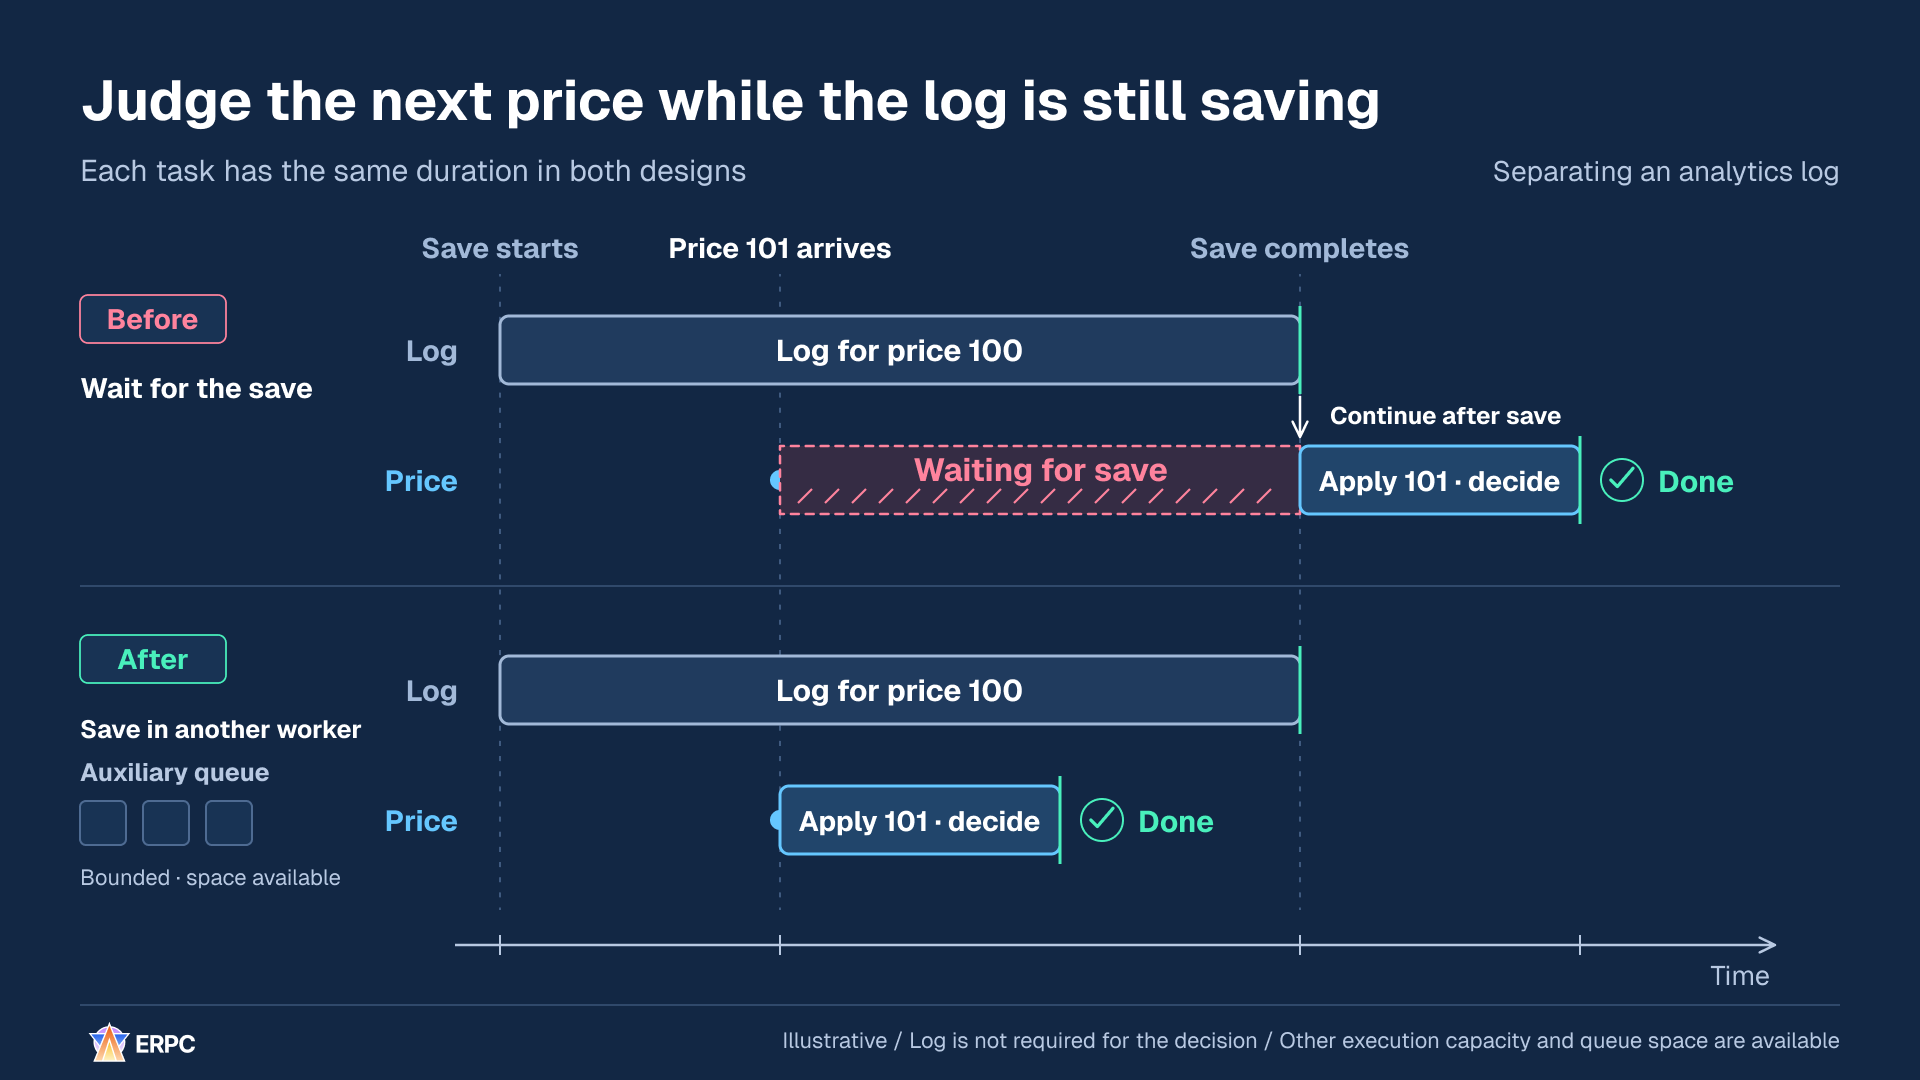
101 자체의 작업 시간을 줄이지 않아도, 작업 시작 전의 대기를 줄일 수 있습니다.
수신에서 판단과 제출까지 반드시 거치는 처리 경로를 핫패스(hot path)라고 합니다. 이 예에서는 판단을 늦출 필요가 없는 분석용 로깅을 해당 경로 밖으로 옮겼습니다. 잔액 확인, 위험 한도 확인, 정확성을 유지하기 위해 완료되어야 하는 저장은 요구사항이 정한 위치에 남겨야 합니다.
저장 작업 자체는 여전히 존재하므로 보조 큐에도 용량과 대기 시간의 한도가 필요합니다. 별도 태스크가 반드시 별도 CPU에서 실행되는 것은 아닙니다. Tokio의 긴 CPU 작업이나 블로킹 작업, Node.js 이벤트 루프의 긴 동기 작업은 다른 작업의 진행을 막을 수 있습니다. 작업을 옮길 때 실제 실행 위치를 확인하세요.[1][2]
분석용 기록의 저장 대기를 판단 경로에서 분리하려면 다음 지시문을 복사하세요.
text
분석용 기록의 저장 완료를 기다리느라 다음 업데이트를 반영하거나 판단에 사용할 수 없는 부분을 이 애플리케이션에서 개선하세요.

README, 개발 지침, 의존성, 수신 루프를 읽으세요. 기존 언어, 런타임, 저장 라이브러리로 진행하세요. 저장 완료를 기다리는 위치와 작업이 실제로 실행되는 스레드, 태스크, 이벤트 루프를 확인하세요.

1. 기밀 정보를 제외한 재현 가능한 입력을 준비하세요. 수신, 상태 반영, 판단 시작·완료, 저장 시작·완료 시점과 현재 결과를 기록하세요.
2. 요건을 바탕으로 저장 완료가 판단이나 복구의 전제조건인지 확인하세요. 잔액 확인, 위험 확인, 정확성에 필수적인 영속 저장은 필요한 위치에 남기세요. 나중에 저장을 끝내도 되는 분석용 기록을 분리하세요.
3. 이후의 상태 변경이 기록할 값을 바꾸지 않도록 기록의 전달 방식을 정하세요. 용량이 제한된 보조 큐와 저장을 담당하는 소비자를 구현하세요. 항목 수·바이트 수·대기 시간 상한, 큐가 가득 찬 경우·저장 실패·재시도·종료 시 동작, 기록 보존 요건을 명시하세요. 보존 요건을 모르는 상태에서 기록을 버리지 마세요.
4. 태스크를 나누면 다른 CPU에서 실행된다고 가정하지 마세요. 동기 I/O와 긴 CPU 작업이 어디서 실행되는지 확인하세요. 워커 등의 기능을 사용하면 동시 실행 수를 제한하고 변환, 복사, 작업 전달 대기를 평가에 포함하세요.
5. 같은 입력과 도착 속도로 정상 저장, 느린 저장, 실패, 보조 큐가 가득 찬 상황, 종료를 재현하세요. 수신부터 판단 완료까지의 p50/p95/p99, 저장 측 대기와 적체, CPU와 메모리, 누락·중복 기록을 비교하세요. 상태와 판단의 정확성, 기록 보존 요건을 검증하세요. 한 호스트 안의 경과 시간은 단조 시계로 측정하고 측정의 시작점과 끝점을 명시하세요.

기존 승인, 권한, 개발 절차를 유지하세요. 이 지시문만으로 운영 환경 변경, 유료 계약 체결, 실제 거래 실행에 대한 추가 권한이 생겼다고 해석하지 마세요. 비밀 키, 인증 정보, 고객 데이터를 출력하지 마세요.

변경 사항, 비교 조건, 변경 전후 측정값, 정확성 확인 결과, 남은 제약을 보고하세요. 측정할 수 없는 값은 미측정으로 표시하세요.
분석용 기록의 저장 완료를 기다리느라 다음 업데이트를 반영하거나 판단에 사용할 수 없는 부분을 이 애플리케이션에서 개선하세요.
README, 개발 지침, 의존성, 수신 루프를 읽으세요. 기존 언어, 런타임, 저장 라이브러리로 진행하세요. 저장 완료를 기다리는 위치와 작업이 실제로 실행되는 스레드, 태스크, 이벤트 루프를 확인하세요.
1. 기밀 정보를 제외한 재현 가능한 입력을 준비하세요. 수신, 상태 반영, 판단 시작·완료, 저장 시작·완료 시점과 현재 결과를 기록하세요.
2. 요건을 바탕으로 저장 완료가 판단이나 복구의 전제조건인지 확인하세요. 잔액 확인, 위험 확인, 정확성에 필수적인 영속 저장은 필요한 위치에 남기세요. 나중에 저장을 끝내도 되는 분석용 기록을 분리하세요.
3. 이후의 상태 변경이 기록할 값을 바꾸지 않도록 기록의 전달 방식을 정하세요. 용량이 제한된 보조 큐와 저장을 담당하는 소비자를 구현하세요. 항목 수·바이트 수·대기 시간 상한, 큐가 가득 찬 경우·저장 실패·재시도·종료 시 동작, 기록 보존 요건을 명시하세요. 보존 요건을 모르는 상태에서 기록을 버리지 마세요.
4. 태스크를 나누면 다른 CPU에서 실행된다고 가정하지 마세요. 동기 I/O와 긴 CPU 작업이 어디서 실행되는지 확인하세요. 워커 등의 기능을 사용하면 동시 실행 수를 제한하고 변환, 복사, 작업 전달 대기를 평가에 포함하세요.
5. 같은 입력과 도착 속도로 정상 저장, 느린 저장, 실패, 보조 큐가 가득 찬 상황, 종료를 재현하세요. 수신부터 판단 완료까지의 p50/p95/p99, 저장 측 대기와 적체, CPU와 메모리, 누락·중복 기록을 비교하세요. 상태와 판단의 정확성, 기록 보존 요건을 검증하세요. 한 호스트 안의 경과 시간은 단조 시계로 측정하고 측정의 시작점과 끝점을 명시하세요.
기존 승인, 권한, 개발 절차를 유지하세요. 이 지시문만으로 운영 환경 변경, 유료 계약 체결, 실제 거래 실행에 대한 추가 권한이 생겼다고 해석하지 마세요. 비밀 키, 인증 정보, 고객 데이터를 출력하지 마세요.
변경 사항, 비교 조건, 변경 전후 측정값, 정확성 확인 결과, 남은 제약을 보고하세요. 측정할 수 없는 값은 미측정으로 표시하세요.3. 독립된 업데이트가 같은 잠금을 기다리지 않게 한다
시장 A와 시장 B의 가격을 독립적으로 갱신할 수 있는 애플리케이션을 생각해 보겠습니다. A의 업데이트가 시작한 뒤 B의 업데이트가 도착합니다. 하나의 mutex가 A와 B를 함께 보호하면, B는 A가 잠금을 해제할 때까지 기다려야 합니다.
mutex는 보호하는 데이터에 접근할 권한을 한 번에 한 작업에만 부여합니다. 다른 작업이 사용 중이면 같은 잠금을 얻으려는 작업은 기다립니다.[17]
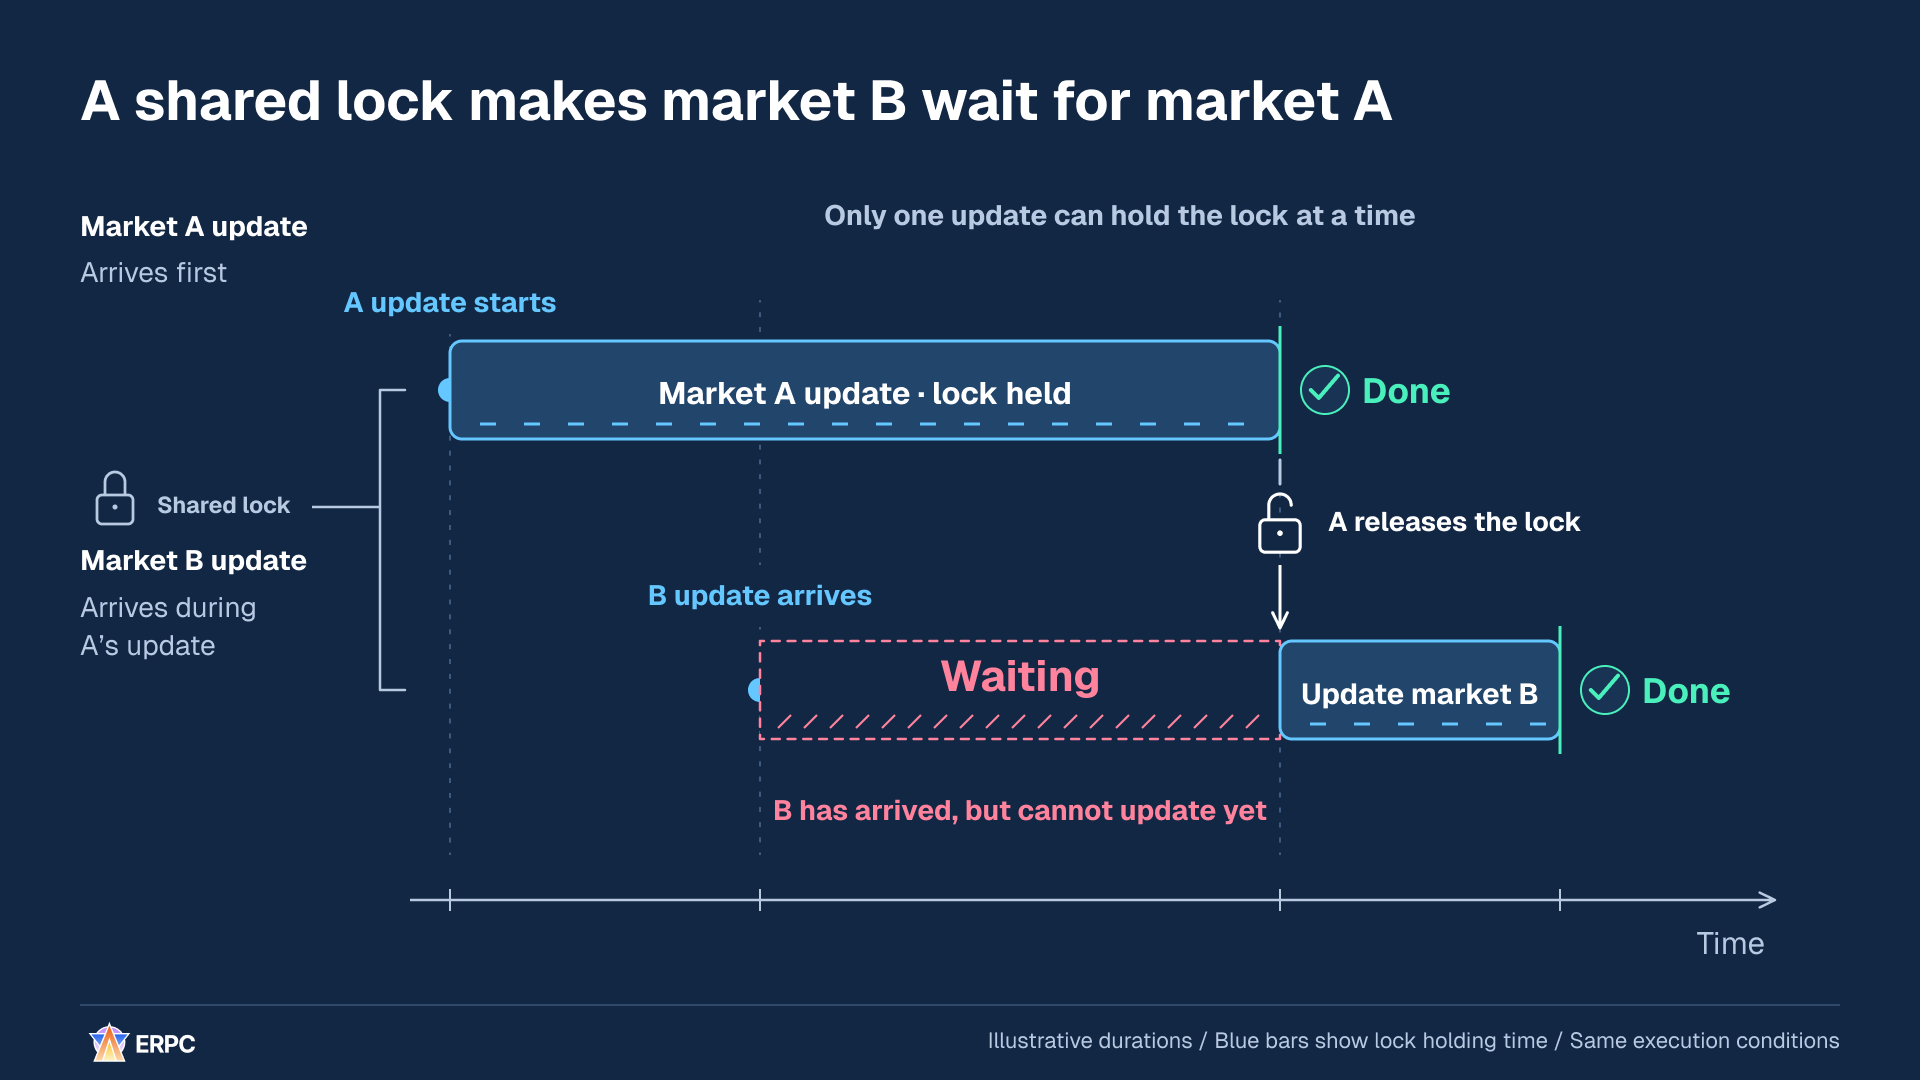
B의 데이터는 이미 도착했지만 A가 보유한 공유 잠금을 기다리고 있습니다.
A와 B가 각각 별개의 값을 변경한다면, 서로 다른 잠금으로 보호하는 방법이 있습니다. 다음 도식의 위쪽은 공유 잠금, 아래쪽은 개별 잠금을 사용합니다. 두 설계에서 A와 B의 도착 위치와 잠금 보유 시간은 같습니다. B의 잠금이 비어 있고 B를 실행할 여력이 있다는 조건의 예입니다. Tokio 공식 튜토리얼도 독립적인 키를 가진 데이터에 대한 mutex 샤딩을 설명합니다.[18]
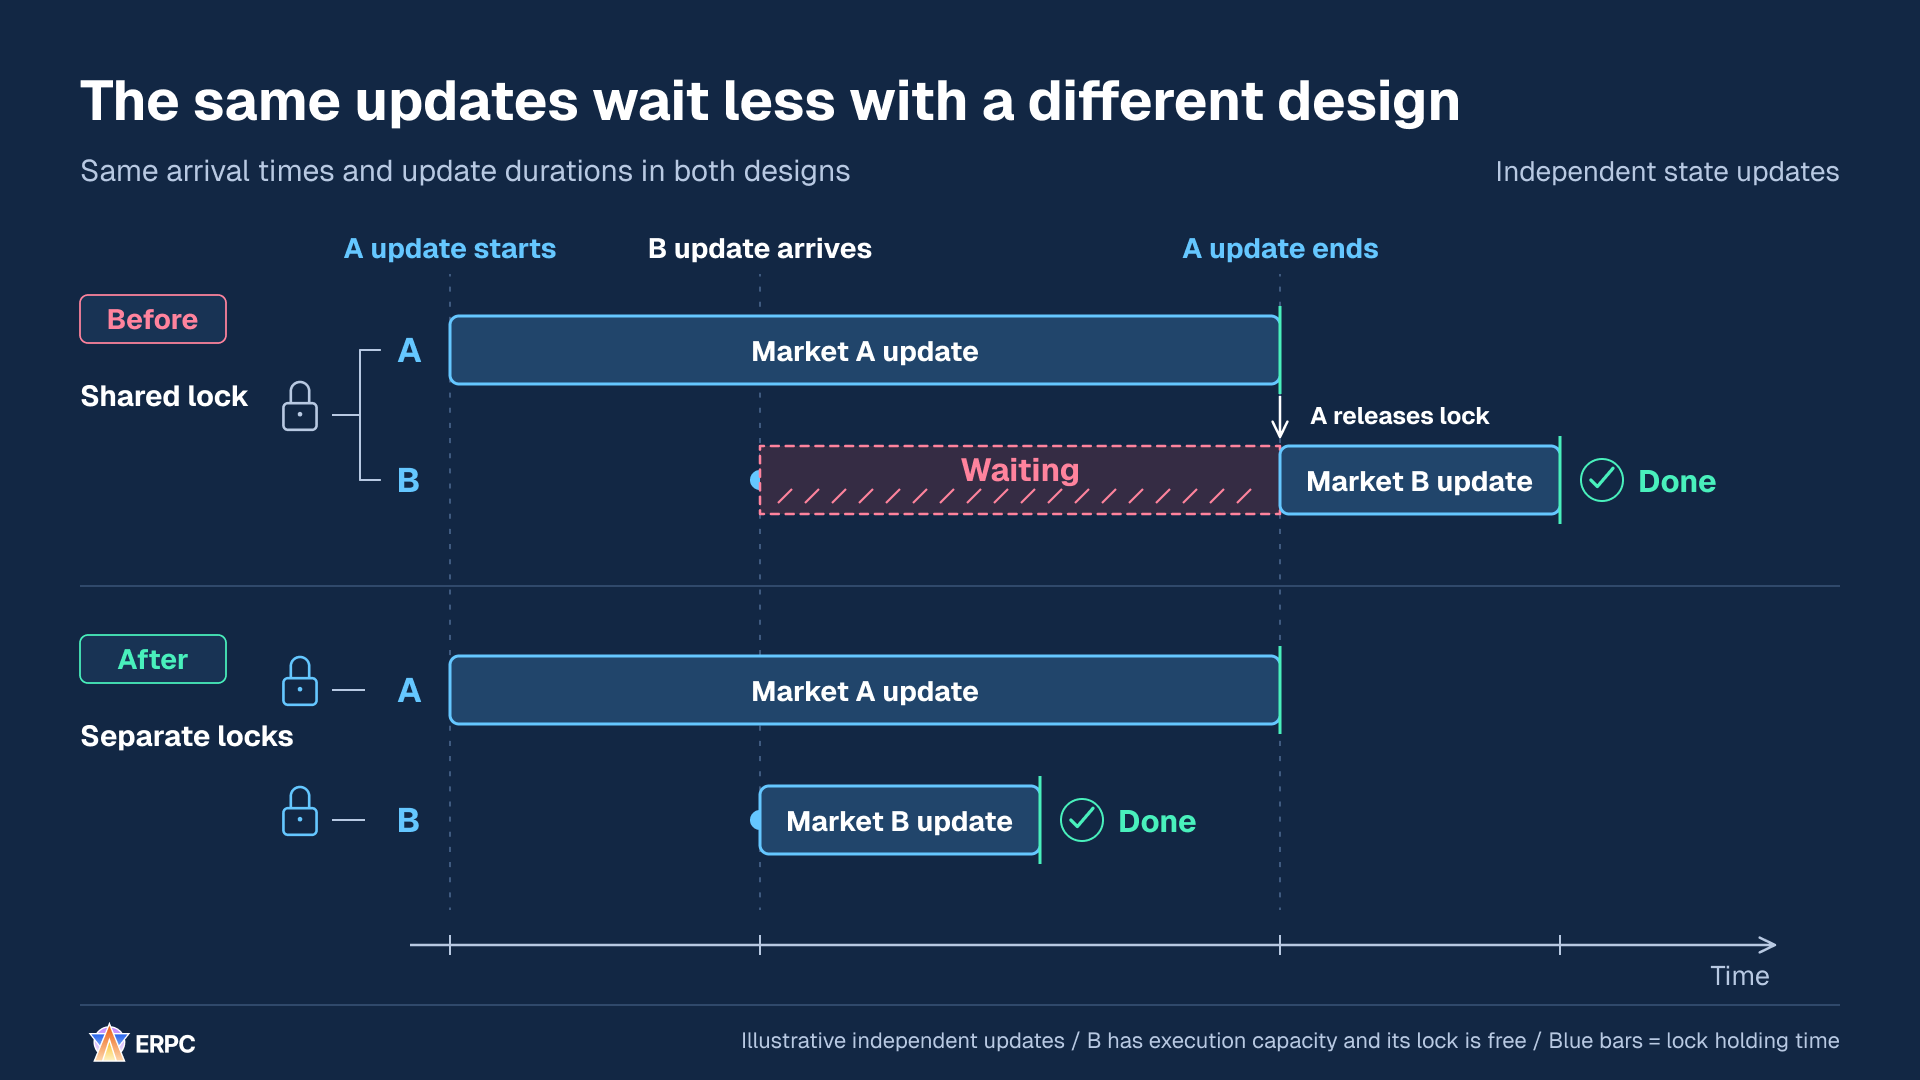
B의 파란 막대 길이는 같습니다. 사라진 부분은 앞에 있던 분홍색 대기 구간입니다.
파란 막대는 잠금을 획득한 시점부터 해제할 때까지를 나타냅니다. 이 예에서는 A가 아직 갱신 중일 때 B가 끝납니다. 잠금을 나눠도 B 자신의 잠금이 사용 중이거나 다른 작업이 실행 자원을 차지해서 발생하는 대기는 없어지지 않습니다.
잠금을 나누기 전에 어떤 업데이트가 독립적인지 확인하세요. A와 B의 가격을 따로 갱신할 수 있더라도, 두 가격이나 공유 잔액을 사용하는 판단에는 필요한 값을 일관되게 읽는 방법이 필요합니다. 같은 스레드에서도 await에서 작업이 중단된 사이 값이 바뀔 수 있습니다. 판단이 어느 버전을 어떤 방식으로 읽는지, 업데이트를 어떤 순서로 적용하는지 정의하세요.
예를 들어 A와 B가 같은 잔액을 읽고 각각 주문을 만들면, 둘 다 같은 자금을 사용할 수 있다고 판단할 수 있습니다. 공유 값은 별도의 보호가 필요합니다. 한 소유자가 주문마다 순서대로 잔액을 확인하고 자금을 예약하게 하는 방법 등이 있습니다.
각 상태에 갱신 소유자를 하나만 두고 업데이트 메시지를 보내는 방법도 있습니다. 이것이 Single Writer 원칙입니다. 잠금을 나누는 것과 단일 작성자를 선택하는 것은 별개의 설계 결정입니다. LMAX Disruptor는 Single Writer와 처리 의존성을, Tokio는 전용 태스크에 메시지를 보내 상태를 관리하는 방법을 설명합니다.[5][18]
독립된 업데이트 사이의 잠금 대기를 줄이려면 다음 지시문을 복사하세요.
text
한 시장이나 키의 업데이트가 독립된 다른 업데이트까지 같은 공유 잠금에서 기다리게 하는 문제를 이 애플리케이션에서 개선하세요.

README, 개발 지침, 의존성, 상태를 읽고 쓰거나 잠금을 획득하거나 await로 다른 작업을 기다리는 코드를 읽으세요. 기존 언어와 런타임을 사용하세요. 각 값을 누가 갱신하는지, 각 판단이 어떤 값들의 집합을 읽는지 확인하세요.

1. 기밀 정보를 제외한 재현 가능한 입력을 저장하고 변경 전 기준값을 기록하세요. 경합이 있는 잠금에 대해 키별 도착, 획득 대기, 보유 시간, 업데이트 순서, 판단에 사용한 상태 버전을 기록하세요.
2. 독립적으로 갱신할 수 있는 값과 일관성을 함께 보호해야 하는 값을 구분하세요. 독립된 상태를 보호하는 잠금을 나누고 각 키의 적용 순서와 쓰기 책임을 명확히 하세요. 잠금이나 처리 담당 수가 무제한으로 늘지 않게 관리하세요.
3. 여러 시장에 걸친 판단과 공유 잔액·자금 예약을 보호하세요. 잔액 확인과 예약을 하나의 조정된 작업으로 확정하여 여러 주문이 같은 자금을 각각 사용할 수 있다고 가정하지 못하게 하세요. 여러 잠금이 필요하면 획득 순서를 정의하세요.
4. await 전후의 상태 변경과 병렬 디코딩의 완료 순서를 살펴보세요. 판단이 어떤 버전을 어떻게 읽는지 정의하세요. 디코딩 완료 순서가 필요한 적용 순서를 대신하지 않게 하세요. 잠금을 나눈 뒤에도 실행 자원 한계나 같은 키의 경합으로 대기가 발생하는지 확인하세요.
5. 같은 입력과 도착 순서로 독립된 키, 한 키에 집중되는 업데이트, 공유 자금의 예약 경합, 중지·재개되는 작업을 재현하세요. 잠금 대기, 수신부터 판단 완료까지의 p50/p95/p99, CPU와 메모리를 비교하세요. 필요한 업데이트 순서, 판단 시 상태의 일관성, 자금의 이중 예약이 없음을 검증하세요. 한 호스트 안의 경과 시간은 단조 시계로 측정하고 측정의 시작점과 끝점을 명시하세요.

기존 승인, 권한, 개발 절차를 유지하세요. 이 지시문만으로 운영 환경 변경, 유료 계약 체결, 실제 거래 실행에 대한 추가 권한이 생겼다고 해석하지 마세요. 비밀 키, 인증 정보, 고객 데이터를 출력하지 마세요.

변경 사항, 비교 조건, 변경 전후 측정값, 정확성 확인 결과, 남은 제약을 보고하세요. 측정할 수 없는 값은 미측정으로 표시하세요.
한 시장이나 키의 업데이트가 독립된 다른 업데이트까지 같은 공유 잠금에서 기다리게 하는 문제를 이 애플리케이션에서 개선하세요.
README, 개발 지침, 의존성, 상태를 읽고 쓰거나 잠금을 획득하거나 await로 다른 작업을 기다리는 코드를 읽으세요. 기존 언어와 런타임을 사용하세요. 각 값을 누가 갱신하는지, 각 판단이 어떤 값들의 집합을 읽는지 확인하세요.
1. 기밀 정보를 제외한 재현 가능한 입력을 저장하고 변경 전 기준값을 기록하세요. 경합이 있는 잠금에 대해 키별 도착, 획득 대기, 보유 시간, 업데이트 순서, 판단에 사용한 상태 버전을 기록하세요.
2. 독립적으로 갱신할 수 있는 값과 일관성을 함께 보호해야 하는 값을 구분하세요. 독립된 상태를 보호하는 잠금을 나누고 각 키의 적용 순서와 쓰기 책임을 명확히 하세요. 잠금이나 처리 담당 수가 무제한으로 늘지 않게 관리하세요.
3. 여러 시장에 걸친 판단과 공유 잔액·자금 예약을 보호하세요. 잔액 확인과 예약을 하나의 조정된 작업으로 확정하여 여러 주문이 같은 자금을 각각 사용할 수 있다고 가정하지 못하게 하세요. 여러 잠금이 필요하면 획득 순서를 정의하세요.
4. await 전후의 상태 변경과 병렬 디코딩의 완료 순서를 살펴보세요. 판단이 어떤 버전을 어떻게 읽는지 정의하세요. 디코딩 완료 순서가 필요한 적용 순서를 대신하지 않게 하세요. 잠금을 나눈 뒤에도 실행 자원 한계나 같은 키의 경합으로 대기가 발생하는지 확인하세요.
5. 같은 입력과 도착 순서로 독립된 키, 한 키에 집중되는 업데이트, 공유 자금의 예약 경합, 중지·재개되는 작업을 재현하세요. 잠금 대기, 수신부터 판단 완료까지의 p50/p95/p99, CPU와 메모리를 비교하세요. 필요한 업데이트 순서, 판단 시 상태의 일관성, 자금의 이중 예약이 없음을 검증하세요. 한 호스트 안의 경과 시간은 단조 시계로 측정하고 측정의 시작점과 끝점을 명시하세요.
기존 승인, 권한, 개발 절차를 유지하세요. 이 지시문만으로 운영 환경 변경, 유료 계약 체결, 실제 거래 실행에 대한 추가 권한이 생겼다고 해석하지 마세요. 비밀 키, 인증 정보, 고객 데이터를 출력하지 마세요.
변경 사항, 비교 조건, 변경 전후 측정값, 정확성 확인 결과, 남은 제약을 보고하세요. 측정할 수 없는 값은 미측정으로 표시하세요.4. 변하지 않는 부분을 미리 준비해 도착 후 작업을 줄인다
가격이 갱신될 때마다 같은 고정 ID를 파싱하고, 같은 입력으로 고정 주소를 계산하며, 작업 메모리를 할당한다고 가정해 보겠습니다. 작업 메모리는 버퍼라고도 합니다. 이 세 가지 준비를 반복하면 변하지 않는 정보를 준비하는 시간이 매 판단의 경로에 들어갑니다.
입력이 바뀌지 않는 준비 작업은 데이터가 도착하기 전에 끝내고 재사용할 수 있습니다. 도착 후에는 해당 이벤트에서 바뀐 정보를 확인하고, 보낼 최종 메시지를 구성한 뒤 그 내용에 서명합니다.
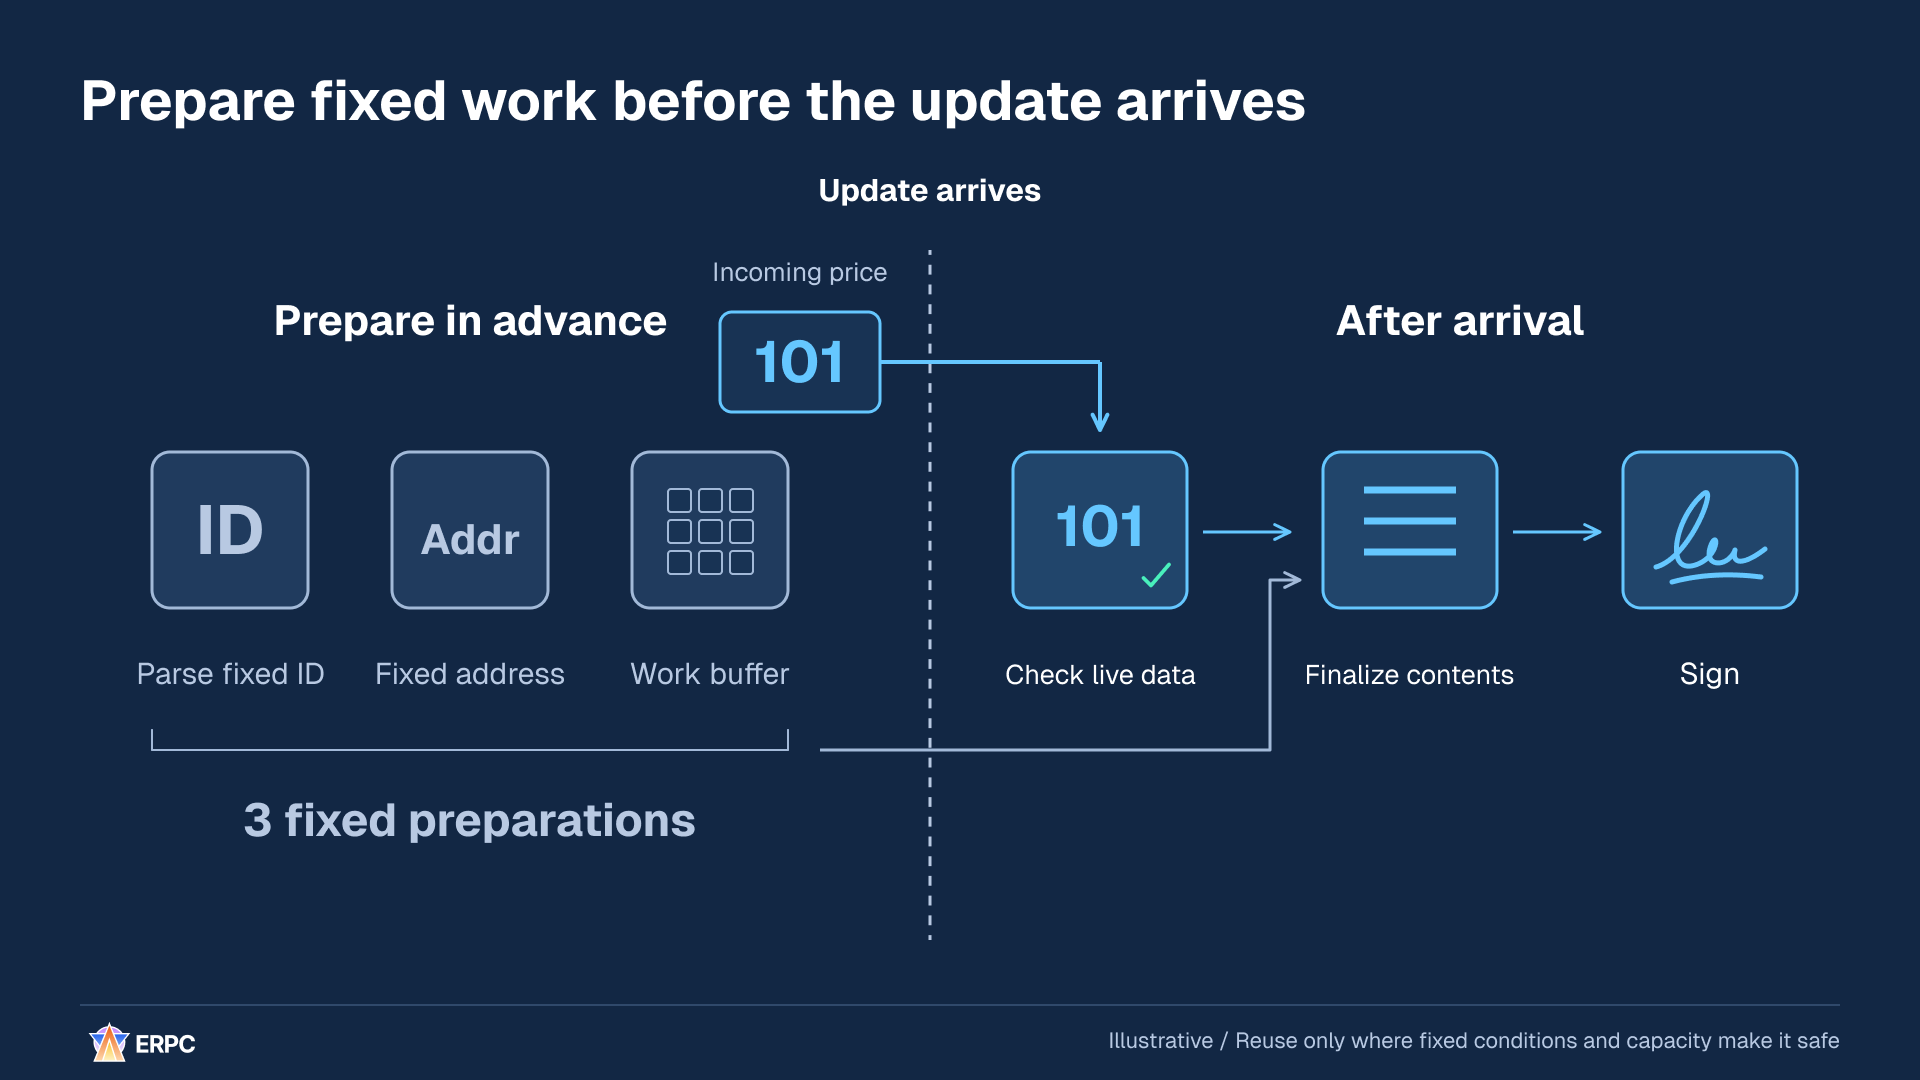
변하지 않는 준비는 앞당기되, 현재 내용의 검증과 서명은 도착 후에 수행합니다.
업데이트 세 개에서 무엇이 달라지는지 세어 보겠습니다. 이벤트마다 세 종류를 준비하면 준비 작업은 아홉 번입니다. 세 종류를 한 번 준비하고 순차적으로 재사용하면 세 번입니다. 두 설계 모두 이벤트 세 개를 받고 하나씩 처리해 출력 세 개를 만듭니다.
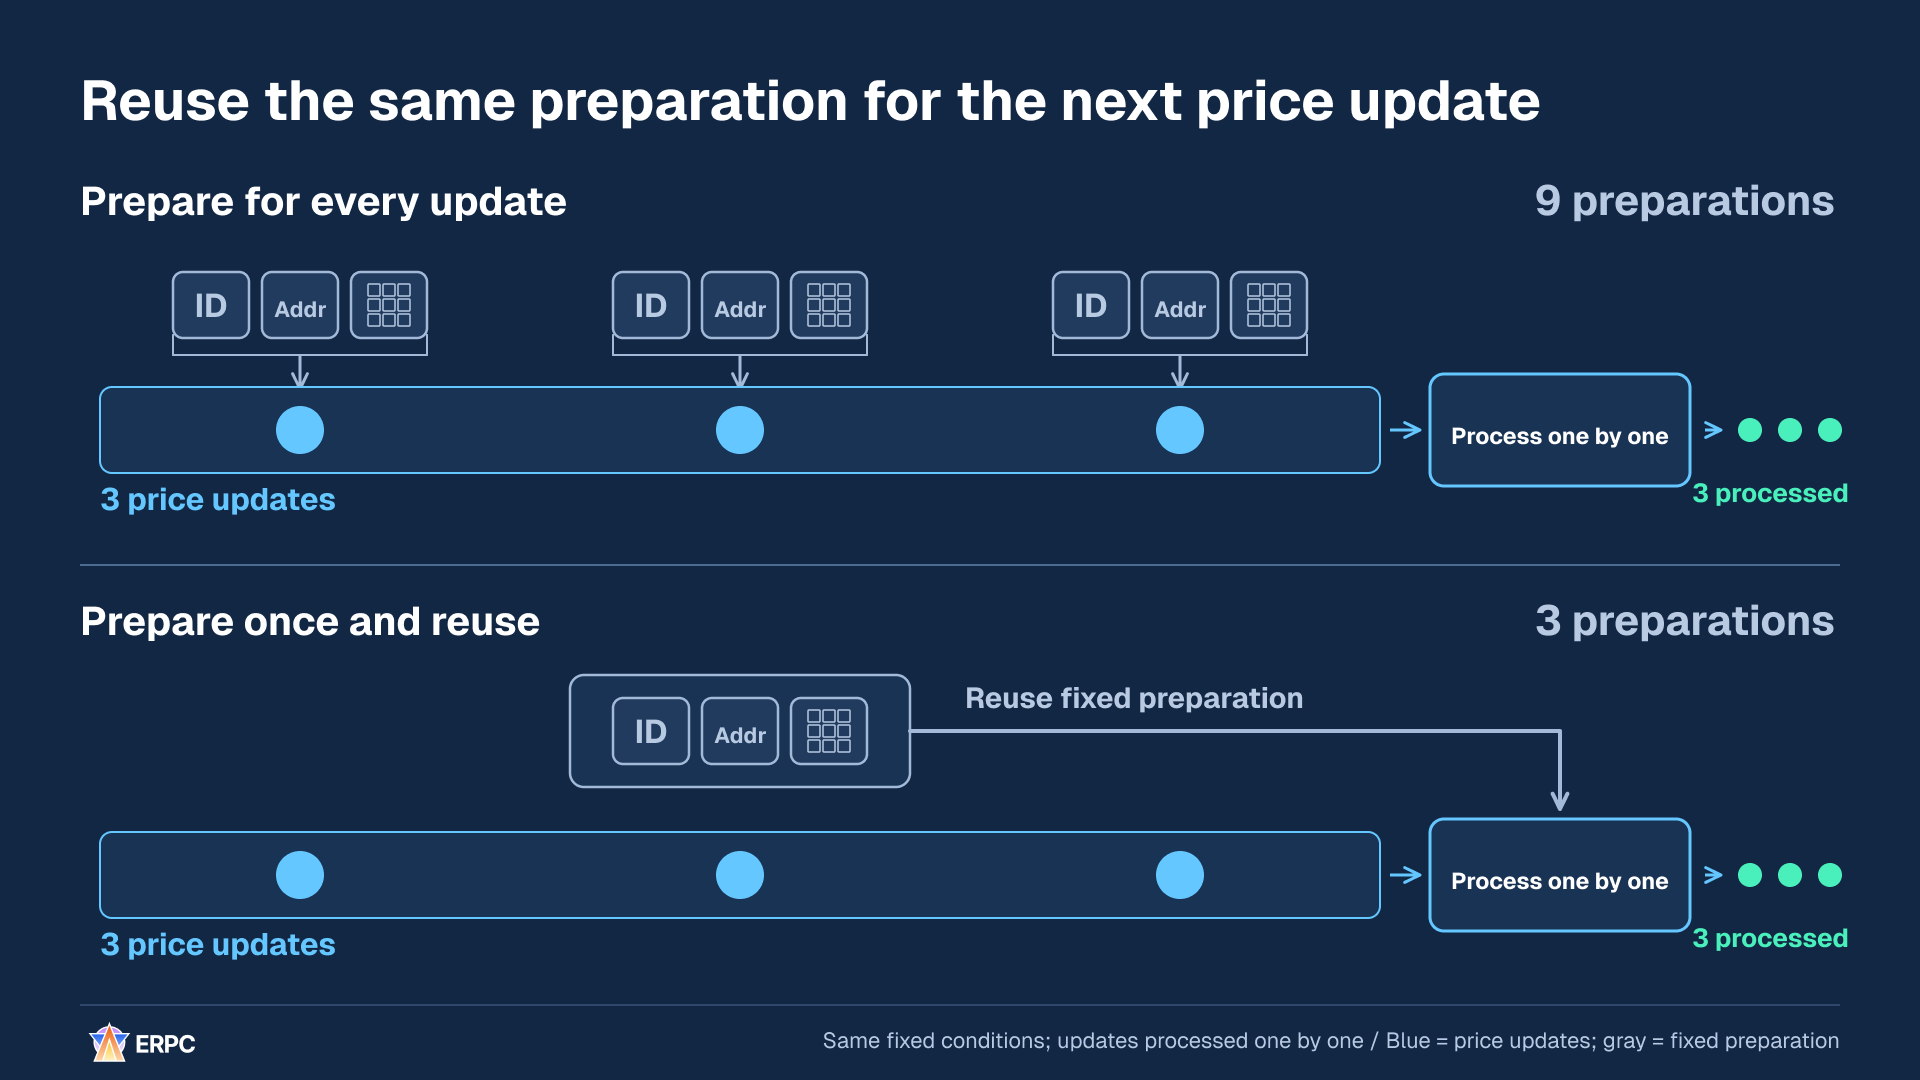
이 예에서 이벤트 수는 세 개로 유지되지만 고정 준비는 아홉 번에서 세 번으로 줄어듭니다.
이 비교는 고정 조건이 바뀌지 않고 작업 메모리를 순서대로 안전하게 재사용할 수 있다고 가정합니다. 버퍼의 내용은 매번 현재 이벤트에 맞춰 갱신해야 합니다. 여러 작업이 동시에 진행된다면 작업마다 별도 영역을 쓰거나 접근을 관리하는 풀을 사용해 같은 메모리를 덮어쓰지 않도록 해야 합니다.
같은 예를 이벤트 1,000개로 늘려 보겠습니다. 이벤트마다 세 종류를 준비하면 준비 작업은 3,000번이고, 공통 준비를 한 번만 하면 세 번입니다. 두 설계 모두 이벤트 1,000개를 받고, 하나씩 처리해 출력 1,000개를 만듭니다. 준비 횟수와 처리하는 이벤트 수를 구분하세요.
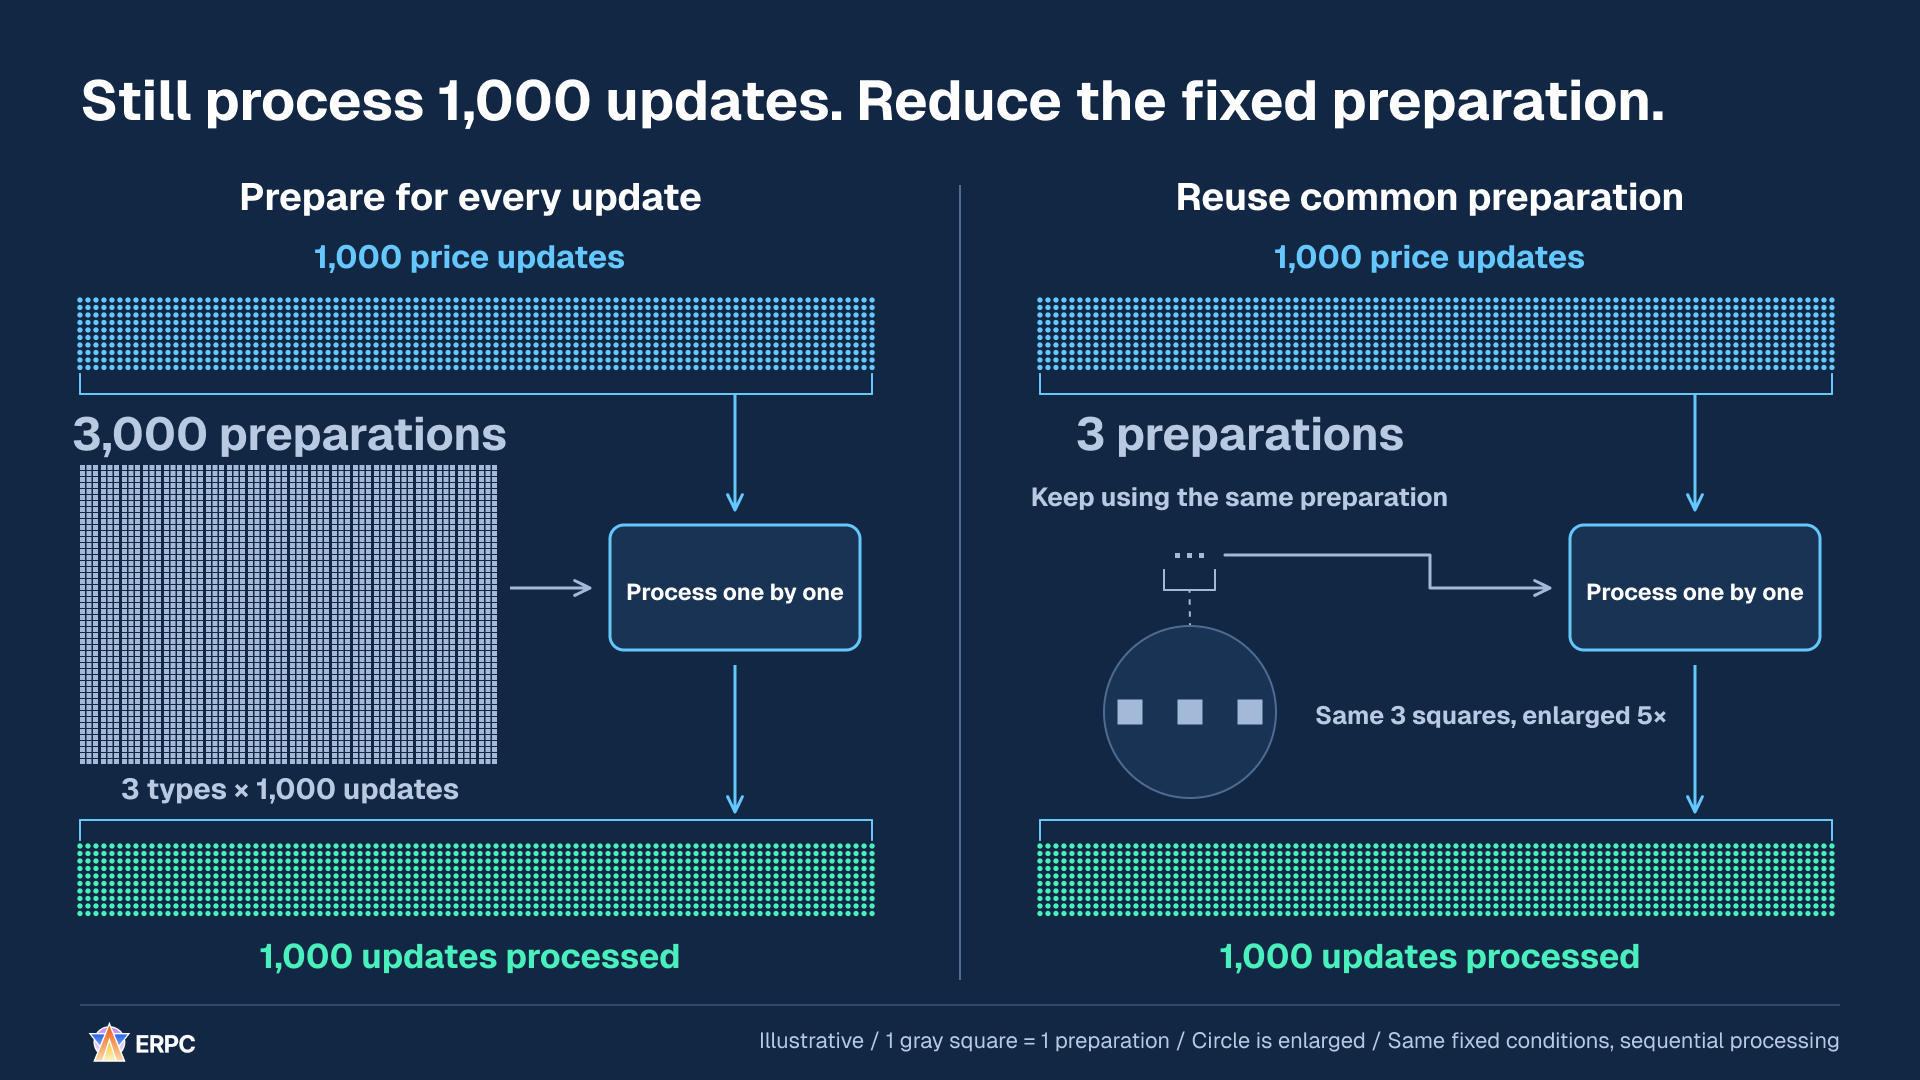
줄어드는 것은 반복되는 고정 준비입니다. 검증, 판단, 서명 등의 작업은 남아 있으므로 이 횟수의 비율이 애플리케이션 전체의 속도 향상 비율은 아닙니다.
재사용이 유효한 조건을 정의하세요. 고정 주소 계산의 입력이 바뀌면 주소를 다시 계산해야 합니다. 가격, 수량, 잔액, 참조하는 계정 상태, 위험 한도, blockhash는 판단이 사용하는 시점에 유효해야 합니다. 지속적으로 갱신되는 로컬 상태를 관리한다면 버전, 최신성, 유효성을 확인하세요. 매 판단마다 RPC로 모든 것을 다시 가져와야 한다는 뜻은 아닙니다.
Solana의 getLatestBlockhash는 blockhash와 lastValidBlockHeight를 반환합니다. 만료를 확인할 때 블록 높이와 slot을 구분하세요.[7] 메시지는 서명하기 전에 확정해야 합니다. 서명 후 메시지를 변경했다면 변경된 내용에 맞춰 서명을 다시 생성해야 합니다.[19]
변하지 않는 준비를 앞당겨 재사용하려면 다음 지시문을 복사하세요.
text
각 입력마다 같은 파싱, 주소 계산, 메모리 할당을 반복하는 작업을 살펴보고 재사용할 수 있는 준비를 수신 이전으로 옮기세요.

README, 개발 지침, 의존성, 수신 → 준비 → 판단 → 메시지 구성 → 서명 코드를 읽으세요. 기존 언어, 런타임, SDK를 사용하세요. 각 준비의 입력, 출력, 소유자, 유효 기간을 확인하세요.

1. 기밀 정보를 제외한 재현 가능한 입력을 저장하세요. 이벤트와 출력의 수, 각 준비의 실행 횟수와 시간, 할당된 메모리, 수신부터 판단 완료까지의 시간을 기록하세요.
2. 입력이 변하지 않는 준비를 찾아 초기화나 적절한 이전 단계에서 실행하고 결과를 재사용하세요. 재사용 키, 입력이나 설정이 바뀔 때의 무효화와 재계산, 캐시와 버퍼 풀의 한도를 구현하세요.
3. 재사용하는 작업 메모리는 현재 입력에 맞게 갱신하세요. 동시 작업에는 별도 영역이나 관리되는 대여 방식을 사용하여 사용 중인 영역을 덮어쓰거나 반환하지 못하게 하세요.
4. 판단 요건에 따라 가격, 수량, 잔액, 계정 상태, 위험 조건, blockhash를 검증하세요. 계속 갱신되는 로컬 상태를 쓰면 버전과 최신성을 확인하세요. Solana에서 lastValidBlockHeight로 blockhash 만료를 확인할 때 블록 높이와 slot을 구분하세요. 메시지를 확정한 뒤 서명하고, 서명 후 내용이 바뀌면 갱신된 메시지에 다시 서명하세요.
5. 같은 입력으로 준비 횟수와 시간, 수신부터 판단 완료까지의 p50/p95/p99, CPU와 메모리, 출력을 비교하세요. 입력·설정 변경, 만료, 동시 실행도 재현하여 오래된 결과의 재사용과 메모리 충돌을 확인하세요. 준비 횟수의 비율을 전체 속도 향상으로 취급하지 마세요. 한 호스트 안의 경과 시간은 단조 시계로 측정하고 측정의 시작점과 끝점을 명시하세요.

기존 승인, 권한, 개발 절차를 유지하세요. 이 지시문만으로 운영 환경 변경, 유료 계약 체결, 실제 거래 실행에 대한 추가 권한이 생겼다고 해석하지 마세요. 비밀 키, 인증 정보, 고객 데이터를 출력하지 마세요.

변경 사항, 비교 조건, 변경 전후 측정값, 정확성 확인 결과, 남은 제약을 보고하세요. 측정할 수 없는 값은 미측정으로 표시하세요.
각 입력마다 같은 파싱, 주소 계산, 메모리 할당을 반복하는 작업을 살펴보고 재사용할 수 있는 준비를 수신 이전으로 옮기세요.
README, 개발 지침, 의존성, 수신 → 준비 → 판단 → 메시지 구성 → 서명 코드를 읽으세요. 기존 언어, 런타임, SDK를 사용하세요. 각 준비의 입력, 출력, 소유자, 유효 기간을 확인하세요.
1. 기밀 정보를 제외한 재현 가능한 입력을 저장하세요. 이벤트와 출력의 수, 각 준비의 실행 횟수와 시간, 할당된 메모리, 수신부터 판단 완료까지의 시간을 기록하세요.
2. 입력이 변하지 않는 준비를 찾아 초기화나 적절한 이전 단계에서 실행하고 결과를 재사용하세요. 재사용 키, 입력이나 설정이 바뀔 때의 무효화와 재계산, 캐시와 버퍼 풀의 한도를 구현하세요.
3. 재사용하는 작업 메모리는 현재 입력에 맞게 갱신하세요. 동시 작업에는 별도 영역이나 관리되는 대여 방식을 사용하여 사용 중인 영역을 덮어쓰거나 반환하지 못하게 하세요.
4. 판단 요건에 따라 가격, 수량, 잔액, 계정 상태, 위험 조건, blockhash를 검증하세요. 계속 갱신되는 로컬 상태를 쓰면 버전과 최신성을 확인하세요. Solana에서 lastValidBlockHeight로 blockhash 만료를 확인할 때 블록 높이와 slot을 구분하세요. 메시지를 확정한 뒤 서명하고, 서명 후 내용이 바뀌면 갱신된 메시지에 다시 서명하세요.
5. 같은 입력으로 준비 횟수와 시간, 수신부터 판단 완료까지의 p50/p95/p99, CPU와 메모리, 출력을 비교하세요. 입력·설정 변경, 만료, 동시 실행도 재현하여 오래된 결과의 재사용과 메모리 충돌을 확인하세요. 준비 횟수의 비율을 전체 속도 향상으로 취급하지 마세요. 한 호스트 안의 경과 시간은 단조 시계로 측정하고 측정의 시작점과 끝점을 명시하세요.
기존 승인, 권한, 개발 절차를 유지하세요. 이 지시문만으로 운영 환경 변경, 유료 계약 체결, 실제 거래 실행에 대한 추가 권한이 생겼다고 해석하지 마세요. 비밀 키, 인증 정보, 고객 데이터를 출력하지 마세요.
변경 사항, 비교 조건, 변경 전후 측정값, 정확성 확인 결과, 남은 제약을 보고하세요. 측정할 수 없는 값은 미측정으로 표시하세요.5. 필요한 업데이트를 놓친 상태에서 판단을 계속하지 않는다
같은 자산을 다루는 두 시장의 가격 차이 B−A를 계산하는 애플리케이션을 생각해 보겠습니다. 연결이 끊긴 동안 시장 A가 100에서 105로 바뀌었는데 그 업데이트를 놓쳤습니다. 재연결 후 B의 가격 104만 받았다면 104−100을 계산해 +4를 얻습니다. 갱신된 A의 값을 사용하면 104−105, 즉 -1입니다. 부호까지 바뀝니다.
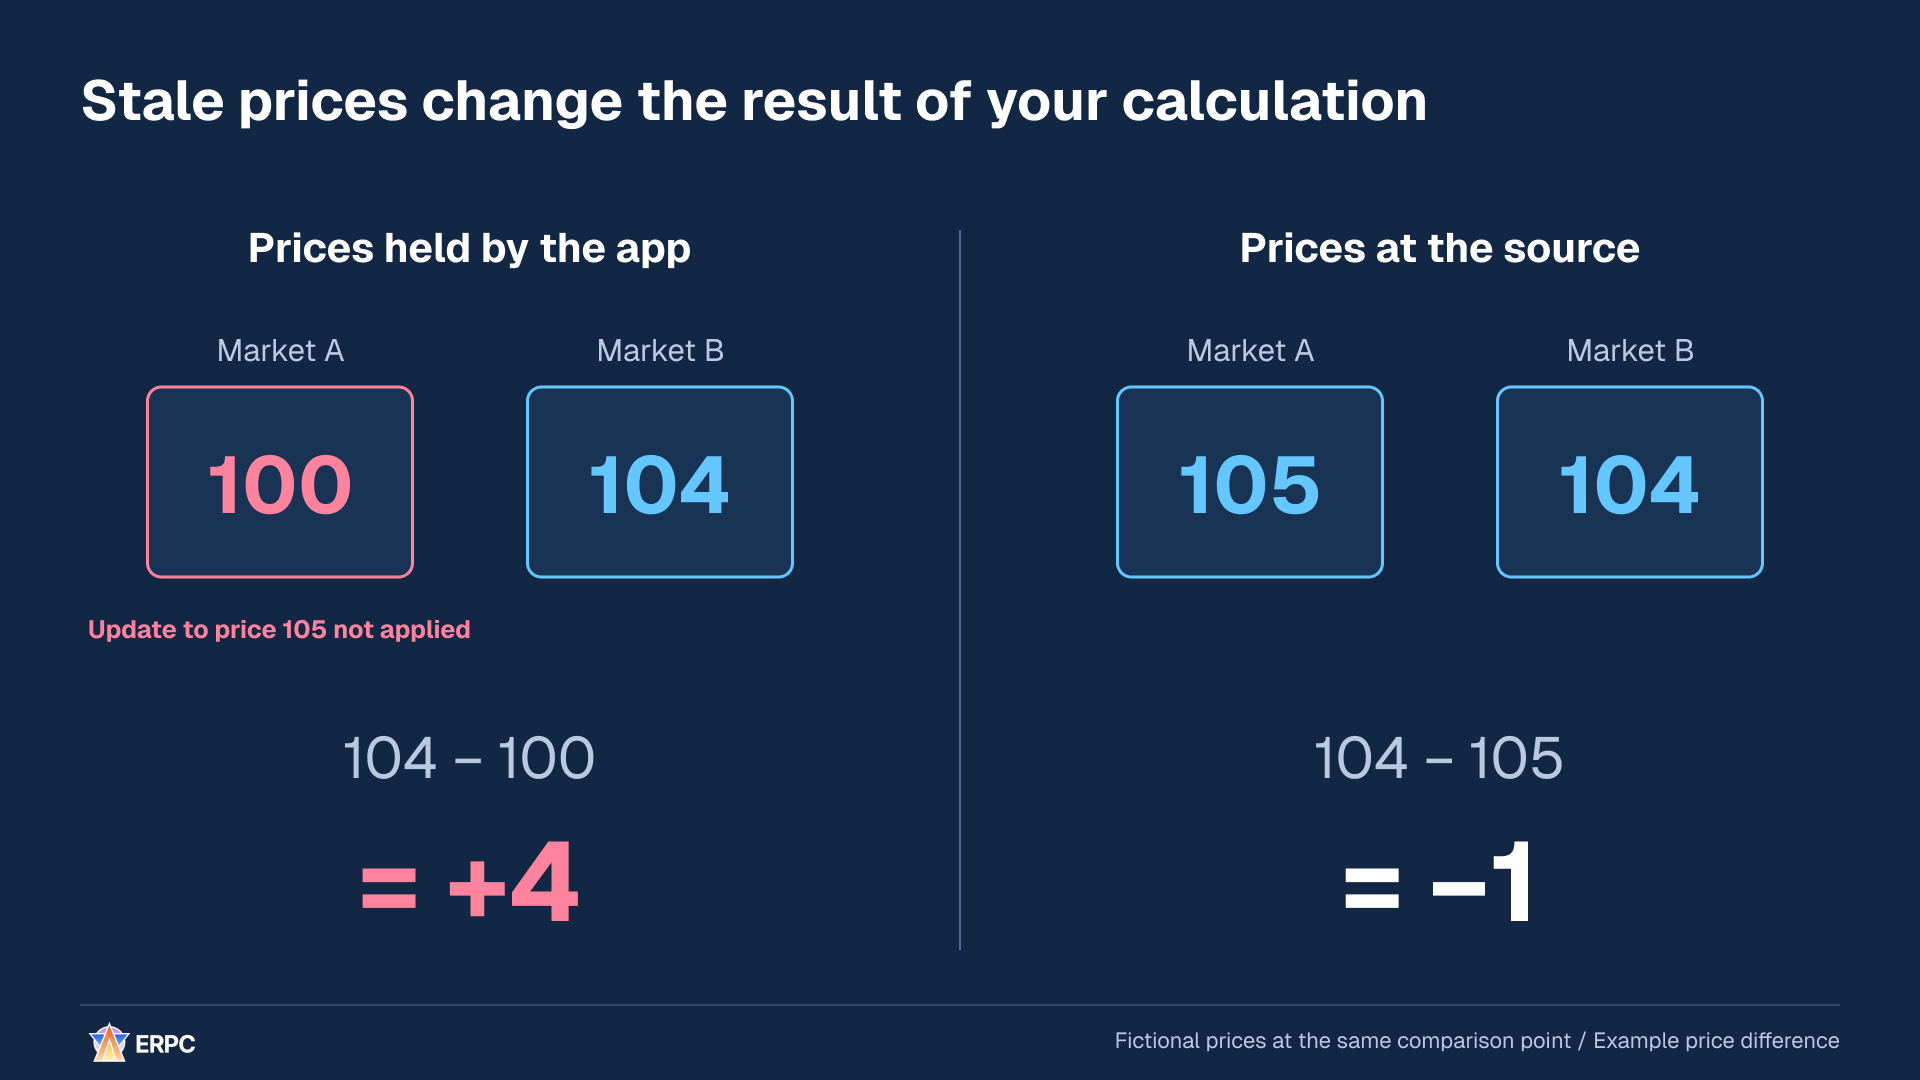
같은 계산도 A의 옛 값 100을 쓰는지 갱신된 105를 쓰는지에 따라 달라집니다.
이 모델은 가격 차이만 보여 줍니다. 수수료, 체결 조건 등의 요소를 제외했으며 거래 이익을 나타내지 않습니다. 연결이 복구되어도 판단에 필요한 모든 업데이트가 복구된 것은 아닐 수 있다는 점이 핵심입니다.
이 예에서는 A와 B의 가격을 사용하는 신규 거래 판단을 중지한 뒤, A의 옛 값 100을 복구한 105로 바꿉니다. 그다음 판단에 필요한 업데이트가 A와 B에 적용되었고 필요한 순서와 최신성 조건을 만족하는지 확인합니다. 필요한 검사가 끝나면 재개하고, 끝낼 수 없다면 중지 상태를 유지합니다.
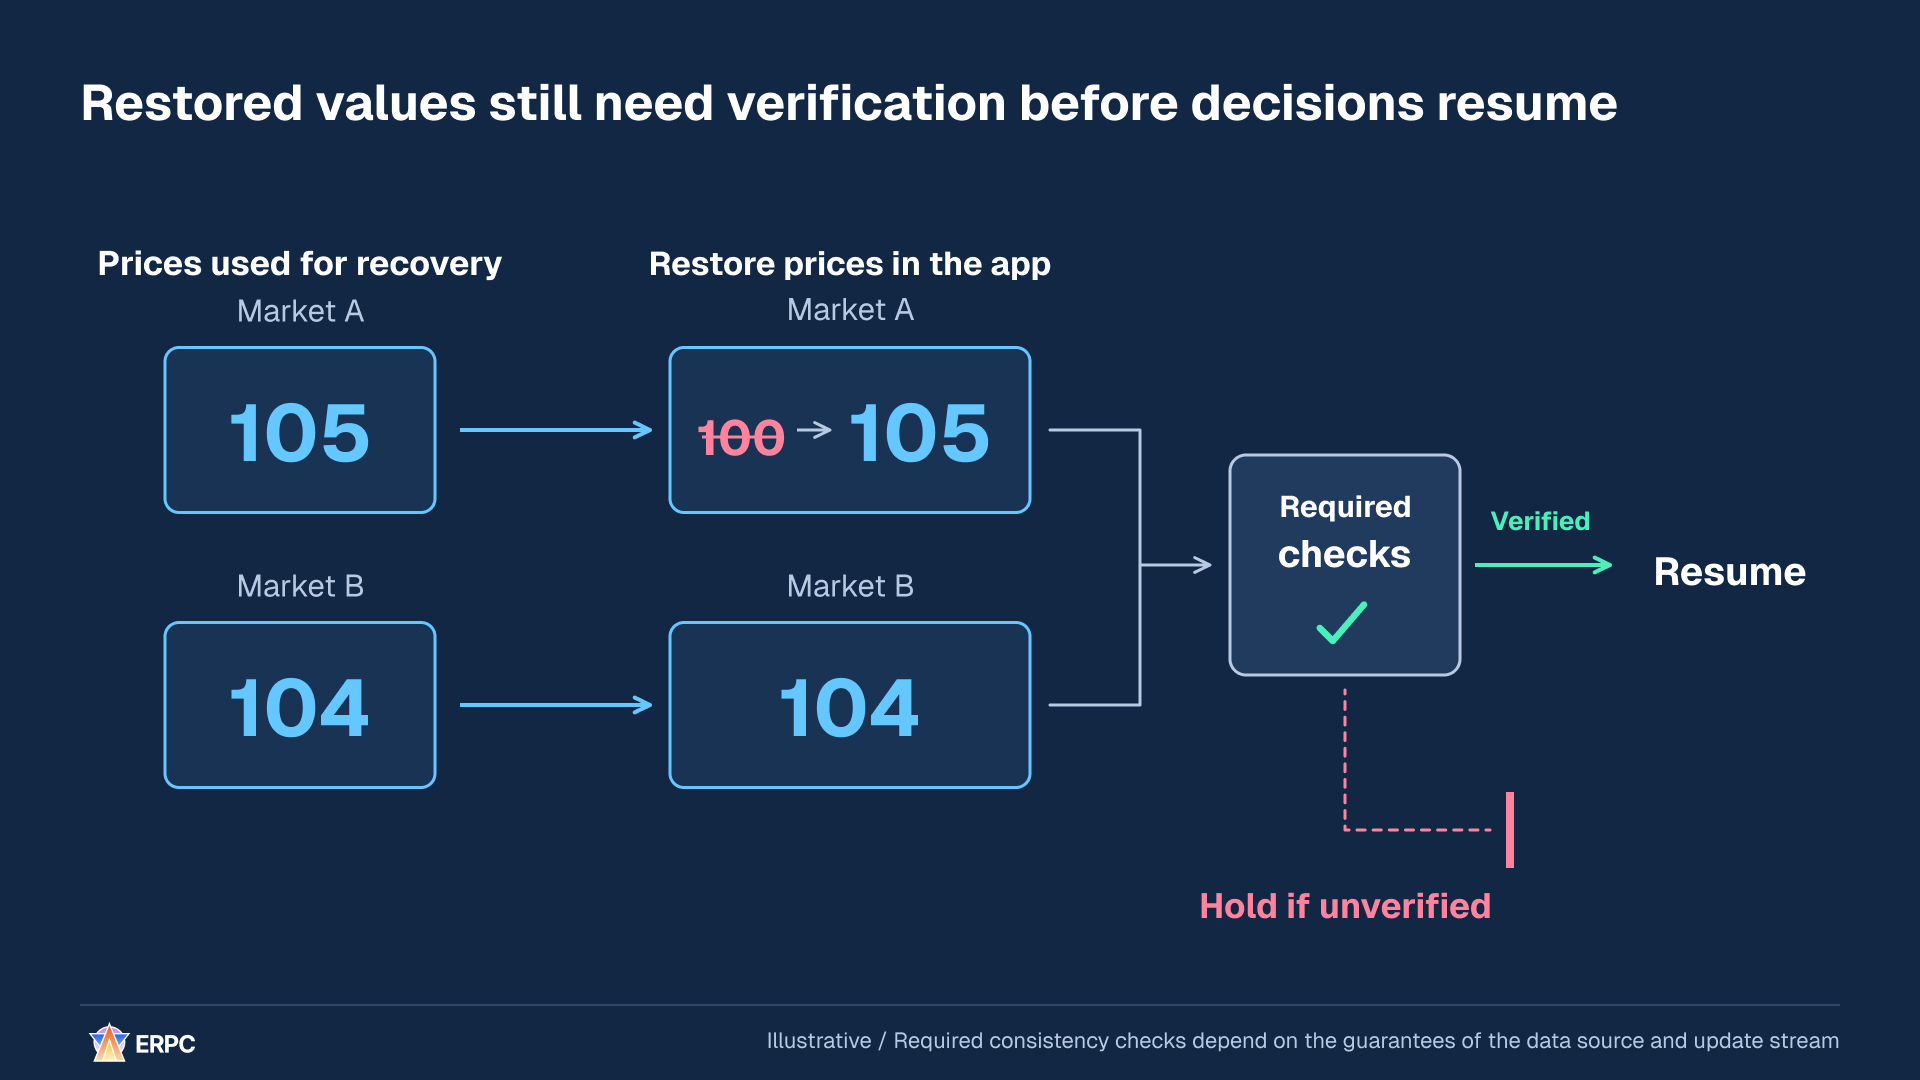
값을 갱신하는 단계와 그 값을 판단에 사용해도 되는지 확인하는 단계를 구분하세요.
흔히 쓰는 복구 방법은 특정 시점의 상태를 모은 스냅샷입니다. 이를 연속 업데이트 스트림과 연결할 때는 스냅샷에 이미 포함된 업데이트와 그 이후 적용할 업데이트를 구분해야 합니다. 그래야 포함된 델타를 두 번 적용하거나 경계에서 업데이트를 빠뜨리지 않습니다. 구체적인 방법은 선택한 API가 구독 시작, 식별, 재조회, 재생에 대해 제공하는 보장을 따라야 합니다.
Yellowstone 메시지에는 slot, write_version 같은 필드가 포함됩니다.[16] 이 필드가 있다는 사실만으로 제공자 간에 사용할 수 있는 순서나 완전한 누락 탐지를 보장한다고 생각해서는 안 됩니다. slot 차이를 곧바로 누락된 업데이트 수나 지연 시간(초)으로 바꾸지 마세요. 선택한 제공자의 보장에 따라 상태가 올바르게 이어졌는지 검증하세요.
복구 전에 시작한 계산도 고려해야 합니다. 옛 상태로 시작한 작업이 복구 후 끝나면 그 결과가 새 상태를 덮어쓸 수 있습니다. 한 가지 방법은 복구를 전후해 상태에 세대 번호를 부여하고 이전 세대의 결과를 거부하는 것입니다. processed 상태를 사용한다면 해당 상태가 더 이상 채택되지 않는 롤백도 상태 재검토 조건에 포함하세요.[6]
재연결 후 판단을 재개하기 전에 유효한 상태를 복구하려면 다음 지시문을 복사하세요.
text
연결이 돌아왔다는 이유만으로 이 애플리케이션이 오래된 상태에 근거한 거래 판단을 재개하지 않게 하세요. 판단을 재개하기 전에 필요한 상태를 복구하도록 구현하세요.

README, 개발 지침, 의존성, 구독·초기 조회·업데이트 적용·재연결·판단 코드를 읽으세요. 기존 언어, 런타임, SDK를 사용하세요. 제공자, commitment, 업데이트의 의미, 순서·식별·재조회·재생에 관한 실제 보장을 확인하세요.

1. 연결 상태, 데이터의 유효성, 판단 재개 허용 여부를 구분하세요. 필요한 업데이트의 누락이나 최신성 부족이 확인되면 그 상태에 의존하는 새로운 거래 판단을 중지하되, 필요한 수신·업데이트·복구는 계속하세요.
2. 스냅샷을 사용하면 제공자의 보장을 바탕으로 어떤 업데이트가 포함되는지, 이후 스트림과의 경계가 어디인지 확인하세요. 변경분의 이중 적용, 경계에서의 누락, 잘못된 적용 순서를 방지하세요. 보장되지 않는 부분을 가정으로 메우지 마세요. slot이나 write_version을 누락된 업데이트를 언제나 탐지할 수 있는 순번으로 취급하지 마세요.
3. 값을 가져왔다는 이유만으로 재개하지 마세요. 영향을 받는 판단에 필요한 업데이트, 순서, 최신성, 일관성 검사를 구현하고 검사를 완료할 수 없으면 판단을 중지한 상태로 유지하세요. 복구 전에 시작한 작업이 나중에 끝나더라도 오래된 계산이나 주문 제안이 적용·전송되지 않도록 세대 번호 또는 동등한 장치를 사용하세요. 재개할 때는 검증된 상태에서 새로운 판단을 내리세요. processed 상태를 사용하면 롤백 후 무효화와 복구를 처리하세요.
4. 기밀 정보를 제외한 재현 가능한 입력으로 단절 중 놓친 업데이트, 중복, 순서 변경, 오래된 데이터, 반복 재연결, 이전 세대 작업의 완료를 재현하세요. 연결 복구부터 검증 완료까지 판단이 중지되는지, 검증된 상태가 예상 결과와 일치하는지 확인하세요.
5. 복구 시간, 유효하지 않은 상태 때문에 억제된 판단 시도 수와 중지 기간, 재적용되거나 제외된 업데이트, 평상시 수신부터 판단 완료까지의 시간, CPU와 메모리를 기록하세요. 중지 기간이나 누락된 업데이트를 측정에서 알리지 않고 제외하지 마세요. 측정 경계와 탐지 가능한 것·불가능한 것을 명시하세요. 한 호스트 안의 경과 시간은 단조 시계로 측정하세요.

기존 승인, 권한, 개발 절차를 유지하세요. 이 지시문만으로 운영 환경 변경, 유료 계약 체결, 실제 거래 실행에 대한 추가 권한이 생겼다고 해석하지 마세요. 비밀 키, 인증 정보, 고객 데이터를 출력하지 마세요.

변경 사항, 비교 조건, 변경 전후 측정값, 정확성 확인 결과, 남은 제약을 보고하세요. 측정할 수 없는 값은 미측정으로 표시하세요.
연결이 돌아왔다는 이유만으로 이 애플리케이션이 오래된 상태에 근거한 거래 판단을 재개하지 않게 하세요. 판단을 재개하기 전에 필요한 상태를 복구하도록 구현하세요.
README, 개발 지침, 의존성, 구독·초기 조회·업데이트 적용·재연결·판단 코드를 읽으세요. 기존 언어, 런타임, SDK를 사용하세요. 제공자, commitment, 업데이트의 의미, 순서·식별·재조회·재생에 관한 실제 보장을 확인하세요.
1. 연결 상태, 데이터의 유효성, 판단 재개 허용 여부를 구분하세요. 필요한 업데이트의 누락이나 최신성 부족이 확인되면 그 상태에 의존하는 새로운 거래 판단을 중지하되, 필요한 수신·업데이트·복구는 계속하세요.
2. 스냅샷을 사용하면 제공자의 보장을 바탕으로 어떤 업데이트가 포함되는지, 이후 스트림과의 경계가 어디인지 확인하세요. 변경분의 이중 적용, 경계에서의 누락, 잘못된 적용 순서를 방지하세요. 보장되지 않는 부분을 가정으로 메우지 마세요. slot이나 write_version을 누락된 업데이트를 언제나 탐지할 수 있는 순번으로 취급하지 마세요.
3. 값을 가져왔다는 이유만으로 재개하지 마세요. 영향을 받는 판단에 필요한 업데이트, 순서, 최신성, 일관성 검사를 구현하고 검사를 완료할 수 없으면 판단을 중지한 상태로 유지하세요. 복구 전에 시작한 작업이 나중에 끝나더라도 오래된 계산이나 주문 제안이 적용·전송되지 않도록 세대 번호 또는 동등한 장치를 사용하세요. 재개할 때는 검증된 상태에서 새로운 판단을 내리세요. processed 상태를 사용하면 롤백 후 무효화와 복구를 처리하세요.
4. 기밀 정보를 제외한 재현 가능한 입력으로 단절 중 놓친 업데이트, 중복, 순서 변경, 오래된 데이터, 반복 재연결, 이전 세대 작업의 완료를 재현하세요. 연결 복구부터 검증 완료까지 판단이 중지되는지, 검증된 상태가 예상 결과와 일치하는지 확인하세요.
5. 복구 시간, 유효하지 않은 상태 때문에 억제된 판단 시도 수와 중지 기간, 재적용되거나 제외된 업데이트, 평상시 수신부터 판단 완료까지의 시간, CPU와 메모리를 기록하세요. 중지 기간이나 누락된 업데이트를 측정에서 알리지 않고 제외하지 마세요. 측정 경계와 탐지 가능한 것·불가능한 것을 명시하세요. 한 호스트 안의 경과 시간은 단조 시계로 측정하세요.
기존 승인, 권한, 개발 절차를 유지하세요. 이 지시문만으로 운영 환경 변경, 유료 계약 체결, 실제 거래 실행에 대한 추가 권한이 생겼다고 해석하지 마세요. 비밀 키, 인증 정보, 고객 데이터를 출력하지 마세요.
변경 사항, 비교 조건, 변경 전후 측정값, 정확성 확인 결과, 남은 제약을 보고하세요. 측정할 수 없는 값은 미측정으로 표시하세요.언어의 강점을 여섯 가지 축으로 비교한다
이 다섯 가지 설계를 구현하려면 누가 데이터를 갱신하는지, 어디서 메모리를 할당하는지, 무엇을 복사하는지, 어떤 작업이 기다리는지 결정해야 합니다. 계산이 빠른 것, 갑작스러운 지연을 제어하기 쉬운 것, 시제품을 빨리 만드는 것은 서로 다른 강점입니다. 개선하려는 부분에 맞춰 언어를 비교합니다.
공개 벤치마크로 실행 시간 비교하기
2025년 8월 1일의 공개 측정값으로, 다섯 천체의 계산을 50만 단계 실행한 결과입니다. 평균 실행 시간은 프로그램 시작부터 처리가 끝날 때까지 걸린 시간의 평균입니다. 시작 처리와 실행 중 코드 최적화를 포함하며, 사전 빌드 시간은 포함하지 않습니다. 1,000ms는 1초입니다.[27][29]
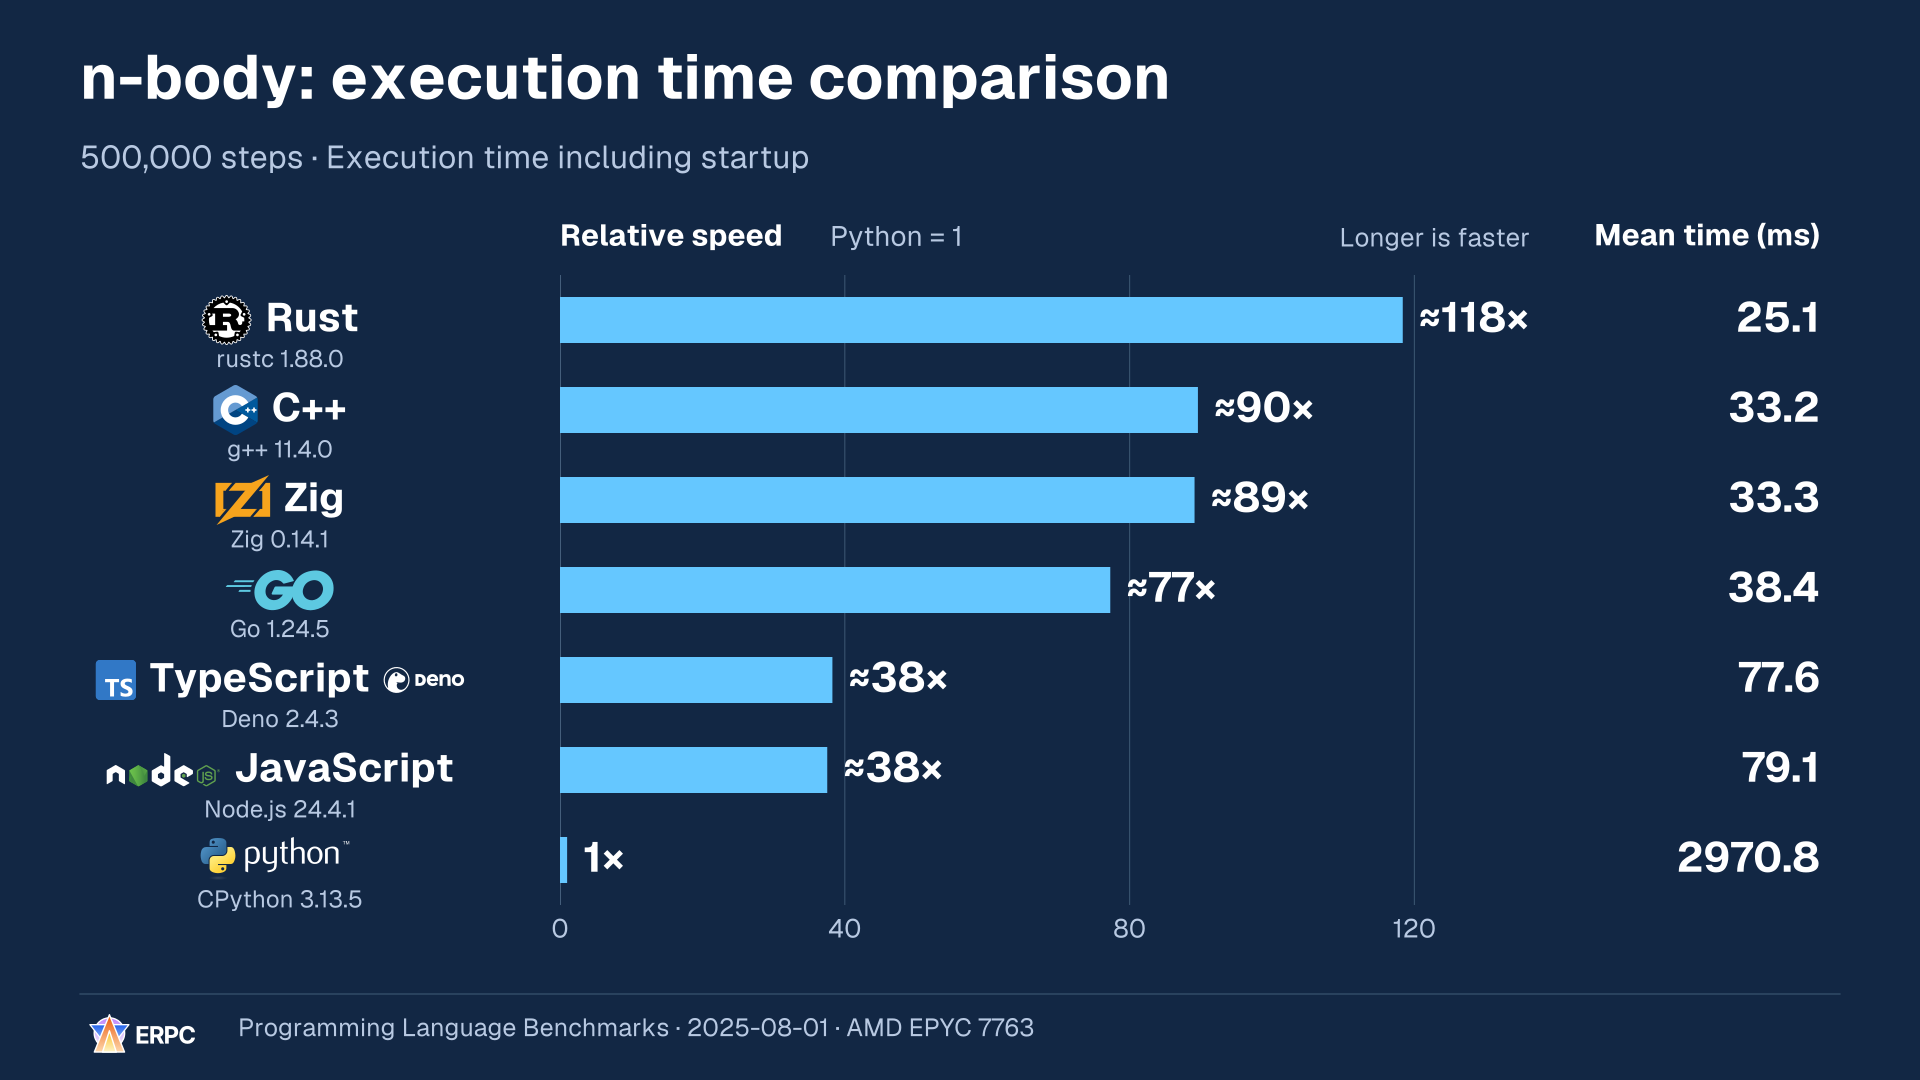
| 언어 / 실행 환경 | 평균 실행 시간 | 상대 속도 (Python = 1) |
|---|---|---|
| Rust / rustc 1.88.0 | 25.1ms | 약 118 |
| C++ / g++ 11.4.0 | 33.2ms | 약 90 |
| Zig / Zig 0.14.1 | 33.3ms | 약 89 |
| Go / Go 1.24.5 | 38.4ms | 약 77 |
| TypeScript / Deno 2.4.3 | 77.6ms | 약 38 |
| JavaScript / Node.js 24.4.1 | 79.1ms | 약 38 |
| Python / CPython 3.13.5 | 2970.8ms | 1 |
상대 속도는 반올림 전 평균 실행 시간을 사용해 Python을 1로 두고 계산했습니다. 언어·실행 환경별 안정 버전 중 수치 계산이 단일 스레드에서 실행되고 명시적 SIMD 명령, 벡터 타입, 외부 수치 계산 라이브러리를 사용하지 않는 구현의 가장 작은 공개 평균값을 선택했습니다. 코드와 최적화는 서로 다르며 Zig는 ReleaseFast를 사용합니다. TypeScript는 Deno/V8을 포함한 실행 파일, JavaScript는 Node.js에서의 결과입니다.[28]
가까운 값은 비슷한 결과로 읽고, 이 과제 하나로 언어 전체의 순위를 정하지 마세요. 시작 후 계속 실행되는 봇의 처리 시간이나 주문이 목적지에 도착할 때까지의 지연을 직접 측정한 것은 아닙니다.
기록된 환경은 AMD EPYC 7763, 사용 가능한 코어 4개의 Linux입니다. 공개 측정 코드는 조건마다 세 번 반복하도록 설정되어 있으며 매번 새 프로세스를 시작합니다. 당시 실행의 정확한 커밋과 각 측정의 원시 데이터는 검증하지 못했으므로 공개된 평균값으로 소개합니다.[28][29]
여섯 축으로 설계상의 강점 비교하기
다음 그림은 오프체인 Solana 클라이언트를 위한 3단계의 편집상 선택 지침입니다. 계산 속도 축은 비교하는 언어와 구현에서 직접 작성한 대량의 데이터 읽기와 계산을 빠르게 할 수 있는 선택지를 살펴봅니다. 네트워크 대기가 대부분인 애플리케이션 전체나 고속 외부 라이브러리에 맡긴 계산의 순위를 나타내지는 않습니다.
Rust, Go, C++, Zig는 최적화된 네이티브 실행의 유력한 후보입니다. 속도가 같다는 뜻은 아니며, 더 세밀한 순서는 실제 작업 부하를 측정해야 알 수 있습니다. V8도 자주 실행되는 함수를 기계어로 바꿉니다. JavaScript가 인터프리터 방식이기 때문에 느리다고만 설명하는 것은 부정확합니다.[20][21]
계산 속도, 지연 제어, 메모리 제어의 세 축은 계산과 제어에 관한 강점을 나타냅니다. 안전성 지원, 시제품 구현의 용이성, Solana SDK는 개발을 돕는 강점을 나타냅니다. 여섯 축이 모두 처리 속도를 뜻하는 것은 아닙니다.
모든 육각형은 같은 축과 척도를 사용합니다. 바깥쪽일수록 해당 축의 정성적 강점이 크다는 뜻입니다. 실측 속도나 비율이 아니므로 3단계가 1단계의 세 배라는 의미도 아닙니다. 다각형의 면적을 종합 점수로 보지 말고, 개선하려는 축을 하나씩 비교합니다.
| 축 | 비교하는 내용 |
|---|---|
| 계산 속도 | 비교하는 구현에서 직접 작성한 대량의 데이터 읽기와 계산을 빠르게 할 수 있는 선택지 |
| 지연 제어 | 메모리 할당·회수나 실행 중 코드 최적화처럼 갑작스러운 지연을 일으킬 수 있는 작업을 중요한 처리에서 얼마나 직접 분리할 수 있는지 |
| 메모리 제어 | 데이터 배치, 소유권과 수명, 할당·재사용·회수를 얼마나 직접 설계할 수 있는지 |
| 안전성 지원 | 메모리 수명이나 공유 메모리 오류를 방지하는 언어 기능, 런타임, 표준 도구의 지원 |
| 시제품 구현의 용이성 | 작은 애플리케이션을 실행하고 변경을 시험하기 쉬운 정도. 경험과 기존 코드에 따라 달라지는 편집상 평가 |
| Solana SDK | Solana 공식 문서에서 용도에 맞는 클라이언트 SDK와 예제를 찾아 사용하기 쉬운 정도 |
제어 축은 직접 설계할 수 있는 범위를, 안전성은 이용할 수 있는 지원을, SDK 축은 공식 문서에서 이어지는 경로를 평가합니다. 같은 단계라도 제공하는 장치와 보장은 다를 수 있습니다.[8][13][20][21][26]
다음 목록에서는 Rust, Go, TypeScript, Python, C++, Zig의 여섯 언어를 가로 3열과 세로 2행으로 비교합니다. 관심 있는 축을 비교하고, 이어지는 개별 그림과 설명에서 실행 조건과 적합한 용도를 확인하세요.
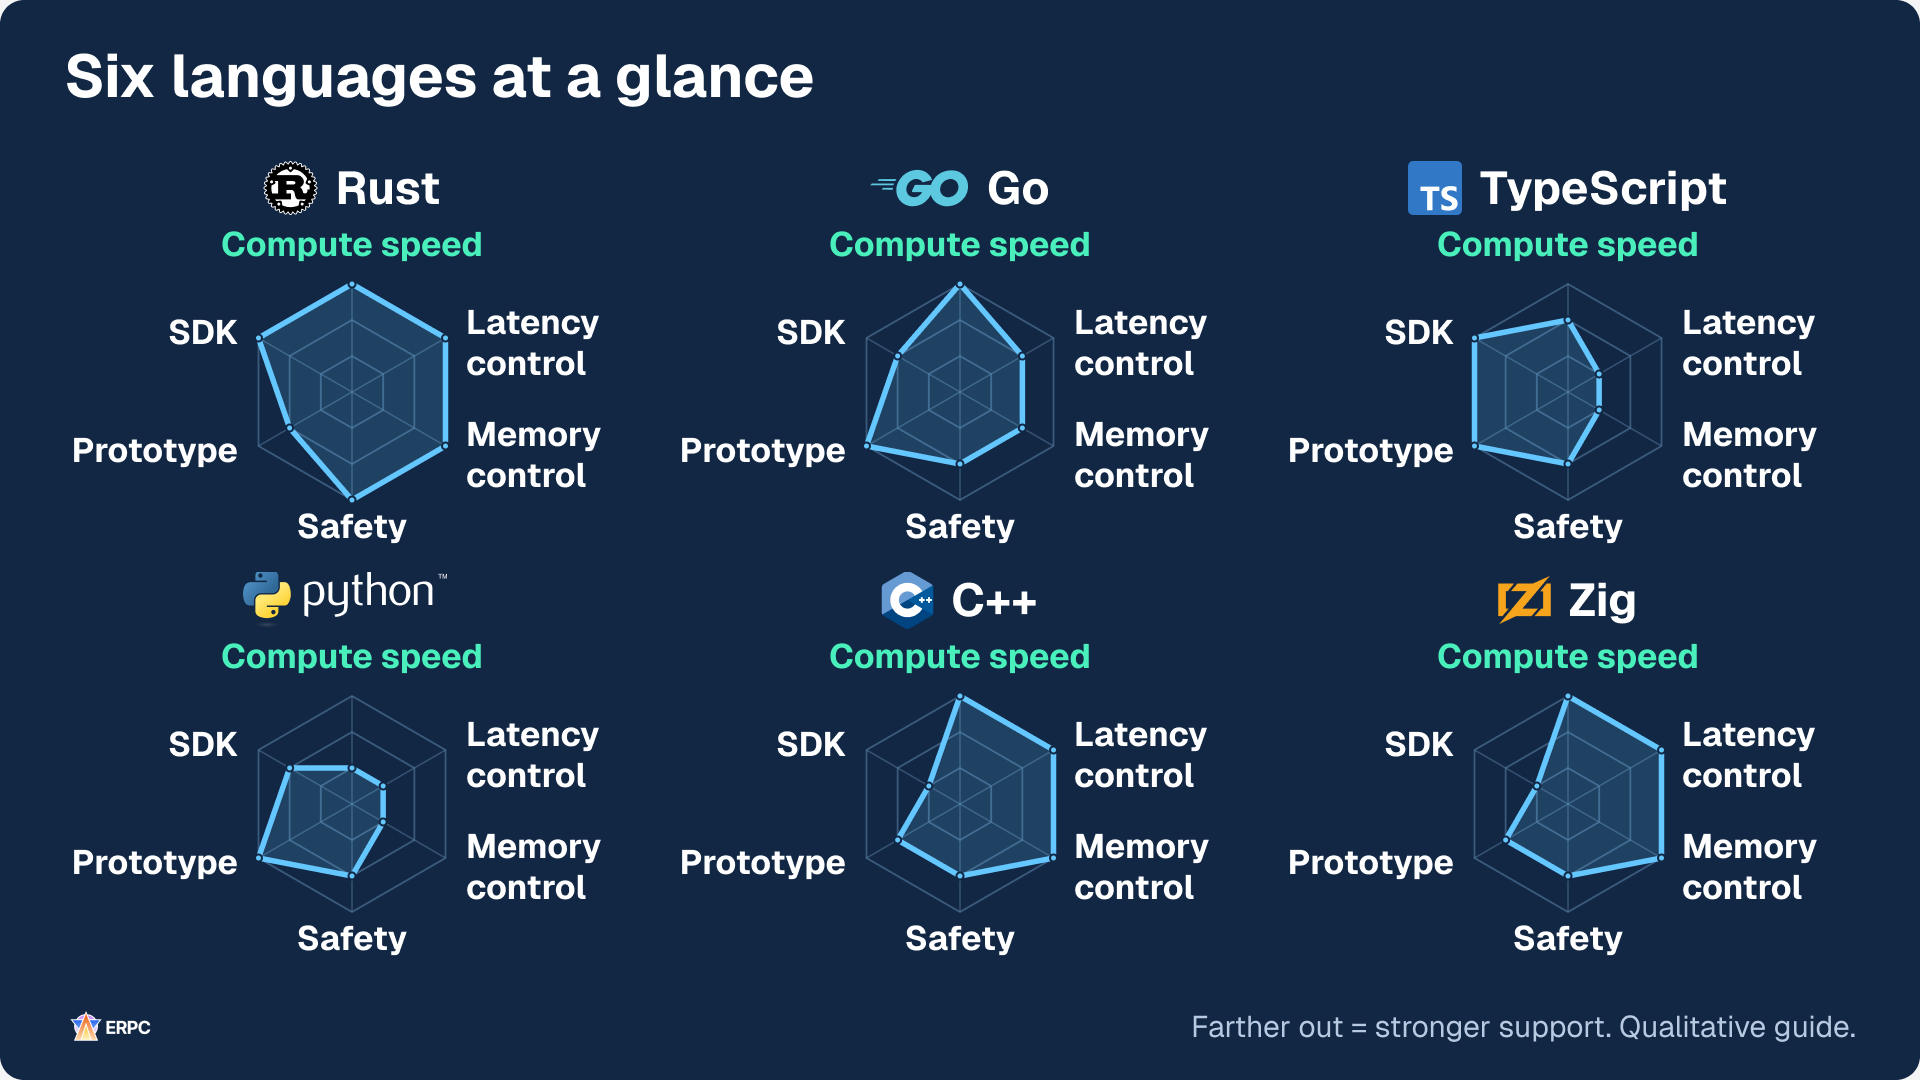
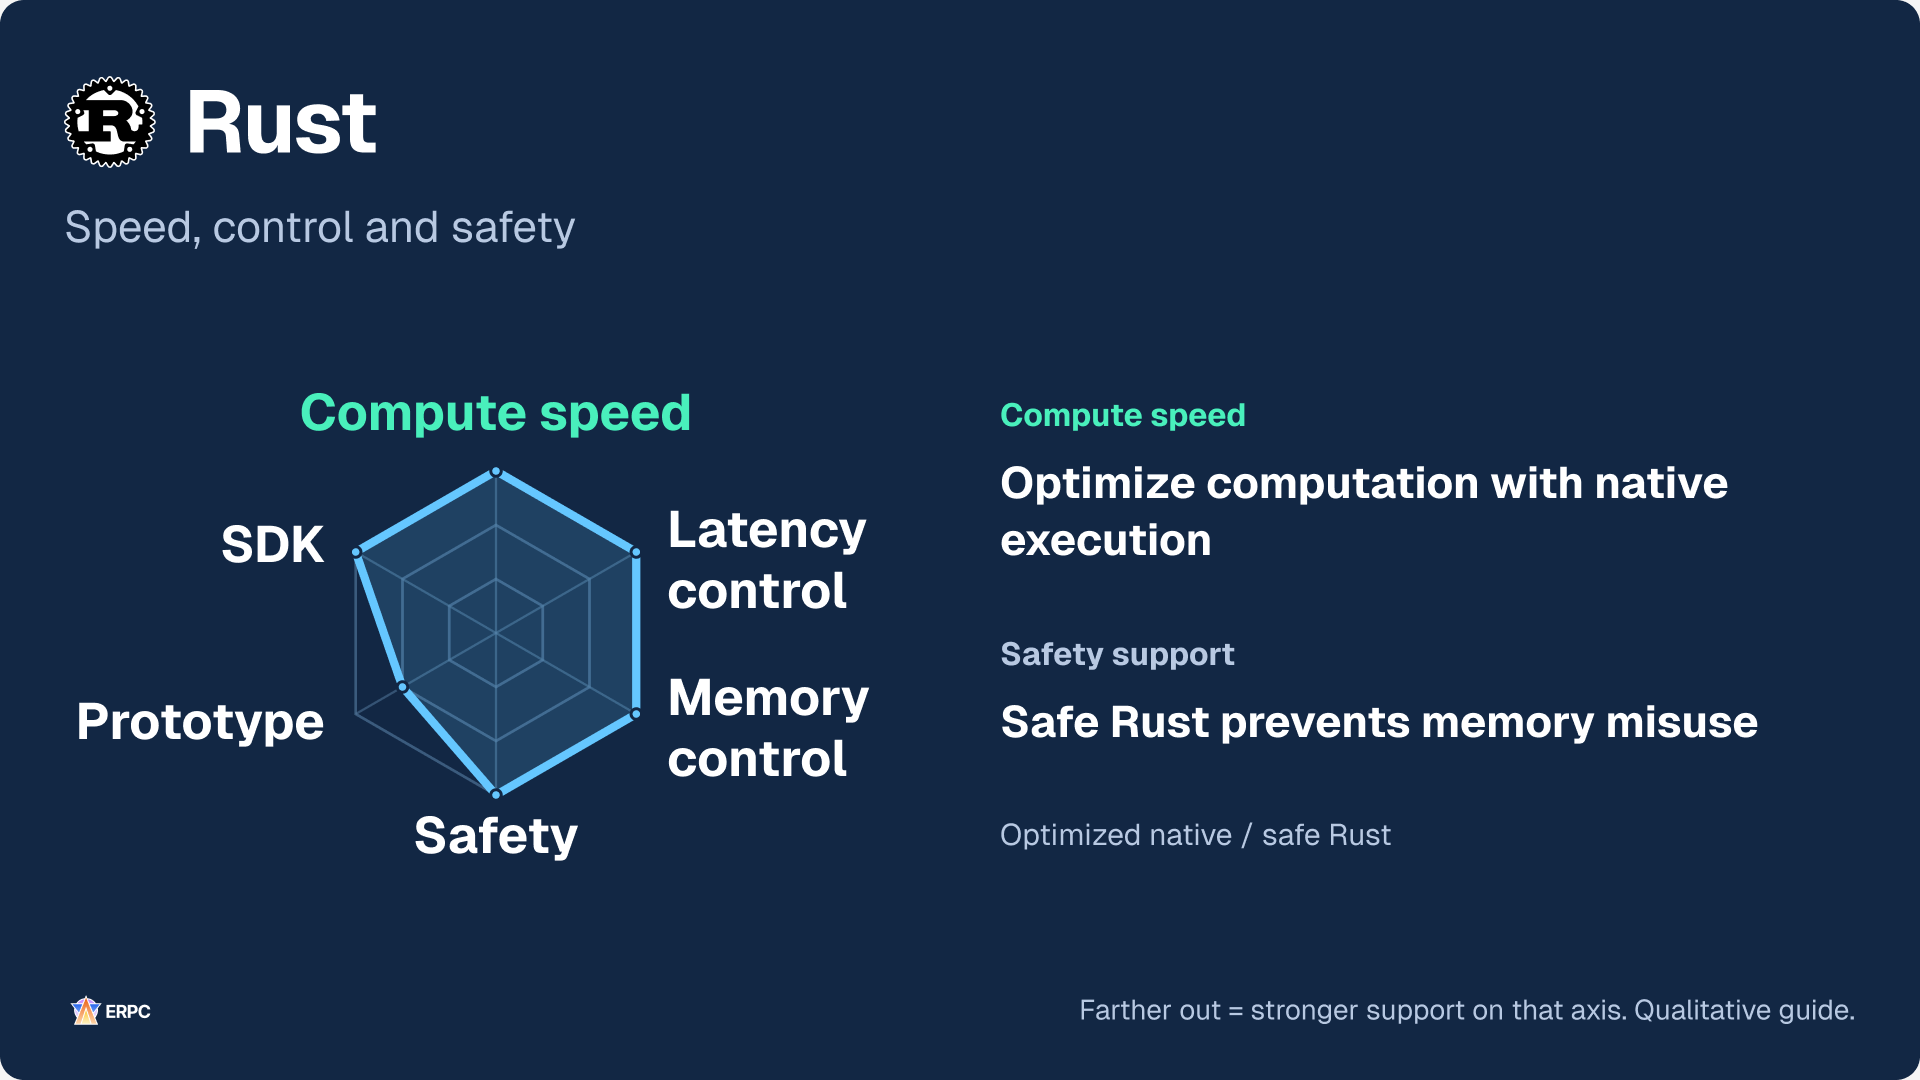
Rust는 중요한 경로의 메모리 배치·할당·재사용 제어와 소유권·차용 검사를 결합합니다. 일반적인 메모리 관리에 추적형 GC가 필요하지 않습니다.[8] safe Rust의 데이터 경쟁 방지 보장이 일반적인 경쟁 조건, 교착 상태, 잘못된 판단 로직까지 없애 주지는 않습니다. unsafe 코드와 외부 언어 인터페이스는 별도 검증이 필요합니다.[22] 복사, 할당, 해제, 잠금, 운영체제 대기는 여전히 생기므로 실제 입력과 부하로 확인합니다.
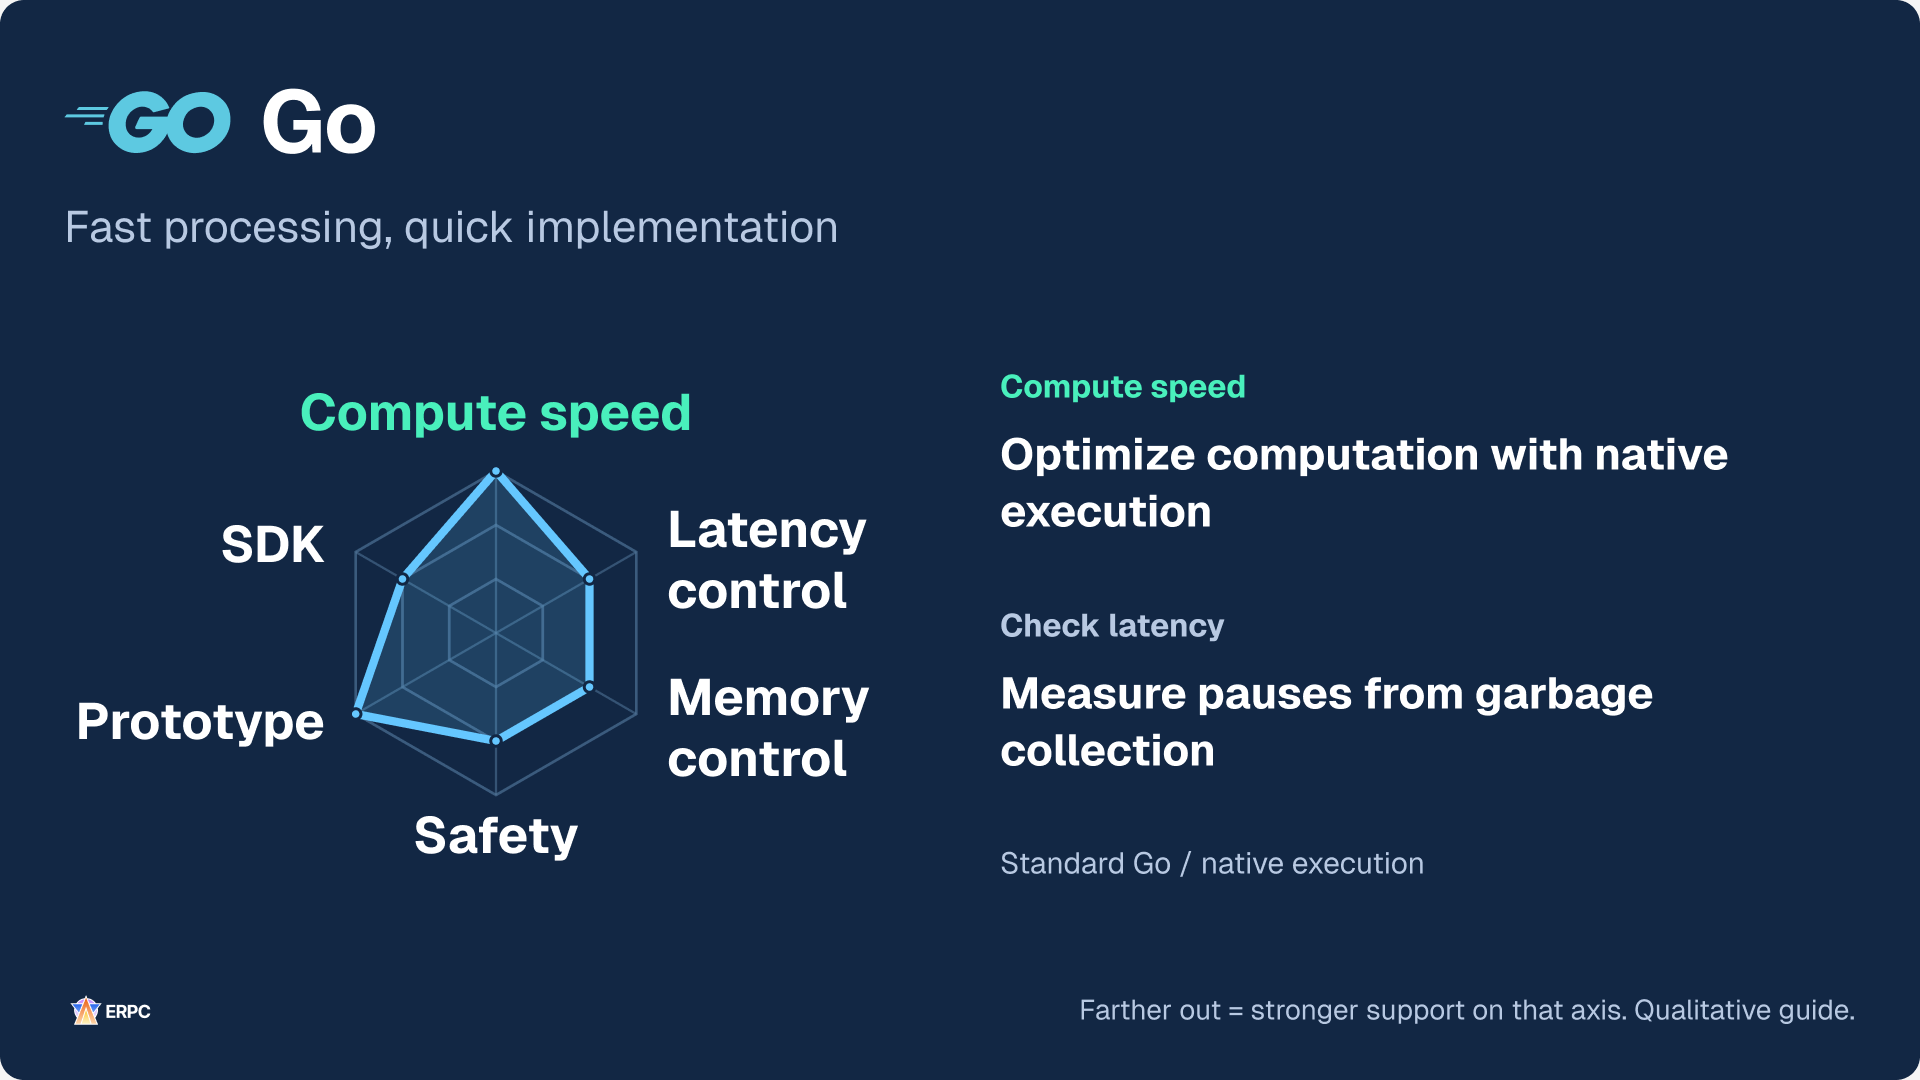
Go도 네이티브 컴파일 실행의 후보입니다. 동시성 서비스와 처리를 구성하기 쉽고, 런타임이 메모리 관리 등의 작업을 지원합니다.[20] GC 작업은 대부분 다른 작업과 동시에 진행되지만, 할당량과 수집에 따른 CPU·메모리·지연 비용을 측정해야 합니다. CPU 처리의 잠재력과 메모리 회수 시점을 직접 제어할 수 있는 정도는 별도로 봅니다.[13]
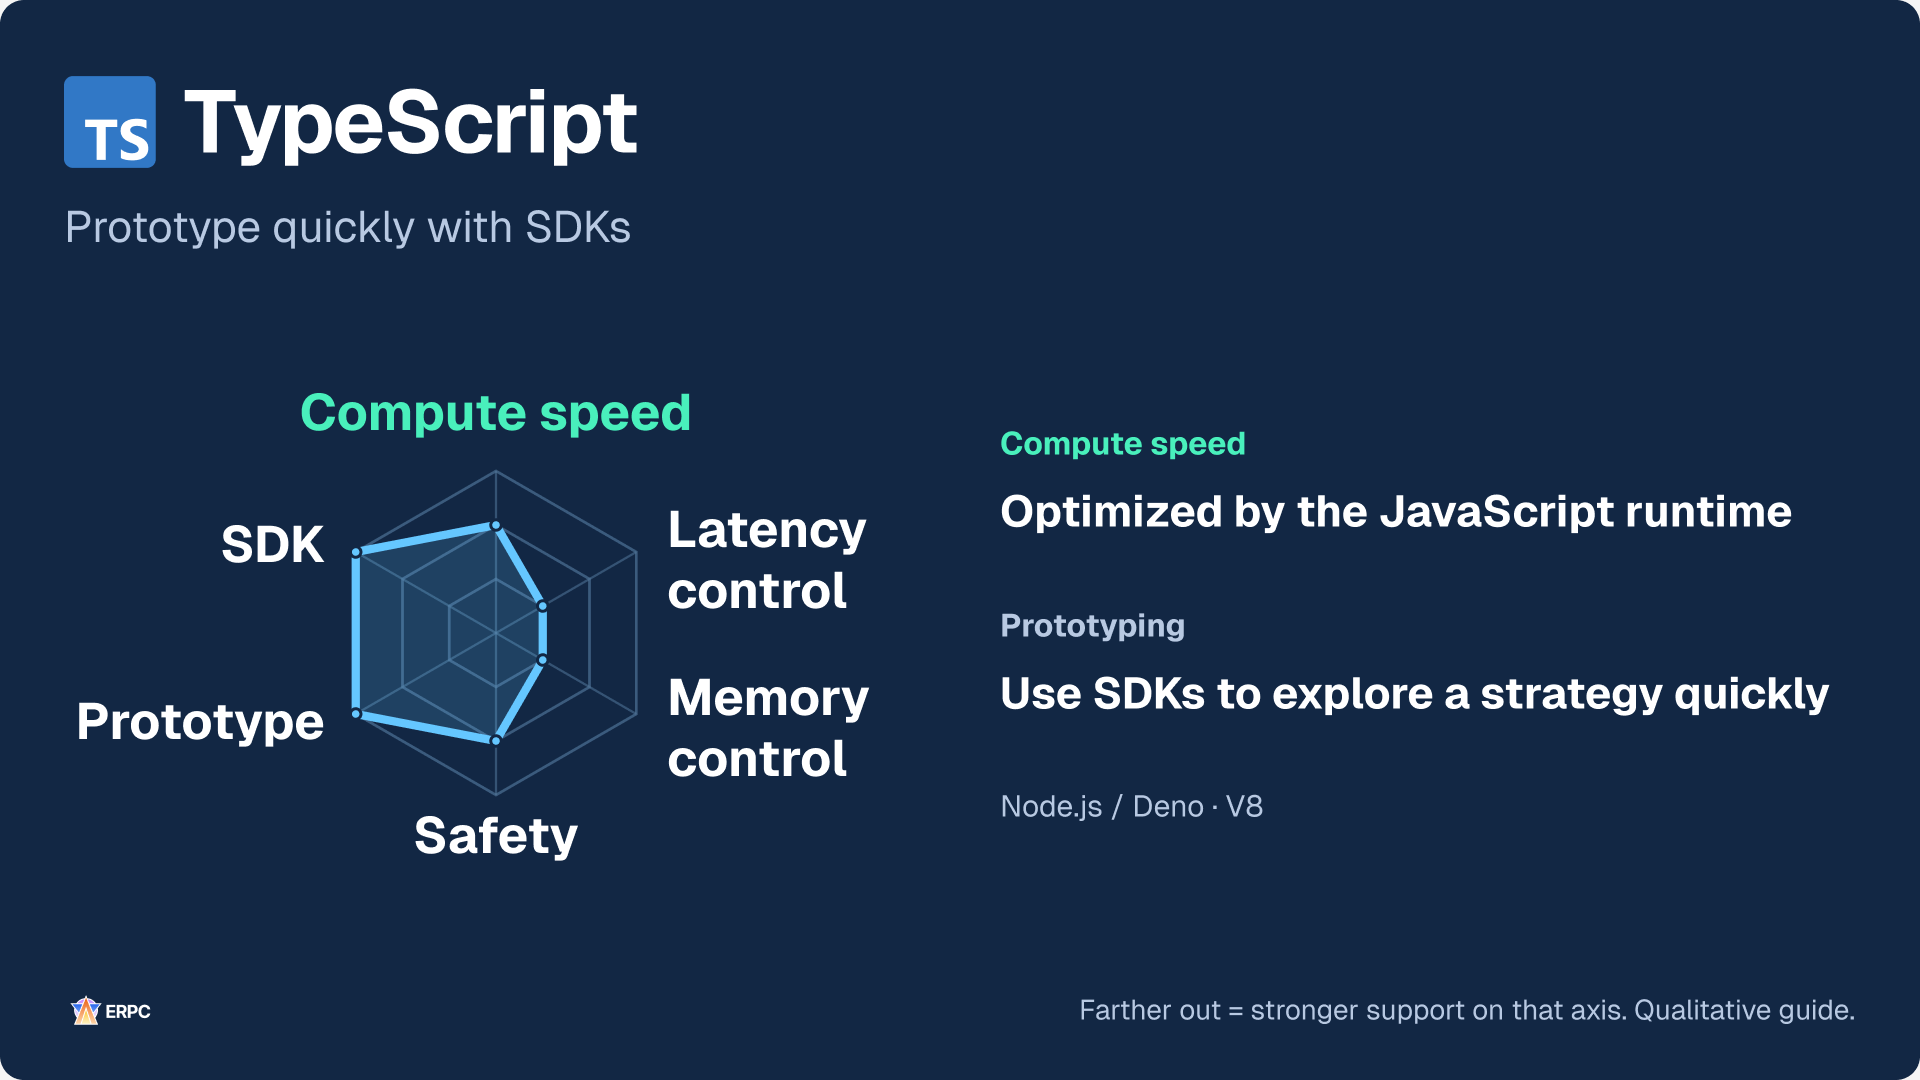
TypeScript는 언어이고 Node.js와 Deno는 런타임입니다. 이 그림은 V8이 실행하는 JavaScript를 다룹니다. 타입 표기는 실행되는 코드에서 사라지므로 타입을 추가한 것 자체가 CPU 작업을 빠르게 하지는 않습니다. 외부 데이터는 실행 시점의 검증이 별도로 필요합니다.[9][10][21] API 연동, 설정, 모니터링, Web UI, 필요한 성능을 충족하는 스트림 처리에 활용할 수 있습니다.
Node.js의 worker_threads와 Deno의 Web Workers는 CPU 작업을 다른 실행 맥락으로 옮길 수 있습니다. Node.js 문서는 작업마다 워커를 만드는 대신 워커 풀을 권장합니다. 이동한 곳의 계산뿐 아니라 변환, 복사, 작업 제출 대기도 포함해서 평가합니다.[11][12]
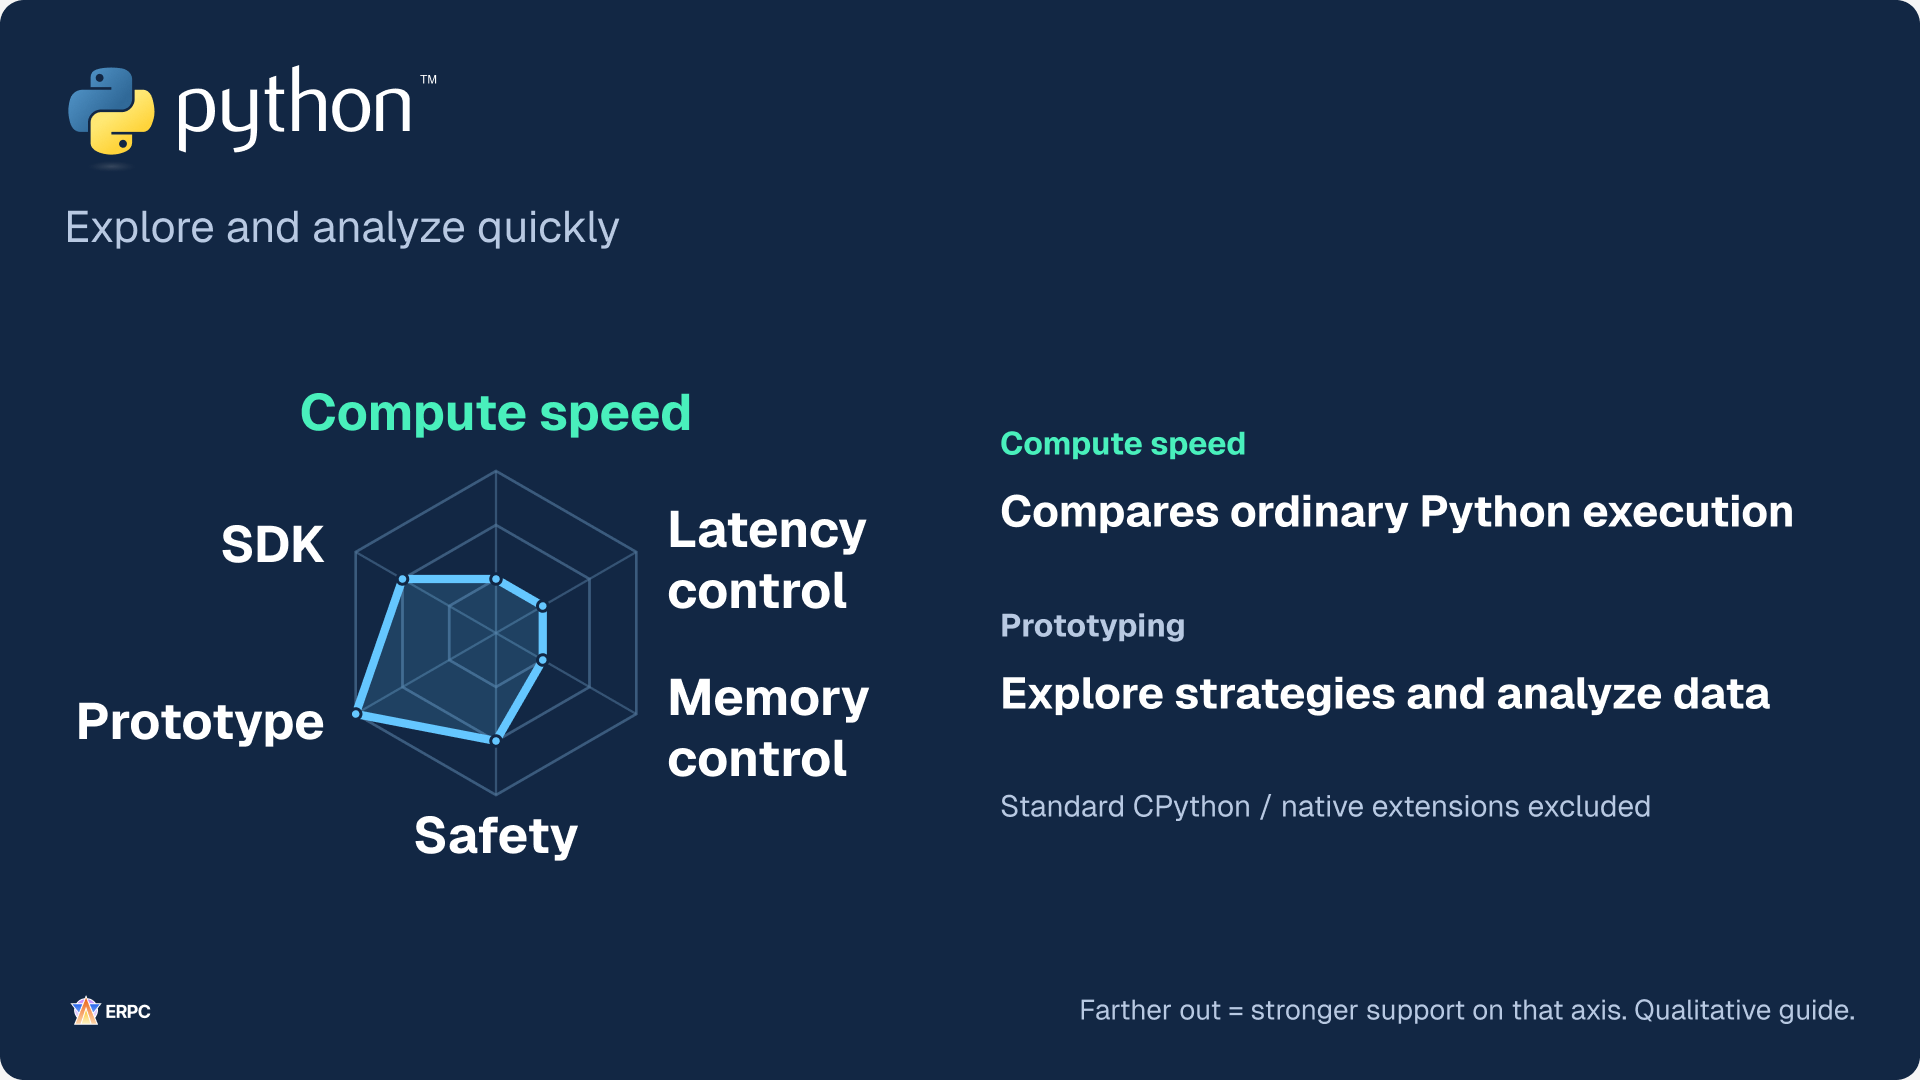
Python은 연구, 분석, 검증, 기존 라이브러리를 사용하는 작업의 후보입니다. 여기서 CPU 평가는 Python으로 작성한 루프를 일반적인 CPython 안에서 실행하는 경우를 다룹니다. NumPy 연산처럼 컴파일된 코드에 맡긴 계산은 별개의 경우입니다.[23] 언어 이름만으로 판단하지 말고 free-threaded 빌드를 포함한 실제 구성을 확인합니다.[14] 일부를 Rust나 다른 구현으로 옮긴다면 경계에서의 변환과 복사를 측정하고 애플리케이션 전체에 효과가 있는지 검증합니다.
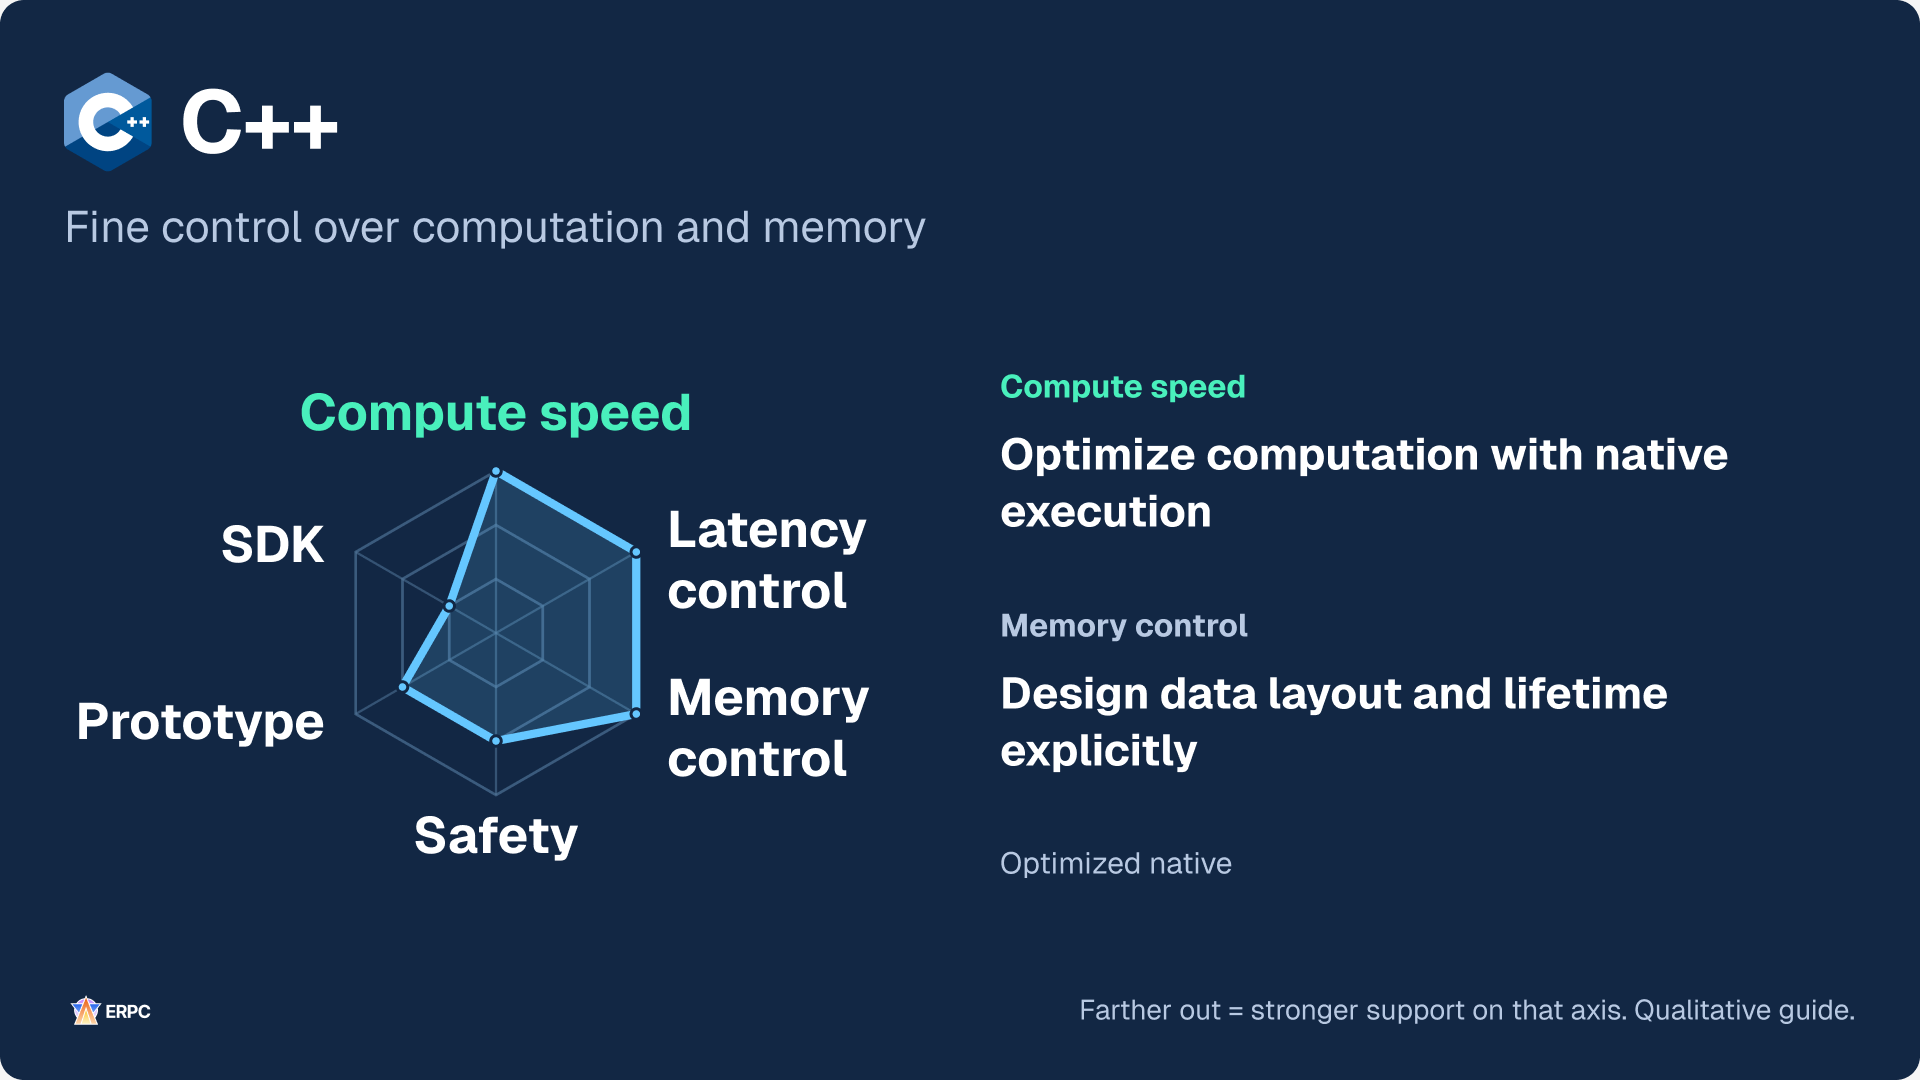
C++는 저수준 제어에 추상화와 기존 라이브러리를 결합합니다. RAII와 스마트 포인터는 자원 수명을 관리하는 데 도움을 주지만, 이를 쓴다고 모든 메모리 수명이나 공유 메모리 안전성이 보장되지는 않습니다.[24] 안전성의 중간 단계가 Go 같은 관리형 메모리와 같은 보장을 뜻하는 것도 아닙니다.
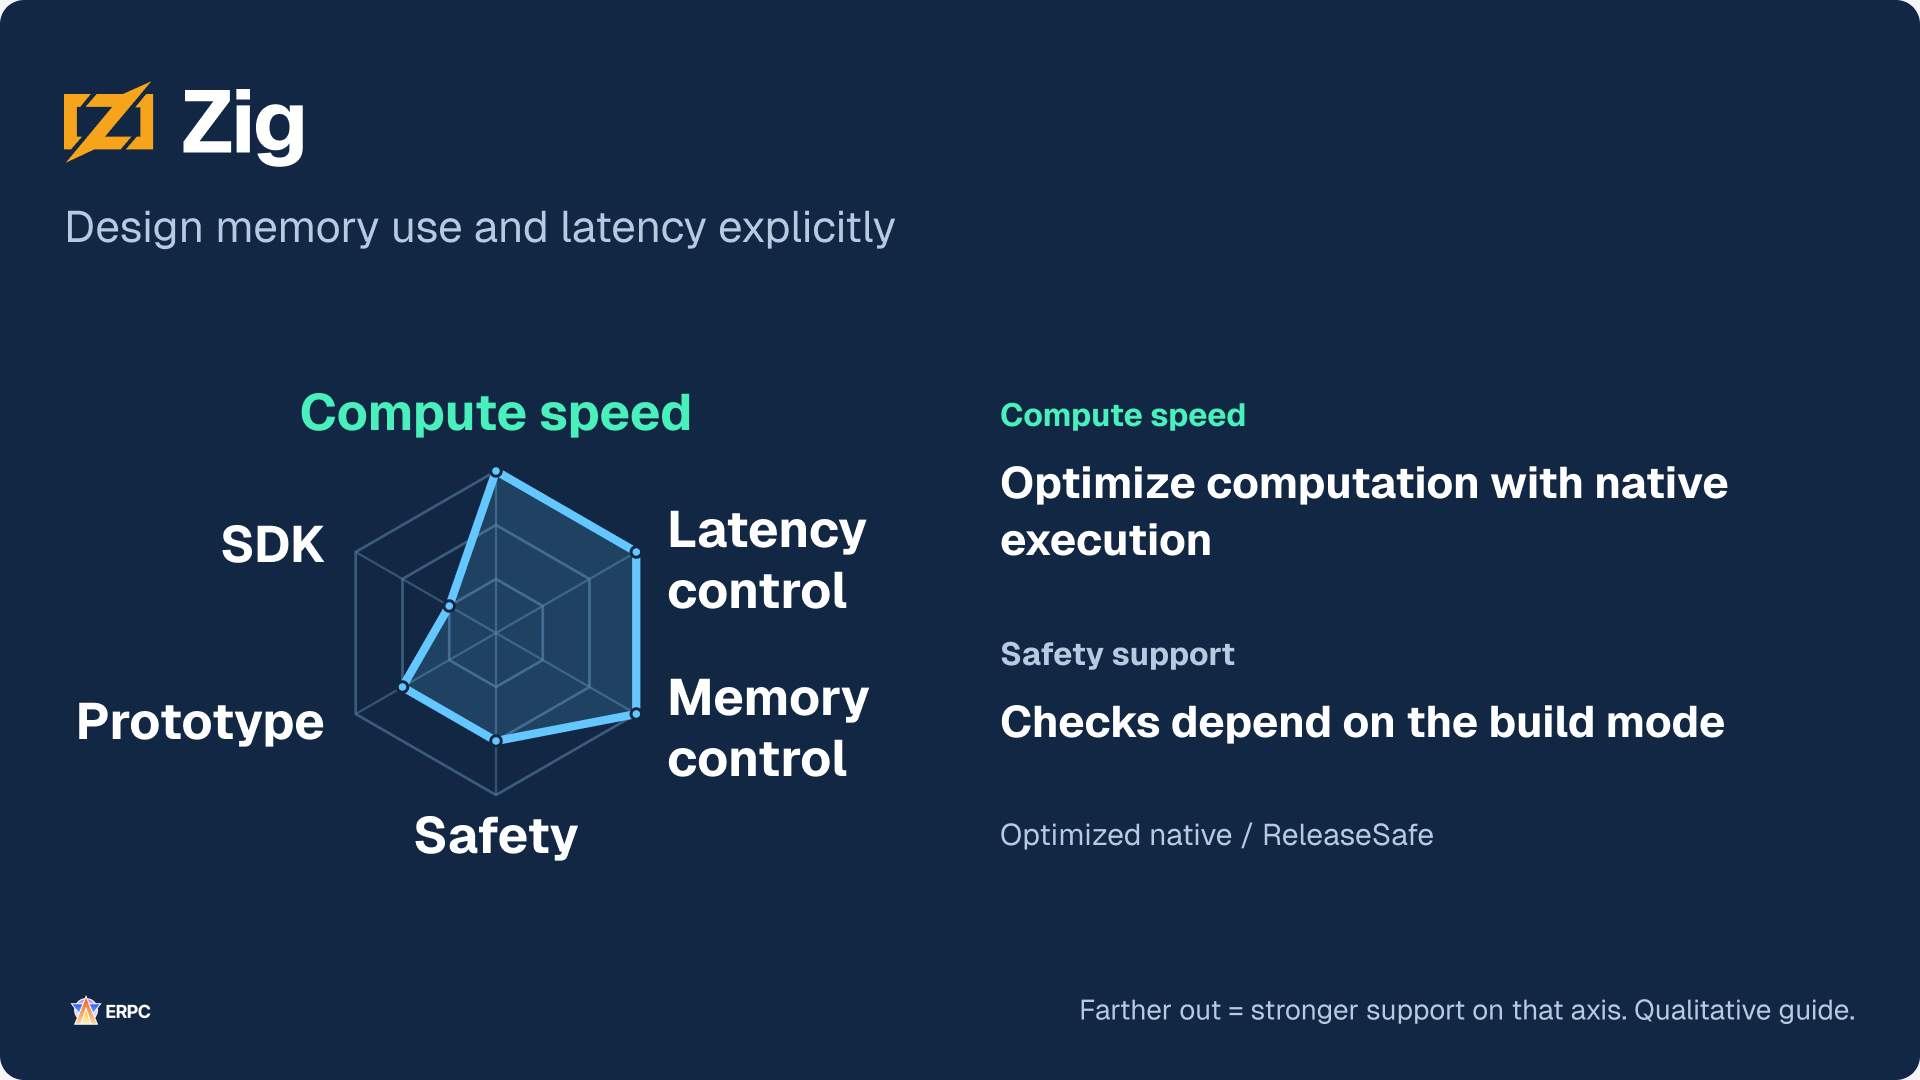
Zig는 메모리 할당과 할당자 선택을 명시적으로 구성할 수 있습니다. 이 특성도는 ReleaseSafe의 검사를 전제로 합니다. ReleaseFast와 ReleaseSmall은 기본 검사가 다르며, ReleaseSafe도 모든 잘못된 동작을 탐지하지는 않습니다.[25] C++와 다각형 모양이 같아도 작동 방식이 같다는 뜻은 아닙니다.
Solana SDK 축은 공식 문서의 TypeScript·Rust 경로와 그 목록에 소개된 Go·Python 클라이언트를 기준으로 합니다. 일반적인 라이브러리의 수나 품질을 매기는 순위도, C++·Zig에 라이브러리가 없다는 주장도 아닙니다. 실제 SDK를 선택할 때 필요한 API, 유지보수와 변경 사항의 반영 여부, Deno를 포함한 선택한 런타임과의 호환성을 확인합니다.[26]
애플리케이션이 어디에 시간을 쓰는지 측정하고, 그 부분에 필요한 강점으로 도구를 선택합니다. 먼저 현재 언어에서 대기와 반복 작업을 줄입니다. 더 세밀한 제어가 필요하면 해당 부분을 다른 언어로 옮길 수도 있습니다.
같은 조건에서 변경 전후를 비교한다
각 절의 지시문은 해당 개선의 구현과 검증을 다룹니다. 여러 개선을 적용할 때는 각 변경과 측정 결과의 대응 관계를 남기세요. 변경을 한꺼번에 적용하면 어떤 변경이 어떤 결과에 영향을 주었는지 구분하기 어려워집니다.
변경 전후에 같은 입력, 구독 조건, 부하, 출력 요구사항을 사용하세요. 수신부터 판단 완료까지 걸린 시간은 중앙값 p50과 함께 p95, p99를 살펴보세요. p99는 측정한 이벤트의 99%가 그 시간 안에 끝나는 임곗값입니다. 일반적인 처리 시간과 함께 분포의 느린 쪽을 드러내는 데 도움이 됩니다.
각 단계의 p99를 더해도 종단 간 p99가 되지는 않습니다. 이벤트마다 수신부터 판단 완료까지의 전체 시간을 직접 측정하고, 큐 대기, CPU와 메모리 사용, 누락되거나 버린 업데이트, 판단 결과의 일치 여부를 함께 확인하세요.
단일 호스트 안에서 경과 시간을 측정할 때는 벽시계 시간이 보정되어도 뒤로 가지 않는 단조 시계를 사용하세요. SDK가 디코딩 후에만 콜백을 호출한다면 콜백이 시작되기 전에도 처리가 발생한 것입니다. 전송 지연과 애플리케이션 지연을 따로 고려할 수 있도록 측정 시작점과 끝점을 정확히 적으세요.
제출 이후도 확인하세요. sendTransaction 응답이 성공했다고 해서 클러스터가 거래를 처리하거나 확인했다고 보장되지는 않습니다.[15] 수신, 판단, 제출 접수, 관찰된 온체인 결과를 연결하면 다음 개선 지점을 찾는 데 도움이 됩니다.
빠른 전달을 제때 끝나는 판단으로 연결한다
빠른 데이터 전달과 필요한 판단을 제때 완료하는 애플리케이션은 모두 중요합니다. ERPC는 전달 인프라를 지속해서 개선하고 그 위에서 실행되는 소프트웨어를 개선하는 데 도움이 되는 정보를 제공합니다.
먼저 같은 환경에서 애플리케이션 변경을 검증하세요. 이후 필요하다면 동일 코드를 서로 다른 배치 위치나 자원에서 비교해 각각의 영향을 구분하세요. ERPC의 시간 단위 과금을 사용할 때는 가설, 비교 조건, 사용 시간을 미리 정의하고 현재 Dashboard에서 가격과 가용성을 확인하세요.
참고 자료 및 관련 링크
- [1] Tokio / CPU 집약적 태스크와 블로킹
- [2] Node.js / 이벤트 루프를 막지 않기
- [3] gRPC / 흐름 제어
- [4] Yellowstone gRPC / 메시지와 구독 명세
- [5] LMAX Disruptor / 설계와 사용
- [6] Solana / Commitment
- [7] Solana / getLatestBlockhash
- [8] Rust / 소유권
- [9] TypeScript / 런타임 동작과 타입 제거
- [10] Deno / TypeScript
- [11] Node.js / Worker threads
- [12] Deno / Web Workers
- [13] Go / 가비지 컬렉터
- [14] Python / Free threading
- [15] Solana / sendTransaction
- [16] Yellowstone gRPC / 메시지 정의
- [17] Rust / std::sync::Mutex
- [18] Tokio / 공유 상태와 mutex 샤딩
- [19] Solana / 트랜잭션 구조와 서명
- [20] Go / 자주 묻는 질문
- [21] V8 / 개요
- [22] Rust / 데이터 경쟁과 경쟁 조건
- [23] NumPy / NumPy란?
- [24] C++ / 핵심 지침
- [25] Zig / 언어 참조
- [26] Solana / 클라이언트 SDK
- [27] Programming-Language-Benchmarks / nbody
- [28] Programming-Language-Benchmarks / Measurement code (2025-07-31): execution, defaults, aggregation, Zig build, Deno configuration.
- [29] Programming-Language-Benchmarks / Published measurement data (2025-08-01)
- 로고와 출처: Rust © Rust Foundation (CC BY 4.0, 형태와 색상 변경 없음); Zig © Zig project (CC BY-SA 4.0, 형태와 색상 변경 없음).
- 기타 로고: Go © The Go Authors; TypeScript © Microsoft; Python © Python Software Foundation; C++ by Jeremy Kratz / Standard C++ Foundation; Node.js / OpenJS Foundation and Node.js contributors; Deno / Deno Land Inc..
- ERPC
- ERPC Web Dashboard