Solana HFT के लिए कम लेटेंसी वाला आर्किटेक्चर
डेटा आ रहा है, फिर भी आपका एप्लिकेशन निर्णय लेने के लिए जिन कीमतों का उपयोग करता है, वे पुरानी हैं। Solana HFT एप्लिकेशन में गणना में लगने वाले समय के साथ उस समय की भी जाँच करनी चाहिए, जो प्राप्त डेटा किसी निर्णय में उपयोग होने से पहले इंतज़ार में बिताता है। हो सकता है पुराने अपडेट अभी भी प्रोसेस होने की प्रतीक्षा कर रहे हों, कोई लॉग लिखना पूरा न हुआ हो, या किसी दूसरे बाज़ार का अपडेट लॉक पकड़े हुए हो। आप अपने कोड को कैसे व्यवस्थित करते हैं, इससे ये इंतज़ार बदलते हैं।
यह लेख पाँच पैटर्न के माध्यम से बताता है कि आने वाला डेटा कहाँ इंतज़ार करता है और डिज़ाइन बदलने पर कौन-सा काम आगे बढ़ सकता है। आप अपने एप्लिकेशन से मेल खाते लक्षण को चुनकर सीधे संबंधित अनुभाग पर भी जा सकते हैं।
| एप्लिकेशन में क्या हो रहा है | किस डिज़ाइन की जाँच करें |
|---|---|
| एप्लिकेशन जितनी देर चलता है, बिना प्रोसेस हुआ डेटा उतना ही बढ़ता जाता है | 1. डेटा आने की दर, प्रोसेसिंग दर और इंतज़ार की सीमाएँ |
| रिकॉर्ड सहेजे जाने तक अगली कीमत प्रोसेस नहीं हो पाती | 2. निर्णय के लिए ज़रूरी काम को विश्लेषणात्मक लॉगिंग से अलग करना |
| बाज़ार A का अपडेट बाज़ार B के अपडेट को इंतज़ार कराता है | 3. स्वतंत्र स्टेट की रक्षा करने वाले लॉक अलग करना |
| हर बार डेटा आने पर वही तैयारी दोहराई जाती है | 4. न बदलने वाले हिस्सों को पहले तैयार करके दोबारा उपयोग करना |
| कनेक्शन लौटने के बाद भी निर्णय पुरानी वैल्यू इस्तेमाल करते हैं | 5. कनेक्शन की रिकवरी और निर्णय के लिए आवश्यक स्टेट की रिकवरी में अंतर करना |
हर खंड के अंत में उस सुधार को अपने एप्लिकेशन में लागू करने के लिए कॉपी किए जा सकने वाले निर्देश हैं। इन्हें ऐसे AI एजेंट को दें जो आपके प्रोजेक्ट का कोड पढ़ सके।
चित्रों में दी गई संख्याएँ, कीमतें, ऑपरेशन की गिनती और अवधियाँ समझाने के लिए बनाए गए मॉडल हैं। वे मापा हुआ प्रदर्शन या ट्रेडिंग के परिणाम नहीं दिखाते।
चित्र को पूरे आकार में खोलने के लिए उस पर टैप या क्लिक करें।
1. आने वाले डेटा की तुलना प्रोसेसिंग क्षमता से करें और इंतज़ार की सीमा तय करें
ऐसा एप्लिकेशन लें जो हर समान अवधि वाले अंतराल में छह इवेंट प्राप्त करता है और दो प्रोसेस कर सकता है। पहले अंतराल के अंत में चार इवेंट बिना प्रोसेस हुए बचते हैं। कतार वह स्थान है जहाँ डेटा प्रोसेस होने का इंतज़ार करता है।
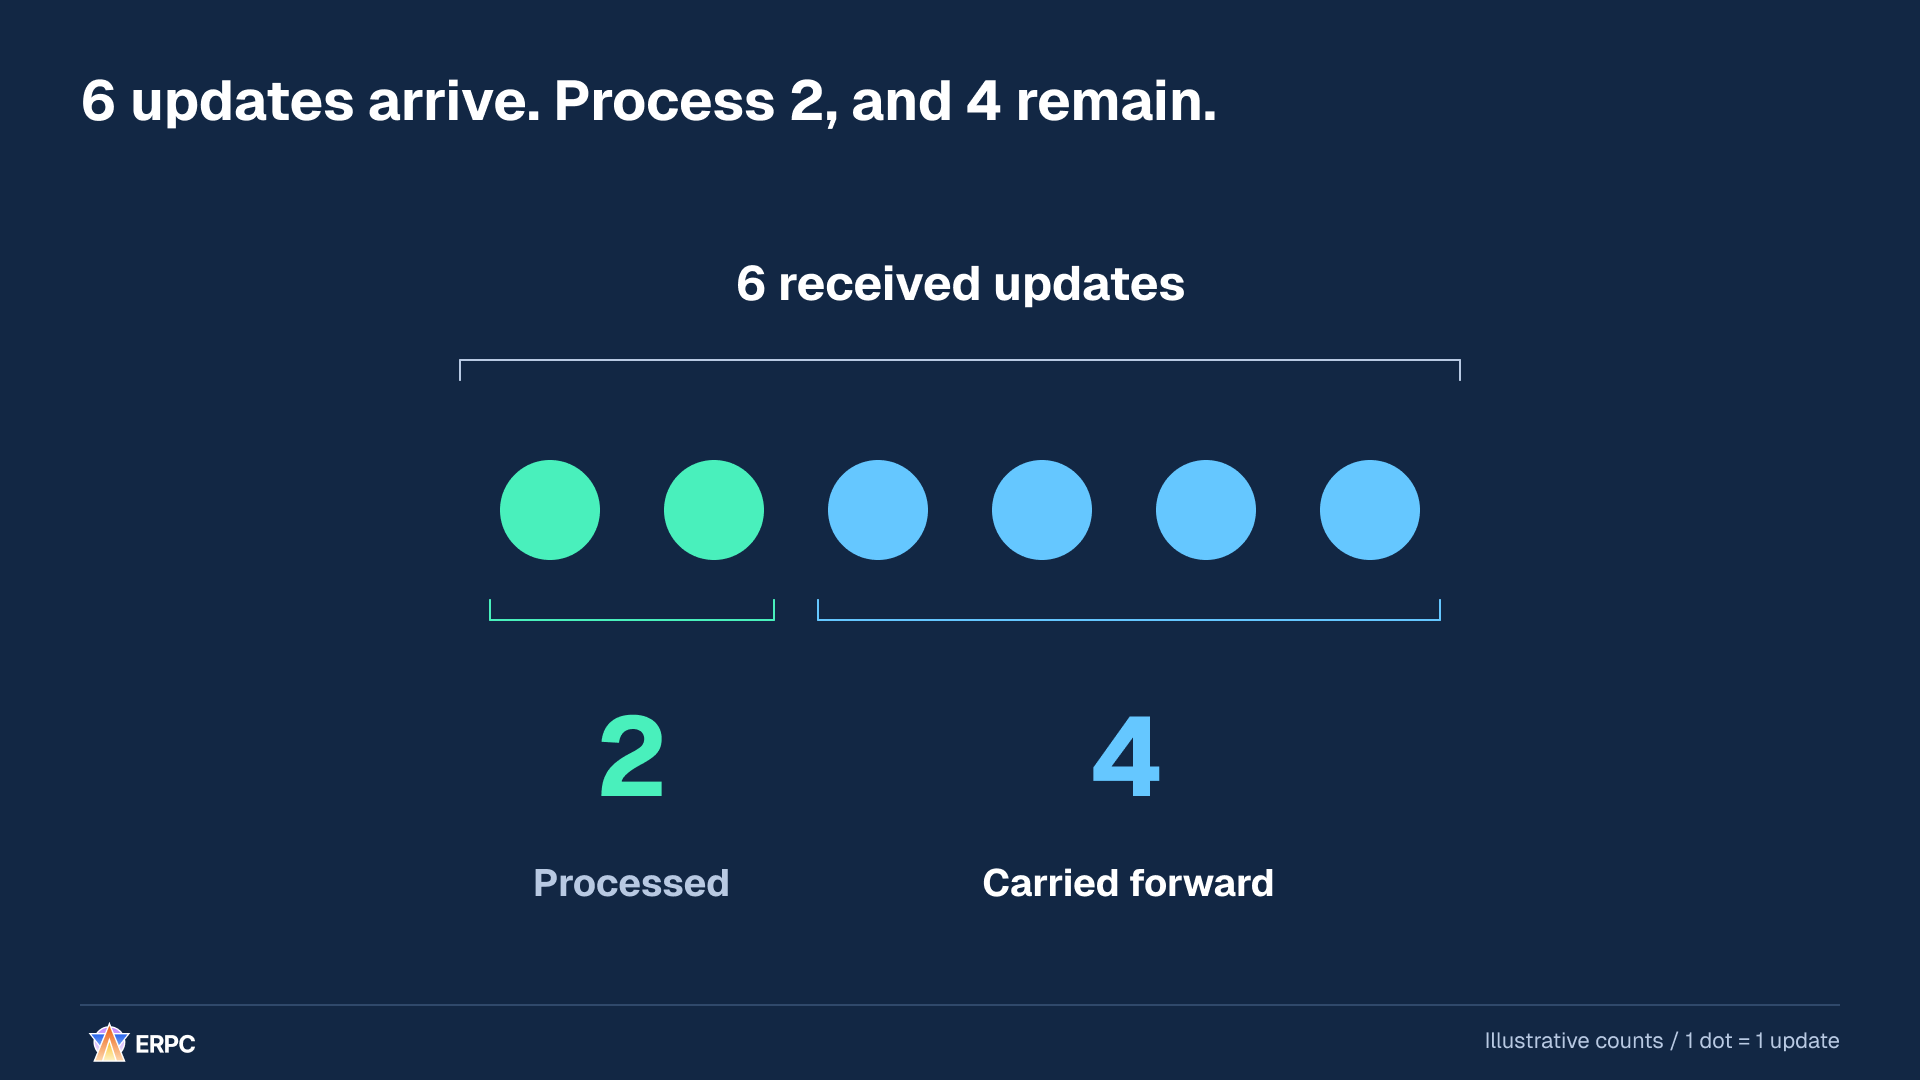
प्रोसेसिंग आगे बढ़ रही है, लेकिन चार इवेंट अभी निर्णय लेने के लिए इस्तेमाल नहीं हुए हैं।
अब यही अनुपात रखते हुए आने वाले इवेंट की संख्या 60,000 कर दें। 20,000 को प्रोसेस करने के बाद 40,000 इंतज़ार में रहेंगे। चित्र के दाईं ओर हर डॉट 100 इवेंट और 100 डॉट का हर समूह 10,000 इवेंट दर्शाता है। दो समूह प्रोसेस हो चुके हैं और चार समूह अभी इंतज़ार कर रहे हैं।
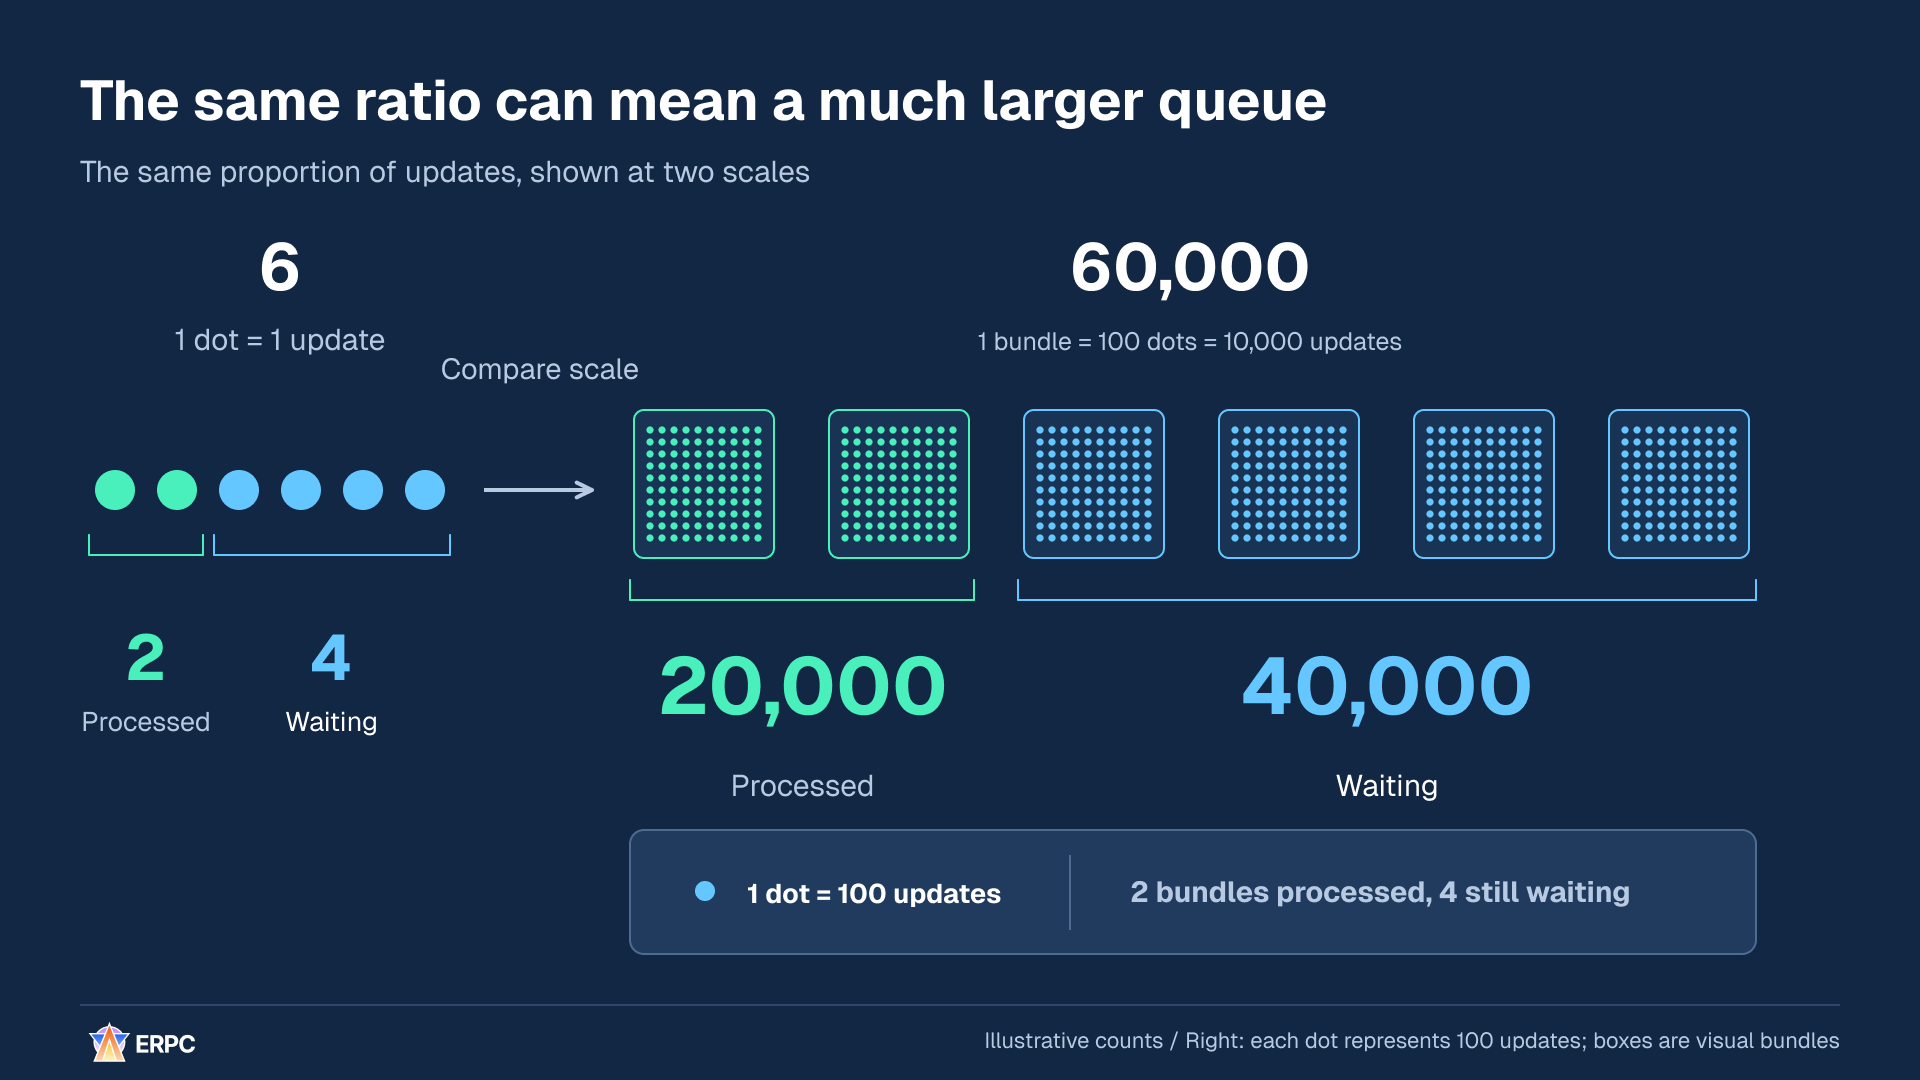
दाईं ओर के समूह डेटा की मात्रा दिखाने का तरीका हैं। वे एप्लिकेशन में प्रोसेस होने वाले बैच नहीं दर्शाते।
अगला अंतराल पहले से इंतज़ार कर रहे 40,000 इवेंट के साथ शुरू होता है। 60,000 और आते हैं तथा 20,000 प्रोसेस होते हैं, इसलिए 80,000 बचते हैं। उसके अगले अंतराल के अंत में 120,000 होते हैं। नई आने वाली कीमतों को कतार में पहले से मौजूद काम के पीछे इंतज़ार करना पड़ता है।
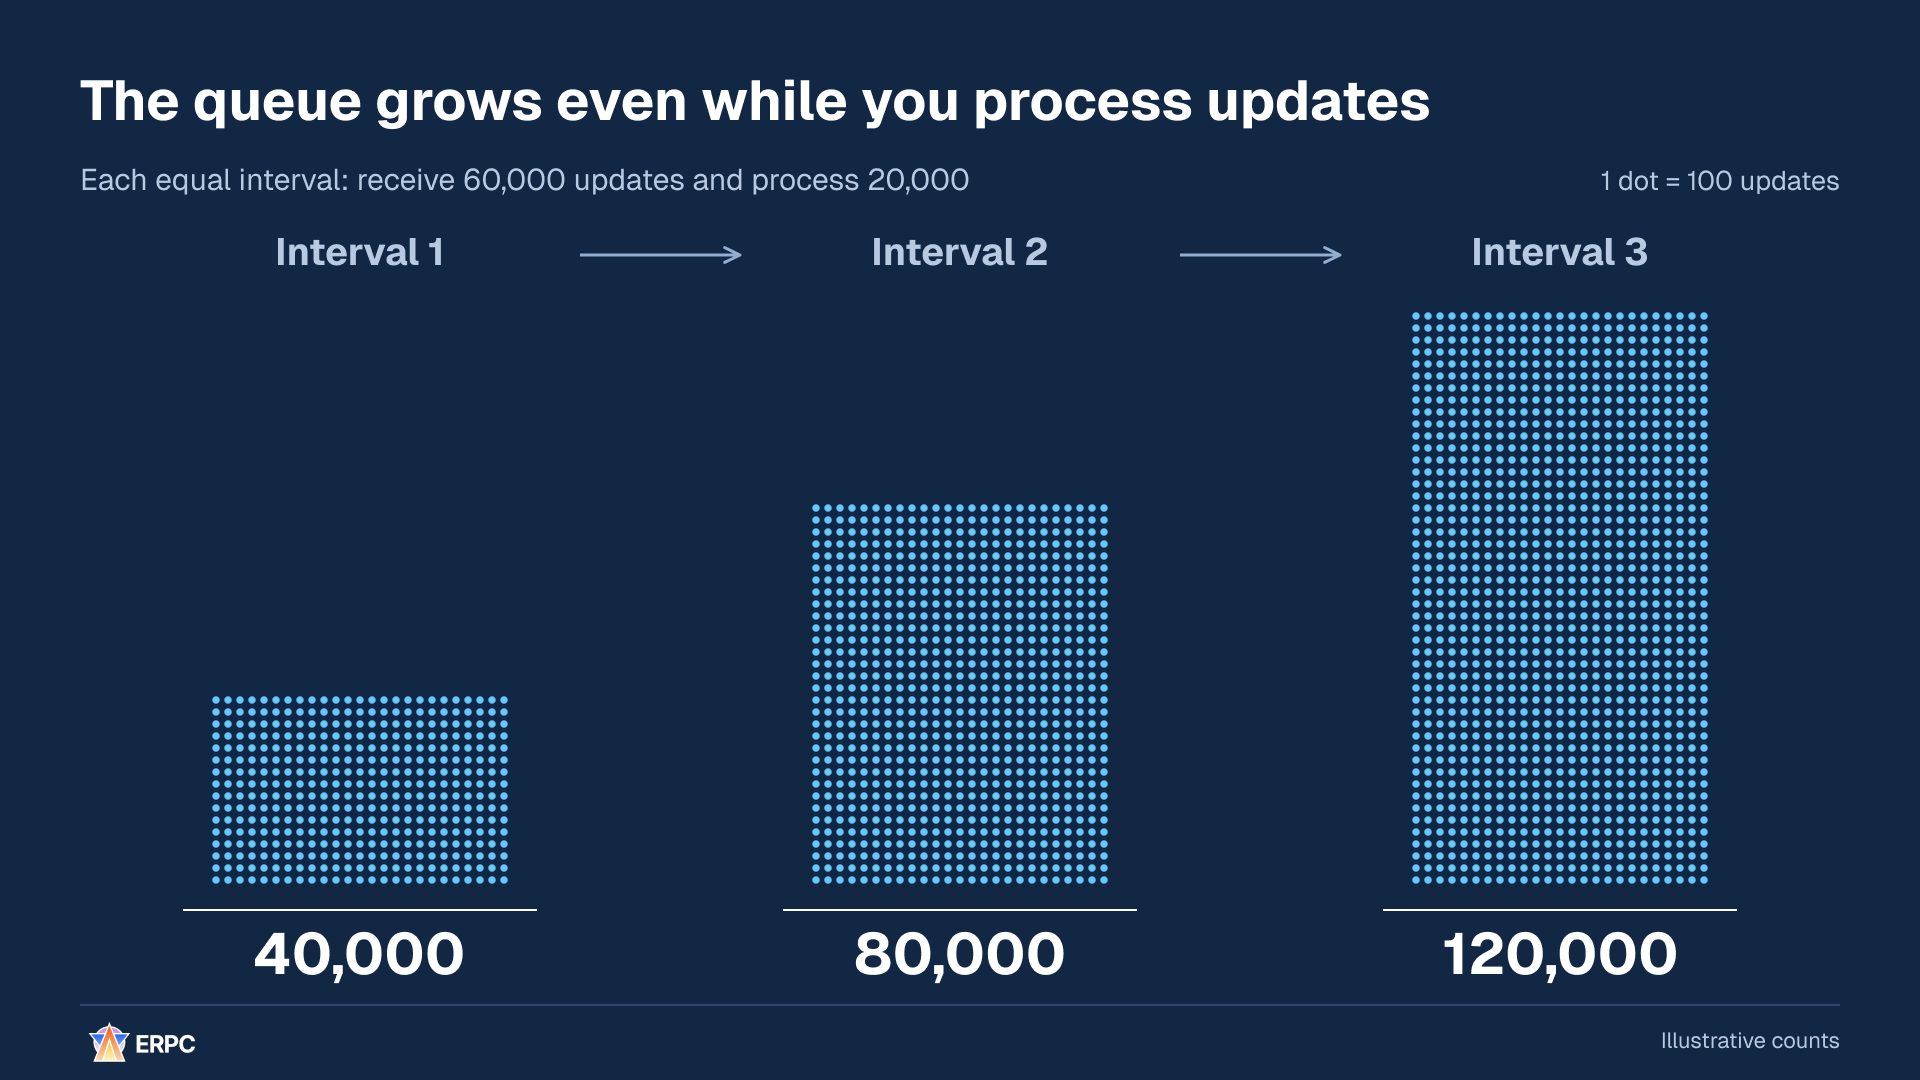
जब आने वाली मात्रा लगातार प्रोसेसिंग क्षमता से अधिक रहती है, तो जमाव बढ़ता रहता है।
कतार छोटी अवधि के उन उछालों को संभालने में मदद करती है, जब बहुत-सा डेटा एक साथ आता है। उसकी क्षमता बढ़ाने से इस उदाहरण जैसी लगातार बनी रहने वाली प्रोसेसिंग की कमी दूर नहीं होती। रखे गए आइटम और बाइट की संख्या के अलावा यह भी देखें कि सबसे पुराना आइटम कितनी देर से इंतज़ार कर रहा है, और उसकी स्वीकार्य सीमा तय करें। यदि डेटा की आवश्यक ताज़गी अब पूरी नहीं होती, तो उन वैल्यू पर निर्भर नए ट्रेडिंग निर्णय रोकें, भले ही कोई अपडेट खोया न हो।
सीमा पूरी होने पर क्या होना चाहिए? अगले चित्र में दो और अपडेट आने के समय उपलब्ध सभी आठ स्थान भरे हैं। यदि इन दो अपडेट को रखा नहीं जा सकता और वे किसी निर्णय के लिए आवश्यक हैं, तो एप्लिकेशन अपनी सहेजी हुई वैल्यू को सही ढंग से अपडेट नहीं कर सकता। उन वैल्यू पर निर्भर नए ट्रेडिंग निर्णय रोकें और आवश्यक अपडेट वापस प्राप्त करने के बाद उन्हें फिर शुरू करें।
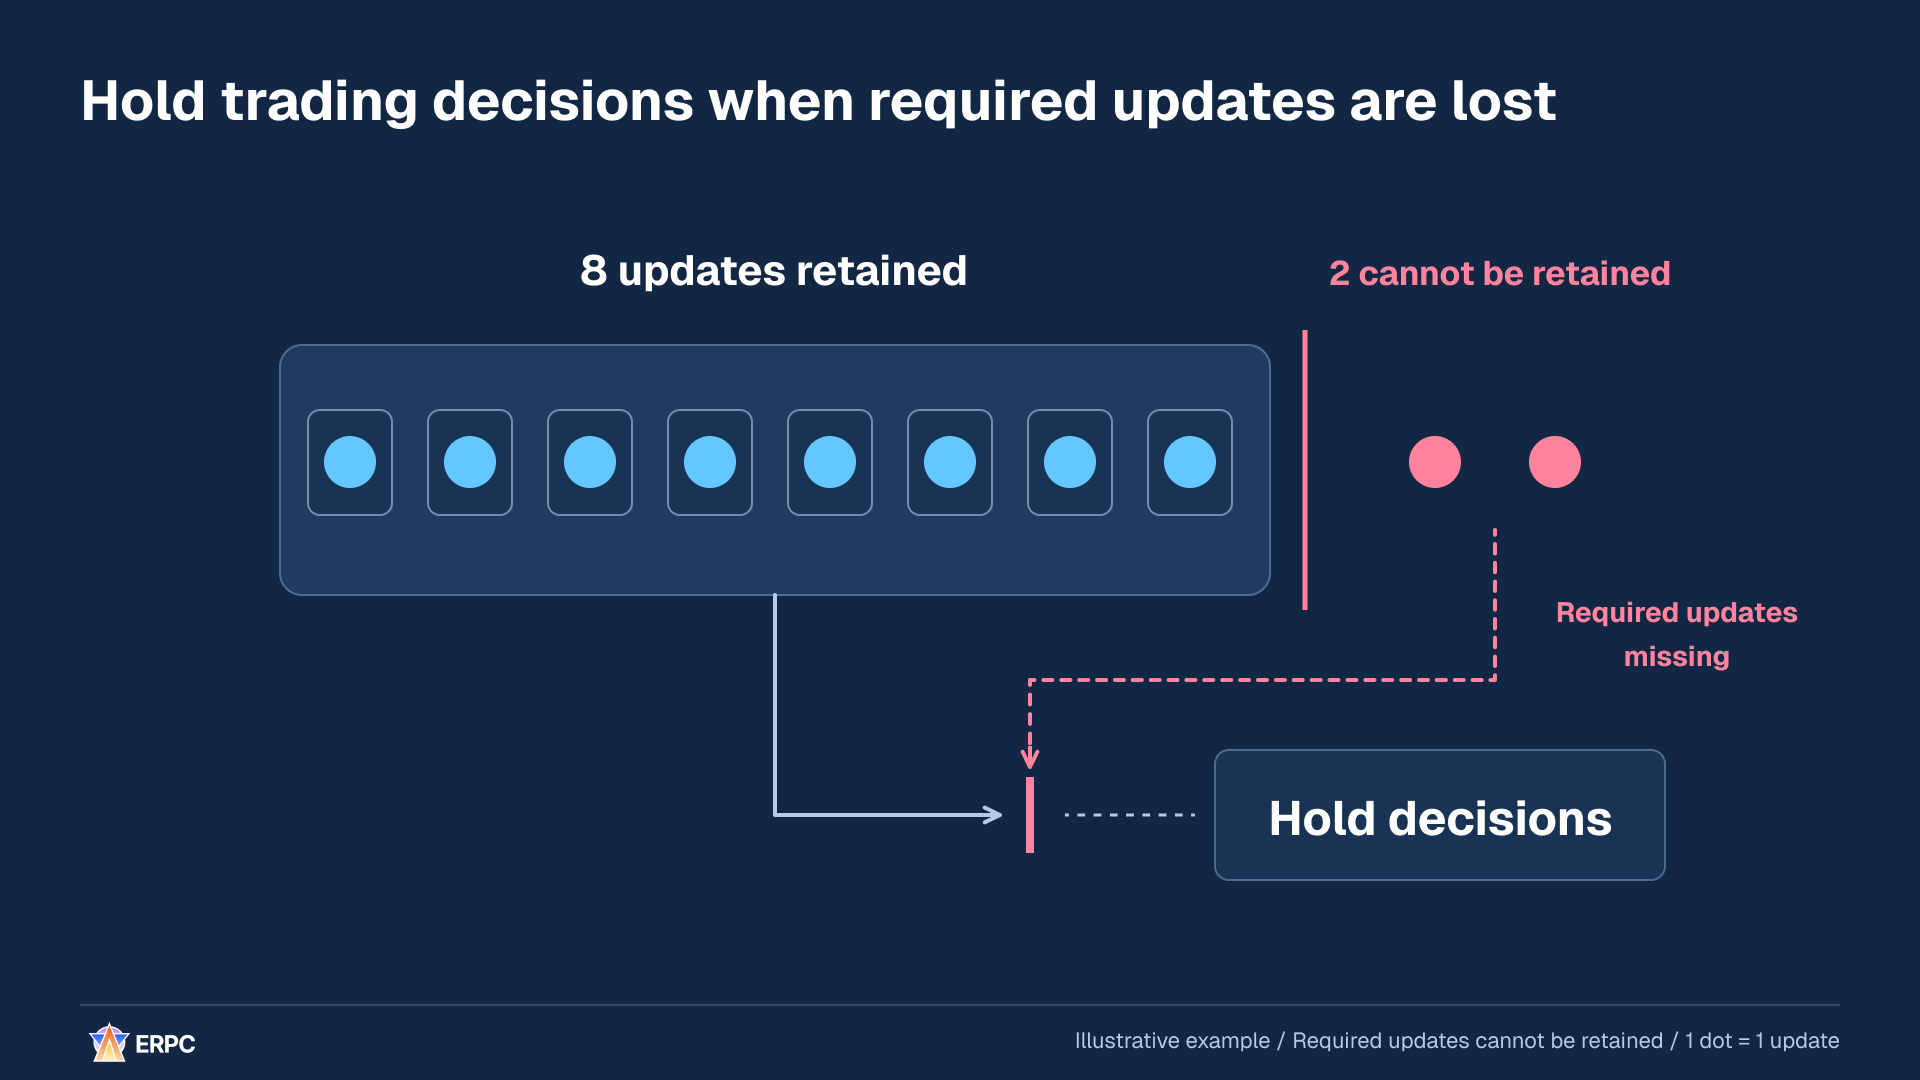
कतार के डिज़ाइन में यह भी तय होना चाहिए कि सीमा पूरी होने के बाद क्या होगा।
जाँचें कि क्या काम घटाया जा सकता है या प्रोसेसिंग क्षमता बढ़ाई जा सकती है। यदि किसी उपभोक्ता को एक ही इकाई की केवल सबसे नई पूर्ण स्टेट चाहिए, तो बीच की वैल्यू को मिलाकर सिर्फ़ नवीनतम वैल्यू रखना संभव हो सकता है। लेकिन जो प्रक्रिया बदलावों को जोड़ती जाती है या जिसे बीच के इवेंट चाहिए, उसमें अपडेट छोड़ने से परिणाम बदलता है।
डेटा प्राप्त करना रोकने से इंतज़ार प्रवाह के पहले हिस्सों में भी जा सकता है। भेजने और प्राप्त करने की गति नियंत्रित करने वाले gRPC flow control को, सब्सक्राइब किए गए डेटा को सीमित करने वाले सर्वर फ़िल्टर और एप्लिकेशन की वास्तविक प्रोसेसिंग क्षमता के साथ देखें।[3][4]
अपने एप्लिकेशन की रिसीव कतार की क्षमता और डेटा की ताज़गी सुधारने के लिए ये निर्देश कॉपी करें।
text
इस एप्लिकेशन में आने वाले डेटा का प्रबंधन सुधारें, जहाँ प्रोसेसिंग पीछे रह जाती है और निर्णयों में इस्तेमाल होने वाला डेटा पुराना हो जाता है।

README, विकास निर्देश, निर्भरताएँ और प्राप्ति → कतार → स्टेट अपडेट → निर्णय का कोड पढ़ें। मौजूदा भाषा, रनटाइम और SDK का इस्तेमाल करें। तय करें कि अपडेट में पूरा स्टेट है या delta, उन्हें किस क्रम में लागू करना आवश्यक है और डेटा की ताज़गी की क्या आवश्यकता है।

1. गोपनीय जानकारी के बिना दोबारा चलाए जा सकने वाले इनपुट सहेजें और शुरुआती मान दर्ज करें। कतार में प्रवेश से पहले का इंतज़ार भी जाँचें। एक ही अंतराल में आने और जाने वाले आइटम तथा बाइट की संख्या, कतार में पड़ा काम, सबसे पुराने प्रतीक्षारत आइटम की उम्र और चल रहे काम को मापें।
2. आइटम, बाइट, प्रतीक्षा अवधि और एक साथ चलने वाले काम की सीमाएँ तय करके लागू करें और हर सीमा का कारण दें। जहाँ आवश्यकताएँ अज्ञात हों, मान्यताएँ स्पष्ट करें। जाँचें कि अनावश्यक डेटा प्राप्ति या प्रोसेसिंग घटाई जा सकती है या नहीं और प्रोसेसिंग क्षमता पर्याप्त है या नहीं। केवल बड़ी कतार को लगातार कम पड़ती प्रोसेसिंग क्षमता का समाधान न मानें।
3. कतार भरने पर होने वाला व्यवहार तय करें। आवश्यक अपडेट सुरक्षित न रखे जा सकें, या बिना कोई अपडेट छूटे भी आवश्यक ताज़गी खो जाए, तो उन मानों पर निर्भर नए ट्रेडिंग निर्णय रोकें। स्टेट अपडेट और रिकवरी जारी रखें और निर्णय दोबारा शुरू करने की शर्तें जाँचें।
4. बीच के मानों को समेटते समय सुनिश्चित करें कि उसी इकाई का सबसे नया पूरा स्टेट परिणाम बनाए रखने के लिए पर्याप्त है। आवश्यक delta या घटनाएँ चुपचाप न हटाएँ। डेटा लेना रोकने पर प्रदाता का flow control और इंतज़ार किस जगह स्थानांतरित होता है, यह जाँचें।
5. सामान्य इनपुट, अचानक आए बड़े समूह, लगातार अधिक लोड और भरी कतार से रिकवरी को समान परिस्थितियों में दोबारा चलाएँ। आगमन और प्रोसेसिंग दर, सबसे पुराने आइटम की उम्र, प्राप्ति से निर्णय पूरा होने तक p50/p95/p99, CPU और मेमोरी तथा छूटे या हटाए गए अपडेट की तुलना करें। लागू स्टेट और निर्णयों को अपेक्षित परिणामों से मिलाएँ। एक ही होस्ट में अवधि मापने के लिए मोनोटोनिक घड़ी इस्तेमाल करें और मापन की शुरुआत व अंत स्पष्ट करें।

मौजूदा स्वीकृतियाँ, अनुमतियाँ और विकास प्रक्रियाएँ बनाए रखें। केवल इन निर्देशों को production बदलने, सशुल्क अनुबंध करने या वास्तविक ट्रेड करने की अतिरिक्त अनुमति न मानें। निजी कुंजियाँ, क्रेडेंशियल या ग्राहक डेटा न दिखाएँ।

बदलाव, तुलना की परिस्थितियाँ, पहले और बाद के माप, सही काम करने की जाँच तथा बाकी सीमाएँ बताएँ। जिन मानों को मापना संभव न हो, उन्हें अमापित बताएँ।
इस एप्लिकेशन में आने वाले डेटा का प्रबंधन सुधारें, जहाँ प्रोसेसिंग पीछे रह जाती है और निर्णयों में इस्तेमाल होने वाला डेटा पुराना हो जाता है।
README, विकास निर्देश, निर्भरताएँ और प्राप्ति → कतार → स्टेट अपडेट → निर्णय का कोड पढ़ें। मौजूदा भाषा, रनटाइम और SDK का इस्तेमाल करें। तय करें कि अपडेट में पूरा स्टेट है या delta, उन्हें किस क्रम में लागू करना आवश्यक है और डेटा की ताज़गी की क्या आवश्यकता है।
1. गोपनीय जानकारी के बिना दोबारा चलाए जा सकने वाले इनपुट सहेजें और शुरुआती मान दर्ज करें। कतार में प्रवेश से पहले का इंतज़ार भी जाँचें। एक ही अंतराल में आने और जाने वाले आइटम तथा बाइट की संख्या, कतार में पड़ा काम, सबसे पुराने प्रतीक्षारत आइटम की उम्र और चल रहे काम को मापें।
2. आइटम, बाइट, प्रतीक्षा अवधि और एक साथ चलने वाले काम की सीमाएँ तय करके लागू करें और हर सीमा का कारण दें। जहाँ आवश्यकताएँ अज्ञात हों, मान्यताएँ स्पष्ट करें। जाँचें कि अनावश्यक डेटा प्राप्ति या प्रोसेसिंग घटाई जा सकती है या नहीं और प्रोसेसिंग क्षमता पर्याप्त है या नहीं। केवल बड़ी कतार को लगातार कम पड़ती प्रोसेसिंग क्षमता का समाधान न मानें।
3. कतार भरने पर होने वाला व्यवहार तय करें। आवश्यक अपडेट सुरक्षित न रखे जा सकें, या बिना कोई अपडेट छूटे भी आवश्यक ताज़गी खो जाए, तो उन मानों पर निर्भर नए ट्रेडिंग निर्णय रोकें। स्टेट अपडेट और रिकवरी जारी रखें और निर्णय दोबारा शुरू करने की शर्तें जाँचें।
4. बीच के मानों को समेटते समय सुनिश्चित करें कि उसी इकाई का सबसे नया पूरा स्टेट परिणाम बनाए रखने के लिए पर्याप्त है। आवश्यक delta या घटनाएँ चुपचाप न हटाएँ। डेटा लेना रोकने पर प्रदाता का flow control और इंतज़ार किस जगह स्थानांतरित होता है, यह जाँचें।
5. सामान्य इनपुट, अचानक आए बड़े समूह, लगातार अधिक लोड और भरी कतार से रिकवरी को समान परिस्थितियों में दोबारा चलाएँ। आगमन और प्रोसेसिंग दर, सबसे पुराने आइटम की उम्र, प्राप्ति से निर्णय पूरा होने तक p50/p95/p99, CPU और मेमोरी तथा छूटे या हटाए गए अपडेट की तुलना करें। लागू स्टेट और निर्णयों को अपेक्षित परिणामों से मिलाएँ। एक ही होस्ट में अवधि मापने के लिए मोनोटोनिक घड़ी इस्तेमाल करें और मापन की शुरुआत व अंत स्पष्ट करें।
मौजूदा स्वीकृतियाँ, अनुमतियाँ और विकास प्रक्रियाएँ बनाए रखें। केवल इन निर्देशों को production बदलने, सशुल्क अनुबंध करने या वास्तविक ट्रेड करने की अतिरिक्त अनुमति न मानें। निजी कुंजियाँ, क्रेडेंशियल या ग्राहक डेटा न दिखाएँ।
बदलाव, तुलना की परिस्थितियाँ, पहले और बाद के माप, सही काम करने की जाँच तथा बाकी सीमाएँ बताएँ। जिन मानों को मापना संभव न हो, उन्हें अमापित बताएँ।2. रिकॉर्ड सहेजे जाने का इंतज़ार किए बिना अगली कीमत प्रोसेस करें
मान लें कि बाज़ार की कीमत 100 से 101 हो जाती है। एप्लिकेशन 100 लागू कर चुका है, अपना निर्णय पूरा कर चुका है और अब विश्लेषण के लिए एक रिकॉर्ड सहेज रहा है। यदि आने वाला डेटा संभालने वाला लूप इस रिकॉर्ड के सहेजे जाने तक इंतज़ार करता है, तो अपडेट आने पर भी वह 101 लागू नहीं कर पाएगा। एप्लिकेशन में सहेजी कीमत 100 बनी रहेगी।
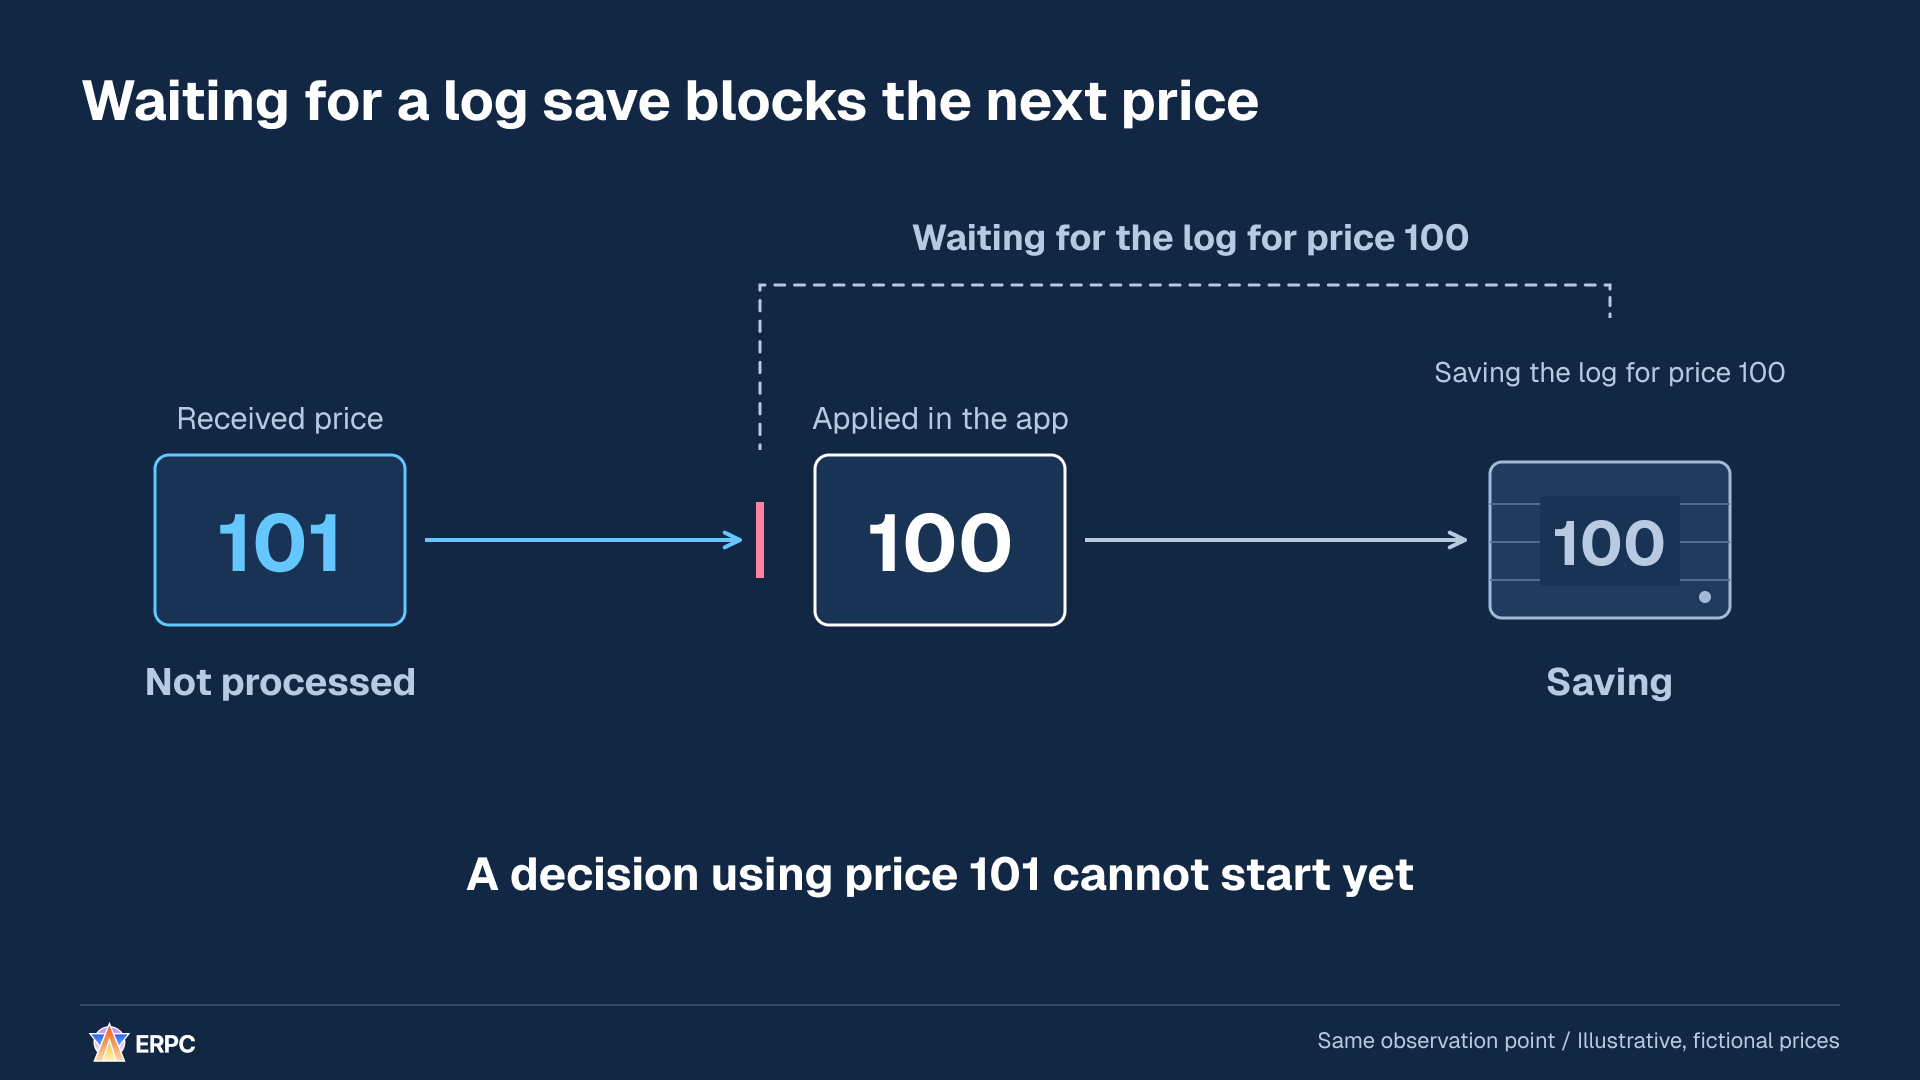
101 की प्रोसेसिंग शुरू न हो पाने का कारण 100 के रिकॉर्ड का इंतज़ार है।
अब विश्लेषणात्मक रिकॉर्ड को खाली क्षमता वाली सहायक कतार में सौंपें और उसे सहेजने का काम अलग ऑपरेशन को करने दें। रिकॉर्ड सौंपना पूरा होने पर डेटा प्राप्त करने वाला लूप अगली इनपुट पर लौट सकता है। 100 का रिकॉर्ड अभी सहेजा जा रहा हो, तब भी वह 101 लागू करके निर्णय तक पहुँच सकता है।
अगली तुलना में 100 को सहेजने की अवधि, 101 के आने का समय और 101 को प्रोसेस करने का समय एक जैसे रखे गए हैं। केवल यह बदलता है कि अगली इनपुट पर जाना रिकॉर्ड सहेजना पूरा होने पर निर्भर है या नहीं।
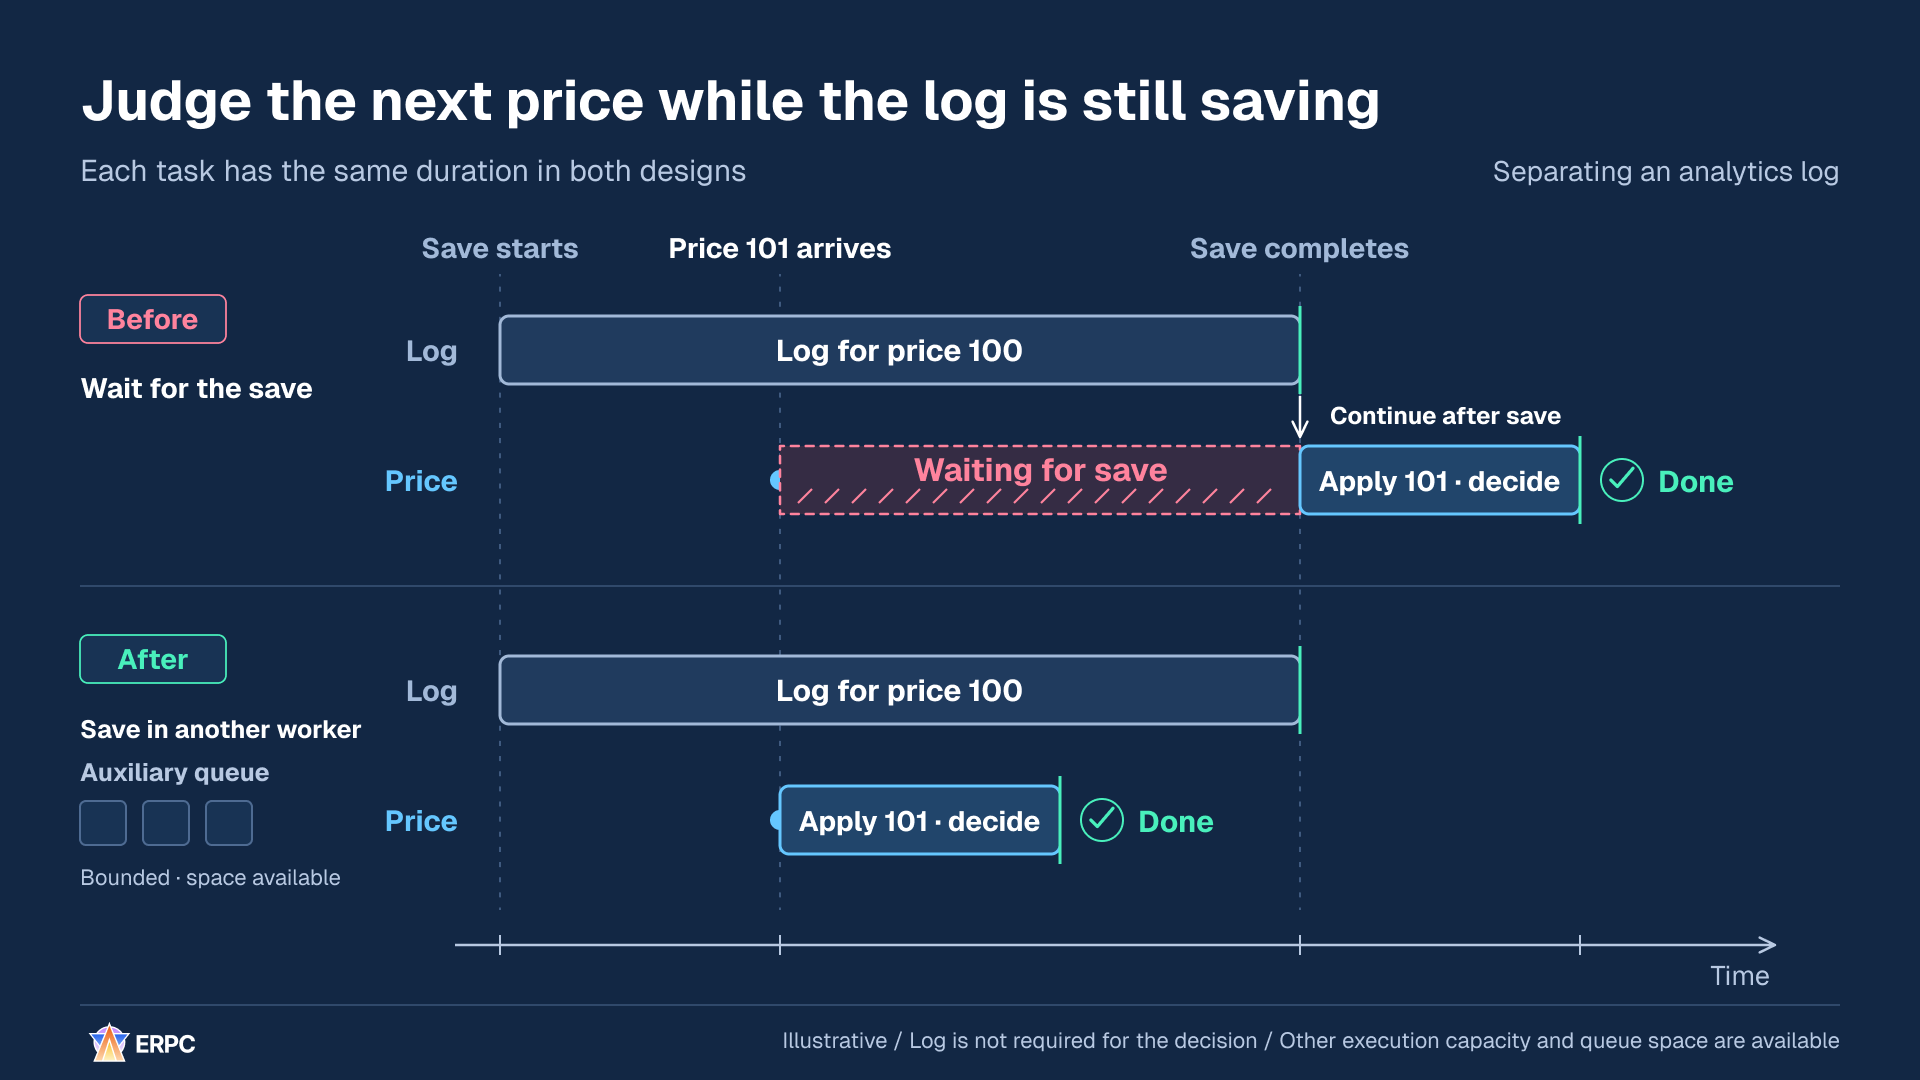
101 के अपने काम को छोटा किए बिना भी, उसके शुरू होने से पहले का इंतज़ार घटाया जा सकता है।
डेटा मिलने से लेकर निर्णय और सबमिशन तक आवश्यक प्रोसेसिंग पथ को hot path कहते हैं। इस उदाहरण में उस विश्लेषणात्मक लॉगिंग को इस पथ से हटाया जाता है, जिसके लिए निर्णय को रोकना आवश्यक नहीं है। बैलेंस जाँच, जोखिम सीमा की जाँच और सही परिणाम बनाए रखने के लिए पूरी होनी आवश्यक सेविंग, आवश्यकताओं के अनुसार अपने स्थान पर बनी रहती हैं।
सहेजने का काम अभी भी मौजूद है, इसलिए सहायक कतार को भी क्षमता और इंतज़ार के समय की सीमाएँ चाहिए। अलग टास्क आवश्यक नहीं कि अलग CPU पर चले। Tokio में लंबे CPU-प्रधान या ब्लॉक करने वाले ऑपरेशन तथा Node.js इवेंट लूप पर लंबे सिंक्रोनस ऑपरेशन दूसरे काम को आगे बढ़ने से रोक सकते हैं। काम को स्थानांतरित करते समय जाँचें कि वह वास्तव में कहाँ चलेगा।[1][2]
विश्लेषण के लिए लॉग लिखने का काम निर्णय वाले रास्ते से अलग करने के लिए ये निर्देश कॉपी करें।
text
इस एप्लिकेशन को वहाँ सुधारें, जहाँ विश्लेषण वाले रिकॉर्ड सहेजे जाने का इंतज़ार अगला अपडेट लागू होने या निर्णय में इस्तेमाल होने से रोकता है।

README, विकास निर्देश, निर्भरताएँ और रिसीव लूप पढ़ें। मौजूदा भाषा, रनटाइम और स्टोरेज लाइब्रेरी का इस्तेमाल करें। सहेजना पूरा होने के इंतज़ार वाले स्थान खोजें और पता लगाएँ कि काम वास्तव में किन thread, task या event loop पर चलता है।

1. गोपनीय जानकारी के बिना दोबारा चलाए जा सकने वाले इनपुट तैयार करें। प्राप्ति, स्टेट लागू होना, निर्णय की शुरुआत और समाप्ति, सहेजने की शुरुआत और समाप्ति तथा वर्तमान परिणाम दर्ज करें।
2. आवश्यकताओं से तय करें कि सहेजना पूरा होना निर्णय या रिकवरी की पूर्वशर्त है या नहीं। बैलेंस जाँच, जोखिम जाँच और सही काम करने के लिए आवश्यक स्थायी भंडारण को उनकी आवश्यक जगह पर रखें। ऐसे विश्लेषण रिकॉर्ड अलग करें जिन्हें बाद में सहेजना पूरा किया जा सकता है।
3. रिकॉर्ड आगे सौंपने का तरीका तय करें ताकि बाद के स्टेट बदलाव रिकॉर्ड किए जा रहे मानों को न बदल सकें। सीमित सहायक कतार और रिकॉर्ड सहेजने वाला उपभोक्ता लागू करें। आइटम, बाइट और प्रतीक्षा अवधि की सीमाएँ; कतार भरने, सहेजने में विफलता, दोबारा प्रयास और बंद होने का व्यवहार; तथा रिकॉर्ड रखने की आवश्यकताएँ स्पष्ट करें। रखने की आवश्यकताएँ अज्ञात हों तो रिकॉर्ड न हटाएँ।
4. अलग task को दूसरे CPU पर चलने वाला न मानें। जाँचें कि synchronous I/O और लंबे CPU काम वास्तव में कहाँ चलते हैं। worker या ऐसे दूसरे साधन इस्तेमाल हों तो एक साथ चलने वाले काम को सीमित करें और मूल्यांकन में रूपांतरण, कॉपी और सौंपे जाने के इंतज़ार को शामिल करें।
5. समान इनपुट और आगमन गति से सामान्य सहेजना, धीमा सहेजना, विफलता, भरी सहायक कतार और बंद होने की स्थितियाँ दोहराएँ। प्राप्ति से निर्णय पूरा होने तक p50/p95/p99, सहेजने वाले हिस्से का इंतज़ार और जमा काम, CPU और मेमोरी तथा छूटे या दोहरे रिकॉर्ड की तुलना करें। स्टेट और निर्णयों के सही होने तथा रिकॉर्ड रखने की आवश्यकताओं की जाँच करें। एक ही होस्ट में अवधि मापने के लिए मोनोटोनिक घड़ी इस्तेमाल करें और मापन की शुरुआत व अंत स्पष्ट करें।

मौजूदा स्वीकृतियाँ, अनुमतियाँ और विकास प्रक्रियाएँ बनाए रखें। केवल इन निर्देशों को production बदलने, सशुल्क अनुबंध करने या वास्तविक ट्रेड करने की अतिरिक्त अनुमति न मानें। निजी कुंजियाँ, क्रेडेंशियल या ग्राहक डेटा न दिखाएँ।

बदलाव, तुलना की परिस्थितियाँ, पहले और बाद के माप, सही काम करने की जाँच तथा बाकी सीमाएँ बताएँ। जिन मानों को मापना संभव न हो, उन्हें अमापित बताएँ।
इस एप्लिकेशन को वहाँ सुधारें, जहाँ विश्लेषण वाले रिकॉर्ड सहेजे जाने का इंतज़ार अगला अपडेट लागू होने या निर्णय में इस्तेमाल होने से रोकता है।
README, विकास निर्देश, निर्भरताएँ और रिसीव लूप पढ़ें। मौजूदा भाषा, रनटाइम और स्टोरेज लाइब्रेरी का इस्तेमाल करें। सहेजना पूरा होने के इंतज़ार वाले स्थान खोजें और पता लगाएँ कि काम वास्तव में किन thread, task या event loop पर चलता है।
1. गोपनीय जानकारी के बिना दोबारा चलाए जा सकने वाले इनपुट तैयार करें। प्राप्ति, स्टेट लागू होना, निर्णय की शुरुआत और समाप्ति, सहेजने की शुरुआत और समाप्ति तथा वर्तमान परिणाम दर्ज करें।
2. आवश्यकताओं से तय करें कि सहेजना पूरा होना निर्णय या रिकवरी की पूर्वशर्त है या नहीं। बैलेंस जाँच, जोखिम जाँच और सही काम करने के लिए आवश्यक स्थायी भंडारण को उनकी आवश्यक जगह पर रखें। ऐसे विश्लेषण रिकॉर्ड अलग करें जिन्हें बाद में सहेजना पूरा किया जा सकता है।
3. रिकॉर्ड आगे सौंपने का तरीका तय करें ताकि बाद के स्टेट बदलाव रिकॉर्ड किए जा रहे मानों को न बदल सकें। सीमित सहायक कतार और रिकॉर्ड सहेजने वाला उपभोक्ता लागू करें। आइटम, बाइट और प्रतीक्षा अवधि की सीमाएँ; कतार भरने, सहेजने में विफलता, दोबारा प्रयास और बंद होने का व्यवहार; तथा रिकॉर्ड रखने की आवश्यकताएँ स्पष्ट करें। रखने की आवश्यकताएँ अज्ञात हों तो रिकॉर्ड न हटाएँ।
4. अलग task को दूसरे CPU पर चलने वाला न मानें। जाँचें कि synchronous I/O और लंबे CPU काम वास्तव में कहाँ चलते हैं। worker या ऐसे दूसरे साधन इस्तेमाल हों तो एक साथ चलने वाले काम को सीमित करें और मूल्यांकन में रूपांतरण, कॉपी और सौंपे जाने के इंतज़ार को शामिल करें।
5. समान इनपुट और आगमन गति से सामान्य सहेजना, धीमा सहेजना, विफलता, भरी सहायक कतार और बंद होने की स्थितियाँ दोहराएँ। प्राप्ति से निर्णय पूरा होने तक p50/p95/p99, सहेजने वाले हिस्से का इंतज़ार और जमा काम, CPU और मेमोरी तथा छूटे या दोहरे रिकॉर्ड की तुलना करें। स्टेट और निर्णयों के सही होने तथा रिकॉर्ड रखने की आवश्यकताओं की जाँच करें। एक ही होस्ट में अवधि मापने के लिए मोनोटोनिक घड़ी इस्तेमाल करें और मापन की शुरुआत व अंत स्पष्ट करें।
मौजूदा स्वीकृतियाँ, अनुमतियाँ और विकास प्रक्रियाएँ बनाए रखें। केवल इन निर्देशों को production बदलने, सशुल्क अनुबंध करने या वास्तविक ट्रेड करने की अतिरिक्त अनुमति न मानें। निजी कुंजियाँ, क्रेडेंशियल या ग्राहक डेटा न दिखाएँ।
बदलाव, तुलना की परिस्थितियाँ, पहले और बाद के माप, सही काम करने की जाँच तथा बाकी सीमाएँ बताएँ। जिन मानों को मापना संभव न हो, उन्हें अमापित बताएँ।3. स्वतंत्र अपडेट को एक ही लॉक के लिए इंतज़ार न कराएँ
ऐसा एप्लिकेशन लें जो बाज़ार A और B की कीमतें स्वतंत्र रूप से अपडेट कर सकता है। A का अपडेट शुरू होने के बाद B का अपडेट आता है। यदि एक ही mutex A और B दोनों की रक्षा करता है, तो B को A के उस लॉक को छोड़ने तक इंतज़ार करना होगा।
Mutex एक समय में केवल एक ऑपरेशन को सुरक्षित डेटा तक पहुँचने का अधिकार देता है। यदि दूसरा ऑपरेशन उसका उपयोग कर रहा है, तो वही लॉक लेने की कोशिश कर रहा ऑपरेशन इंतज़ार करता है।[17]
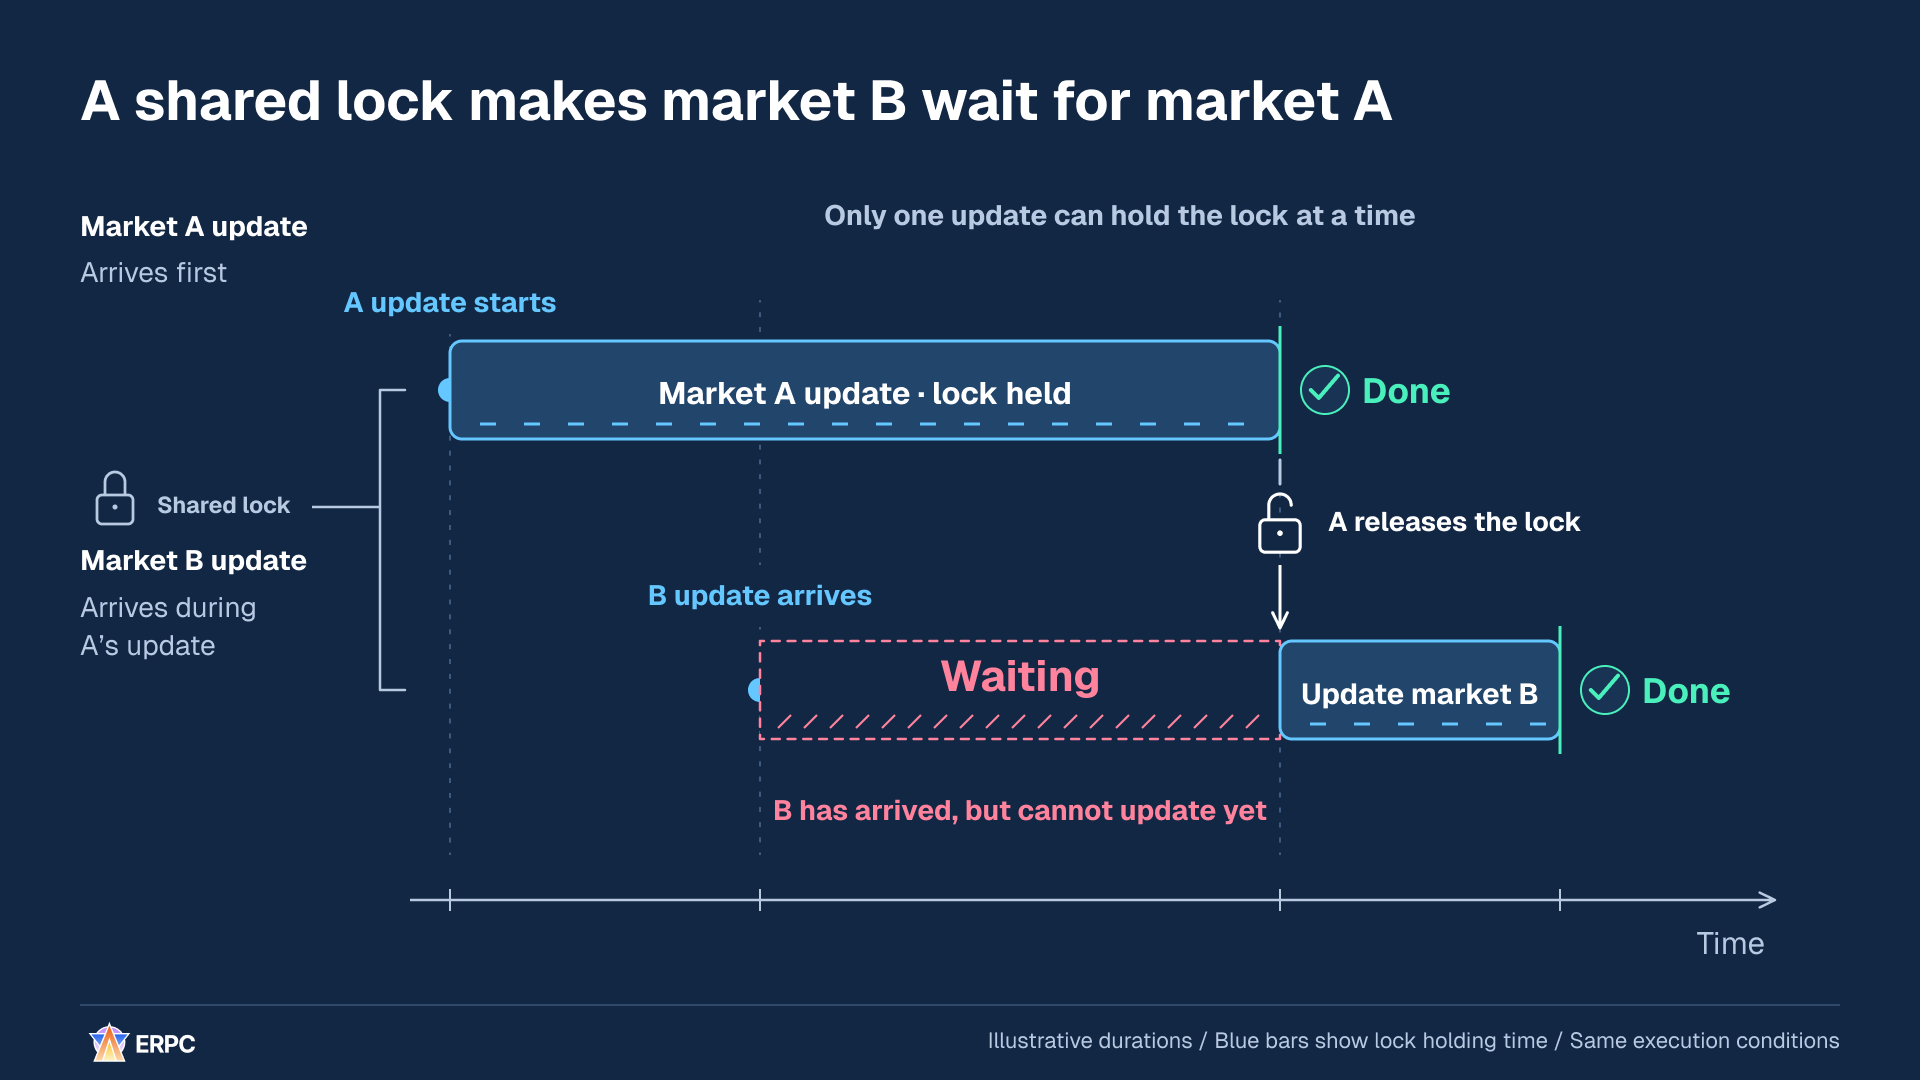
B का डेटा आ चुका है, लेकिन वह A द्वारा पकड़े गए साझा लॉक का इंतज़ार कर रहा है।
यदि A और B अलग-अलग वैल्यू बदलते हैं, तो एक विकल्प उन्हें अलग लॉक से सुरक्षित करना है। अगले चित्र के ऊपरी हिस्से में साझा लॉक और निचले हिस्से में अलग लॉक हैं। A और B के आने के बिंदु तथा लॉक पकड़े रखने की अवधि दोनों हिस्सों में समान हैं। उदाहरण में माना गया है कि B का लॉक खाली है और B के लिए निष्पादन क्षमता उपलब्ध है। Tokio का आधिकारिक ट्यूटोरियल स्वतंत्र कुंजी वाले डेटा के लिए mutex sharding भी बताता है।[18]
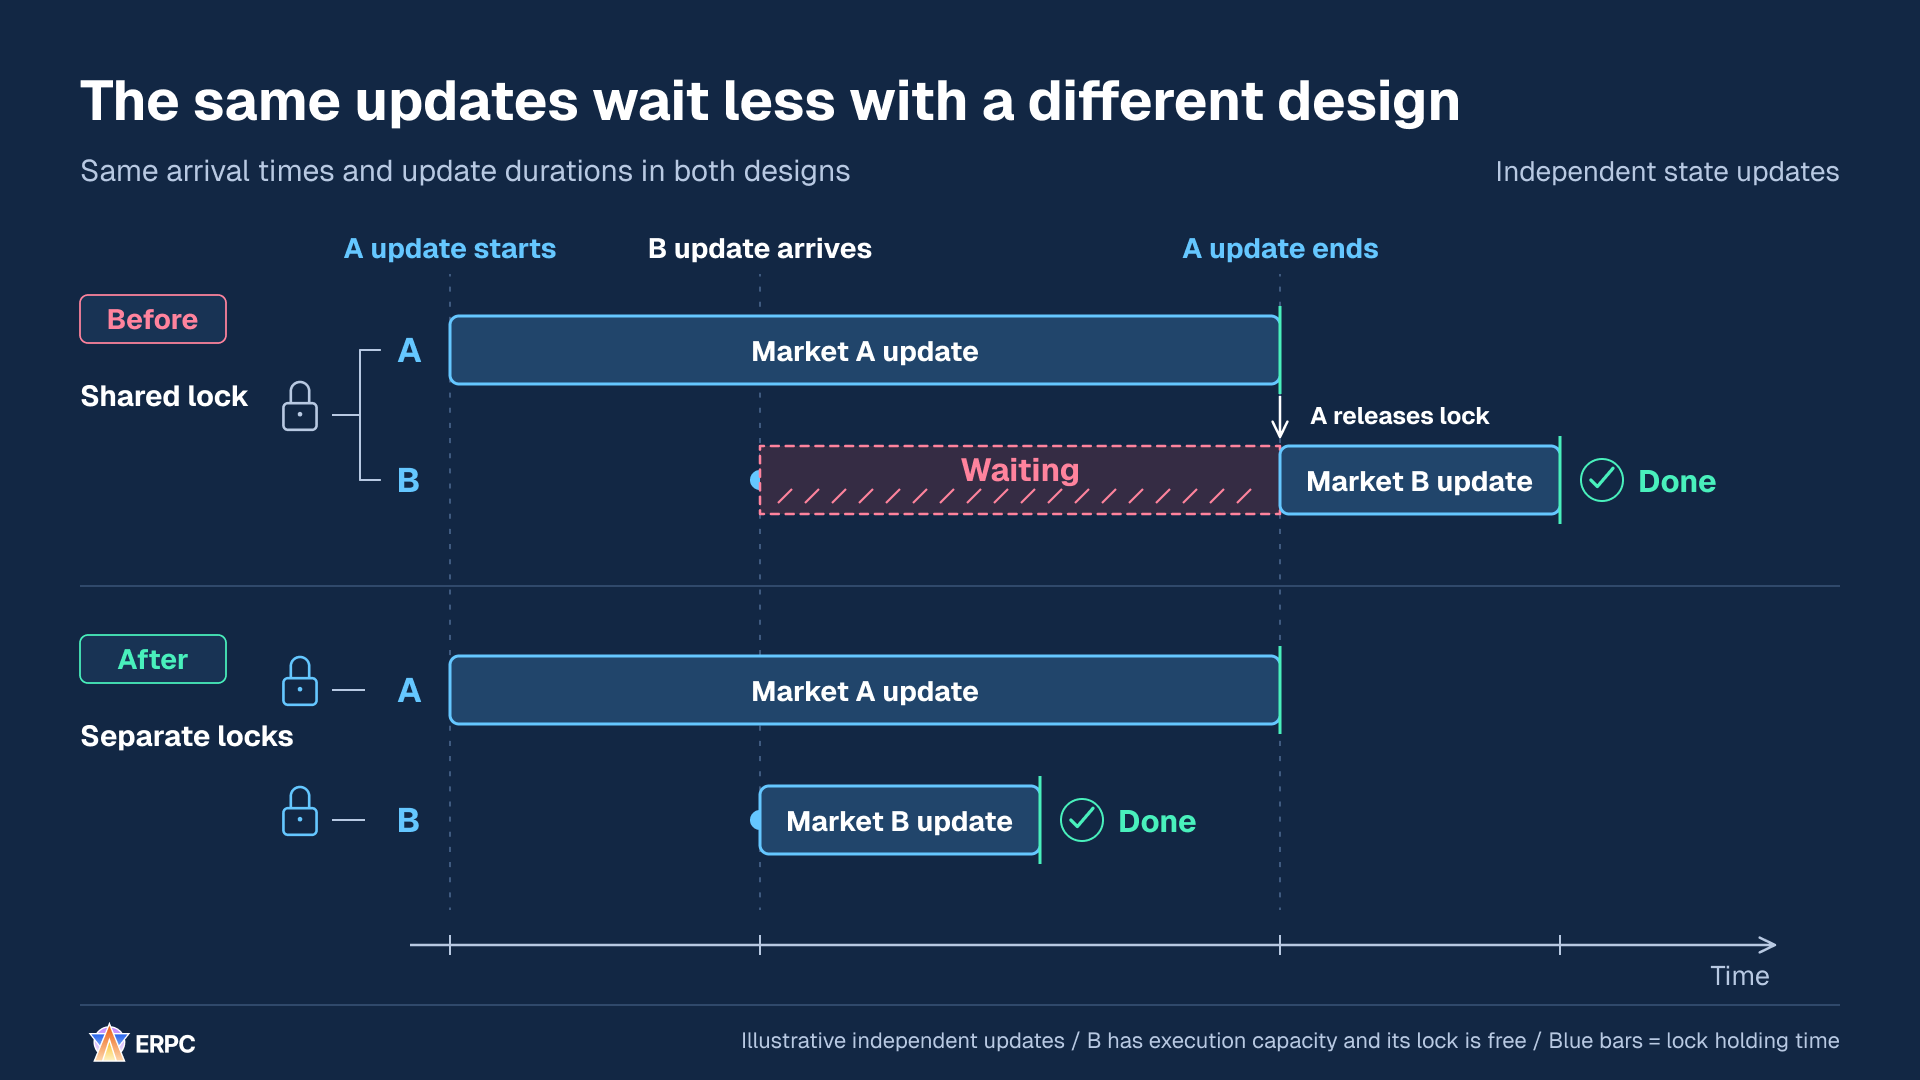
B की नीली पट्टी की लंबाई वही है। हटने वाला हिस्सा उससे पहले का गुलाबी इंतज़ार है।
नीली पट्टी लॉक लेने से उसे छोड़ने तक का समय दिखाती है। इस उदाहरण में B पूरा हो जाता है जबकि A अभी अपडेट हो रहा है। अलग लॉक उस इंतज़ार को नहीं हटाते जो B का अपना लॉक उपयोग में होने या उपलब्ध निष्पादन संसाधनों पर दूसरा काम चलने से होता है।
लॉक बाँटने से पहले तय करें कि कौन-से अपडेट स्वतंत्र हैं। A और B की कीमतें अलग-अलग अपडेट हो सकती हों, तब भी दोनों कीमतों या साझा बैलेंस का उपयोग करने वाले निर्णय को आवश्यक वैल्यू एक संगत तरीके से पढ़नी होंगी। किसी ऑपरेशन के await पर रुके होने के दौरान, उसी थ्रेड पर भी वैल्यू बदल सकती हैं। तय करें कि निर्णय कौन-से संस्करण पढ़ता है, उन्हें कैसे पढ़ता है और अपडेट किस क्रम में लागू होते हैं।
उदाहरण के लिए, यदि A और B एक ही बैलेंस पढ़कर अलग-अलग ऑर्डर बनाते हैं, तो दोनों एक ही धनराशि खर्च करने पर निर्भर हो सकते हैं। साझा वैल्यू को अभी भी अपनी सुरक्षा चाहिए। उदाहरण के तौर पर एक ही स्वामी हर ऑर्डर के लिए क्रम से बैलेंस जाँचकर धनराशि आरक्षित कर सकता है।
एक और विकल्प हर स्टेट को अपडेट करने का अधिकार एक ही स्वामी को देना और उसे अपडेट संदेश भेजना है। यही Single Writer सिद्धांत है। लॉक बाँटना और एक राइटर चुनना अलग डिज़ाइन निर्णय हैं। LMAX Disruptor, Single Writer और प्रोसेसिंग निर्भरताएँ समझाता है, जबकि Tokio एक समर्पित टास्क को संदेश भेजकर स्टेट प्रबंधित करना बताता है।[5][18]
स्वतंत्र स्टेट अपडेट के बीच लॉक का इंतज़ार घटाने के लिए ये निर्देश कॉपी करें।
text
इस एप्लिकेशन को वहाँ सुधारें, जहाँ किसी बाज़ार या key का अपडेट स्वतंत्र दूसरे अपडेट को उसी साझा लॉक के लिए इंतज़ार कराता है।

README, विकास निर्देश, निर्भरताएँ और स्टेट पढ़ने या लिखने, लॉक लेने या await से दूसरे काम की प्रतीक्षा करने वाला कोड पढ़ें। मौजूदा भाषा और रनटाइम का इस्तेमाल करें। पता लगाएँ कि हर मान कौन अपडेट करता है और हर निर्णय किन मानों के समूह को पढ़ता है।

1. गोपनीय जानकारी के बिना दोबारा चलाए जा सकने वाले इनपुट सहेजें और शुरुआती मान दर्ज करें। जिन लॉक पर प्रतिस्पर्धा होती है, उनके लिए हर key का आगमन, लॉक मिलने का इंतज़ार, लॉक पकड़े रखने की अवधि, अपडेट का क्रम और निर्णय में इस्तेमाल स्टेट के संस्करण दर्ज करें।
2. स्वतंत्र रूप से अपडेट हो सकने वाले मानों को उन मानों से अलग करें जिनकी संगति एक साथ सुरक्षित रखनी चाहिए। स्वतंत्र स्टेट के आसपास लॉक बाँटें और हर key का लागू करने का क्रम तथा लिखने की जिम्मेदारी स्पष्ट करें। लॉक या प्रोसेसिंग जिम्मेदारों की संख्या नियंत्रित रखें।
3. कई बाज़ारों को शामिल करने वाले निर्णयों तथा साझा बैलेंस या धन आरक्षण की रक्षा करें। बैलेंस जाँचना और धन आरक्षित करना एक समन्वित कार्य बनाएँ, ताकि कई ऑर्डर अलग-अलग यह न मान लें कि वही धन उपलब्ध है। कई लॉक चाहिए हों तो उन्हें लेने का क्रम तय करें।
4. await बिंदुओं के बीच स्टेट बदलाव और समानांतर डिकोडिंग में पूरा होने का क्रम जाँचें। तय करें कि निर्णय कौन-से संस्करण पढ़ता है और उन्हें कैसे पढ़ता है। डिकोडिंग पूरी होने का क्रम आवश्यक लागू करने के क्रम की जगह न लेने दें। लॉक बाँटने के बाद भी जाँचें कि निष्पादन संसाधनों की सीमाएँ या उसी key पर प्रतिस्पर्धा इंतज़ार पैदा कर रही है या नहीं।
5. समान इनपुट और आगमन क्रम को स्वतंत्र key, एक key पर केंद्रित अपडेट, साझा धन के लिए प्रतिस्पर्धी आरक्षण तथा रुके और फिर शुरू हुए काम के साथ दोहराएँ। लॉक का इंतज़ार, प्राप्ति से निर्णय पूरा होने तक p50/p95/p99, CPU और मेमोरी की तुलना करें। आवश्यक अपडेट क्रम, निर्णय में इस्तेमाल स्टेट की संगति और दोहरा धन आरक्षण न होने की जाँच करें। एक ही होस्ट में अवधि मापने के लिए मोनोटोनिक घड़ी इस्तेमाल करें और मापन की शुरुआत व अंत स्पष्ट करें।

मौजूदा स्वीकृतियाँ, अनुमतियाँ और विकास प्रक्रियाएँ बनाए रखें। केवल इन निर्देशों को production बदलने, सशुल्क अनुबंध करने या वास्तविक ट्रेड करने की अतिरिक्त अनुमति न मानें। निजी कुंजियाँ, क्रेडेंशियल या ग्राहक डेटा न दिखाएँ।

बदलाव, तुलना की परिस्थितियाँ, पहले और बाद के माप, सही काम करने की जाँच तथा बाकी सीमाएँ बताएँ। जिन मानों को मापना संभव न हो, उन्हें अमापित बताएँ।
इस एप्लिकेशन को वहाँ सुधारें, जहाँ किसी बाज़ार या key का अपडेट स्वतंत्र दूसरे अपडेट को उसी साझा लॉक के लिए इंतज़ार कराता है।
README, विकास निर्देश, निर्भरताएँ और स्टेट पढ़ने या लिखने, लॉक लेने या await से दूसरे काम की प्रतीक्षा करने वाला कोड पढ़ें। मौजूदा भाषा और रनटाइम का इस्तेमाल करें। पता लगाएँ कि हर मान कौन अपडेट करता है और हर निर्णय किन मानों के समूह को पढ़ता है।
1. गोपनीय जानकारी के बिना दोबारा चलाए जा सकने वाले इनपुट सहेजें और शुरुआती मान दर्ज करें। जिन लॉक पर प्रतिस्पर्धा होती है, उनके लिए हर key का आगमन, लॉक मिलने का इंतज़ार, लॉक पकड़े रखने की अवधि, अपडेट का क्रम और निर्णय में इस्तेमाल स्टेट के संस्करण दर्ज करें।
2. स्वतंत्र रूप से अपडेट हो सकने वाले मानों को उन मानों से अलग करें जिनकी संगति एक साथ सुरक्षित रखनी चाहिए। स्वतंत्र स्टेट के आसपास लॉक बाँटें और हर key का लागू करने का क्रम तथा लिखने की जिम्मेदारी स्पष्ट करें। लॉक या प्रोसेसिंग जिम्मेदारों की संख्या नियंत्रित रखें।
3. कई बाज़ारों को शामिल करने वाले निर्णयों तथा साझा बैलेंस या धन आरक्षण की रक्षा करें। बैलेंस जाँचना और धन आरक्षित करना एक समन्वित कार्य बनाएँ, ताकि कई ऑर्डर अलग-अलग यह न मान लें कि वही धन उपलब्ध है। कई लॉक चाहिए हों तो उन्हें लेने का क्रम तय करें।
4. await बिंदुओं के बीच स्टेट बदलाव और समानांतर डिकोडिंग में पूरा होने का क्रम जाँचें। तय करें कि निर्णय कौन-से संस्करण पढ़ता है और उन्हें कैसे पढ़ता है। डिकोडिंग पूरी होने का क्रम आवश्यक लागू करने के क्रम की जगह न लेने दें। लॉक बाँटने के बाद भी जाँचें कि निष्पादन संसाधनों की सीमाएँ या उसी key पर प्रतिस्पर्धा इंतज़ार पैदा कर रही है या नहीं।
5. समान इनपुट और आगमन क्रम को स्वतंत्र key, एक key पर केंद्रित अपडेट, साझा धन के लिए प्रतिस्पर्धी आरक्षण तथा रुके और फिर शुरू हुए काम के साथ दोहराएँ। लॉक का इंतज़ार, प्राप्ति से निर्णय पूरा होने तक p50/p95/p99, CPU और मेमोरी की तुलना करें। आवश्यक अपडेट क्रम, निर्णय में इस्तेमाल स्टेट की संगति और दोहरा धन आरक्षण न होने की जाँच करें। एक ही होस्ट में अवधि मापने के लिए मोनोटोनिक घड़ी इस्तेमाल करें और मापन की शुरुआत व अंत स्पष्ट करें।
मौजूदा स्वीकृतियाँ, अनुमतियाँ और विकास प्रक्रियाएँ बनाए रखें। केवल इन निर्देशों को production बदलने, सशुल्क अनुबंध करने या वास्तविक ट्रेड करने की अतिरिक्त अनुमति न मानें। निजी कुंजियाँ, क्रेडेंशियल या ग्राहक डेटा न दिखाएँ।
बदलाव, तुलना की परिस्थितियाँ, पहले और बाद के माप, सही काम करने की जाँच तथा बाकी सीमाएँ बताएँ। जिन मानों को मापना संभव न हो, उन्हें अमापित बताएँ।4. डेटा आने के बाद का काम घटाने के लिए न बदलने वाले हिस्से पहले तैयार करें
मान लें कि हर कीमत अपडेट पर एप्लिकेशन वही स्थिर ID पार्स करता है, समान इनपुट से वही स्थिर पता निकालता है और काम के लिए मेमोरी आवंटित करता है। इस कार्यशील मेमोरी को बफ़र भी कहते हैं। ये तीन तैयारियाँ दोहराने से न बदलने वाली जानकारी तैयार करने का समय हर निर्णय के पथ में जुड़ जाता है।
जिस तैयारी के इनपुट नहीं बदलते, उसे डेटा आने से पहले पूरा करके दोबारा उपयोग किया जा सकता है। डेटा आने के बाद एप्लिकेशन उस इवेंट के लिए बदली जानकारी की जाँच करता है, भेजा जाने वाला अंतिम संदेश बनाता है और उसी सामग्री पर सिग्नेचर करता है।
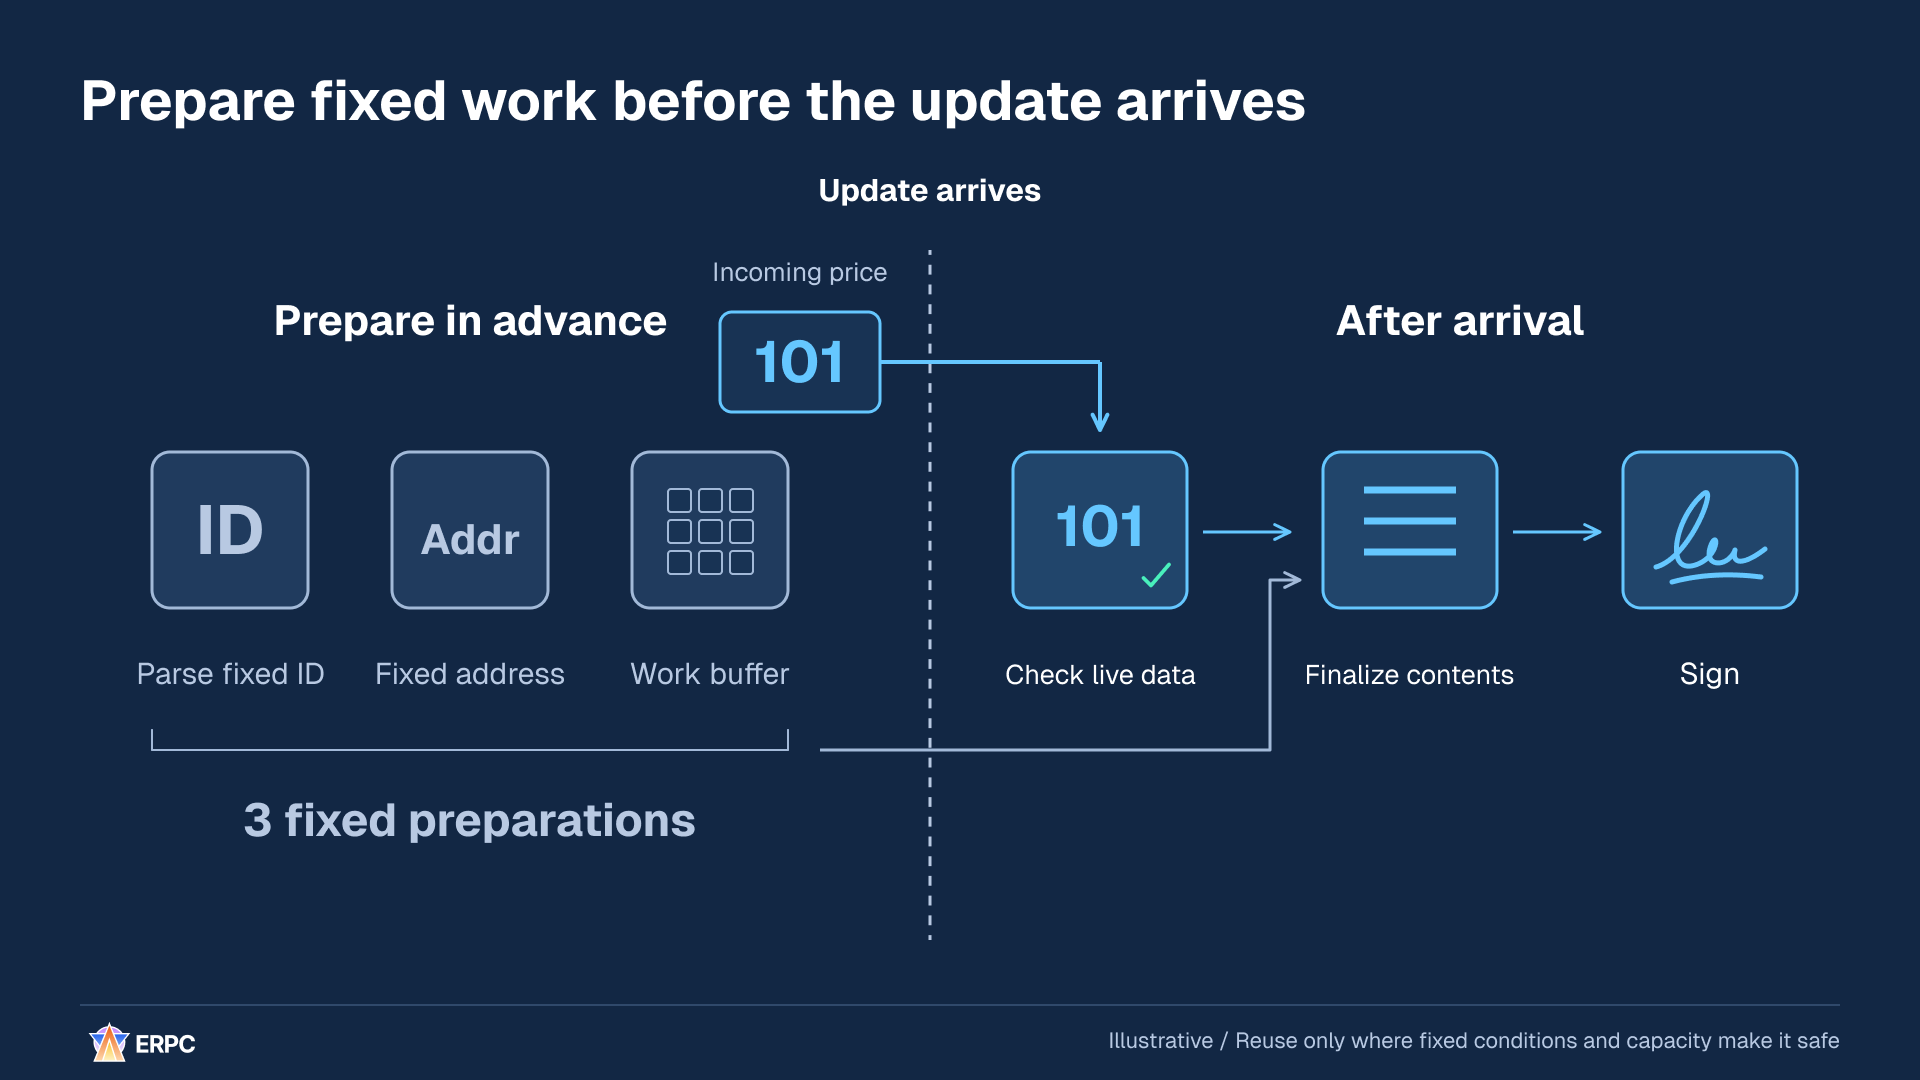
न बदलने वाली तैयारी पहले करें, लेकिन वर्तमान सामग्री की जाँच और सिग्नेचर डेटा आने के बाद ही रखें।
तीन अपडेट के लिए क्या बदलता है, इसे गिनें। हर इवेंट के लिए तीन तरह की तैयारी करने पर नौ तैयारी ऑपरेशन होते हैं। उन तीन प्रकारों की तैयारी एक बार करके क्रम से दोबारा उपयोग करने पर तीन ऑपरेशन होते हैं। दोनों डिज़ाइन में अब भी तीन इवेंट आते हैं, एक-एक करके प्रोसेस होते हैं और तीन आउटपुट बनते हैं।
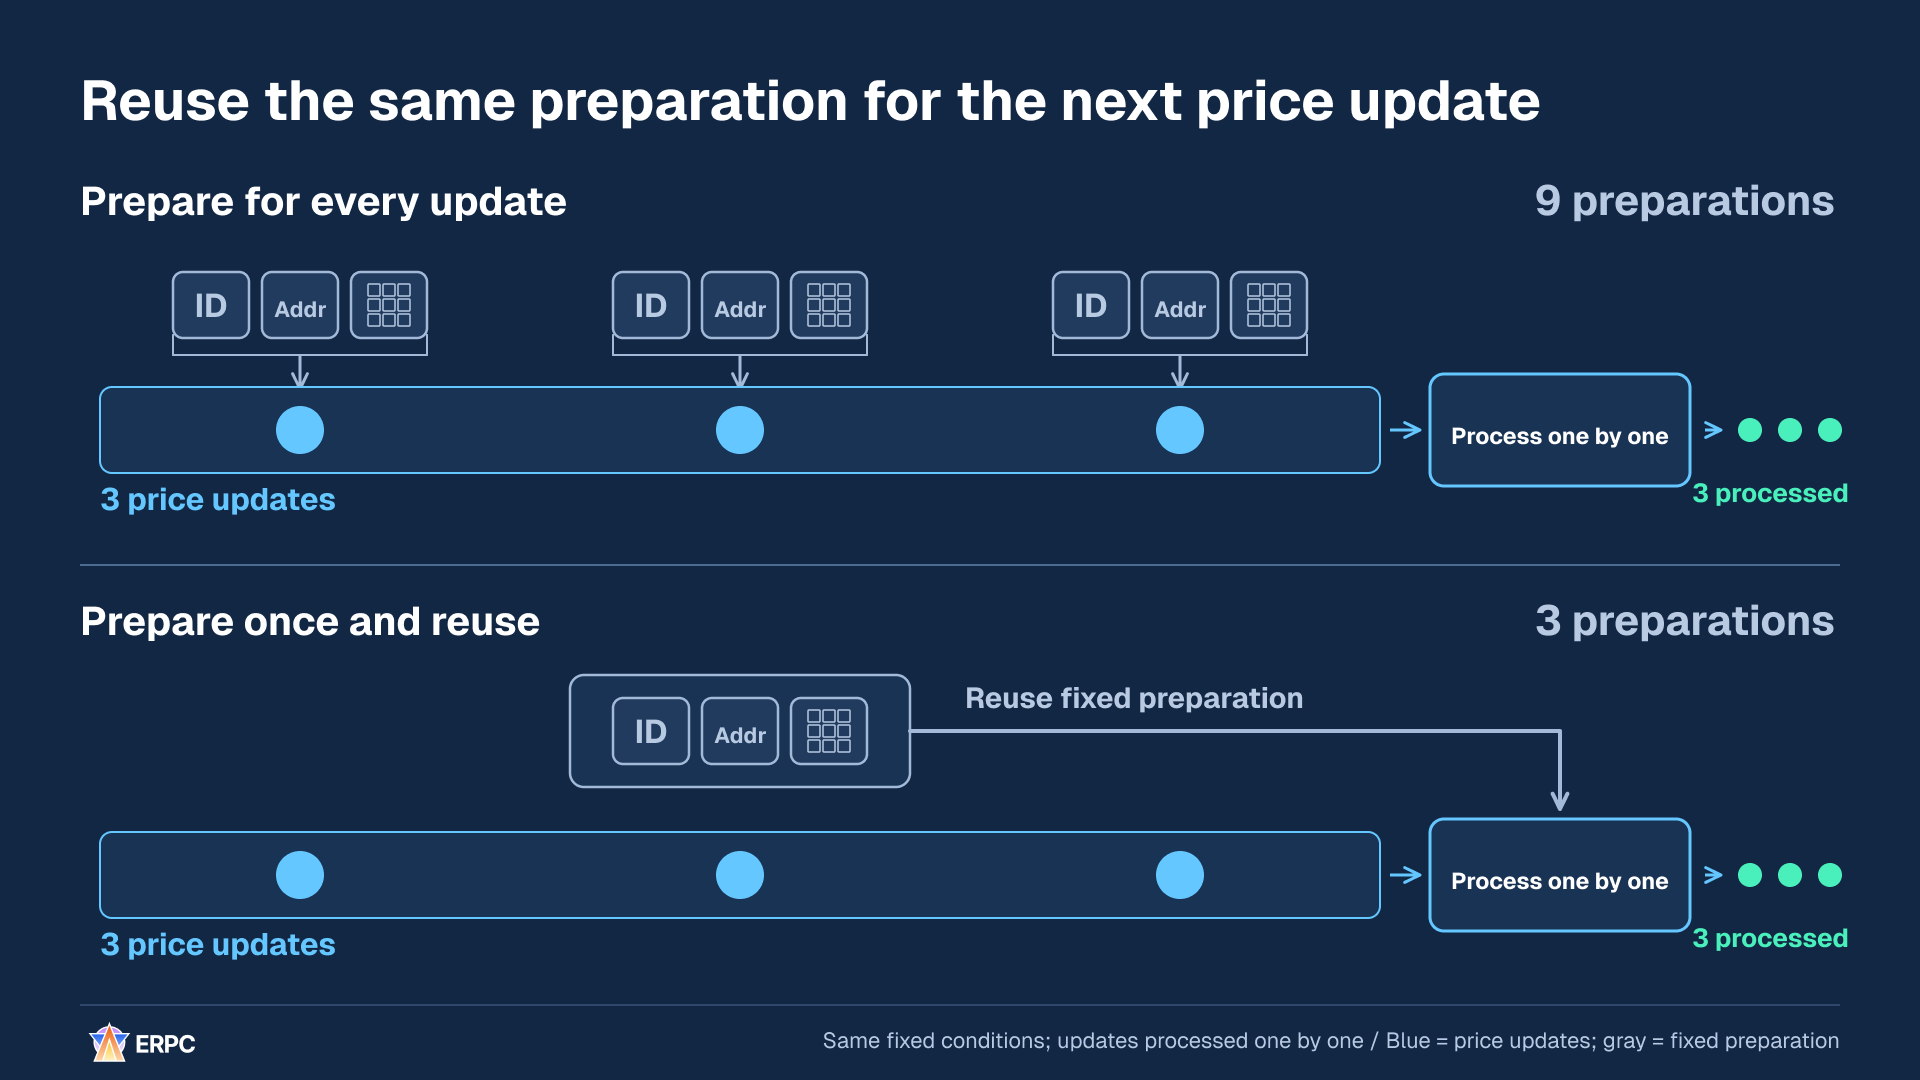
इवेंट की संख्या तीन बनी रहती है, जबकि इस उदाहरण में स्थिर तैयारी नौ ऑपरेशन से घटकर तीन होती है।
इस तुलना में माना गया है कि स्थिर शर्तें नहीं बदलतीं और कार्यशील मेमोरी को क्रम से सुरक्षित तरीके से दोबारा उपयोग किया जा सकता है। उसकी सामग्री हर बार वर्तमान इवेंट के लिए अपडेट होती है। यदि कई ऑपरेशन साथ चल रहे हों, तो हर एक के लिए अलग क्षेत्र या पहुँच प्रबंधित करने वाला पूल इस्तेमाल करें, ताकि वे एक ही मेमोरी को ओवरराइट न करें।
इसी उदाहरण को 1,000 इवेंट तक बढ़ाएँ। हर इवेंट के लिए तीन तरह की तैयारी करने पर 3,000 तैयारी ऑपरेशन होते हैं; साझा तैयारी एक बार करने पर तीन। दोनों डिज़ाइन 1,000 इवेंट प्राप्त करते हैं, एक-एक करके प्रोसेस करते हैं और 1,000 आउटपुट देते हैं। तैयारी की गिनती को प्रोसेस किए जा रहे इवेंट की संख्या से अलग रखें।
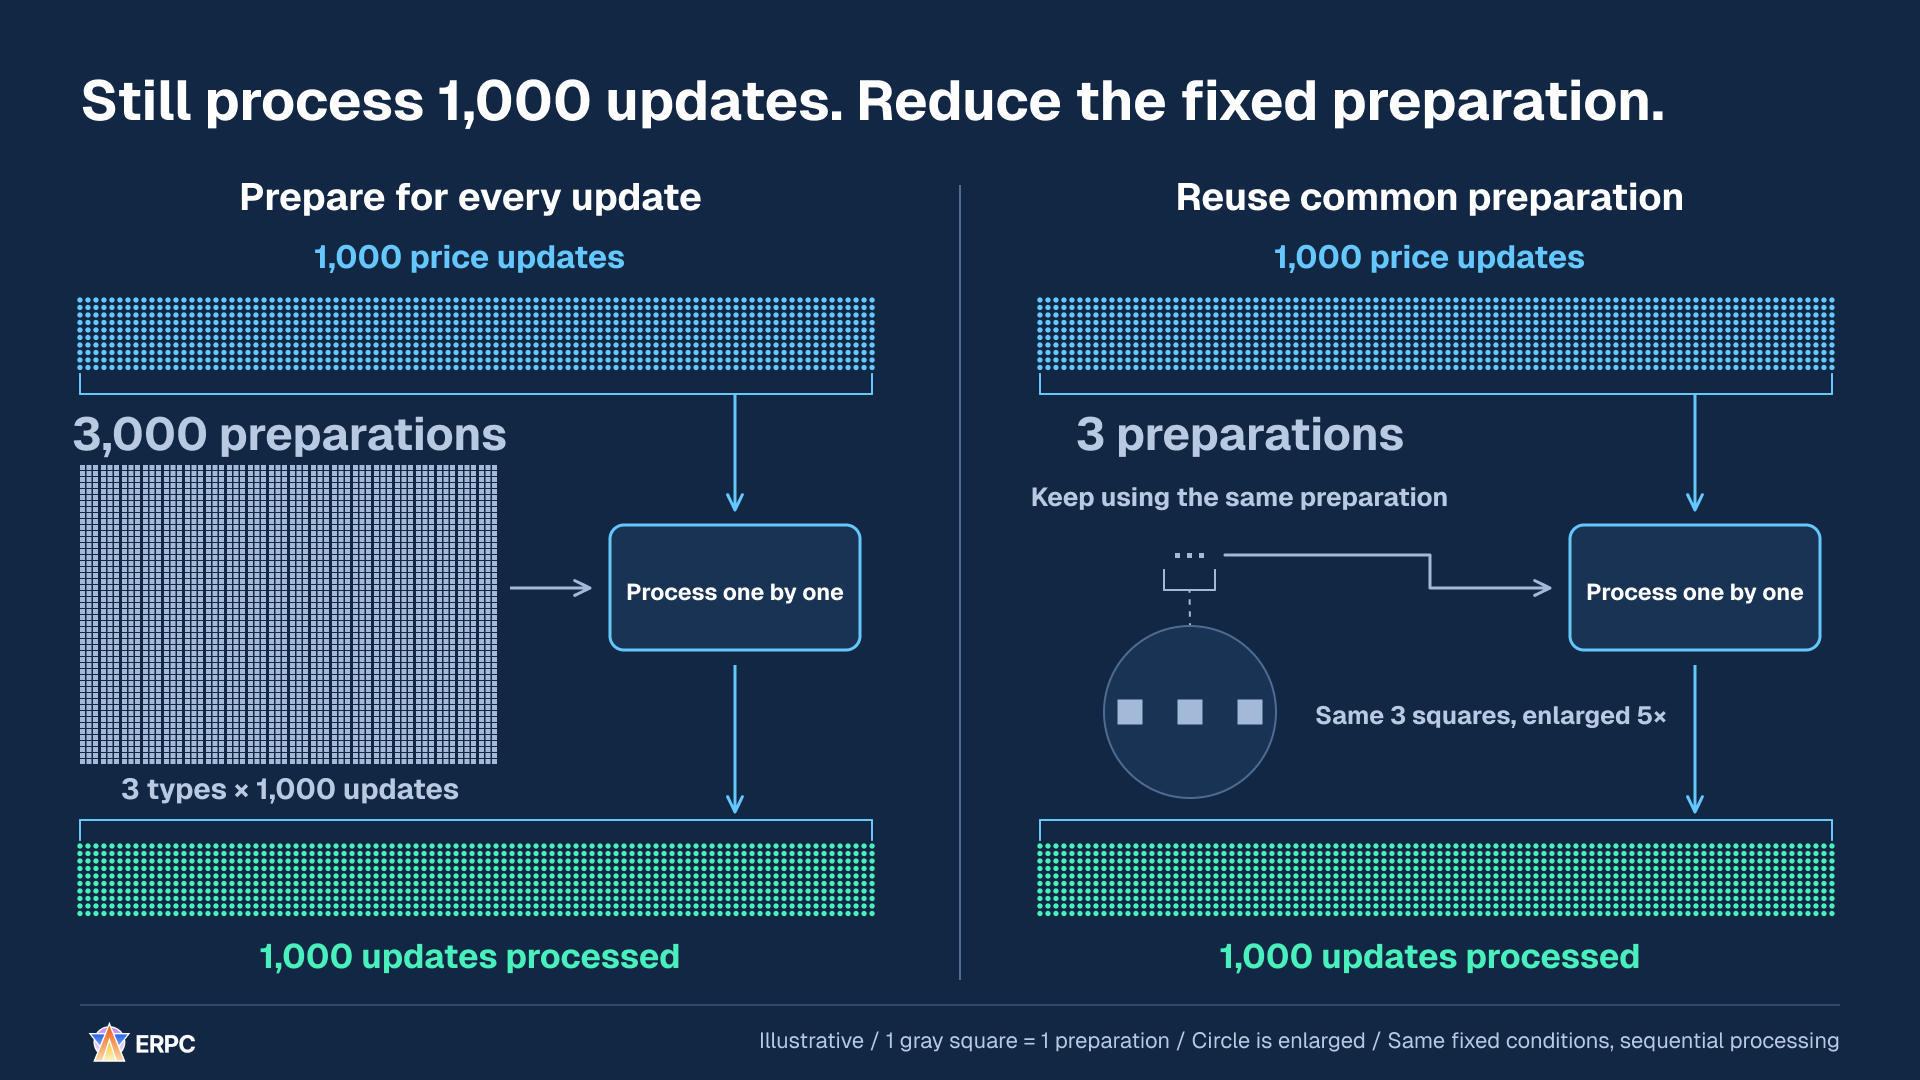
कम होने वाला काम बार-बार की स्थिर तैयारी है। सत्यापन, निर्णय, सिग्नेचर और अन्य काम अभी भी होते हैं, इसलिए इन गिनतियों का अनुपात पूरे एप्लिकेशन की गति में बढ़ोतरी नहीं है।
वे शर्तें तय करें जिनके अंतर्गत दोबारा उपयोग वैध रहता है। यदि स्थिर पता निकालने का कोई इनपुट बदले, तो पता फिर निकालना होगा। कीमतें, मात्राएँ, बैलेंस, संदर्भित अकाउंट की स्टेट, जोखिम सीमाएँ और blockhash, निर्णय में इस्तेमाल होने के समय वैध होने चाहिए। यदि एप्लिकेशन लगातार अपडेट होने वाली स्थानीय स्टेट रखता है, तो उसके संस्करण, ताज़गी और वैधता की जाँच करें। इसके लिए आवश्यक नहीं कि हर निर्णय पर सब कुछ RPC से दोबारा प्राप्त किया जाए।
Solana की getLatestBlockhash, blockhash और उसका lastValidBlockHeight लौटाती है। वैधता समाप्त होने की जाँच करते समय ब्लॉक की ऊँचाई और slot में अंतर रखें।[7] सिग्नेचर करने से पहले संदेश की सामग्री अंतिम करें। यदि सिग्नेचर के बाद संदेश बदलता है, तो अपडेट की गई सामग्री के लिए नए सिग्नेचर बनाएँ।[19]
स्थिर तैयारी का दोबारा उपयोग करके डेटा मिलने के बाद का काम घटाने के लिए ये निर्देश कॉपी करें।
text
हर इनपुट के लिए एक जैसी parsing, address derivation या मेमोरी allocation दोहराने वाला काम जाँचें और दोबारा इस्तेमाल हो सकने वाली तैयारी डेटा मिलने से पहले करें।

README, विकास निर्देश, निर्भरताएँ और प्राप्ति → तैयारी → निर्णय → संदेश बनाना → हस्ताक्षर का कोड पढ़ें। मौजूदा भाषा, रनटाइम और SDK का इस्तेमाल करें। हर तैयारी के इनपुट, आउटपुट, मालिक और वैधता अवधि की पहचान करें।

1. गोपनीय जानकारी के बिना दोबारा चलाए जा सकने वाले इनपुट सहेजें। घटना और आउटपुट की संख्या, हर तैयारी के चलने की संख्या और अवधि, आवंटित मेमोरी तथा प्राप्ति से निर्णय पूरा होने तक की अवधि दर्ज करें।
2. ऐसी तैयारी पहचानें जिसके इनपुट न बदलते हों, उसे initialization या किसी उपयुक्त पहले चरण में करें और परिणाम दोबारा इस्तेमाल करें। पुनः उपयोग की key, इनपुट या कॉन्फ़िगरेशन बदलने पर अमान्य करने और दोबारा गणना करने की प्रक्रिया तथा cache और buffer pool की सीमाएँ लागू करें।
3. पुनः इस्तेमाल वाली कामकाजी मेमोरी को वर्तमान इनपुट से अपडेट करें। एक साथ चलने वाले काम के लिए अलग क्षेत्र या प्रबंधित उधार का इस्तेमाल करें, ताकि उपयोग में मौजूद क्षेत्र पर दूसरी बार न लिखा जाए या उसे वापस न कर दिया जाए।
4. निर्णय की आवश्यकताओं के अनुसार कीमत, मात्रा, बैलेंस, अकाउंट स्टेट, जोखिम शर्तें और blockhash जाँचें। लगातार अपडेट होने वाला स्थानीय स्टेट इस्तेमाल करते समय संस्करण और ताज़गी जाँचें। Solana में blockhash की समाप्ति जाँचने के लिए lastValidBlockHeight इस्तेमाल करते समय block height और slot का अंतर बनाए रखें। हस्ताक्षर से पहले संदेश को अंतिम रूप दें और हस्ताक्षर के बाद सामग्री बदलने पर अपडेट किए गए संदेश पर दोबारा हस्ताक्षर करें।
5. समान इनपुट पर तैयारी की संख्या और अवधि, प्राप्ति से निर्णय पूरा होने तक p50/p95/p99, CPU और मेमोरी तथा आउटपुट की तुलना करें। बदले हुए इनपुट या कॉन्फ़िगरेशन, वैधता समाप्त होने और एक साथ निष्पादन की स्थितियाँ भी दोहराएँ, ताकि पुराने परिणामों के गलत पुनः उपयोग और मेमोरी टकराव की जाँच हो। तैयारी की संख्या का अनुपात पूरे एप्लिकेशन की गति बढ़ने का अनुपात न मानें। एक ही होस्ट में अवधि मापने के लिए मोनोटोनिक घड़ी इस्तेमाल करें और मापन की शुरुआत व अंत स्पष्ट करें।

मौजूदा स्वीकृतियाँ, अनुमतियाँ और विकास प्रक्रियाएँ बनाए रखें। केवल इन निर्देशों को production बदलने, सशुल्क अनुबंध करने या वास्तविक ट्रेड करने की अतिरिक्त अनुमति न मानें। निजी कुंजियाँ, क्रेडेंशियल या ग्राहक डेटा न दिखाएँ।

बदलाव, तुलना की परिस्थितियाँ, पहले और बाद के माप, सही काम करने की जाँच तथा बाकी सीमाएँ बताएँ। जिन मानों को मापना संभव न हो, उन्हें अमापित बताएँ।
हर इनपुट के लिए एक जैसी parsing, address derivation या मेमोरी allocation दोहराने वाला काम जाँचें और दोबारा इस्तेमाल हो सकने वाली तैयारी डेटा मिलने से पहले करें।
README, विकास निर्देश, निर्भरताएँ और प्राप्ति → तैयारी → निर्णय → संदेश बनाना → हस्ताक्षर का कोड पढ़ें। मौजूदा भाषा, रनटाइम और SDK का इस्तेमाल करें। हर तैयारी के इनपुट, आउटपुट, मालिक और वैधता अवधि की पहचान करें।
1. गोपनीय जानकारी के बिना दोबारा चलाए जा सकने वाले इनपुट सहेजें। घटना और आउटपुट की संख्या, हर तैयारी के चलने की संख्या और अवधि, आवंटित मेमोरी तथा प्राप्ति से निर्णय पूरा होने तक की अवधि दर्ज करें।
2. ऐसी तैयारी पहचानें जिसके इनपुट न बदलते हों, उसे initialization या किसी उपयुक्त पहले चरण में करें और परिणाम दोबारा इस्तेमाल करें। पुनः उपयोग की key, इनपुट या कॉन्फ़िगरेशन बदलने पर अमान्य करने और दोबारा गणना करने की प्रक्रिया तथा cache और buffer pool की सीमाएँ लागू करें।
3. पुनः इस्तेमाल वाली कामकाजी मेमोरी को वर्तमान इनपुट से अपडेट करें। एक साथ चलने वाले काम के लिए अलग क्षेत्र या प्रबंधित उधार का इस्तेमाल करें, ताकि उपयोग में मौजूद क्षेत्र पर दूसरी बार न लिखा जाए या उसे वापस न कर दिया जाए।
4. निर्णय की आवश्यकताओं के अनुसार कीमत, मात्रा, बैलेंस, अकाउंट स्टेट, जोखिम शर्तें और blockhash जाँचें। लगातार अपडेट होने वाला स्थानीय स्टेट इस्तेमाल करते समय संस्करण और ताज़गी जाँचें। Solana में blockhash की समाप्ति जाँचने के लिए lastValidBlockHeight इस्तेमाल करते समय block height और slot का अंतर बनाए रखें। हस्ताक्षर से पहले संदेश को अंतिम रूप दें और हस्ताक्षर के बाद सामग्री बदलने पर अपडेट किए गए संदेश पर दोबारा हस्ताक्षर करें।
5. समान इनपुट पर तैयारी की संख्या और अवधि, प्राप्ति से निर्णय पूरा होने तक p50/p95/p99, CPU और मेमोरी तथा आउटपुट की तुलना करें। बदले हुए इनपुट या कॉन्फ़िगरेशन, वैधता समाप्त होने और एक साथ निष्पादन की स्थितियाँ भी दोहराएँ, ताकि पुराने परिणामों के गलत पुनः उपयोग और मेमोरी टकराव की जाँच हो। तैयारी की संख्या का अनुपात पूरे एप्लिकेशन की गति बढ़ने का अनुपात न मानें। एक ही होस्ट में अवधि मापने के लिए मोनोटोनिक घड़ी इस्तेमाल करें और मापन की शुरुआत व अंत स्पष्ट करें।
मौजूदा स्वीकृतियाँ, अनुमतियाँ और विकास प्रक्रियाएँ बनाए रखें। केवल इन निर्देशों को production बदलने, सशुल्क अनुबंध करने या वास्तविक ट्रेड करने की अतिरिक्त अनुमति न मानें। निजी कुंजियाँ, क्रेडेंशियल या ग्राहक डेटा न दिखाएँ।
बदलाव, तुलना की परिस्थितियाँ, पहले और बाद के माप, सही काम करने की जाँच तथा बाकी सीमाएँ बताएँ। जिन मानों को मापना संभव न हो, उन्हें अमापित बताएँ।5. आवश्यक अपडेट छूटने के बाद निर्णय लेना जारी न रखें
एक ही एसेट के दो बाज़ार लें, जहाँ एप्लिकेशन कीमत का अंतर B−A निकालता है। कनेक्शन टूटने के दौरान बाज़ार A की कीमत 100 से 105 हो जाती है और एप्लिकेशन यह अपडेट खो देता है। यदि फिर जुड़ने के बाद उसे केवल B की कीमत 104 मिलती है, तो वह 104−100, यानी +4 निकालता है। A की अपडेट की हुई वैल्यू लेने पर 104−105, यानी -1 मिलता है। चिह्न तक बदल जाता है।
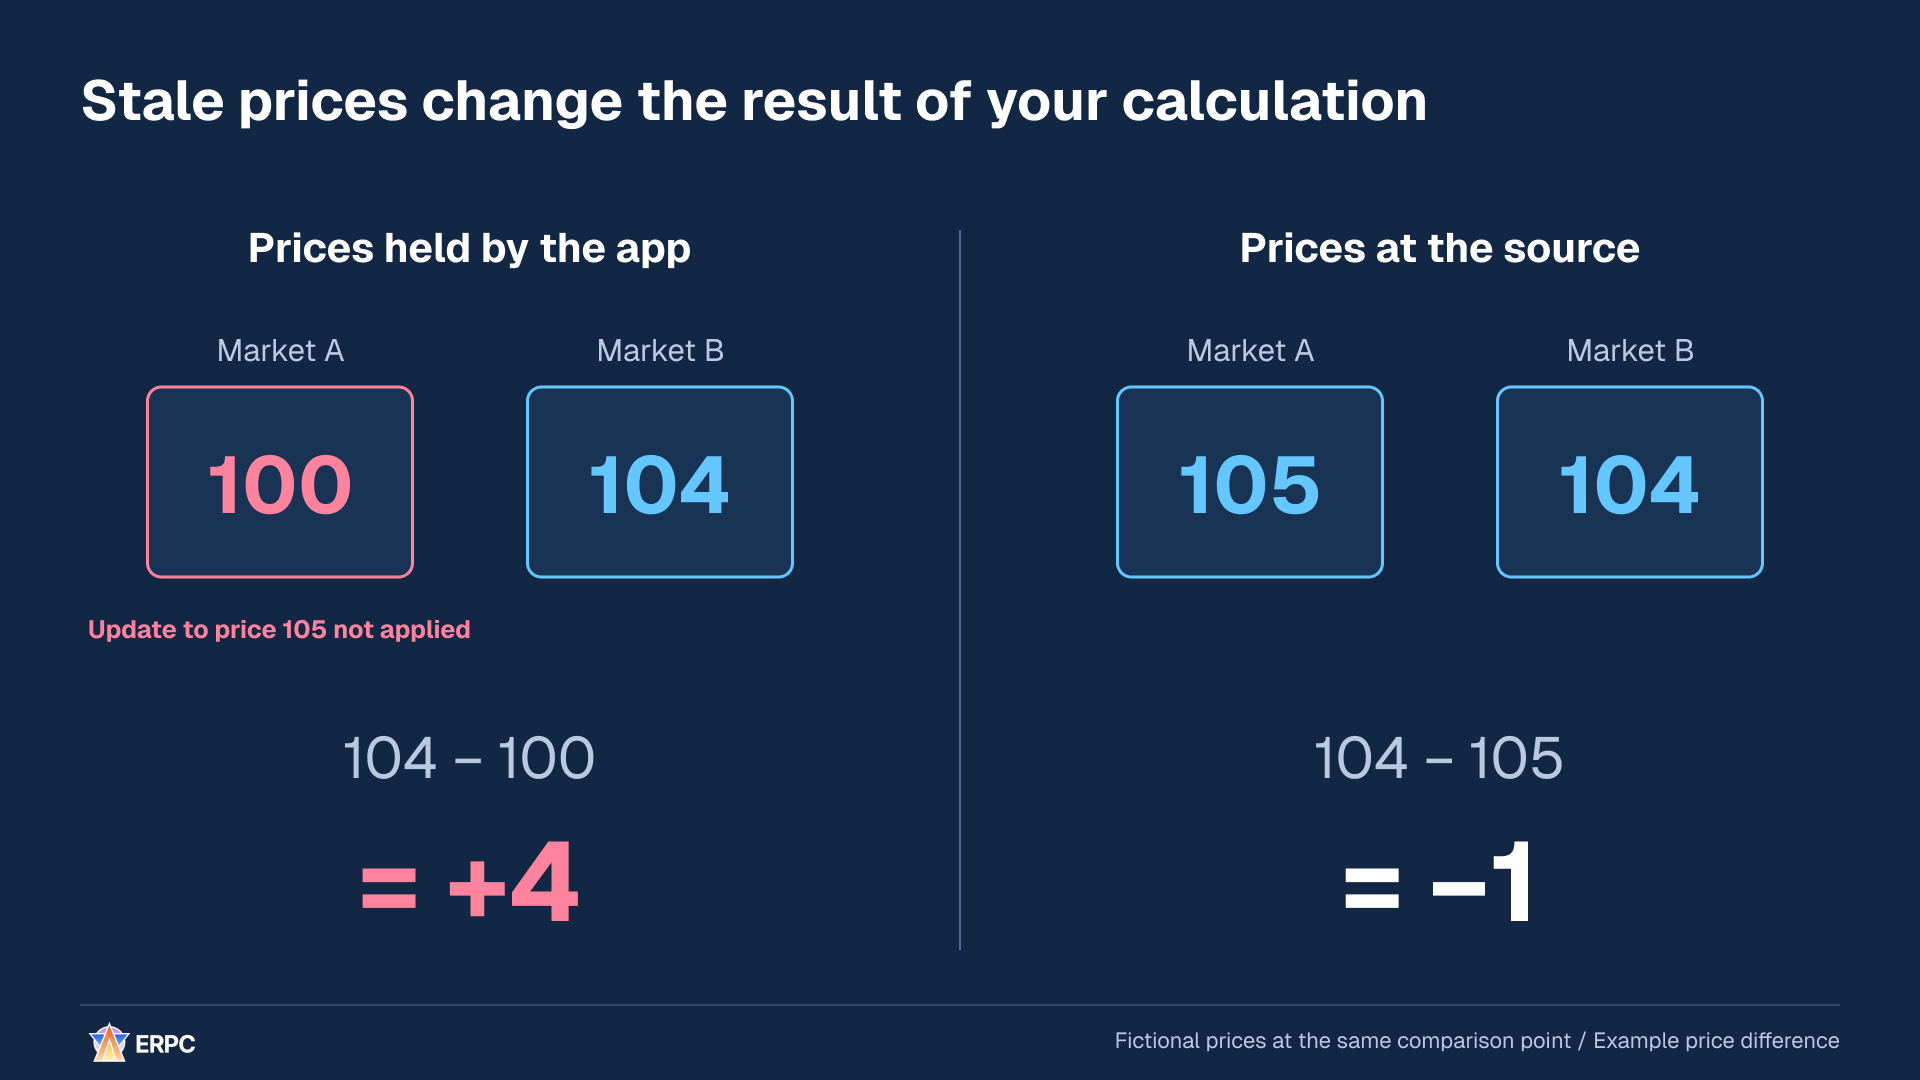
एक ही गणना का परिणाम इस बात से बदल जाता है कि A की पुरानी वैल्यू 100 इस्तेमाल हुई या अपडेट की हुई वैल्यू 105।
यह मॉडल सिर्फ़ कीमत का अंतर दिखाता है। इसमें शुल्क, निष्पादन की शर्तें और दूसरे कारक शामिल नहीं हैं, और यह ट्रेडिंग मुनाफ़ा नहीं दर्शाता। बात यह है कि कनेक्शन लौटने से निर्णय के लिए ज़रूरी सभी अपडेट अनिवार्य रूप से वापस नहीं आते।
इस उदाहरण में A और B की कीमतों का उपयोग करने वाले नए ट्रेडिंग निर्णय रोकें, फिर A की पुरानी वैल्यू 100 को वापस प्राप्त हुई वैल्यू 105 से बदलें। इसके बाद सत्यापित करें कि निर्णय के लिए आवश्यक अपडेट A और B पर लागू हो गए हैं, और ज़रूरी क्रम तथा ताज़गी की शर्तें पूरी हैं। आवश्यक जाँच पूरी होने पर ही दोबारा शुरू करें; यदि वे पूरी नहीं हो सकतीं, तो निर्णय रोके रखें।
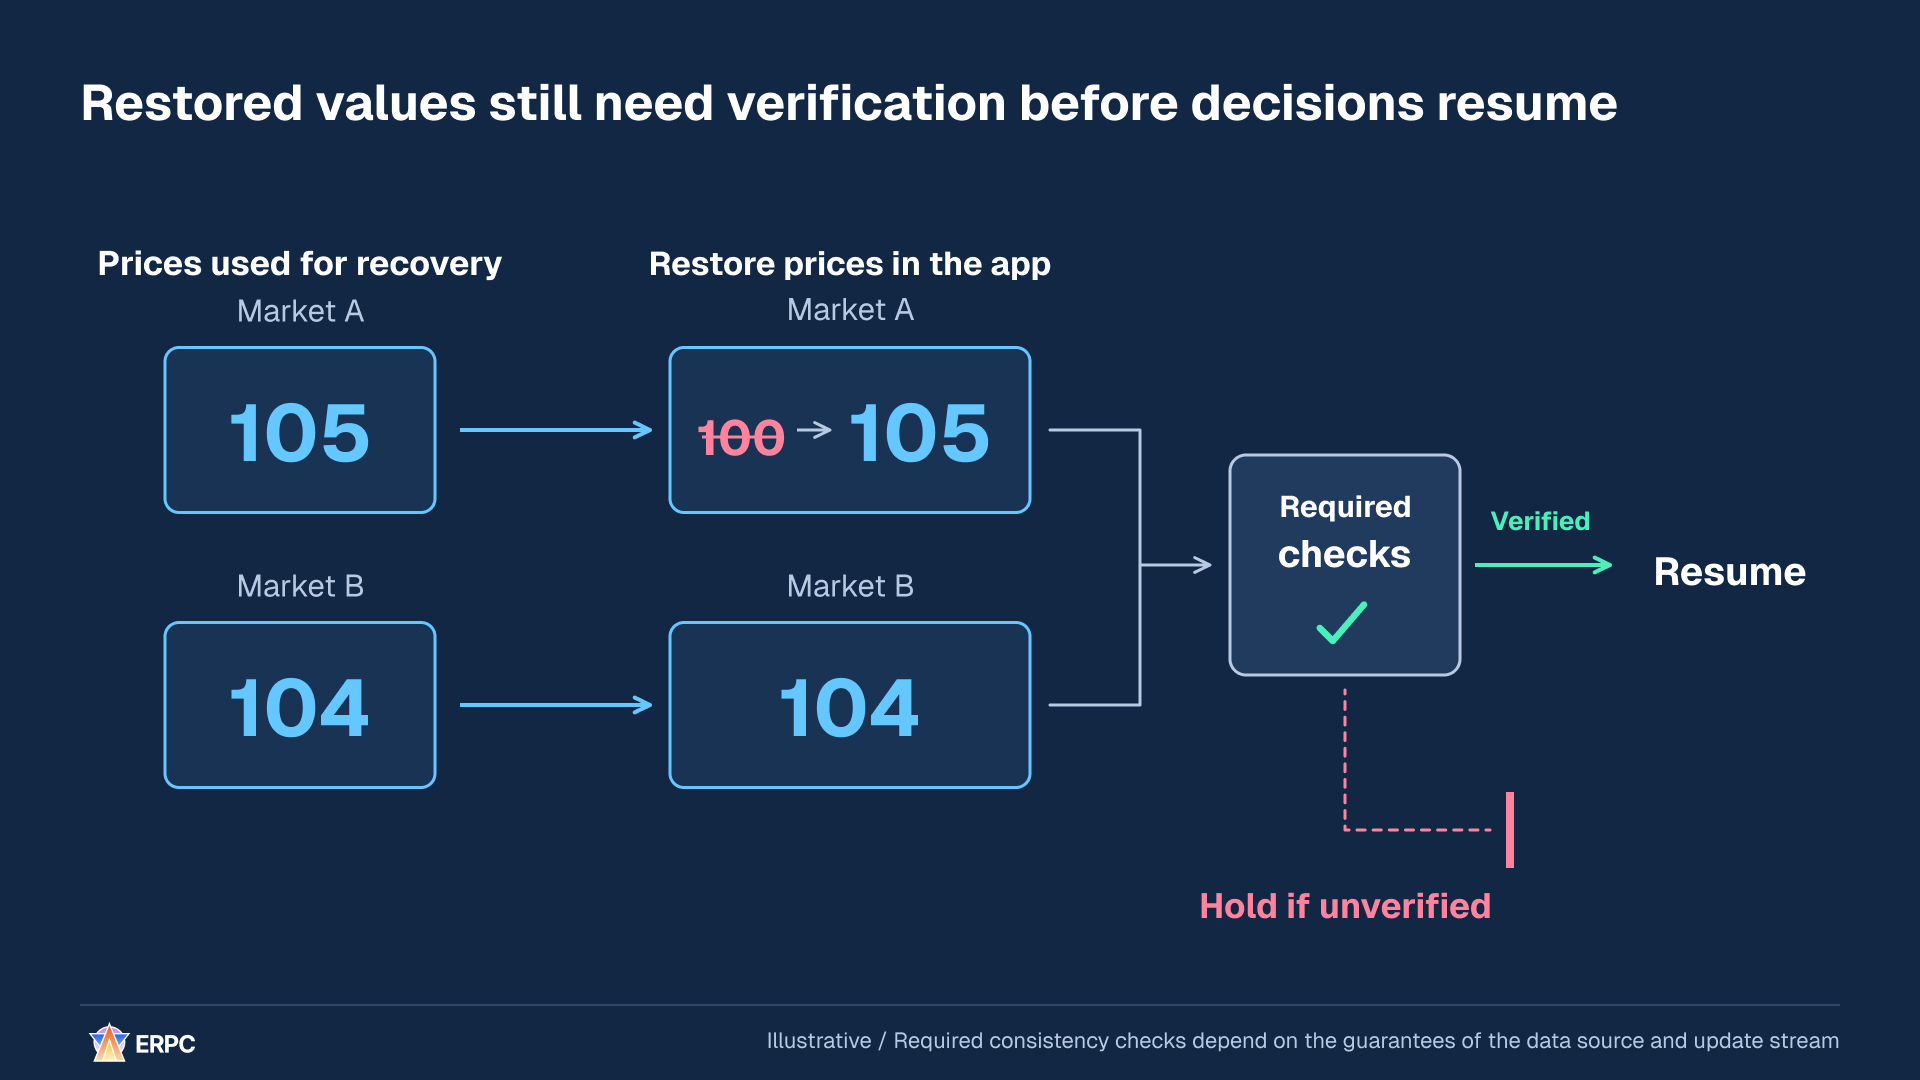
वैल्यू अपडेट करने को इस सत्यापन से अलग रखें कि वे निर्णय के लिए उपयोग की जा सकती हैं।
रिकवरी का एक सामान्य तरीका snapshot है, यानी किसी विशेष बिंदु की स्टेट का संग्रह। उसे लगातार आने वाले अपडेट के प्रवाह से जोड़ते समय तय करें कि कौन-से अपडेट snapshot में पहले से शामिल हैं और उसके बाद के कौन-से अपडेट लागू करने हैं। इससे पहले से शामिल बदलाव दो बार लागू होने या सीमा पर कोई अपडेट खो जाने से बचता है। विशिष्ट तरीका चुने हुए API की सब्सक्रिप्शन शुरुआत, पहचान, दोबारा प्राप्ति और रीप्ले संबंधी गारंटी के अनुसार होना चाहिए।
Yellowstone संदेशों में slot और write_version जैसे फ़ील्ड होते हैं।[16] केवल उनकी मौजूदगी को अलग प्रदाताओं में उपयोग किए जा सकने वाले क्रम या सभी अंतरालों का पता लगाने की गारंटी नहीं मानना चाहिए। slot के अंतर को सीधे छूटे अपडेट की संख्या या लेटेंसी के सेकंड में न बदलें। सत्यापित करें कि चुने हुए प्रदाता की गारंटी के अनुसार स्टेट दोबारा जोड़ी गई है।
रिकवरी से पहले शुरू हुई गणनाओं को भी ध्यान में रखें। पुरानी स्टेट पर शुरू हुआ ऑपरेशन यदि रिकवरी के बाद पूरा होता है, तो उसका परिणाम नई स्टेट को ओवरराइट कर सकता है। एक तरीका रिकवरी के दौरान स्टेट को पीढ़ी संख्या देना और पुरानी पीढ़ी के परिणाम अस्वीकार करना है। यदि आप processed स्टेट उपयोग करते हैं, तो ऐसे rollback को भी स्टेट की दोबारा जाँच की शर्त में रखें, जिनमें उस स्टेट को अब स्वीकार नहीं किया जाता।[6]
दोबारा कनेक्ट होने के बाद निर्णय फिर शुरू करने से पहले सही स्टेट बहाल करने के लिए ये निर्देश कॉपी करें।
text
इस एप्लिकेशन को केवल कनेक्शन लौट आने के कारण पुराने स्टेट पर ट्रेडिंग निर्णय फिर शुरू करने से रोकें। निर्णय दोबारा शुरू होने से पहले आवश्यक स्टेट की रिकवरी लागू करें।

README, विकास निर्देश, निर्भरताएँ और subscription, शुरुआती fetch, अपडेट लागू करने, दोबारा कनेक्ट करने तथा निर्णय का कोड पढ़ें। मौजूदा भाषा, रनटाइम और SDK का इस्तेमाल करें। प्रदाता, commitment, अपडेट का अर्थ और क्रम, पहचान, दोबारा fetch तथा replay की वास्तविक गारंटियाँ जाँचें।

1. कनेक्शन की स्थिति, डेटा की वैधता और निर्णय फिर शुरू करने की अनुमति को अलग रखें। आवश्यक अपडेट छूटने या पर्याप्त ताज़गी न होने की पुष्टि हो तो उस स्टेट पर निर्भर नए ट्रेडिंग निर्णय रोकें, जबकि आवश्यक डेटा प्राप्ति, अपडेट और रिकवरी जारी रहें।
2. snapshot इस्तेमाल करते समय प्रदाता की गारंटियों से तय करें कि उसमें कौन-से अपडेट शामिल हैं और उसके बाद के stream से उसकी सीमा कहाँ है। delta को दो बार लागू होने, सीमा पर अंतराल रहने और गलत लागू करने के क्रम से बचाएँ। इन गारंटियों की कमी को मान्यताओं से न भरें। slot या write_version को छूटे अपडेट पहचानने वाला बिना शर्त क्रम न मानें।
3. केवल मान fetch हो जाने से निर्णय फिर शुरू न करें। प्रभावित निर्णयों के लिए आवश्यक अपडेट, क्रम, ताज़गी और संगति की जाँच लागू करें और जब तक जाँच पूरी न हो सके, निर्णय रोककर रखें। generation या समान व्यवस्था से पुराने गणना परिणाम या ऑर्डर प्रस्ताव लागू या भेजे जाने से रोकें, यदि रिकवरी से पहले शुरू हुआ काम बाद में पूरा हो। फिर शुरू करते समय सत्यापित स्टेट से नए निर्णय लें। processed स्टेट इस्तेमाल हो तो rollback के बाद अमान्य करने और रिकवरी की व्यवस्था रखें।
4. गोपनीय जानकारी रहित दोबारा चलाए जा सकने वाले इनपुट से कनेक्शन टूटने के दौरान छूटे अपडेट, डुप्लिकेट, बदले क्रम के अपडेट, पुराने डेटा, बार-बार reconnect और पुरानी generation के काम के बाद में पूरा होने की स्थितियाँ दोहराएँ। जाँचें कि कनेक्शन लौटने से सत्यापन पूरा होने तक निर्णय रुके रहें और सत्यापित स्टेट अपेक्षित परिणाम से मेल खाए।
5. रिकवरी समय, अमान्य स्टेट के कारण रोके गए निर्णय प्रयासों की संख्या और विराम की अवधि, दोबारा लागू या बाहर रखे गए अपडेट, सामान्य प्राप्ति से निर्णय पूरा होने की अवधि, CPU और मेमोरी दर्ज करें। विराम वाले समय या छूटे अपडेट को मापन से चुपचाप बाहर न करें। मापन की सीमाएँ और क्या पहचाना जा सकता है तथा क्या नहीं, यह बताएँ। एक ही होस्ट में अवधि मापने के लिए मोनोटोनिक घड़ी इस्तेमाल करें।

मौजूदा स्वीकृतियाँ, अनुमतियाँ और विकास प्रक्रियाएँ बनाए रखें। केवल इन निर्देशों को production बदलने, सशुल्क अनुबंध करने या वास्तविक ट्रेड करने की अतिरिक्त अनुमति न मानें। निजी कुंजियाँ, क्रेडेंशियल या ग्राहक डेटा न दिखाएँ।

बदलाव, तुलना की परिस्थितियाँ, पहले और बाद के माप, सही काम करने की जाँच तथा बाकी सीमाएँ बताएँ। जिन मानों को मापना संभव न हो, उन्हें अमापित बताएँ।
इस एप्लिकेशन को केवल कनेक्शन लौट आने के कारण पुराने स्टेट पर ट्रेडिंग निर्णय फिर शुरू करने से रोकें। निर्णय दोबारा शुरू होने से पहले आवश्यक स्टेट की रिकवरी लागू करें।
README, विकास निर्देश, निर्भरताएँ और subscription, शुरुआती fetch, अपडेट लागू करने, दोबारा कनेक्ट करने तथा निर्णय का कोड पढ़ें। मौजूदा भाषा, रनटाइम और SDK का इस्तेमाल करें। प्रदाता, commitment, अपडेट का अर्थ और क्रम, पहचान, दोबारा fetch तथा replay की वास्तविक गारंटियाँ जाँचें।
1. कनेक्शन की स्थिति, डेटा की वैधता और निर्णय फिर शुरू करने की अनुमति को अलग रखें। आवश्यक अपडेट छूटने या पर्याप्त ताज़गी न होने की पुष्टि हो तो उस स्टेट पर निर्भर नए ट्रेडिंग निर्णय रोकें, जबकि आवश्यक डेटा प्राप्ति, अपडेट और रिकवरी जारी रहें।
2. snapshot इस्तेमाल करते समय प्रदाता की गारंटियों से तय करें कि उसमें कौन-से अपडेट शामिल हैं और उसके बाद के stream से उसकी सीमा कहाँ है। delta को दो बार लागू होने, सीमा पर अंतराल रहने और गलत लागू करने के क्रम से बचाएँ। इन गारंटियों की कमी को मान्यताओं से न भरें। slot या write_version को छूटे अपडेट पहचानने वाला बिना शर्त क्रम न मानें।
3. केवल मान fetch हो जाने से निर्णय फिर शुरू न करें। प्रभावित निर्णयों के लिए आवश्यक अपडेट, क्रम, ताज़गी और संगति की जाँच लागू करें और जब तक जाँच पूरी न हो सके, निर्णय रोककर रखें। generation या समान व्यवस्था से पुराने गणना परिणाम या ऑर्डर प्रस्ताव लागू या भेजे जाने से रोकें, यदि रिकवरी से पहले शुरू हुआ काम बाद में पूरा हो। फिर शुरू करते समय सत्यापित स्टेट से नए निर्णय लें। processed स्टेट इस्तेमाल हो तो rollback के बाद अमान्य करने और रिकवरी की व्यवस्था रखें।
4. गोपनीय जानकारी रहित दोबारा चलाए जा सकने वाले इनपुट से कनेक्शन टूटने के दौरान छूटे अपडेट, डुप्लिकेट, बदले क्रम के अपडेट, पुराने डेटा, बार-बार reconnect और पुरानी generation के काम के बाद में पूरा होने की स्थितियाँ दोहराएँ। जाँचें कि कनेक्शन लौटने से सत्यापन पूरा होने तक निर्णय रुके रहें और सत्यापित स्टेट अपेक्षित परिणाम से मेल खाए।
5. रिकवरी समय, अमान्य स्टेट के कारण रोके गए निर्णय प्रयासों की संख्या और विराम की अवधि, दोबारा लागू या बाहर रखे गए अपडेट, सामान्य प्राप्ति से निर्णय पूरा होने की अवधि, CPU और मेमोरी दर्ज करें। विराम वाले समय या छूटे अपडेट को मापन से चुपचाप बाहर न करें। मापन की सीमाएँ और क्या पहचाना जा सकता है तथा क्या नहीं, यह बताएँ। एक ही होस्ट में अवधि मापने के लिए मोनोटोनिक घड़ी इस्तेमाल करें।
मौजूदा स्वीकृतियाँ, अनुमतियाँ और विकास प्रक्रियाएँ बनाए रखें। केवल इन निर्देशों को production बदलने, सशुल्क अनुबंध करने या वास्तविक ट्रेड करने की अतिरिक्त अनुमति न मानें। निजी कुंजियाँ, क्रेडेंशियल या ग्राहक डेटा न दिखाएँ।
बदलाव, तुलना की परिस्थितियाँ, पहले और बाद के माप, सही काम करने की जाँच तथा बाकी सीमाएँ बताएँ। जिन मानों को मापना संभव न हो, उन्हें अमापित बताएँ।छह पहलुओं पर भाषाओं की खूबियों की तुलना करें
इन पाँच डिज़ाइन को लागू करने के लिए तय करना पड़ता है कि डेटा कौन अपडेट करता है, मेमोरी कहाँ आवंटित होती है, क्या कॉपी होता है और कौन-सी क्रियाएँ इंतज़ार करती हैं। तेज़ गणना, अचानक होने वाले विलंब पर नियंत्रण और जल्दी प्रोटोटाइप बनाना अलग-अलग खूबियाँ हैं। भाषाओं की तुलना उस हिस्से के अनुसार करें जिसे आप सुधारना चाहते हैं।
प्रकाशित बेंचमार्क में निष्पादन समय की तुलना करें
1 अगस्त 2025 के ये प्रकाशित माप पाँच पिंडों की गणना को 5 लाख चरणों तक चलाते हैं। औसत निष्पादन समय का अर्थ है प्रोग्राम शुरू होने से पूरा होने तक लगने वाले समय का औसत। इसमें शुरुआत और निष्पादन के दौरान कोड का अनुकूलन शामिल है, लेकिन पहले से किया गया बिल्ड शामिल नहीं है। 1,000 ms एक सेकंड के बराबर है।[27][29]
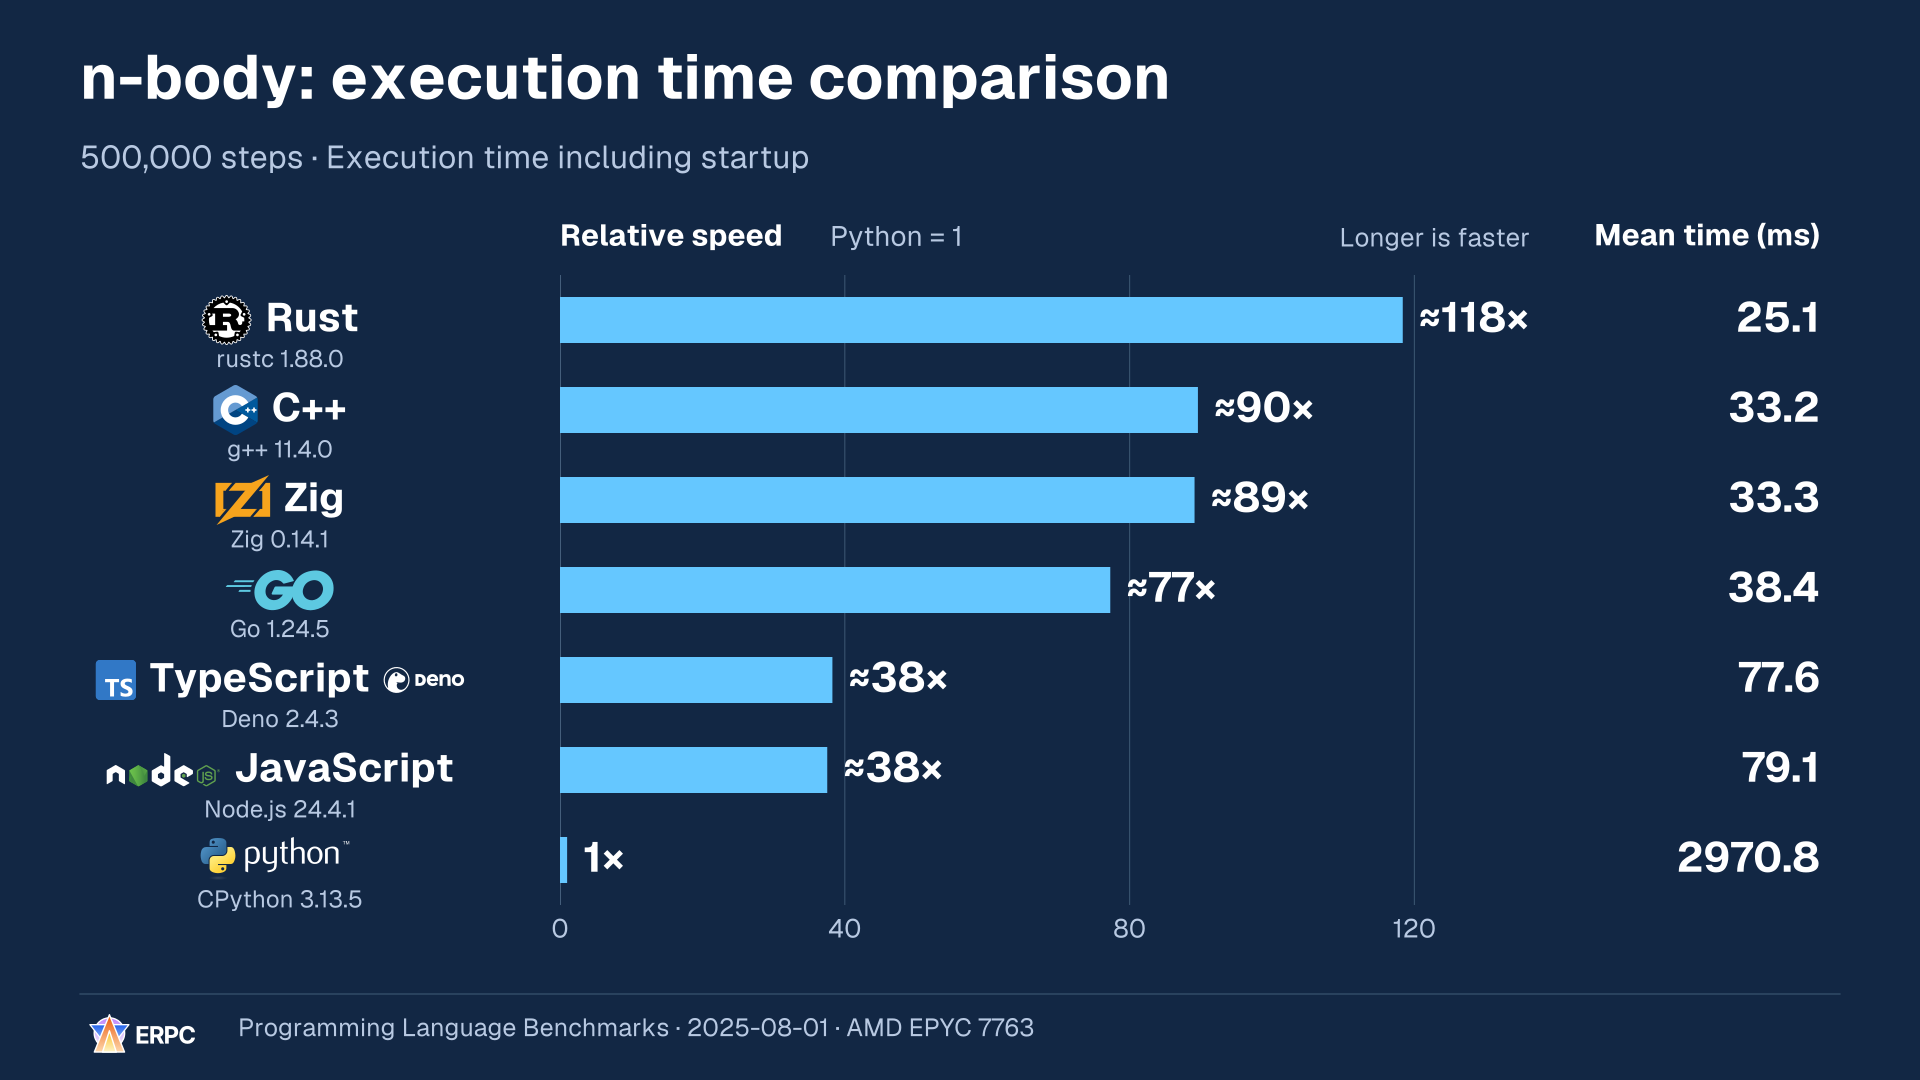
| भाषा / रनटाइम | औसत निष्पादन समय | सापेक्ष गति (Python = 1) |
|---|---|---|
| Rust / rustc 1.88.0 | 25.1 ms | ≈118 |
| C++ / g++ 11.4.0 | 33.2 ms | ≈90 |
| Zig / Zig 0.14.1 | 33.3 ms | ≈89 |
| Go / Go 1.24.5 | 38.4 ms | ≈77 |
| TypeScript / Deno 2.4.3 | 77.6 ms | ≈38 |
| JavaScript / Node.js 24.4.1 | 79.1 ms | ≈38 |
| Python / CPython 3.13.5 | 2970.8 ms | 1 |
सापेक्ष गति बिना गोल किए गए औसत समय से निकाली गई है, जिसमें Python = 1 है। हर भाषा और रनटाइम परिवार के लिए हम स्थिर संस्करणों में सबसे कम प्रकाशित औसत चुनते हैं, जिनकी संख्यात्मक गणना एक थ्रेड में चलती है और स्पष्ट SIMD intrinsics, वेक्टर प्रकार या बाहरी संख्यात्मक लाइब्रेरी का उपयोग नहीं करती। कोड और अनुकूलन अलग हैं; Zig में ReleaseFast का उपयोग है। TypeScript को Deno/V8 वाली निष्पादन योग्य फ़ाइल के रूप में चलाया जाता है, जबकि JavaScript Node.js पर चलती है।[28]
पास-पास के मानों को तुलनीय परिणाम समझें और इस एक कार्य से भाषाओं का समग्र क्रम तय न करें। यह शुरू होने के बाद लगातार चलने वाले बॉट का प्रोसेसिंग समय या ऑर्डर के अपने गंतव्य तक पहुँचने में लगने वाला विलंब सीधे नहीं मापता।
दर्ज वातावरण चार उपलब्ध कोर वाला AMD EPYC 7763 और Linux है। प्रकाशित मापन कोड में हर स्थिति के लिए तीन दोहराव तय हैं और हर बार नया प्रोसेस शुरू होता है। पुराने रन का सटीक कमिट और प्रत्येक माप का मूल डेटा सत्यापित नहीं हो सका, इसलिए यहाँ प्रकाशित औसत प्रस्तुत किए गए हैं।[28][29]
छह आयामों में डिज़ाइन की खूबियों की तुलना करें
अगले चित्र ऑफ-चेन Solana क्लाइंट के लिए तीन स्तरों वाले संपादकीय चयन-मार्गदर्शक हैं। गणना की गति वाला पहलू तुलना की जा रही भाषा और implementation में सीधे लिखे गए, बड़ी मात्रा में डेटा पढ़ने और गणना करने वाले काम को तेज़ करने के विकल्प देखता है। यह पूरे एप्लिकेशन की रैंकिंग नहीं करता, जिसका अधिकांश समय नेटवर्क के इंतज़ार में जाता हो, और न ही उन गणनाओं की जो तेज़ बाहरी लाइब्रेरी को सौंपी जाती हैं।
Rust, Go, C++ और Zig अनुकूलित native निष्पादन के मजबूत विकल्प हैं। इसका अर्थ समान गति नहीं है; अधिक सटीक क्रम के लिए वास्तविक कार्यभार मापना होगा। V8 भी बार-बार चलने वाले फ़ंक्शन को मशीन कोड में बदलता है। केवल interpreted होने के कारण JavaScript को धीमा कहना सही नहीं होगा।[20][21]
तीन पहलू, गणना की गति, विलंब पर नियंत्रण और मेमोरी पर नियंत्रण, गणना और नियंत्रण की खूबियाँ बताते हैं। सुरक्षा में सहायता, प्रोटोटाइप बनाने की आसानी और Solana SDK विकास में मिलने वाली सहायता बताते हैं। सभी छह अक्ष प्रोसेसिंग की गति नहीं दर्शाते।
हर षट्भुज में समान अक्ष और पैमाना है। बाहर की ओर बढ़ना उस पहलू में अधिक गुणात्मक मजबूती दर्शाता है। ये मापी गई गति या अनुपात नहीं हैं: स्तर 3 का अर्थ स्तर 1 से तीन गुना नहीं है। बहुभुज के क्षेत्रफल को कुल स्कोर मानने के बजाय, जिन पहलुओं को सुधारना चाहते हैं उनकी अलग-अलग तुलना करें।
| पहलू | किसकी तुलना करता है |
|---|---|
| गणना की गति | तुलना की जा रही implementation में स्वयं लिखे गए, बड़ी मात्रा में डेटा पढ़ने और गणना करने वाले काम को तेज़ करने के विकल्प |
| विलंब पर नियंत्रण | अचानक होने वाले विलंब को सीमित करने के लिए मेमोरी आवंटन, उसे वापस लेने और रनटाइम पर कोड अनुकूलन जैसे काम को महत्वपूर्ण प्रोसेसिंग से सीधे कितना अलग रखा जा सकता है |
| मेमोरी पर नियंत्रण | डेटा के लेआउट, ownership और जीवनकाल, आवंटन, पुनः उपयोग और मेमोरी वापस लेने को सीधे कितना डिज़ाइन किया जा सकता है |
| सुरक्षा में सहायता | मेमोरी जीवनकाल और साझा मेमोरी की गलतियाँ रोकने के लिए भाषा, रनटाइम और मानक औज़ारों की सहायता |
| प्रोटोटाइप बनाने की आसानी | छोटे एप्लिकेशन को चलाने और उसमें बदलाव आज़माने की आसानी; अनुभव और मौजूदा कोड के अनुसार बदलने वाला संपादकीय आकलन |
| Solana SDK | इच्छित उपयोग के लिए Solana के आधिकारिक दस्तावेज़ों से क्लाइंट SDK और उदाहरण कितनी आसानी से मिलते हैं |
नियंत्रण वाले पहलू सीधे डिज़ाइन विकल्पों का, सुरक्षा उपलब्ध सहायता का और SDK वाला पहलू आधिकारिक दस्तावेज़ों से मिलने वाले रास्ते का आकलन करता है। समान स्तर अलग तंत्र और गारंटियाँ दर्शा सकता है।[8][13][20][21][26]
यह अवलोकन तीन कॉलम और दो पंक्तियों में छह भाषाओं की तुलना करता है: Rust, Go, TypeScript, Python, C++ और Zig। आपके लिए महत्वपूर्ण पहलुओं की तुलना करें, फिर नीचे दिए अलग-अलग चित्रों और व्याख्याओं से रनटाइम की मान्यताओं और उपयुक्त उपयोगों को जाँचें।
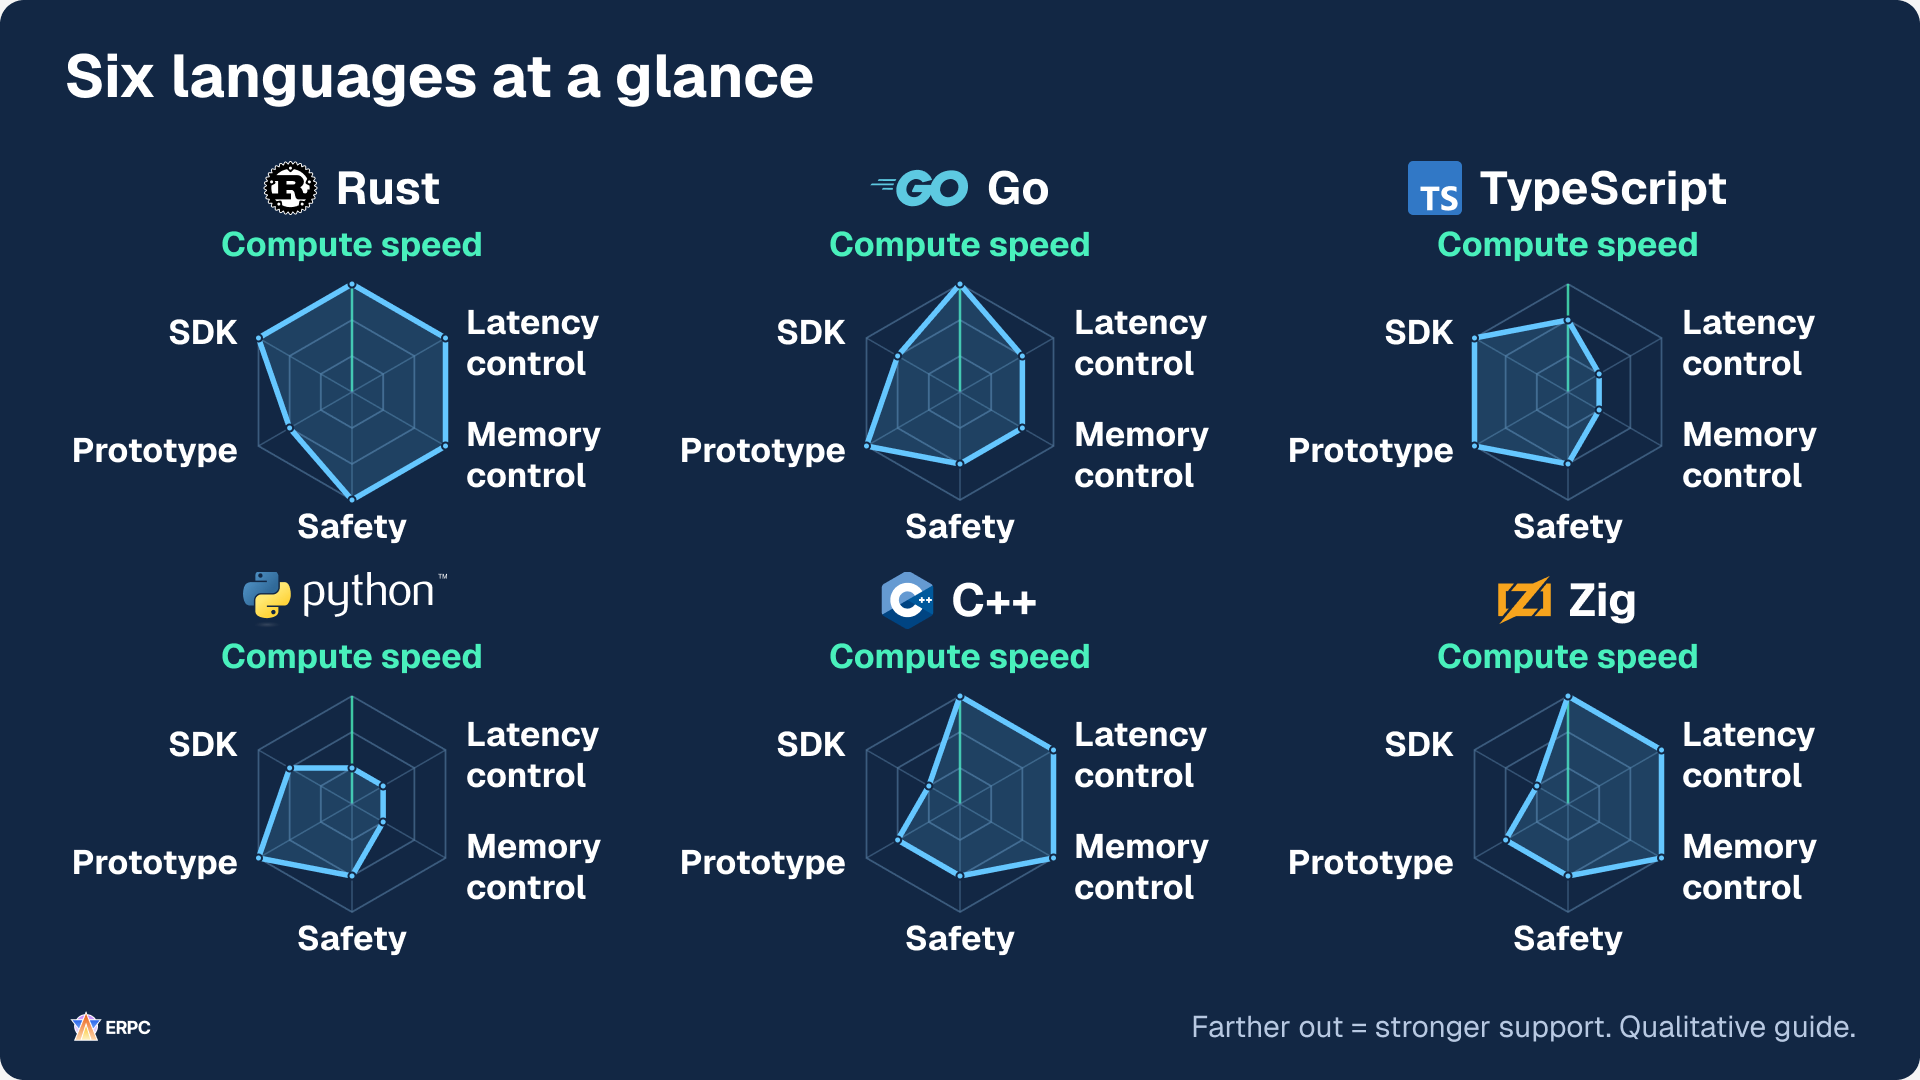
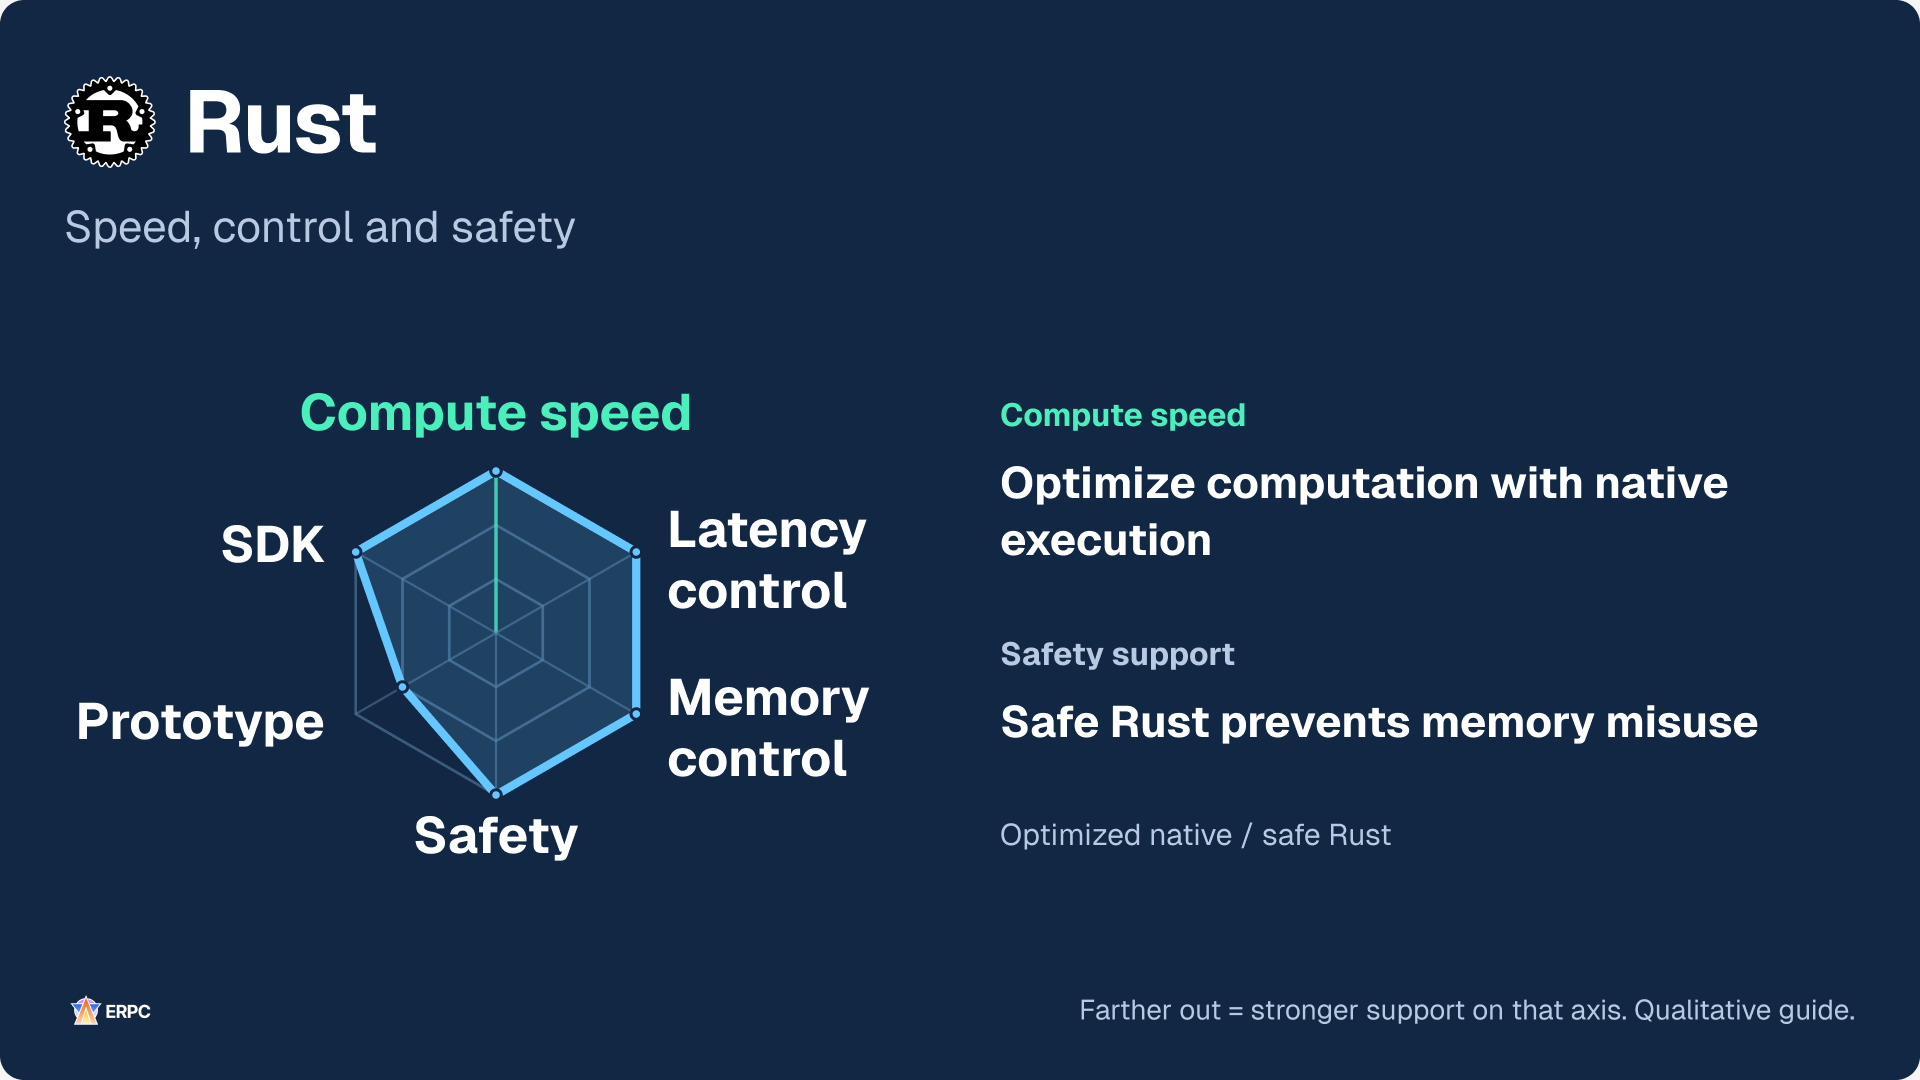
Rust महत्वपूर्ण रास्तों पर लेआउट, आवंटन और पुनः उपयोग के नियंत्रण को ownership और borrowing की जाँच से जोड़ता है। उसके सामान्य मेमोरी प्रबंधन को tracing GC की आवश्यकता नहीं होती।[8] data race के विरुद्ध safe Rust की गारंटी का अर्थ सामान्य race condition, deadlock या गलत निर्णय तर्क से मुक्ति नहीं है। unsafe कोड और दूसरी भाषाओं के इंटरफ़ेस की अलग जाँच आवश्यक है।[22] कॉपी, आवंटन, मेमोरी छोड़ना, लॉक और OS का इंतज़ार फिर भी होते हैं, इसलिए वास्तविक इनपुट और लोड पर जाँचें।
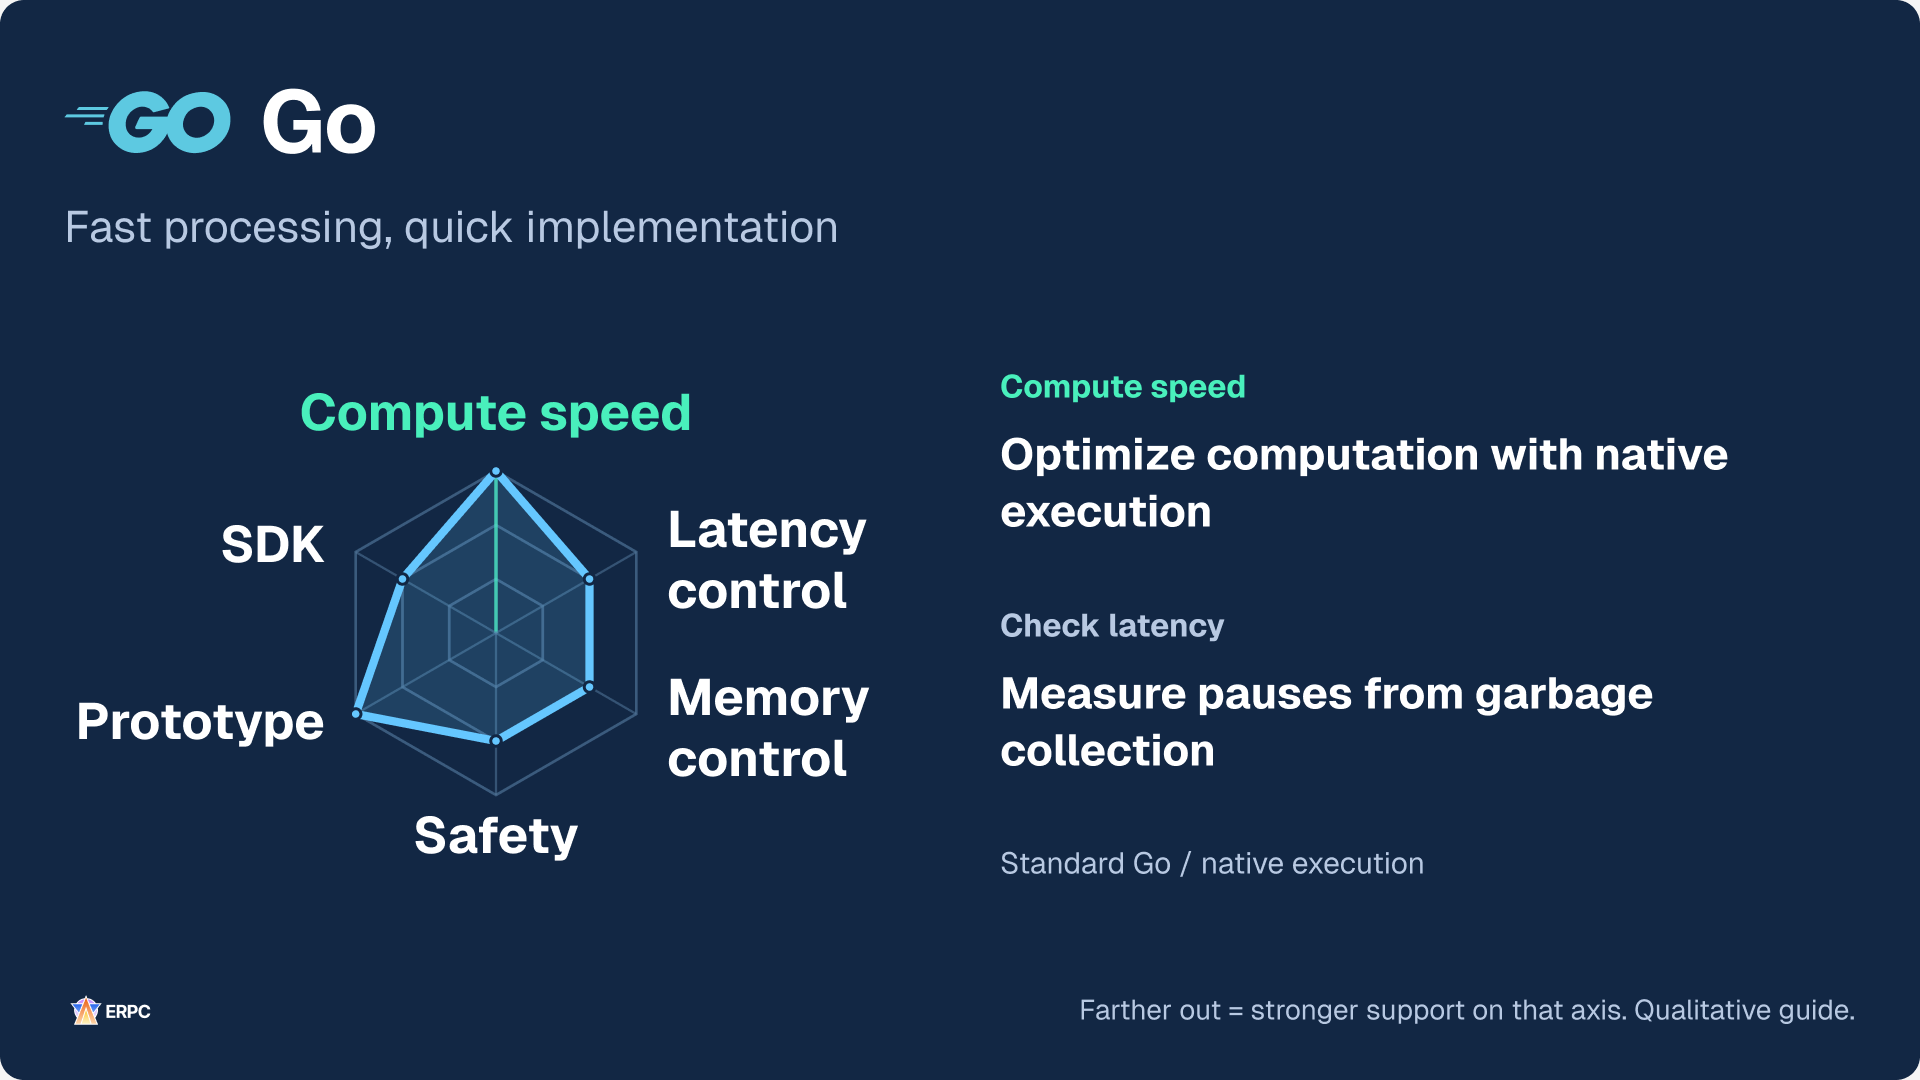
Go भी native compiled निष्पादन का विकल्प है। यह concurrent सेवाएँ और प्रोसेसिंग तैयार करने में सहायता करता है, जबकि उसका रनटाइम मेमोरी प्रबंधन और दूसरी क्रियाएँ संभालता है।[20] अधिकांश GC काम दूसरे काम के साथ चलता है, लेकिन आवंटन और संग्रह की CPU, मेमोरी तथा विलंब लागत मापें। CPU प्रोसेसिंग की क्षमता और मेमोरी वापस लेने के समय पर सीधा नियंत्रण अलग विचार हैं।[13]
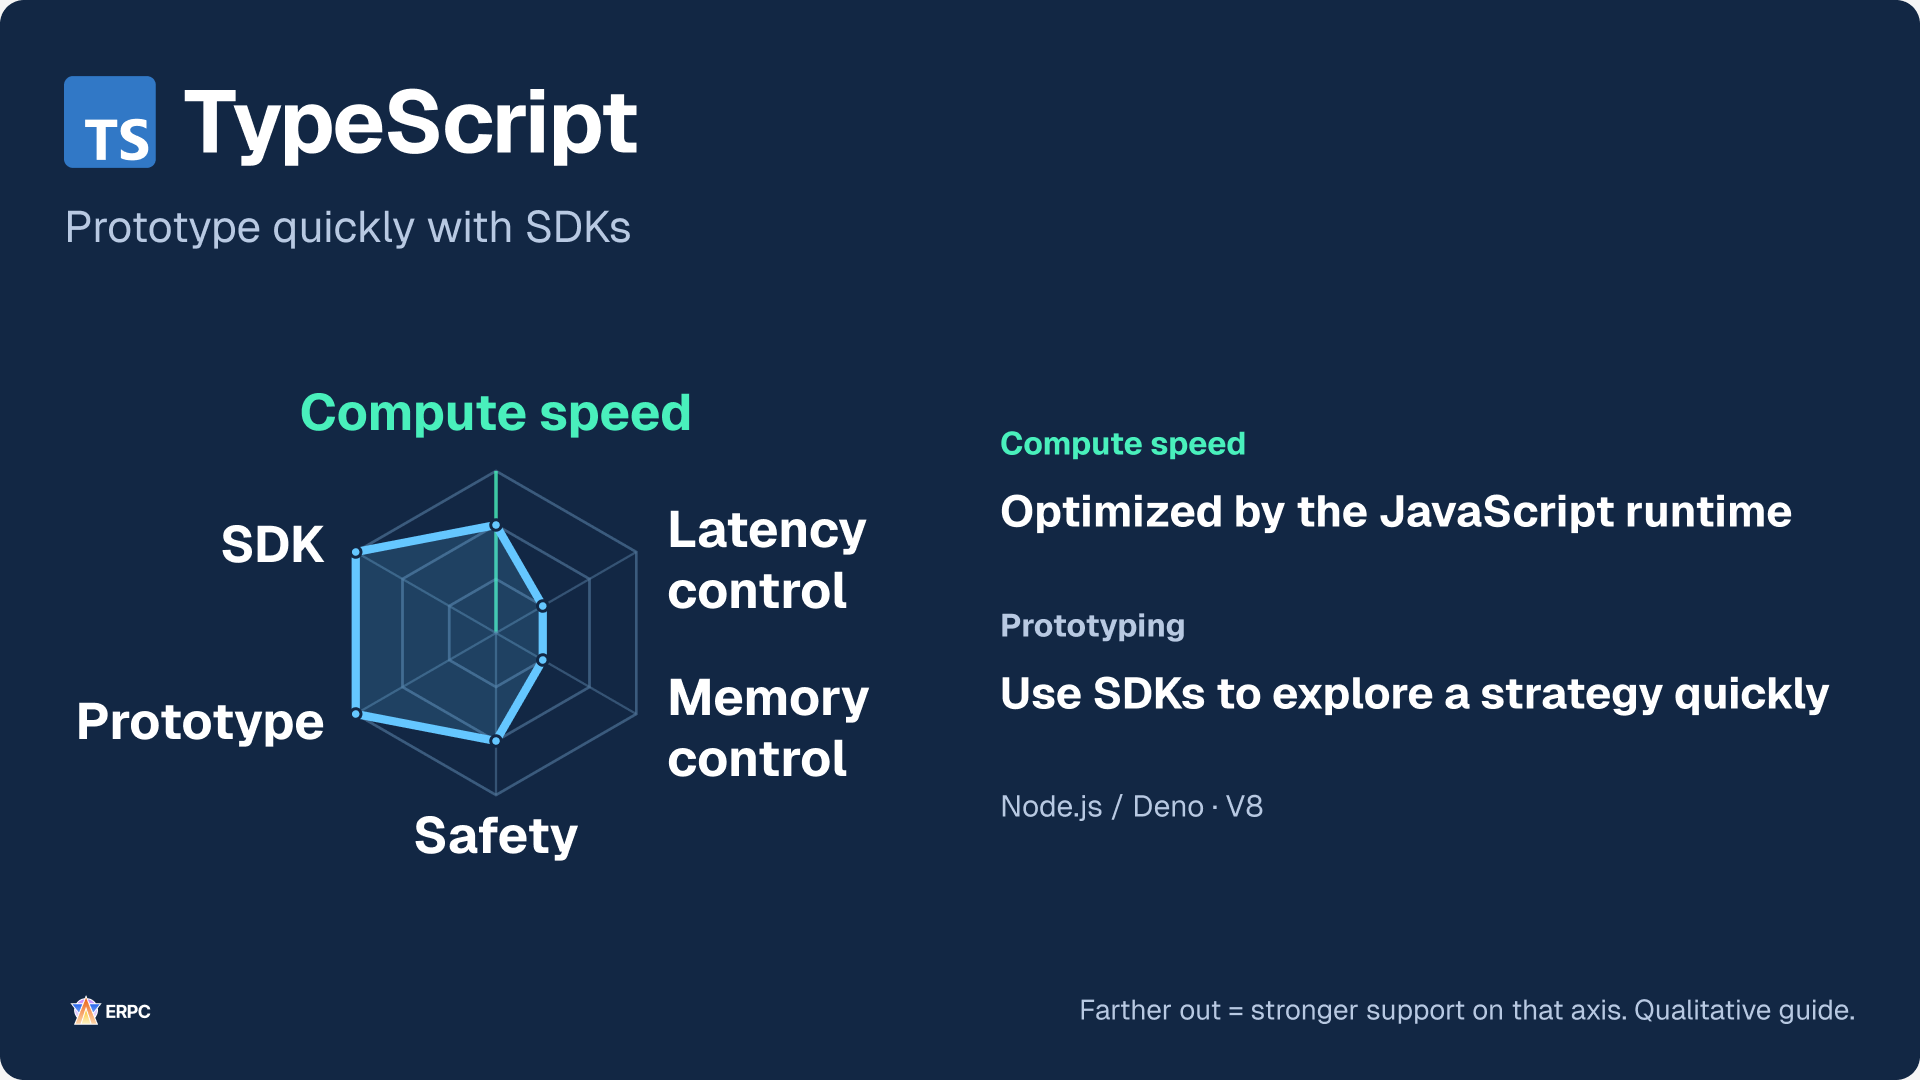
TypeScript एक भाषा है; Node.js और Deno रनटाइम हैं। यह चित्र V8 से चलने वाले JavaScript को देखता है। type annotation रनटाइम में हटा दिए जाते हैं, इसलिए प्रकार जोड़ना अपने आप CPU काम को तेज़ नहीं बनाता। बाहरी डेटा को रनटाइम पर जाँचना फिर भी आवश्यक है।[9][10][21] ये विकल्प API एकीकरण, कॉन्फ़िगरेशन, निगरानी, Web UI और आवश्यक प्रदर्शन पूरा करने वाली stream प्रोसेसिंग के लिए उपयोगी हो सकते हैं।
Node.js worker_threads और Deno Web Workers CPU काम को अलग निष्पादन संदर्भ में भेज सकते हैं। Node.js के दस्तावेज़ हर task के लिए नया worker बनाने के बजाय worker pool की सलाह देते हैं। गंतव्य पर गणना के साथ रूपांतरण, कॉपी और काम सौंपने के इंतज़ार को भी शामिल करें।[11][12]
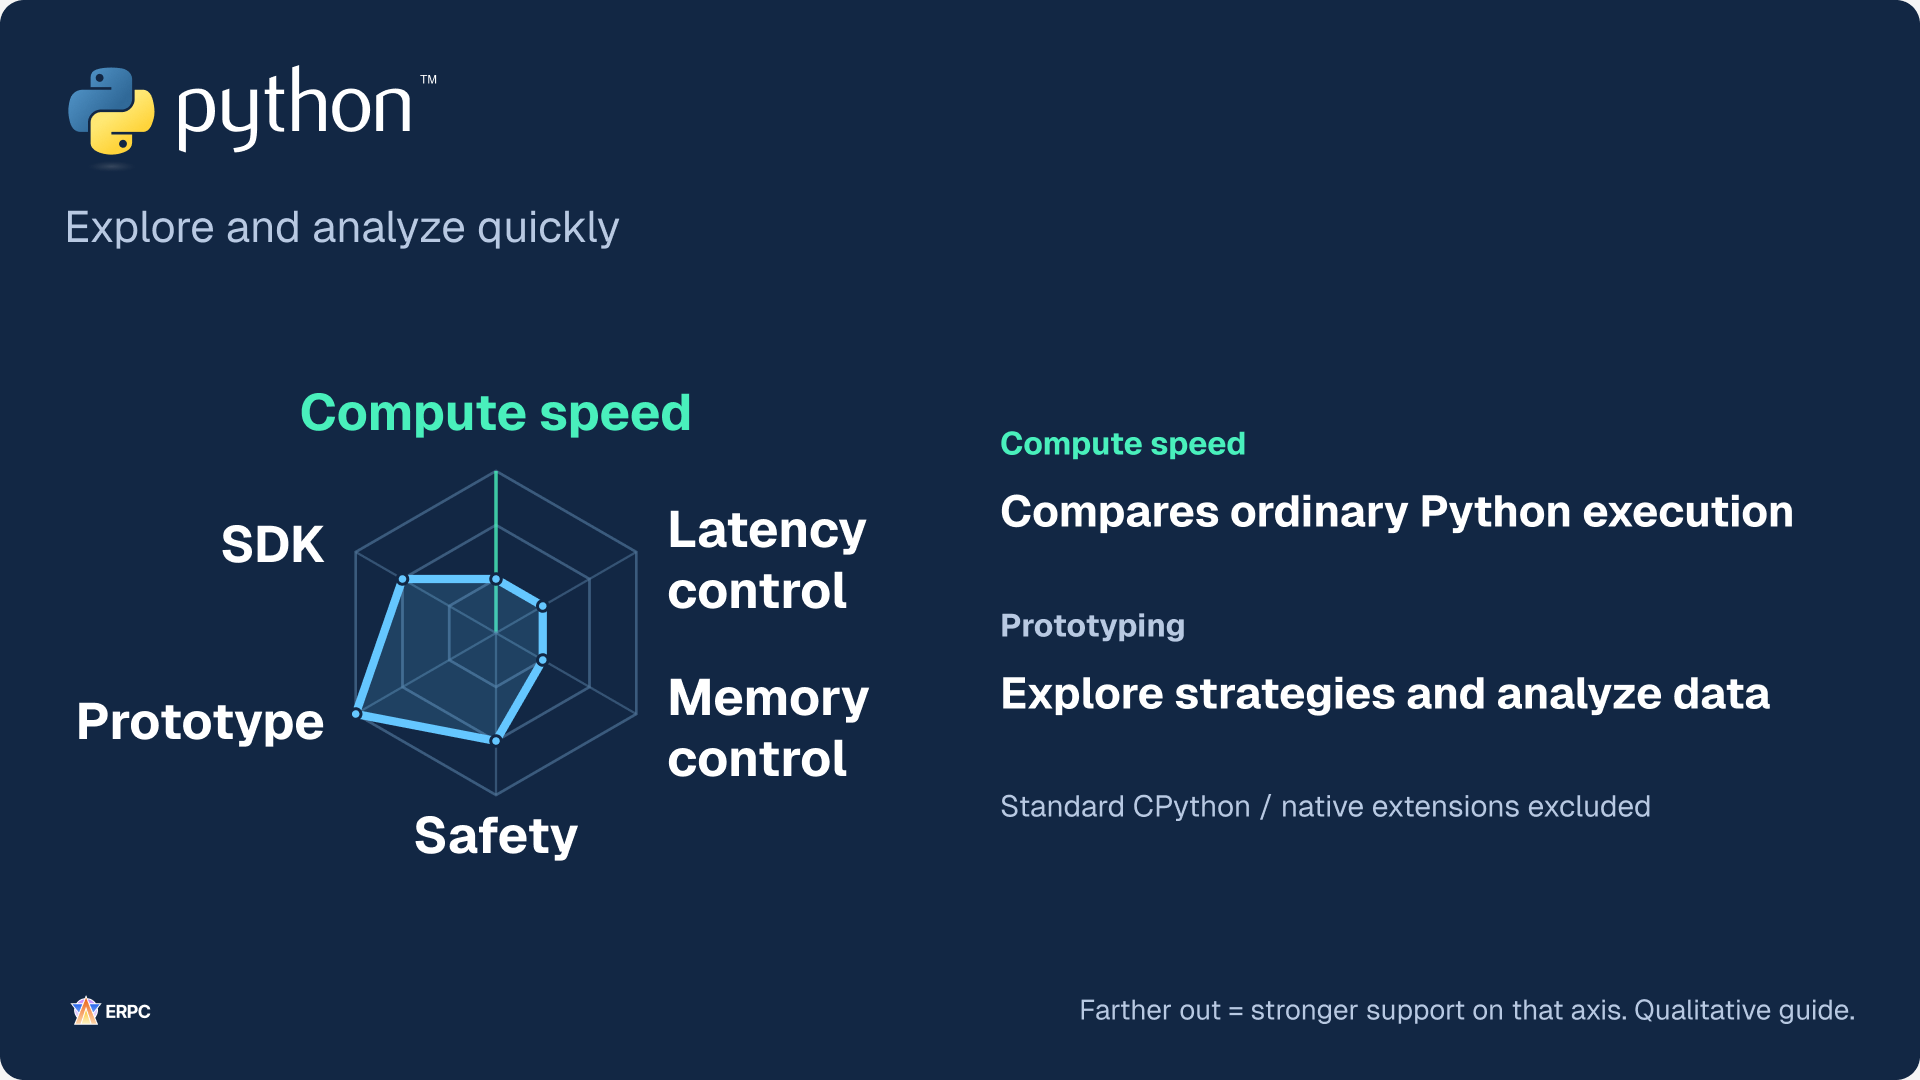
Python शोध, विश्लेषण, सत्यापन और मौजूदा लाइब्रेरी से काम करने का विकल्प है। यहाँ CPU का आकलन Python में लिखे और सामान्य CPython के भीतर चलने वाले लूप से संबंधित है। compiled कोड को सौंपी गणना, जैसे NumPy की क्रियाएँ, अलग मामला है।[23] केवल भाषा के नाम से निर्णय लेने के बजाय वास्तविक कॉन्फ़िगरेशन, जिसमें free-threaded बिल्ड भी शामिल हैं, जाँचें।[14] यदि किसी हिस्से को Rust या दूसरी implementation में ले जाएँ, तो सीमा पर रूपांतरण और कॉपी मापें और पूरे एप्लिकेशन को मिलने वाला लाभ सत्यापित करें।
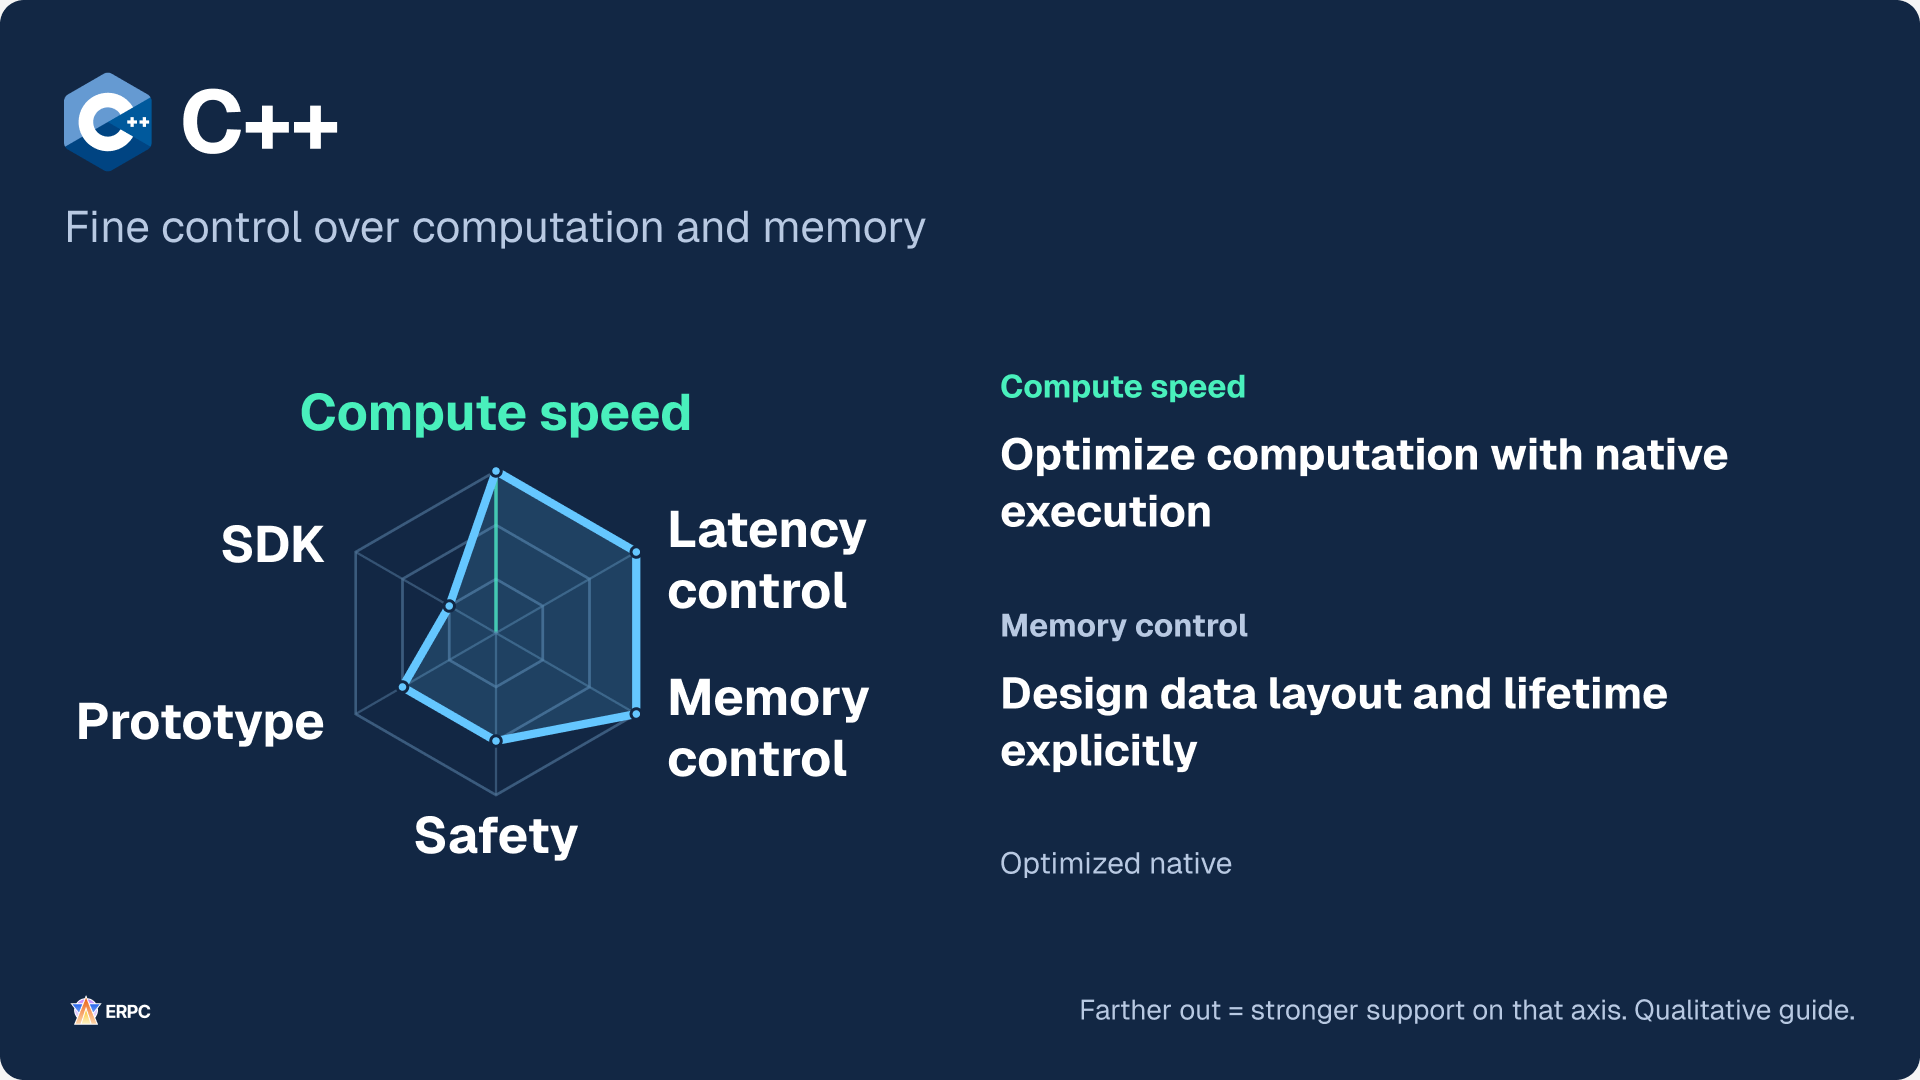
C++ निचले स्तर के नियंत्रण को abstraction और मौजूदा लाइब्रेरी से जोड़ता है। RAII और smart pointer संसाधनों का जीवनकाल संभालने में सहायता करते हैं, लेकिन उनका उपयोग सभी मेमोरी जीवनकाल या साझा मेमोरी की सुरक्षा की गारंटी नहीं देता।[24] सुरक्षा का बीच वाला स्तर भी Go जैसे विकल्पों की managed memory जैसी गारंटियाँ नहीं दर्शाता।
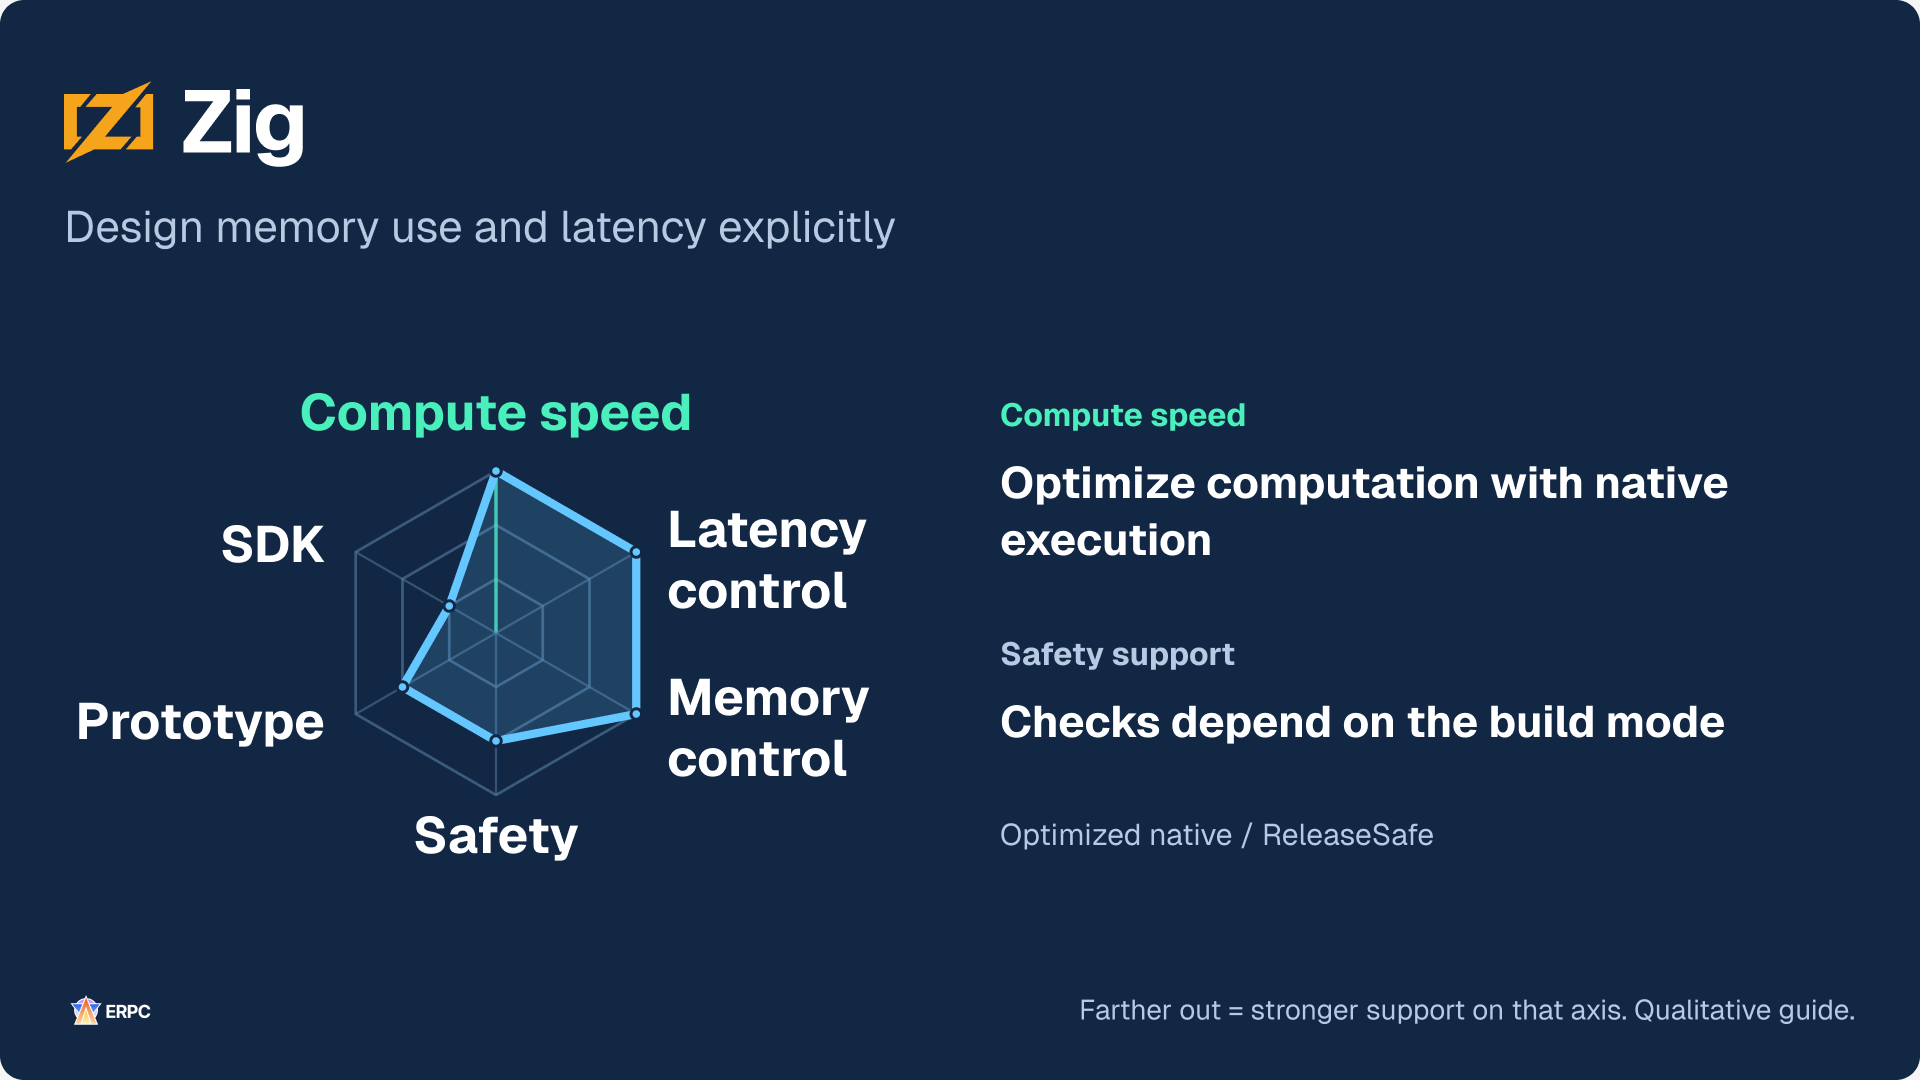
Zig आवंटन और allocator के चयन को स्पष्ट रूप से व्यवस्थित करने देता है। यह प्रोफ़ाइल ReleaseSafe की जाँच मानकर चलता है। ReleaseFast और ReleaseSmall की डिफ़ॉल्ट जाँच अलग हैं और ReleaseSafe हर तरह का अमान्य व्यवहार नहीं पकड़ता।[25] C++ जैसा बहुभुज होने का अर्थ समान तंत्र नहीं है।
Solana SDK वाला पहलू TypeScript और Rust के आधिकारिक दस्तावेज़ी रास्तों तथा वहाँ सूचीबद्ध Go और Python क्लाइंट का उपयोग करता है। यह सामान्य लाइब्रेरी संख्या या गुणवत्ता की रैंकिंग नहीं करता और यह नहीं कहता कि C++ और Zig के लिए लाइब्रेरी नहीं हैं। वास्तविक SDK में आवश्यक API, रखरखाव का तालमेल और चुने हुए रनटाइम, जिसमें Deno भी शामिल है, के साथ संगतता जाँचें।[26]
मापें कि एप्लिकेशन कहाँ समय खर्च करता है, फिर उस हिस्से की आवश्यक खूबियाँ चुनें। पहले मौजूदा भाषा में इंतज़ार और बार-बार होने वाला काम घटाएँ। अधिक बारीक नियंत्रण चाहिए तो संबंधित हिस्से को दूसरी भाषा में ले जाना एक विकल्प रहता है।
बदलावों की तुलना समान परिस्थितियों में करें
हर खंड के निर्देश उसके सुधार को लागू करने और जाँचने के लिए हैं। यदि कई सुधार लागू करें, तो हर बदलाव को उसके मापन परिणामों से जोड़कर रखें। कई बदलाव एक साथ लागू करने पर यह अलग करना कठिन हो जाता है कि किस बदलाव ने किस परिणाम को प्रभावित किया।
पहले और बाद की तुलना समान इनपुट, सब्सक्रिप्शन शर्तों, लोड और आउटपुट आवश्यकताओं के साथ करें। डेटा मिलने से निर्णय पूरा होने तक के समय में माध्यिका p50 के साथ p95 और p99 भी देखें। p99 वह समय सीमा है जिसके भीतर मापे गए 99% इवेंट पूरे होते हैं। इससे सामान्य प्रोसेसिंग के साथ वितरण का धीमा हिस्सा भी दिखता है।
हर चरण की p99 जोड़ने से पूरे पथ की p99 नहीं मिलती। हर इवेंट के लिए डेटा मिलने से निर्णय पूरा होने तक की कुल अवधि सीधे मापें। साथ में कतार का इंतज़ार, CPU और मेमोरी उपयोग, छूटे या हटाए गए अपडेट और निर्णय परिणामों का मेल भी देखें।
एक ही होस्ट के भीतर बीता समय मापते हुए monotonic clock इस्तेमाल करें, जो वास्तविक समय की घड़ी ठीक किए जाने पर पीछे न जाए। यदि SDK डिकोडिंग के बाद ही callback बुलाता है, तो callback शुरू होने से पहले भी प्रोसेसिंग हुई है। हर माप कहाँ शुरू और खत्म होता है, इसे ठीक-ठीक बताएँ, ताकि डेटा पहुँचने की लेटेंसी और एप्लिकेशन की लेटेंसी अलग-अलग देखी जा सकें।
सबमिशन के बाद क्या होता है, यह भी जाँचें। sendTransaction का सफल उत्तर क्लस्टर द्वारा प्रोसेसिंग या पुष्टि की गारंटी नहीं देता।[15] डेटा मिलना, निर्णय, सबमिशन स्वीकार होना और दिखाई देने वाला ऑन-चेन परिणाम आपस में जोड़ने से अगला सुधार बिंदु पहचानने में मदद मिलती है।
तेज़ डेटा डिलीवरी को समय पर लिए गए निर्णयों में बदलें
तेज़ डेटा डिलीवरी और आवश्यक निर्णय समय पर पूरे करने वाला एप्लिकेशन, दोनों महत्वपूर्ण हैं। ERPC अपनी डिलीवरी संरचना बेहतर करना और उस पर चलने वाले सॉफ़्टवेयर को सुधारने में मददगार जानकारी विकसित करना जारी रखता है।
पहले एप्लिकेशन के बदलावों को उसी परिवेश में सत्यापित करें। फिर जहाँ आवश्यक हो, समान कोड की तुलना अलग स्थानों या संसाधनों पर करें, ताकि उनके प्रभाव अलग किए जा सकें। ERPC की घंटे के हिसाब से बिलिंग इस्तेमाल करते समय परिकल्पना, तुलना की शर्तें और उपयोग की अवधि पहले तय करें। मूल्य और उपलब्धता के लिए वर्तमान Dashboard देखें।
संदर्भ और संबंधित लिंक
- [1] Tokio / CPU-प्रधान टास्क और ब्लॉक करने वाला काम
- [2] Node.js / इवेंट लूप को ब्लॉक न करें
- [3] gRPC / Flow Control
- [4] Yellowstone gRPC / संदेश और सब्सक्रिप्शन विनिर्देश
- [5] LMAX Disruptor / डिज़ाइन और उपयोग
- [6] Solana / Commitment
- [7] Solana / getLatestBlockhash
- [8] Rust / Ownership
- [9] TypeScript / रनटाइम व्यवहार और हटाए गए टाइप
- [10] Deno / TypeScript
- [11] Node.js / Worker threads
- [12] Deno / Web Workers
- [13] Go / Garbage Collector
- [14] Python / Free threading
- [15] Solana / sendTransaction
- [16] Yellowstone gRPC / संदेश परिभाषाएँ
- [17] Rust / std::sync::Mutex
- [18] Tokio / साझा स्टेट और mutex sharding
- [19] Solana / ट्रांज़ैक्शन संरचना और सिग्नेचर
- [20] Go / अक्सर पूछे जाने वाले प्रश्न
- [21] V8 / व्यापक परिचय
- [22] Rust / Data Race और Race Condition
- [23] NumPy / NumPy क्या है?
- [24] C++ / मुख्य दिशानिर्देश
- [25] Zig / भाषा संदर्भ
- [26] Solana / क्लाइंट SDK
- [27] Programming-Language-Benchmarks / nbody
- [28] Programming-Language-Benchmarks / Measurement code (2025-07-31): execution, defaults, aggregation, Zig build, Deno configuration.
- [29] Programming-Language-Benchmarks / Published measurement data (2025-08-01)
- लोगो और स्रोत: Rust © Rust Foundation (CC BY 4.0, आकार और रंग अपरिवर्तित); Zig © Zig project (CC BY-SA 4.0, आकार और रंग अपरिवर्तित).
- अन्य लोगो: Go © The Go Authors; TypeScript © Microsoft; Python © Python Software Foundation; C++ by Jeremy Kratz / Standard C++ Foundation; Node.js / OpenJS Foundation and Node.js contributors; Deno / Deno Land Inc..
- ERPC
- ERPC Web Dashboard