Arquitectura de baja latencia para HFT en Solana
Los datos llegan, pero los precios que utiliza tu aplicación para decidir siguen desactualizados. En una aplicación de HFT en Solana debes examinar tanto el tiempo de cálculo como el tiempo que los datos recibidos esperan antes de intervenir en una decisión. Puede haber actualizaciones anteriores pendientes, una escritura de registro sin terminar o una actualización de otro mercado que mantiene un bloqueo. La organización del código cambia esas esperas.
Este artículo recorre, mediante cinco patrones, dónde esperan los datos y qué trabajo puede avanzar cuando cambia el diseño. También puedes empezar por el síntoma que corresponda a tu aplicación e ir directamente a esa sección.
| Qué ocurre en la aplicación | Qué diseño examinar |
|---|---|
| Cuanto más tiempo funciona la aplicación, más datos sin procesar se acumulan | 1. Tasa de llegada, tasa de procesamiento y límites de espera |
| El siguiente precio no puede procesarse mientras se guarda un registro | 2. Separación del trabajo necesario para decidir y del registro analítico |
| Una actualización del mercado A hace esperar a una del mercado B | 3. División de los bloqueos que protegen estados independientes |
| Se repite la misma preparación con cada llegada | 4. Preparación anticipada y reutilización de las partes que no cambian |
| Se decide con valores antiguos incluso después de recuperar la conexión | 5. Distinción entre recuperar la conexión y recuperar el estado para decidir |
Cada sección termina con instrucciones que puedes copiar para aplicar esa mejora a tu aplicación. Entrégalas a un agente de IA que pueda leer el código de tu proyecto.
Las cantidades, los precios, los números de operaciones y las duraciones de los diagramas son modelos ilustrativos. No representan rendimiento medido ni resultados de trading.
Toca o haz clic en un diagrama para abrir la imagen a tamaño completo.
1. Compara las llegadas con la capacidad de procesamiento y limita las esperas
Considera una aplicación que recibe seis eventos y puede procesar dos en cada intervalo de igual duración. Al terminar el primer intervalo, quedan cuatro eventos sin procesar. Una cola es el lugar donde los datos esperan a ser procesados.
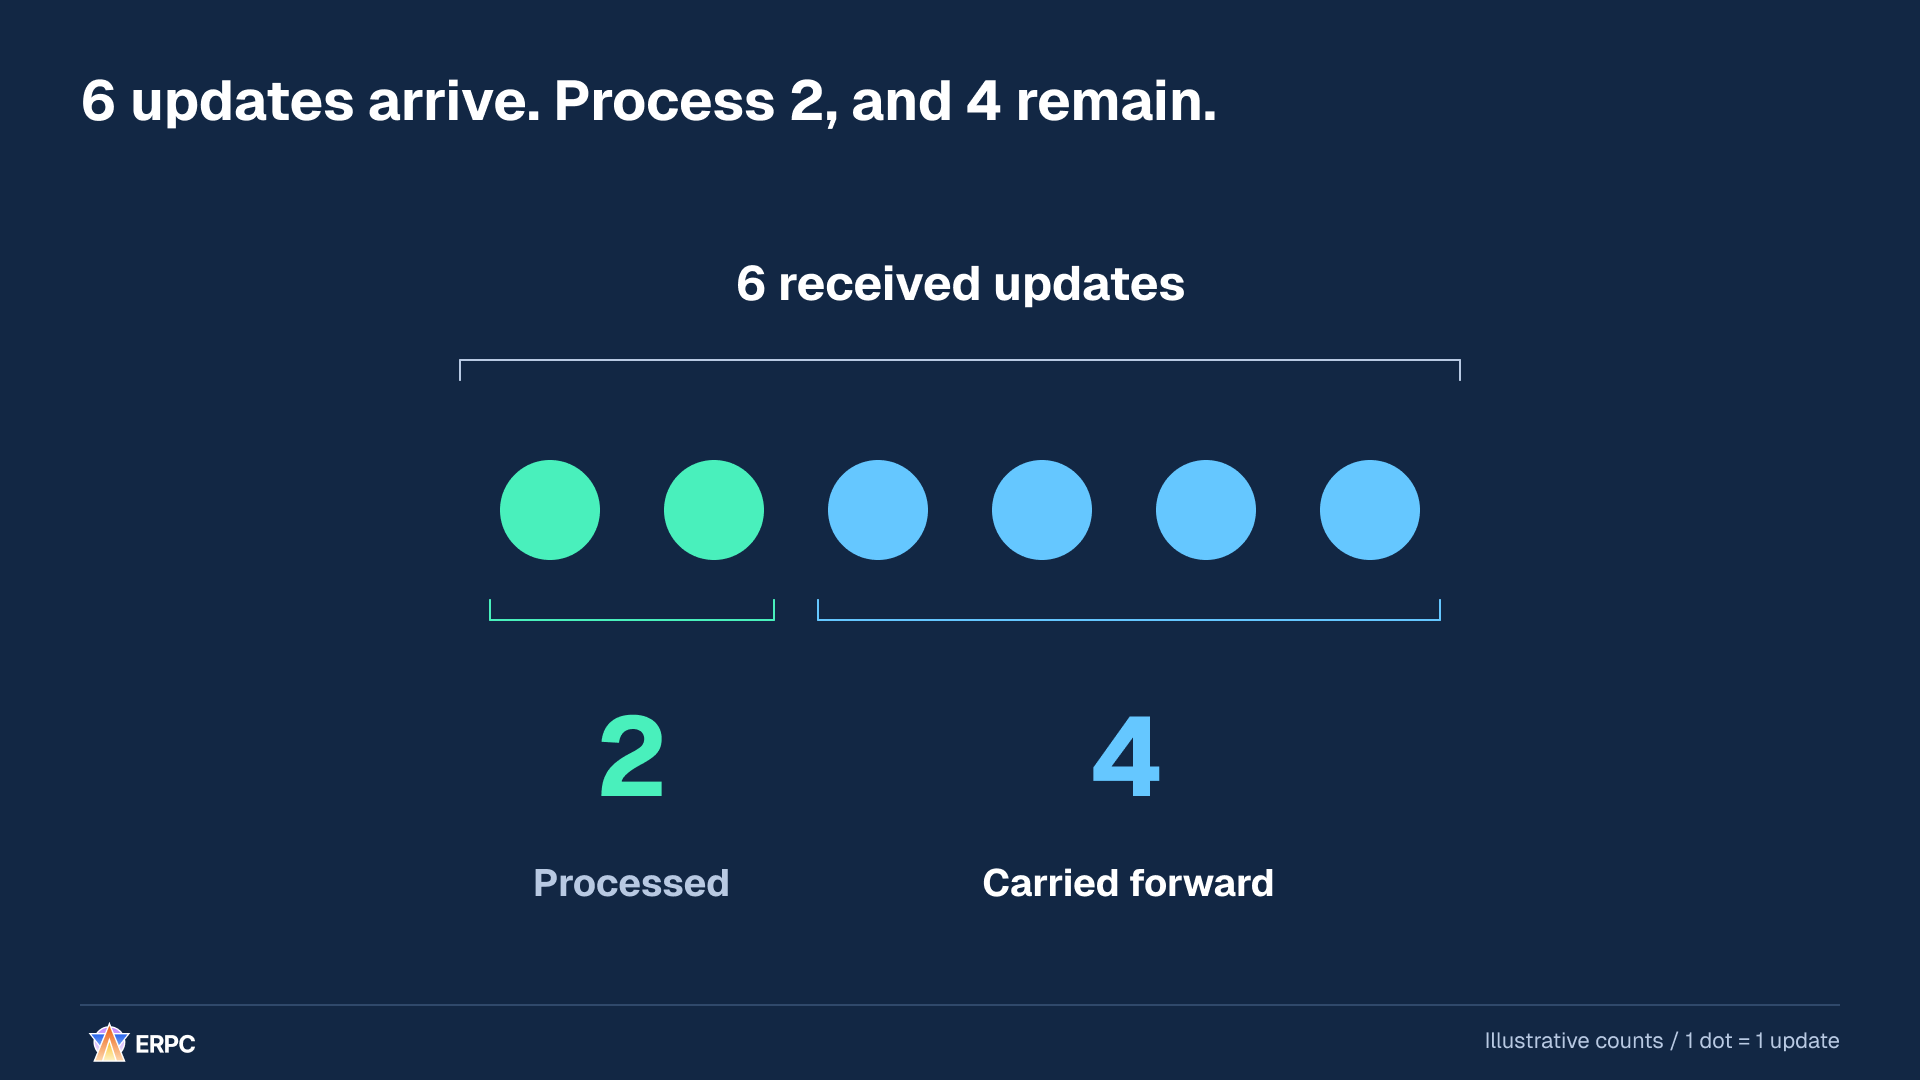
El procesamiento avanza, pero cuatro eventos aún no se han utilizado para decidir.
Llevemos la misma proporción a 60.000 eventos entrantes. Procesar 20.000 deja 40.000 esperando. A la derecha del diagrama, cada punto representa 100 eventos y cada grupo de 100 puntos representa 10.000 eventos. Se han procesado dos grupos y cuatro siguen esperando.
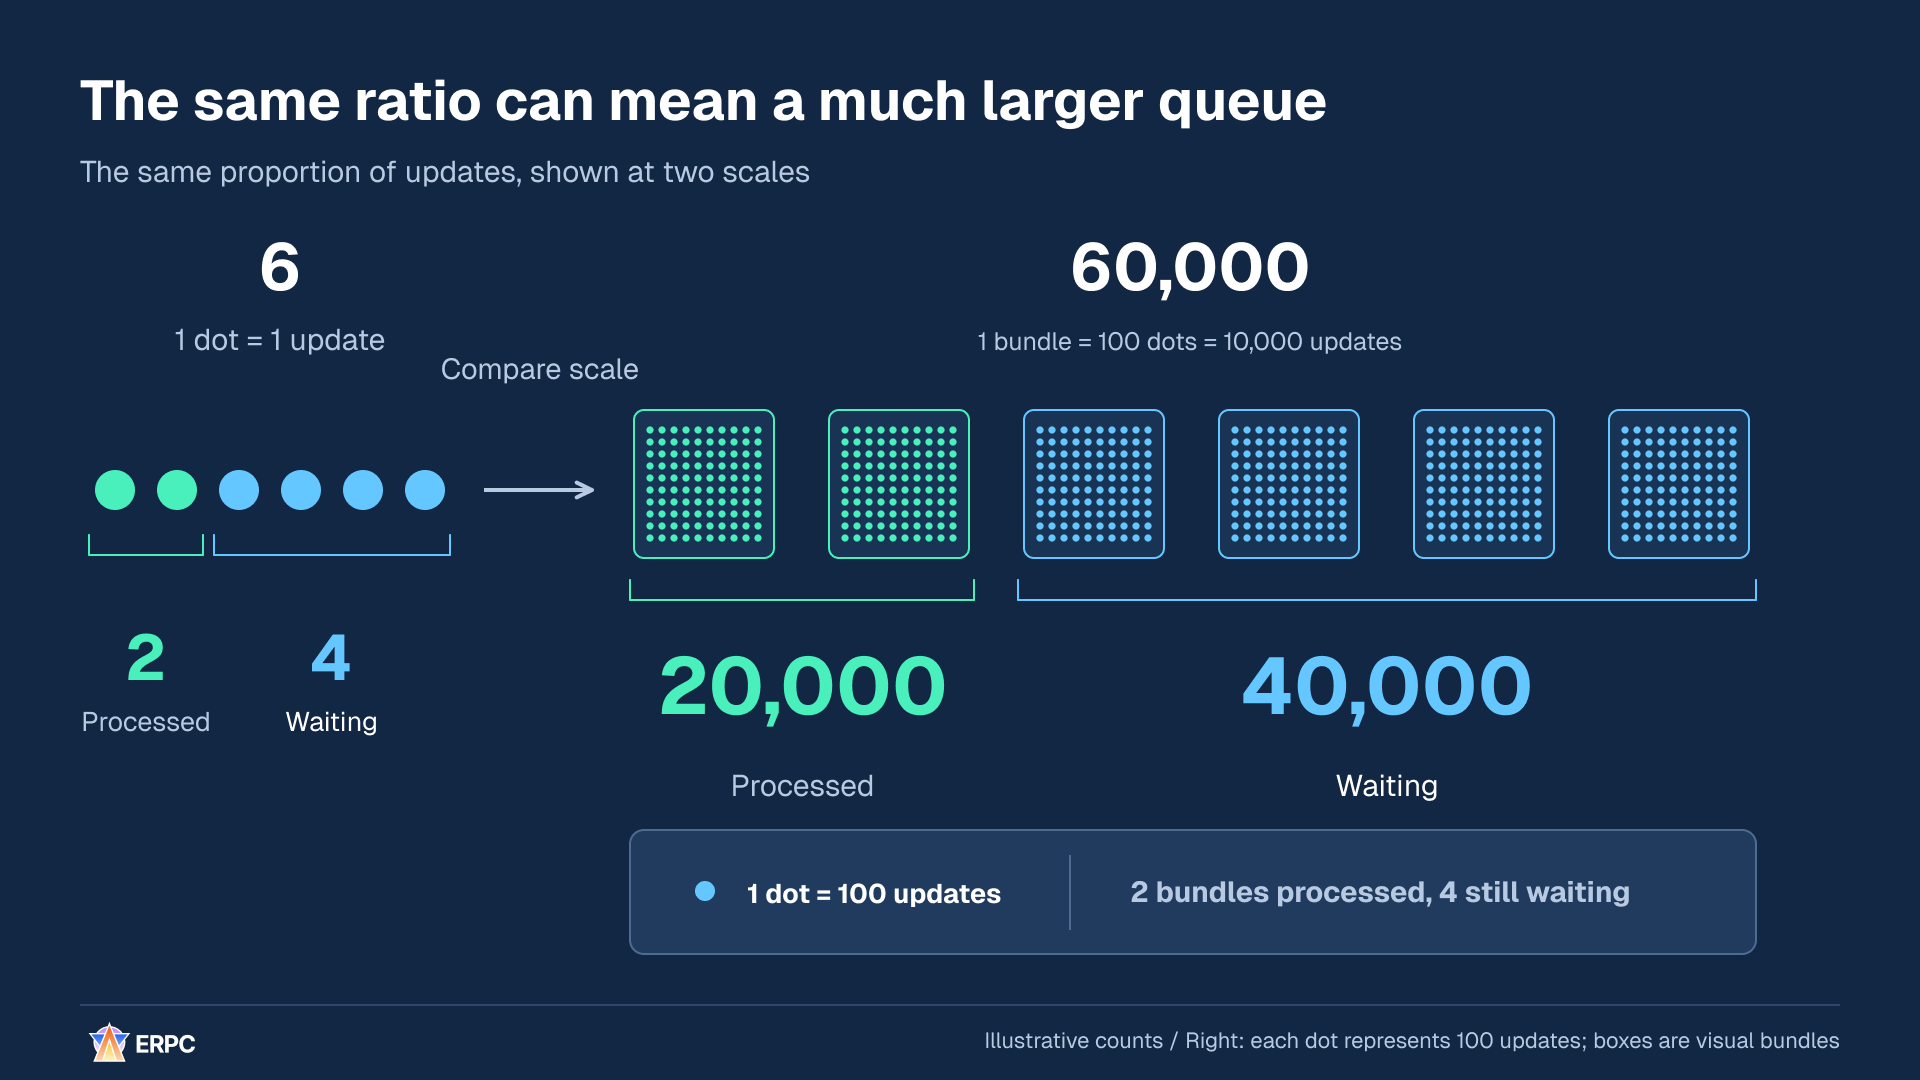
Los grupos de la derecha permiten visualizar el volumen. No representan lotes de procesamiento de la aplicación.
El siguiente intervalo comienza con 40.000 eventos pendientes. Llegan otros 60.000 y se procesan 20.000, por lo que quedan 80.000. El intervalo posterior termina con 120.000. Los precios recién recibidos tienen que esperar detrás del trabajo que ya está en la cola.
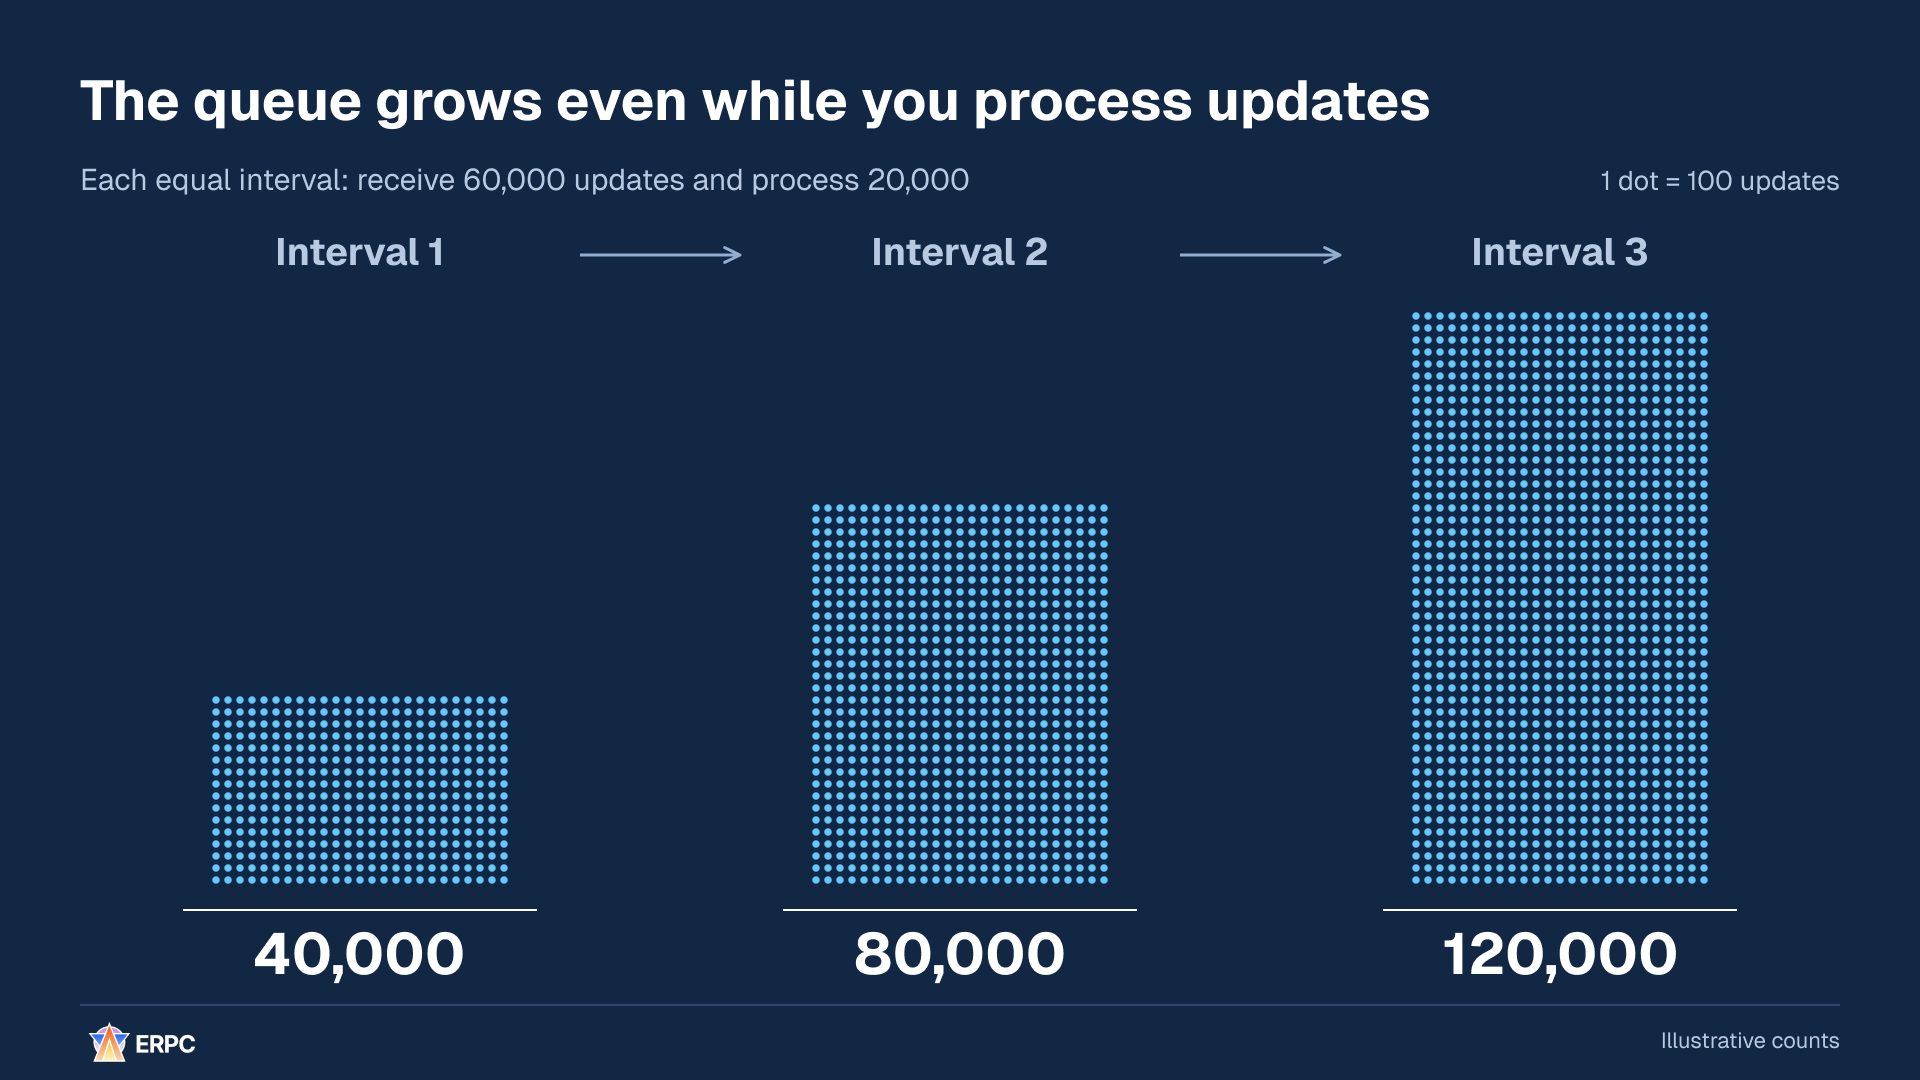
Si las llegadas siguen superando la capacidad de procesamiento, el trabajo pendiente continúa creciendo.
Una cola ayuda a absorber ráfagas: períodos breves en los que se concentran las llegadas. Aumentar su capacidad no resuelve un déficit sostenido de procesamiento como el de este ejemplo. Además del número de elementos y bytes conservados, observa cuánto lleva esperando el elemento más antiguo y establece un límite aceptable. Si los valores ya no cumplen el requisito de actualidad, pausa las nuevas decisiones de trading que dependan de ellos, aunque no se haya perdido ninguna actualización.
¿Qué debe suceder al alcanzar ese límite? En el siguiente diagrama, las ocho posiciones disponibles están ocupadas cuando llegan dos actualizaciones más. Si no pueden conservarse y son necesarias para una decisión, la aplicación ya no puede actualizar correctamente sus valores almacenados. Pausa las nuevas decisiones de trading que dependan de esos valores y reanúdalas después de recuperar las actualizaciones necesarias.
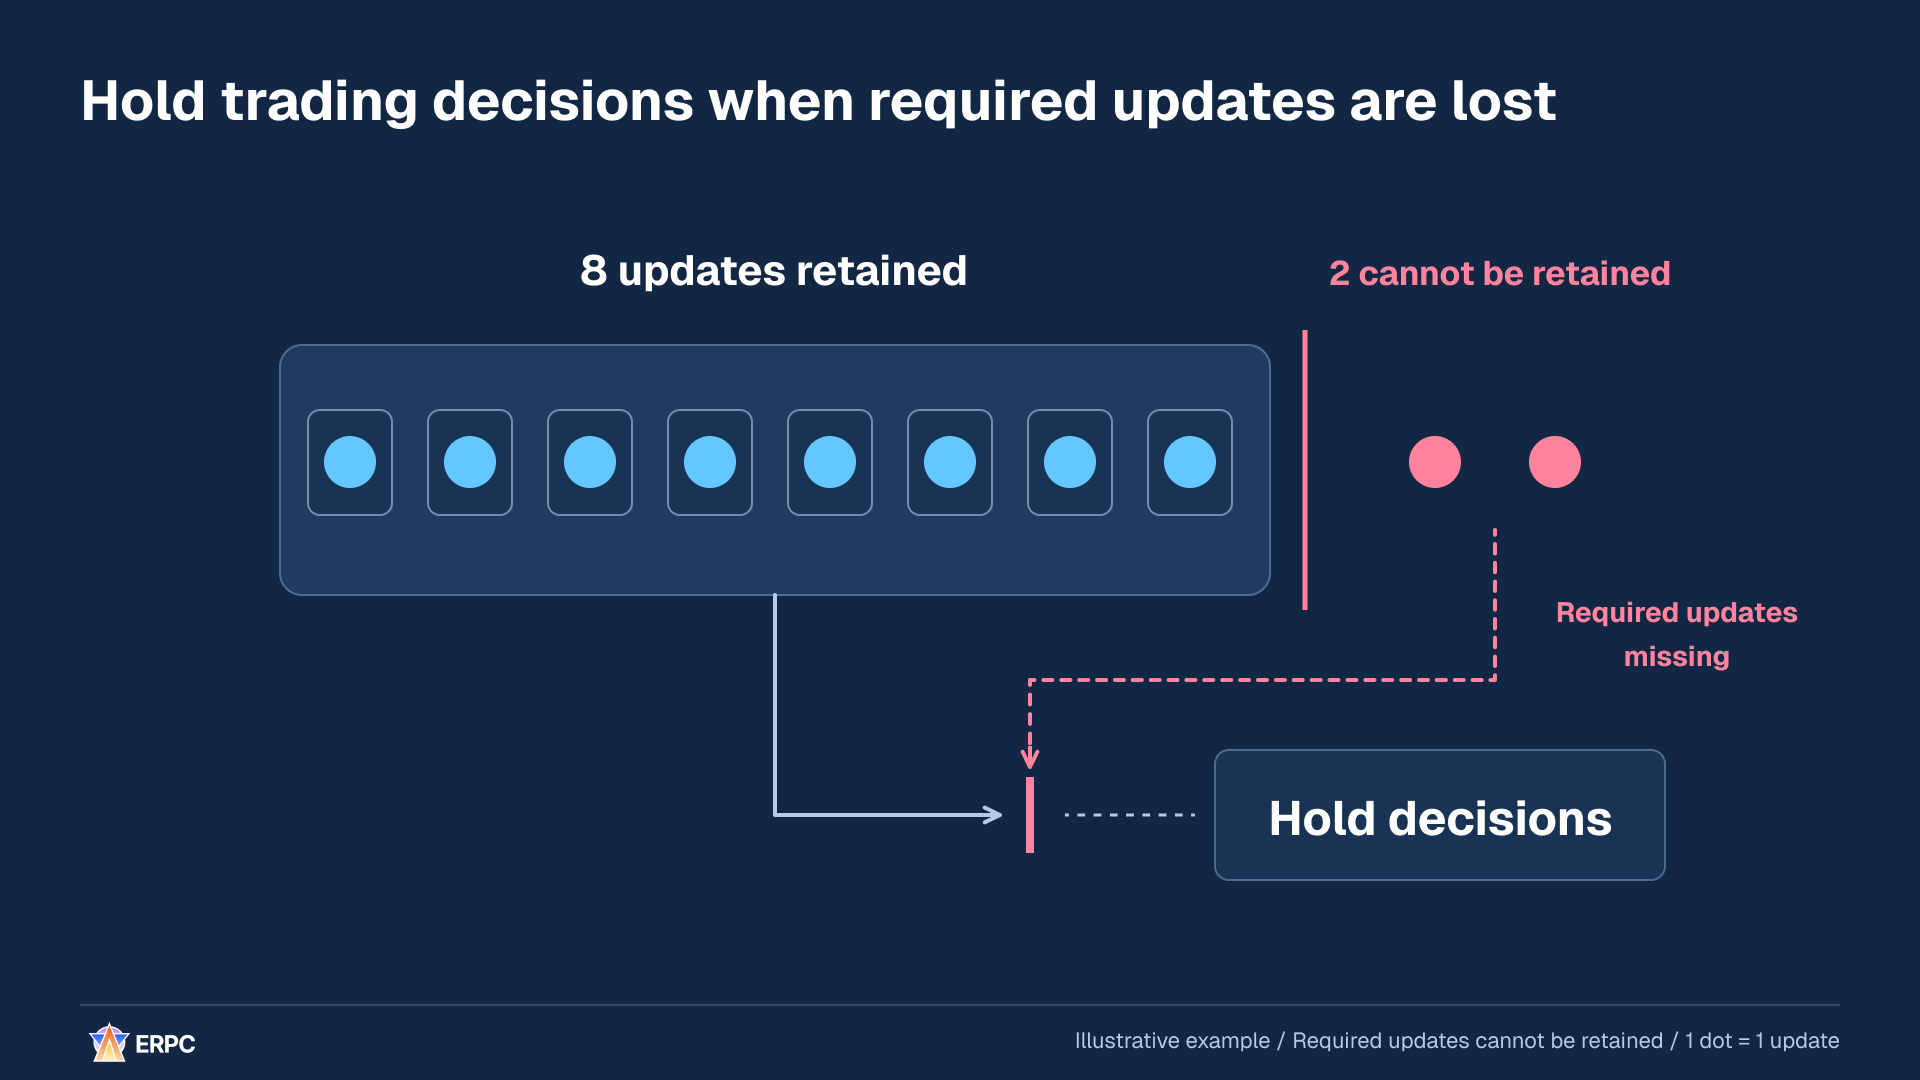
El diseño de una cola también debe definir qué ocurre después de alcanzar su límite.
Revisa si puedes reducir el trabajo o aumentar la capacidad de procesamiento. Si un consumidor solo necesita el último estado completo de la misma entidad, puede ser posible agrupar los valores intermedios en el más reciente. Sin embargo, en un proceso que acumula diferencias o necesita eventos intermedios, omitir actualizaciones cambia el resultado.
Pausar la recepción también puede trasladar la espera hacia el origen. Considera conjuntamente el control de flujo de gRPC, que regula el ritmo de envío y recepción, los filtros del servidor que acotan los datos suscritos y la capacidad real de procesamiento de la aplicación.[3][4]
Para mejorar la capacidad de la cola de recepción y la frescura de los datos de tu aplicación, copia estas instrucciones.
text
Mejora la gestión de datos entrantes de esta aplicación cuando el procesamiento se retrasa y los datos usados para decidir quedan desactualizados.

Lee el README, las instrucciones de desarrollo, las dependencias y el código de recepción → cola → actualización del estado → decisión. Trabaja con el lenguaje, el entorno de ejecución y el SDK existentes. Determina si las actualizaciones contienen un estado completo o deltas, el orden en que deben aplicarse y el requisito de frescura.

1. Guarda entradas reproducibles sin información confidencial y registra los valores iniciales. Examina también la espera anterior a la entrada en la cola. Mide, durante el mismo intervalo, los números de elementos y bytes que entran y salen, el trabajo en cola, la edad del elemento más antiguo en espera y el trabajo en curso.
2. Define e implementa límites de elementos, bytes, tiempo de espera y concurrencia, con una justificación para cada uno. Explicita los supuestos cuando se desconozcan los requisitos. Comprueba si pueden reducirse la recepción o el procesamiento innecesarios y si la capacidad de procesamiento es suficiente. No consideres que ampliar la cola por sí solo resuelve un déficit de procesamiento sostenido.
3. Define qué ocurre cuando la cola está llena. Si no pueden conservarse las actualizaciones necesarias, o si se pierde la frescura requerida incluso sin actualizaciones ausentes, pausa las nuevas decisiones de trading que dependan de esos valores. Continúa actualizando y recuperando el estado y verifica las condiciones para reanudar.
4. Si agrupas valores intermedios, establece que el último estado completo de la misma entidad basta para preservar el resultado. No descartes silenciosamente deltas o eventos necesarios. Si pausas la recepción, comprueba el control de flujo del proveedor y a dónde se traslada la espera.
5. Reproduce entradas normales, ráfagas, sobrecarga sostenida y recuperación de una cola llena en condiciones equivalentes. Compara las tasas de llegada y procesamiento, la edad del elemento más antiguo, p50/p95/p99 desde la recepción hasta la finalización de la decisión, CPU y memoria, y actualizaciones ausentes o descartadas. Contrasta el estado aplicado y las decisiones con los resultados esperados. Usa un reloj monotónico para medir duraciones dentro de un host e indica los límites de la medición.

Respeta las aprobaciones, permisos y procedimientos de desarrollo existentes. Estas instrucciones por sí solas no otorgan permisos adicionales para cambiar producción, contratar servicios de pago ni realizar operaciones reales. No muestres claves privadas, credenciales ni datos de clientes.

Informa de los cambios, las condiciones de comparación, las mediciones antes y después, las comprobaciones de corrección y las limitaciones restantes. Marca como no medidos los valores que no puedan medirse.
Mejora la gestión de datos entrantes de esta aplicación cuando el procesamiento se retrasa y los datos usados para decidir quedan desactualizados.
Lee el README, las instrucciones de desarrollo, las dependencias y el código de recepción → cola → actualización del estado → decisión. Trabaja con el lenguaje, el entorno de ejecución y el SDK existentes. Determina si las actualizaciones contienen un estado completo o deltas, el orden en que deben aplicarse y el requisito de frescura.
1. Guarda entradas reproducibles sin información confidencial y registra los valores iniciales. Examina también la espera anterior a la entrada en la cola. Mide, durante el mismo intervalo, los números de elementos y bytes que entran y salen, el trabajo en cola, la edad del elemento más antiguo en espera y el trabajo en curso.
2. Define e implementa límites de elementos, bytes, tiempo de espera y concurrencia, con una justificación para cada uno. Explicita los supuestos cuando se desconozcan los requisitos. Comprueba si pueden reducirse la recepción o el procesamiento innecesarios y si la capacidad de procesamiento es suficiente. No consideres que ampliar la cola por sí solo resuelve un déficit de procesamiento sostenido.
3. Define qué ocurre cuando la cola está llena. Si no pueden conservarse las actualizaciones necesarias, o si se pierde la frescura requerida incluso sin actualizaciones ausentes, pausa las nuevas decisiones de trading que dependan de esos valores. Continúa actualizando y recuperando el estado y verifica las condiciones para reanudar.
4. Si agrupas valores intermedios, establece que el último estado completo de la misma entidad basta para preservar el resultado. No descartes silenciosamente deltas o eventos necesarios. Si pausas la recepción, comprueba el control de flujo del proveedor y a dónde se traslada la espera.
5. Reproduce entradas normales, ráfagas, sobrecarga sostenida y recuperación de una cola llena en condiciones equivalentes. Compara las tasas de llegada y procesamiento, la edad del elemento más antiguo, p50/p95/p99 desde la recepción hasta la finalización de la decisión, CPU y memoria, y actualizaciones ausentes o descartadas. Contrasta el estado aplicado y las decisiones con los resultados esperados. Usa un reloj monotónico para medir duraciones dentro de un host e indica los límites de la medición.
Respeta las aprobaciones, permisos y procedimientos de desarrollo existentes. Estas instrucciones por sí solas no otorgan permisos adicionales para cambiar producción, contratar servicios de pago ni realizar operaciones reales. No muestres claves privadas, credenciales ni datos de clientes.
Informa de los cambios, las condiciones de comparación, las mediciones antes y después, las comprobaciones de corrección y las limitaciones restantes. Marca como no medidos los valores que no puedan medirse.2. Procesa el siguiente precio sin esperar a que se guarde un registro
Considera un precio de mercado que cambia de 100 a 101. La aplicación ha aplicado 100, terminado su decisión y está guardando un registro analítico. Si el bucle que atiende los datos recibidos espera a que termine esa escritura, no puede aplicar 101 aunque llegue la actualización. El precio almacenado sigue siendo 100.
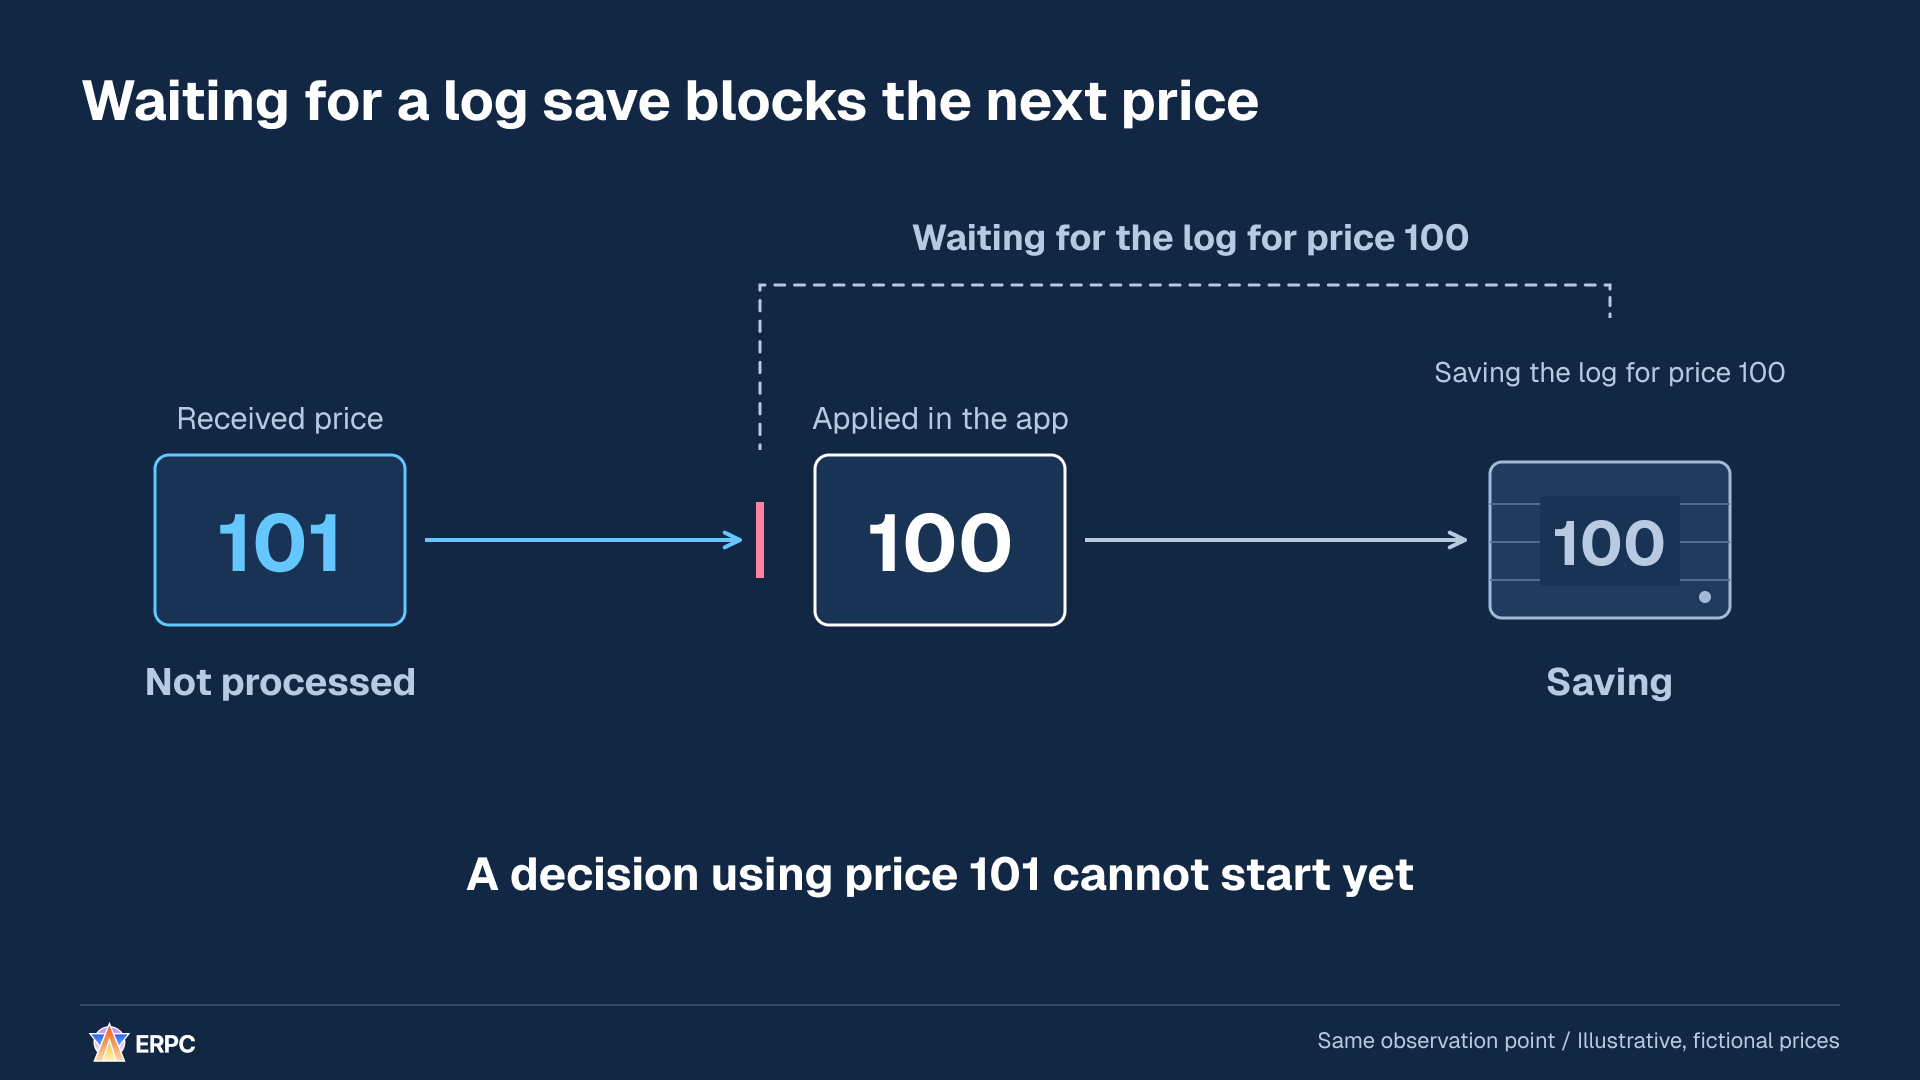
El procesamiento de 101 no puede comenzar porque espera al registro de 100.
Ahora entrega el registro analítico a una cola auxiliar con capacidad disponible y encarga su almacenamiento a una operación separada. El bucle receptor puede volver a la siguiente entrada cuando termina la entrega. Puede aplicar 101 y avanzar hacia una decisión mientras continúa la escritura de 100.
La comparación siguiente mantiene iguales la duración del almacenamiento de 100, el momento de llegada de 101 y el tiempo necesario para procesar 101. Lo que cambia es si pasar a la siguiente entrada depende de que termine la escritura.
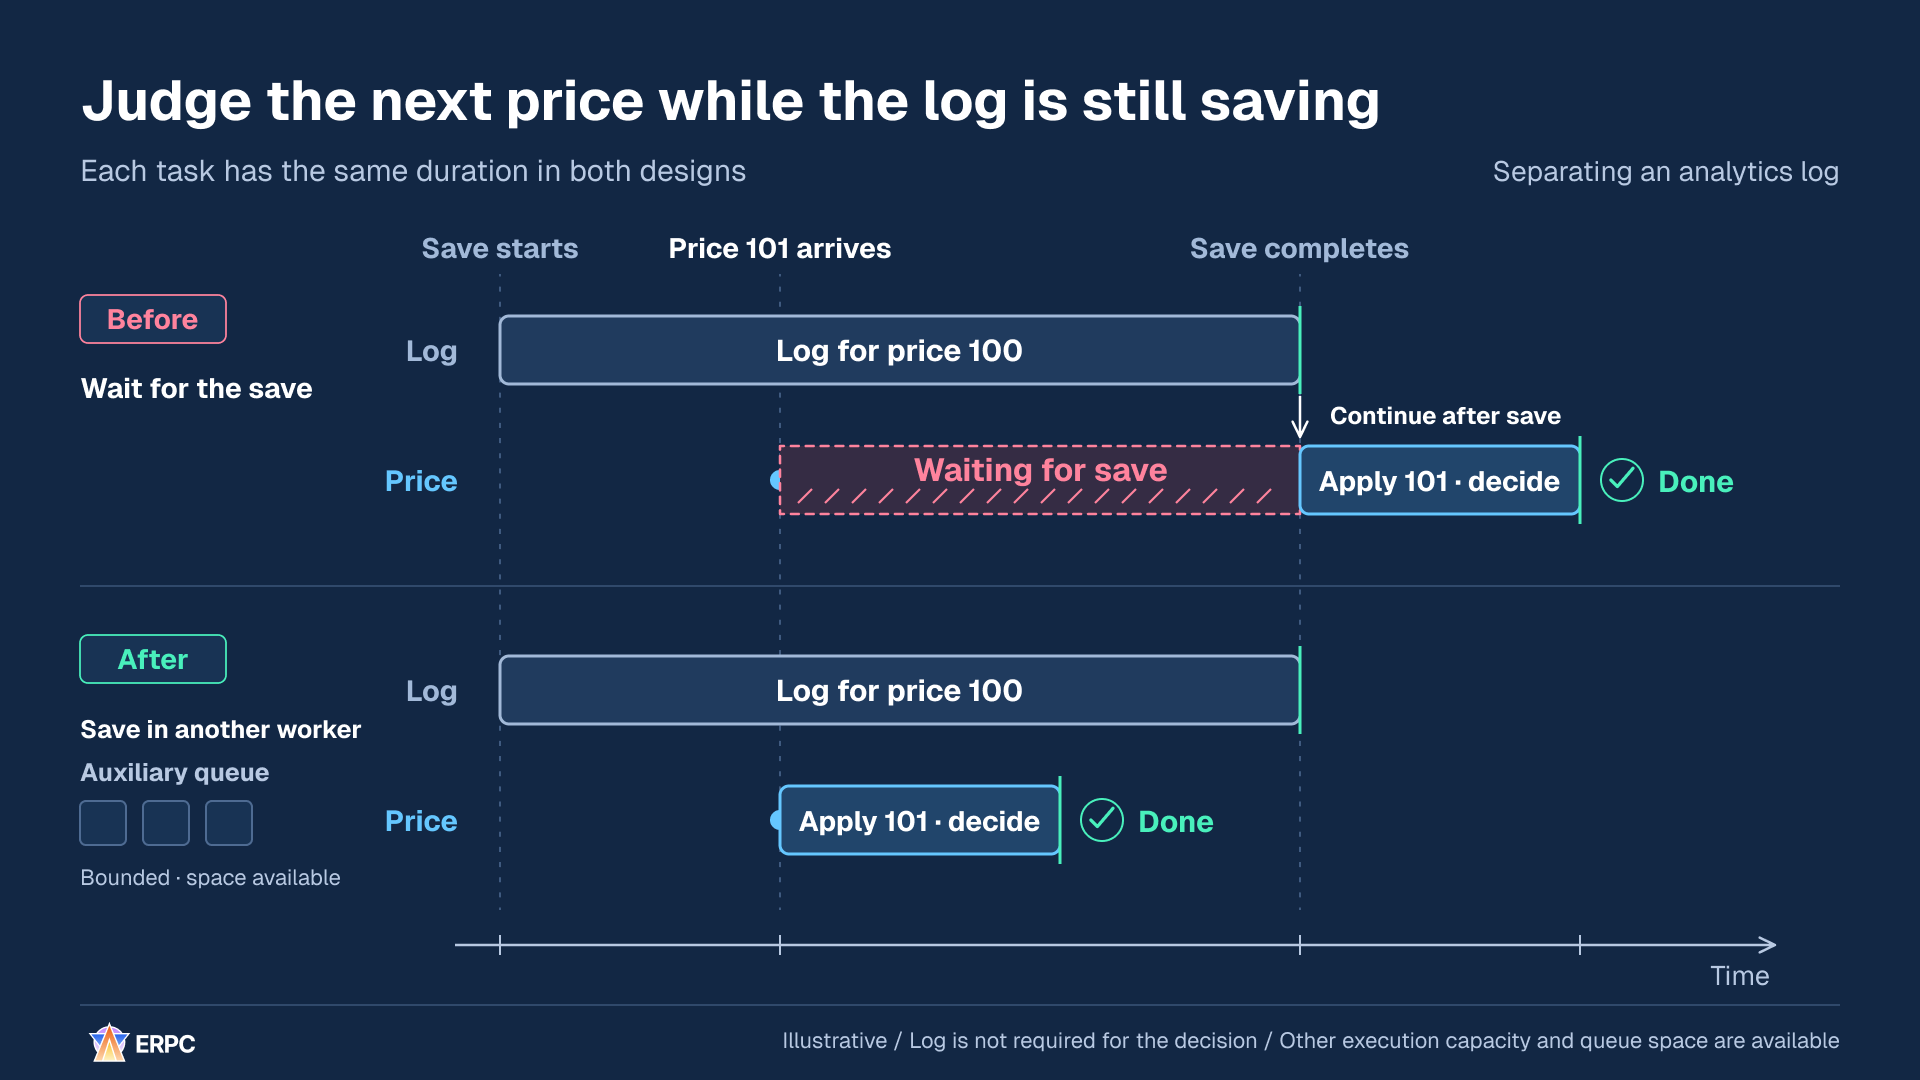
Puedes reducir la espera antes de empezar incluso sin acortar el propio trabajo de 101.
La ruta de procesamiento necesaria desde la recepción hasta la decisión y el envío se denomina hot path. En este ejemplo se aparta de esa ruta el registro analítico que no necesita retrasar la decisión. Las comprobaciones de saldo, las comprobaciones de los límites de riesgo y las escrituras que deben terminar para preservar la corrección permanecen donde lo exijan los requisitos.
El trabajo de almacenamiento sigue existiendo, así que la cola auxiliar también necesita límites de capacidad y espera. Una tarea distinta no se ejecuta necesariamente en una CPU distinta. Las operaciones prolongadas de cálculo o bloqueo en Tokio y las operaciones síncronas largas en el bucle de eventos de Node.js pueden impedir que otro trabajo avance. Al trasladar trabajo, comprueba dónde se ejecutará realmente.[1][2]
Para separar la escritura de registros analíticos de la ruta de decisión, copia estas instrucciones.
text
Mejora esta aplicación cuando esperar a que se guarden los registros analíticos impide aplicar la siguiente actualización o usarla para decidir.

Lee el README, las instrucciones de desarrollo, las dependencias y el bucle de recepción. Trabaja con el lenguaje, el entorno de ejecución y la biblioteca de almacenamiento existentes. Localiza las esperas de finalización del guardado e identifica los hilos, tareas o bucles de eventos donde se ejecuta realmente el trabajo.

1. Prepara entradas reproducibles sin información confidencial. Registra la recepción, la aplicación del estado, el inicio y la finalización de la decisión, el inicio y la finalización del guardado, y los resultados actuales.
2. Determina a partir de los requisitos si completar el guardado es una condición previa para decidir o recuperarse. Mantén las comprobaciones de saldo y riesgo y la persistencia necesaria para la corrección donde sean requeridas. Separa los registros analíticos cuyo guardado pueda terminar más tarde.
3. Define cómo se transfieren los registros para que cambios posteriores del estado no alteren los valores registrados. Implementa una cola auxiliar acotada y un consumidor encargado de guardar. Especifica límites de elementos, bytes y tiempo de espera; el comportamiento ante cola llena, fallos de guardado, reintentos y cierre; y los requisitos de conservación. No descartes registros mientras se desconozcan esos requisitos.
4. No supongas que una tarea separada se ejecuta en otra CPU. Comprueba dónde se ejecutan la E/S síncrona y los trabajos largos de CPU. Si utilizas workers o mecanismos similares, limita la concurrencia e incluye la conversión, la copia y la espera de transferencia en la evaluación.
5. Usa las mismas entradas y el mismo ritmo de llegada para reproducir guardados normales, lentos y fallidos, una cola auxiliar llena y el cierre. Compara p50/p95/p99 desde la recepción hasta la finalización de la decisión, la espera y la acumulación del lado del guardado, CPU y memoria, y registros ausentes o duplicados. Verifica la corrección del estado y de las decisiones y los requisitos de conservación de registros. Usa un reloj monotónico para medir duraciones dentro de un host e indica los límites de la medición.

Respeta las aprobaciones, permisos y procedimientos de desarrollo existentes. Estas instrucciones por sí solas no otorgan permisos adicionales para cambiar producción, contratar servicios de pago ni realizar operaciones reales. No muestres claves privadas, credenciales ni datos de clientes.

Informa de los cambios, las condiciones de comparación, las mediciones antes y después, las comprobaciones de corrección y las limitaciones restantes. Marca como no medidos los valores que no puedan medirse.
Mejora esta aplicación cuando esperar a que se guarden los registros analíticos impide aplicar la siguiente actualización o usarla para decidir.
Lee el README, las instrucciones de desarrollo, las dependencias y el bucle de recepción. Trabaja con el lenguaje, el entorno de ejecución y la biblioteca de almacenamiento existentes. Localiza las esperas de finalización del guardado e identifica los hilos, tareas o bucles de eventos donde se ejecuta realmente el trabajo.
1. Prepara entradas reproducibles sin información confidencial. Registra la recepción, la aplicación del estado, el inicio y la finalización de la decisión, el inicio y la finalización del guardado, y los resultados actuales.
2. Determina a partir de los requisitos si completar el guardado es una condición previa para decidir o recuperarse. Mantén las comprobaciones de saldo y riesgo y la persistencia necesaria para la corrección donde sean requeridas. Separa los registros analíticos cuyo guardado pueda terminar más tarde.
3. Define cómo se transfieren los registros para que cambios posteriores del estado no alteren los valores registrados. Implementa una cola auxiliar acotada y un consumidor encargado de guardar. Especifica límites de elementos, bytes y tiempo de espera; el comportamiento ante cola llena, fallos de guardado, reintentos y cierre; y los requisitos de conservación. No descartes registros mientras se desconozcan esos requisitos.
4. No supongas que una tarea separada se ejecuta en otra CPU. Comprueba dónde se ejecutan la E/S síncrona y los trabajos largos de CPU. Si utilizas workers o mecanismos similares, limita la concurrencia e incluye la conversión, la copia y la espera de transferencia en la evaluación.
5. Usa las mismas entradas y el mismo ritmo de llegada para reproducir guardados normales, lentos y fallidos, una cola auxiliar llena y el cierre. Compara p50/p95/p99 desde la recepción hasta la finalización de la decisión, la espera y la acumulación del lado del guardado, CPU y memoria, y registros ausentes o duplicados. Verifica la corrección del estado y de las decisiones y los requisitos de conservación de registros. Usa un reloj monotónico para medir duraciones dentro de un host e indica los límites de la medición.
Respeta las aprobaciones, permisos y procedimientos de desarrollo existentes. Estas instrucciones por sí solas no otorgan permisos adicionales para cambiar producción, contratar servicios de pago ni realizar operaciones reales. No muestres claves privadas, credenciales ni datos de clientes.
Informa de los cambios, las condiciones de comparación, las mediciones antes y después, las comprobaciones de corrección y las limitaciones restantes. Marca como no medidos los valores que no puedan medirse.3. No hagas que las actualizaciones independientes esperen al mismo bloqueo
Considera una aplicación que puede actualizar de forma independiente los precios de los mercados A y B. Una actualización de B llega después de que haya empezado la de A. Si un solo mutex protege tanto A como B, B tiene que esperar hasta que A libere ese bloqueo.
Un mutex concede a una sola operación a la vez el derecho de acceder a los datos protegidos. Si otra operación lo está utilizando, la que intenta adquirir el mismo bloqueo espera.[17]
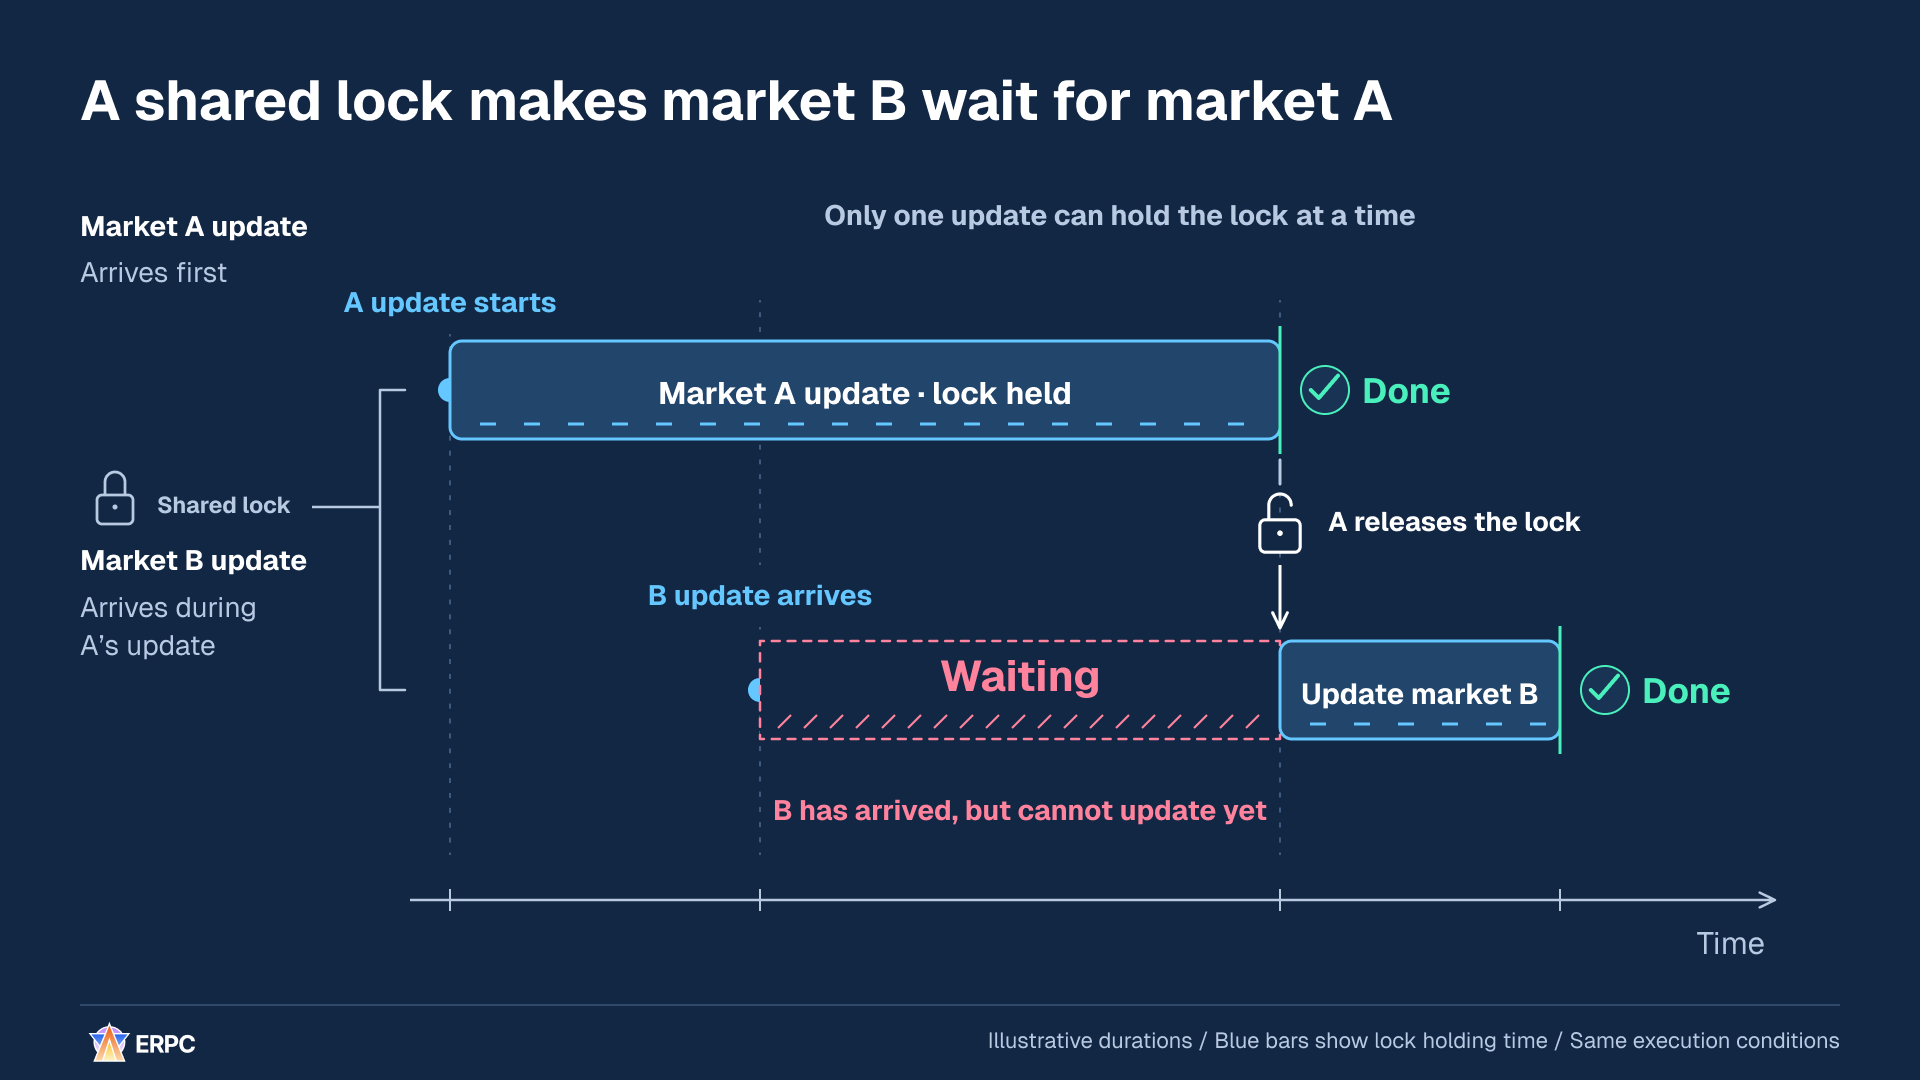
Los datos de B han llegado, pero esperan al bloqueo compartido que mantiene A.
Si A y B modifican valores separados, una opción es protegerlos con bloqueos distintos. La mitad superior del siguiente diagrama utiliza un bloqueo compartido; la inferior utiliza bloqueos separados. Las posiciones de llegada y las duraciones de posesión del bloqueo de A y B son idénticas en ambas mitades. El ejemplo supone que el bloqueo de B está libre y que hay capacidad de ejecución para B. El tutorial oficial de Tokio también describe la partición de mutexes para datos con claves independientes.[18]
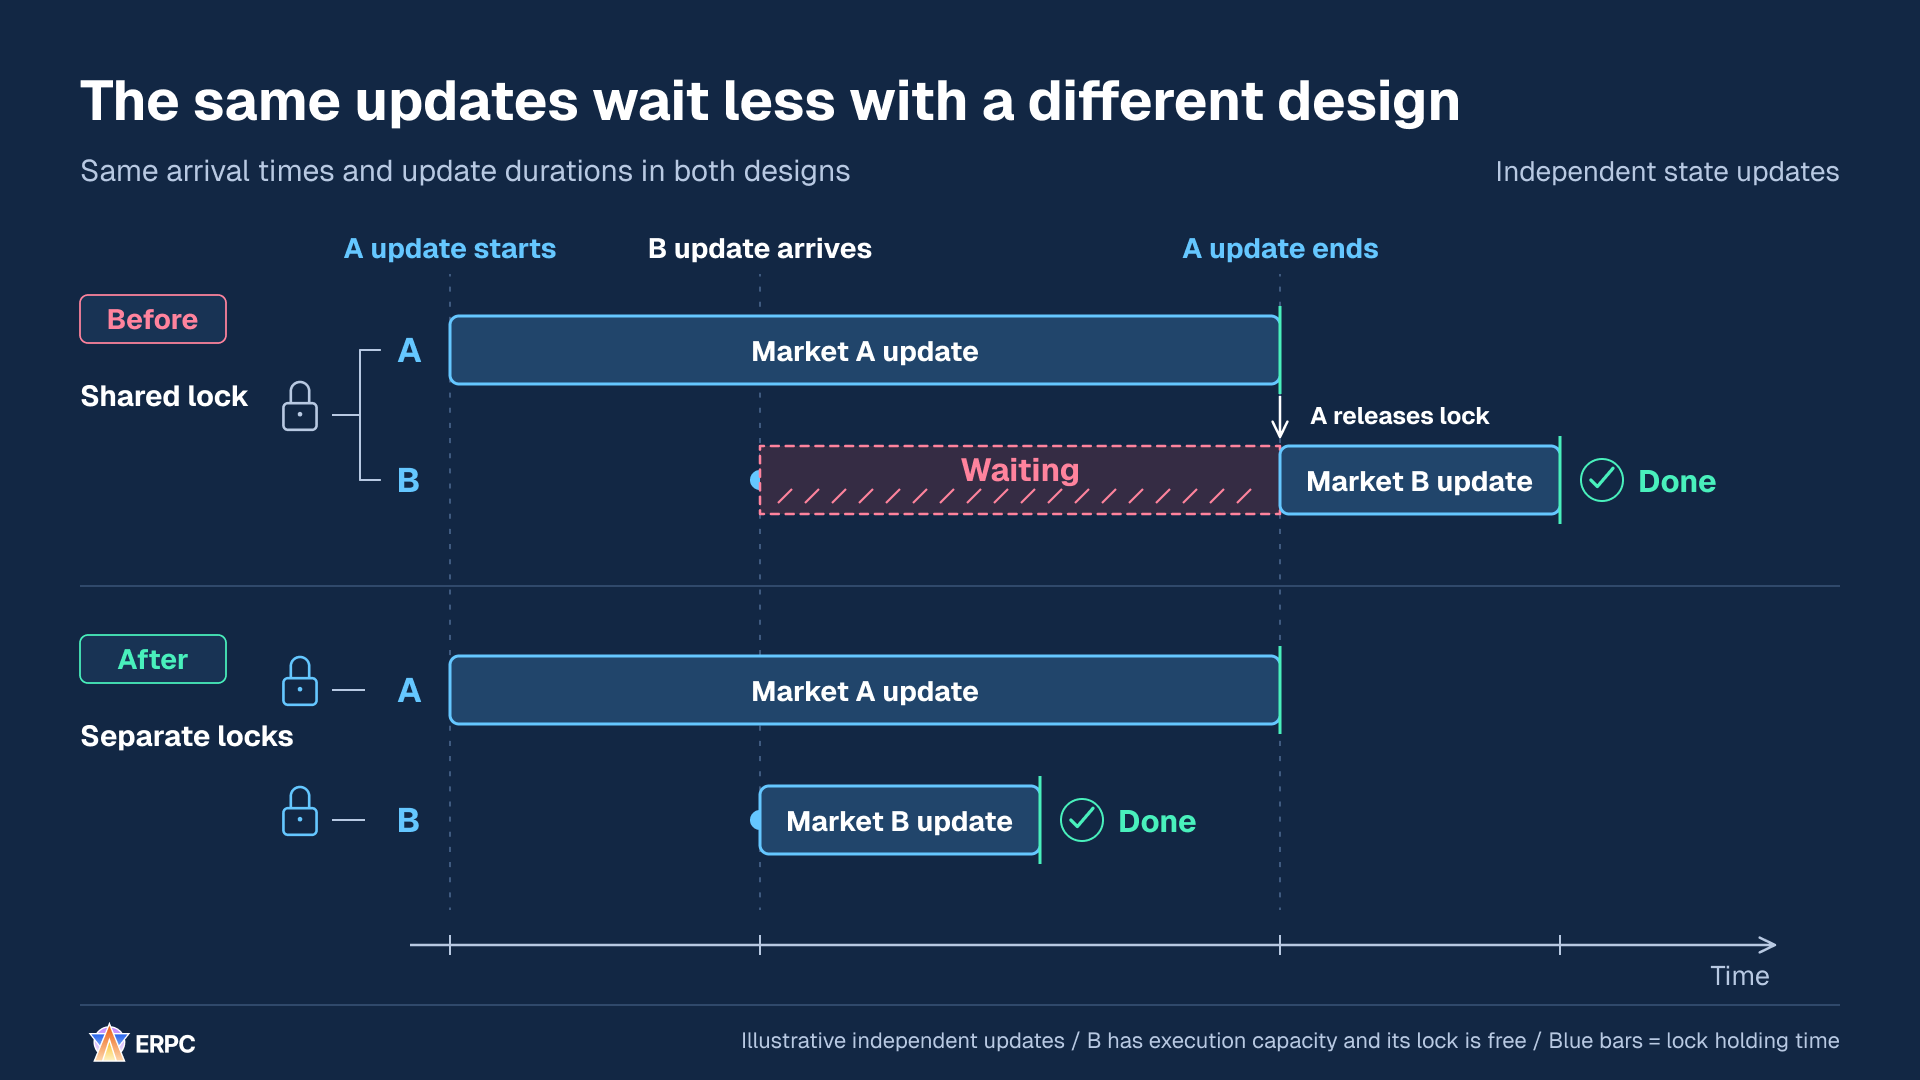
La barra azul de B tiene la misma longitud. Lo eliminado es el intervalo rosa de espera que la precedía.
La barra azul cubre el tiempo desde la adquisición hasta la liberación del bloqueo. En este ejemplo, B termina mientras A sigue actualizándose. Separar los bloqueos no elimina una espera causada porque el propio bloqueo de B esté ocupado o porque otro trabajo use los recursos de ejecución disponibles.
Antes de dividir un bloqueo, determina qué actualizaciones son independientes. Aunque los precios de A y B puedan actualizarse por separado, una decisión que utilice ambos precios o un saldo compartido necesita leer de forma coherente los valores requeridos. Los valores pueden cambiar mientras una operación está suspendida en un await, incluso en el mismo hilo. Define qué versiones lee una decisión, cómo las lee y el orden en que se aplican las actualizaciones.
Por ejemplo, si A y B leen el mismo saldo y cada uno construye una orden, ambos podrían contar con gastar los mismos fondos. Los valores compartidos siguen necesitando protección propia, como un único responsable que compruebe el saldo y reserve fondos para cada orden de forma secuencial.
Otra opción consiste en asignar a cada estado un único responsable de las actualizaciones y enviarle mensajes de actualización. Es el principio Single Writer. Dividir los bloqueos y elegir un único escritor son decisiones de diseño distintas. LMAX Disruptor describe Single Writer y las dependencias de procesamiento; Tokio explica cómo gestionar el estado mediante mensajes a una tarea dedicada.[5][18]
Para reducir la espera por bloqueos entre actualizaciones de estado independientes, copia estas instrucciones.
text
Mejora esta aplicación cuando una actualización de un mercado o una clave hace que otra actualización independiente espere por el mismo bloqueo compartido.

Lee el README, las instrucciones de desarrollo, las dependencias y el código que lee o escribe el estado, adquiere bloqueos o espera otros trabajos mediante await. Usa el lenguaje y el entorno de ejecución existentes. Identifica quién actualiza cada valor y qué conjuntos de valores lee cada decisión.

1. Guarda entradas reproducibles sin información confidencial y registra los valores iniciales. Para los bloqueos con contención, registra las llegadas por clave, la espera de adquisición, el tiempo de retención, el orden de actualización y las versiones del estado usadas para decidir.
2. Distingue los valores que pueden actualizarse de forma independiente de aquellos cuya coherencia debe protegerse conjuntamente. Divide los bloqueos alrededor de estados independientes y explicita el orden de aplicación y la responsabilidad de escritura de cada clave. Controla el número de bloqueos o responsables del procesamiento.
3. Protege las decisiones que abarcan varios mercados y los saldos o reservas de fondos compartidos. Haz de la comprobación del saldo y la reserva una única operación coordinada para que varias órdenes no puedan asumir cada una que los mismos fondos están disponibles. Define un orden de adquisición si hacen falta varios bloqueos.
4. Examina los cambios de estado entre puntos await y el orden de finalización durante la decodificación paralela. Define qué versiones lee una decisión y cómo las lee. No permitas que el orden de finalización de la decodificación sustituya al orden de aplicación requerido. Después de dividir los bloqueos, comprueba si los límites de recursos de ejecución o la contención sobre la misma clave siguen causando espera.
5. Reproduce las mismas entradas y el mismo orden de llegada con claves independientes, actualizaciones concentradas en una clave, reservas competidoras de fondos compartidos y trabajo suspendido y reanudado. Compara la espera por bloqueos, p50/p95/p99 desde la recepción hasta la finalización de la decisión, CPU y memoria. Verifica el orden de actualización requerido, la coherencia del estado usado para decidir y la ausencia de reservas dobles. Usa un reloj monotónico para medir duraciones dentro de un host e indica los límites de la medición.

Respeta las aprobaciones, permisos y procedimientos de desarrollo existentes. Estas instrucciones por sí solas no otorgan permisos adicionales para cambiar producción, contratar servicios de pago ni realizar operaciones reales. No muestres claves privadas, credenciales ni datos de clientes.

Informa de los cambios, las condiciones de comparación, las mediciones antes y después, las comprobaciones de corrección y las limitaciones restantes. Marca como no medidos los valores que no puedan medirse.
Mejora esta aplicación cuando una actualización de un mercado o una clave hace que otra actualización independiente espere por el mismo bloqueo compartido.
Lee el README, las instrucciones de desarrollo, las dependencias y el código que lee o escribe el estado, adquiere bloqueos o espera otros trabajos mediante await. Usa el lenguaje y el entorno de ejecución existentes. Identifica quién actualiza cada valor y qué conjuntos de valores lee cada decisión.
1. Guarda entradas reproducibles sin información confidencial y registra los valores iniciales. Para los bloqueos con contención, registra las llegadas por clave, la espera de adquisición, el tiempo de retención, el orden de actualización y las versiones del estado usadas para decidir.
2. Distingue los valores que pueden actualizarse de forma independiente de aquellos cuya coherencia debe protegerse conjuntamente. Divide los bloqueos alrededor de estados independientes y explicita el orden de aplicación y la responsabilidad de escritura de cada clave. Controla el número de bloqueos o responsables del procesamiento.
3. Protege las decisiones que abarcan varios mercados y los saldos o reservas de fondos compartidos. Haz de la comprobación del saldo y la reserva una única operación coordinada para que varias órdenes no puedan asumir cada una que los mismos fondos están disponibles. Define un orden de adquisición si hacen falta varios bloqueos.
4. Examina los cambios de estado entre puntos await y el orden de finalización durante la decodificación paralela. Define qué versiones lee una decisión y cómo las lee. No permitas que el orden de finalización de la decodificación sustituya al orden de aplicación requerido. Después de dividir los bloqueos, comprueba si los límites de recursos de ejecución o la contención sobre la misma clave siguen causando espera.
5. Reproduce las mismas entradas y el mismo orden de llegada con claves independientes, actualizaciones concentradas en una clave, reservas competidoras de fondos compartidos y trabajo suspendido y reanudado. Compara la espera por bloqueos, p50/p95/p99 desde la recepción hasta la finalización de la decisión, CPU y memoria. Verifica el orden de actualización requerido, la coherencia del estado usado para decidir y la ausencia de reservas dobles. Usa un reloj monotónico para medir duraciones dentro de un host e indica los límites de la medición.
Respeta las aprobaciones, permisos y procedimientos de desarrollo existentes. Estas instrucciones por sí solas no otorgan permisos adicionales para cambiar producción, contratar servicios de pago ni realizar operaciones reales. No muestres claves privadas, credenciales ni datos de clientes.
Informa de los cambios, las condiciones de comparación, las mediciones antes y después, las comprobaciones de corrección y las limitaciones restantes. Marca como no medidos los valores que no puedan medirse.4. Prepara por adelantado las partes que no cambian para reducir el trabajo tras la llegada
Supongamos que cada actualización de precio obliga a la aplicación a analizar el mismo ID fijo, derivar una dirección fija a partir de las mismas entradas y reservar memoria de trabajo. Esta memoria también se llama búfer. Repetir esas tres preparaciones añade el tiempo dedicado a información invariable a la ruta de cada decisión.
La preparación cuyas entradas no cambian puede completarse antes de que lleguen los datos y reutilizarse. Tras recibirlos, la aplicación comprueba la información que cambió para ese evento, construye el mensaje definitivo que enviará y firma ese contenido.
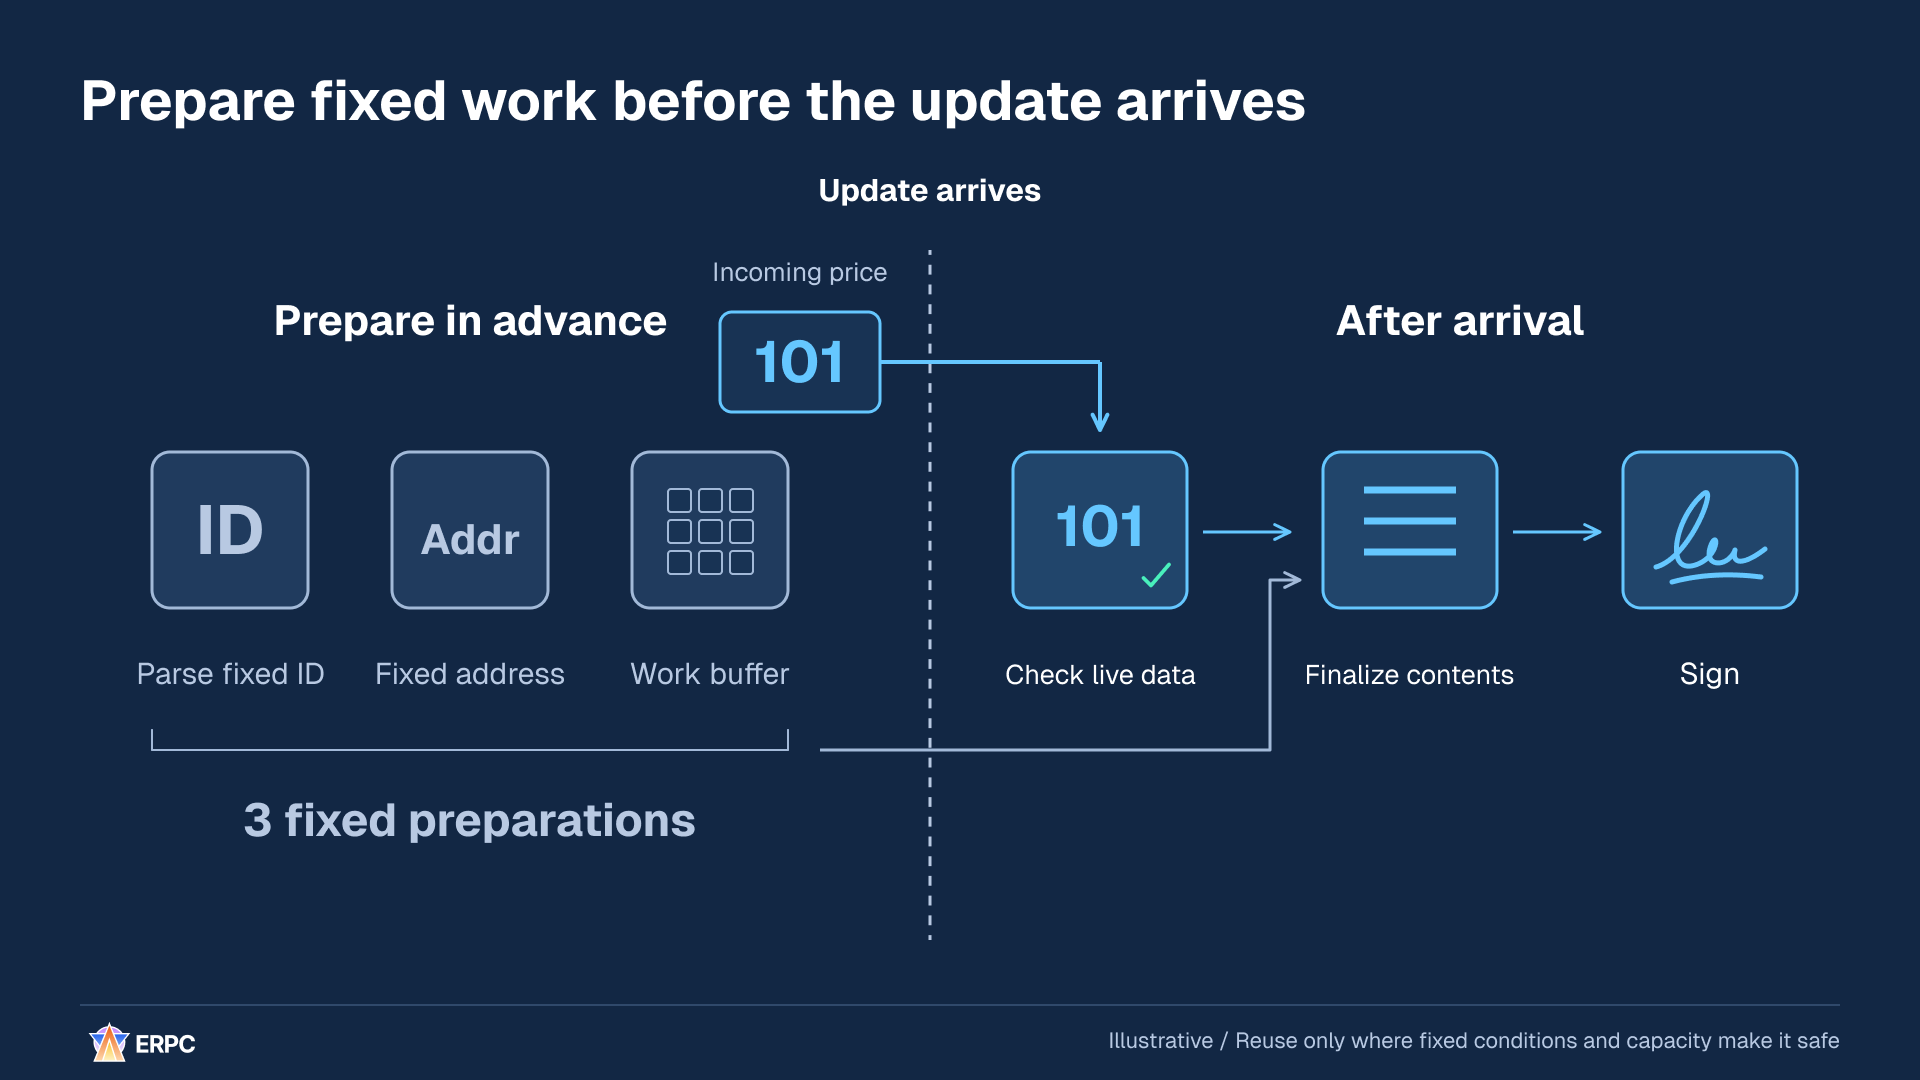
Adelanta la preparación que no cambia y conserva la validación del contenido actual y la firma después de la llegada.
Contemos qué cambia para tres actualizaciones. Preparar tres tipos de elementos para cada evento requiere nueve operaciones de preparación. Preparar esos tres tipos una vez y reutilizarlos secuencialmente requiere tres. Ambos diseños siguen recibiendo tres eventos, procesándolos uno por uno y produciendo tres salidas.
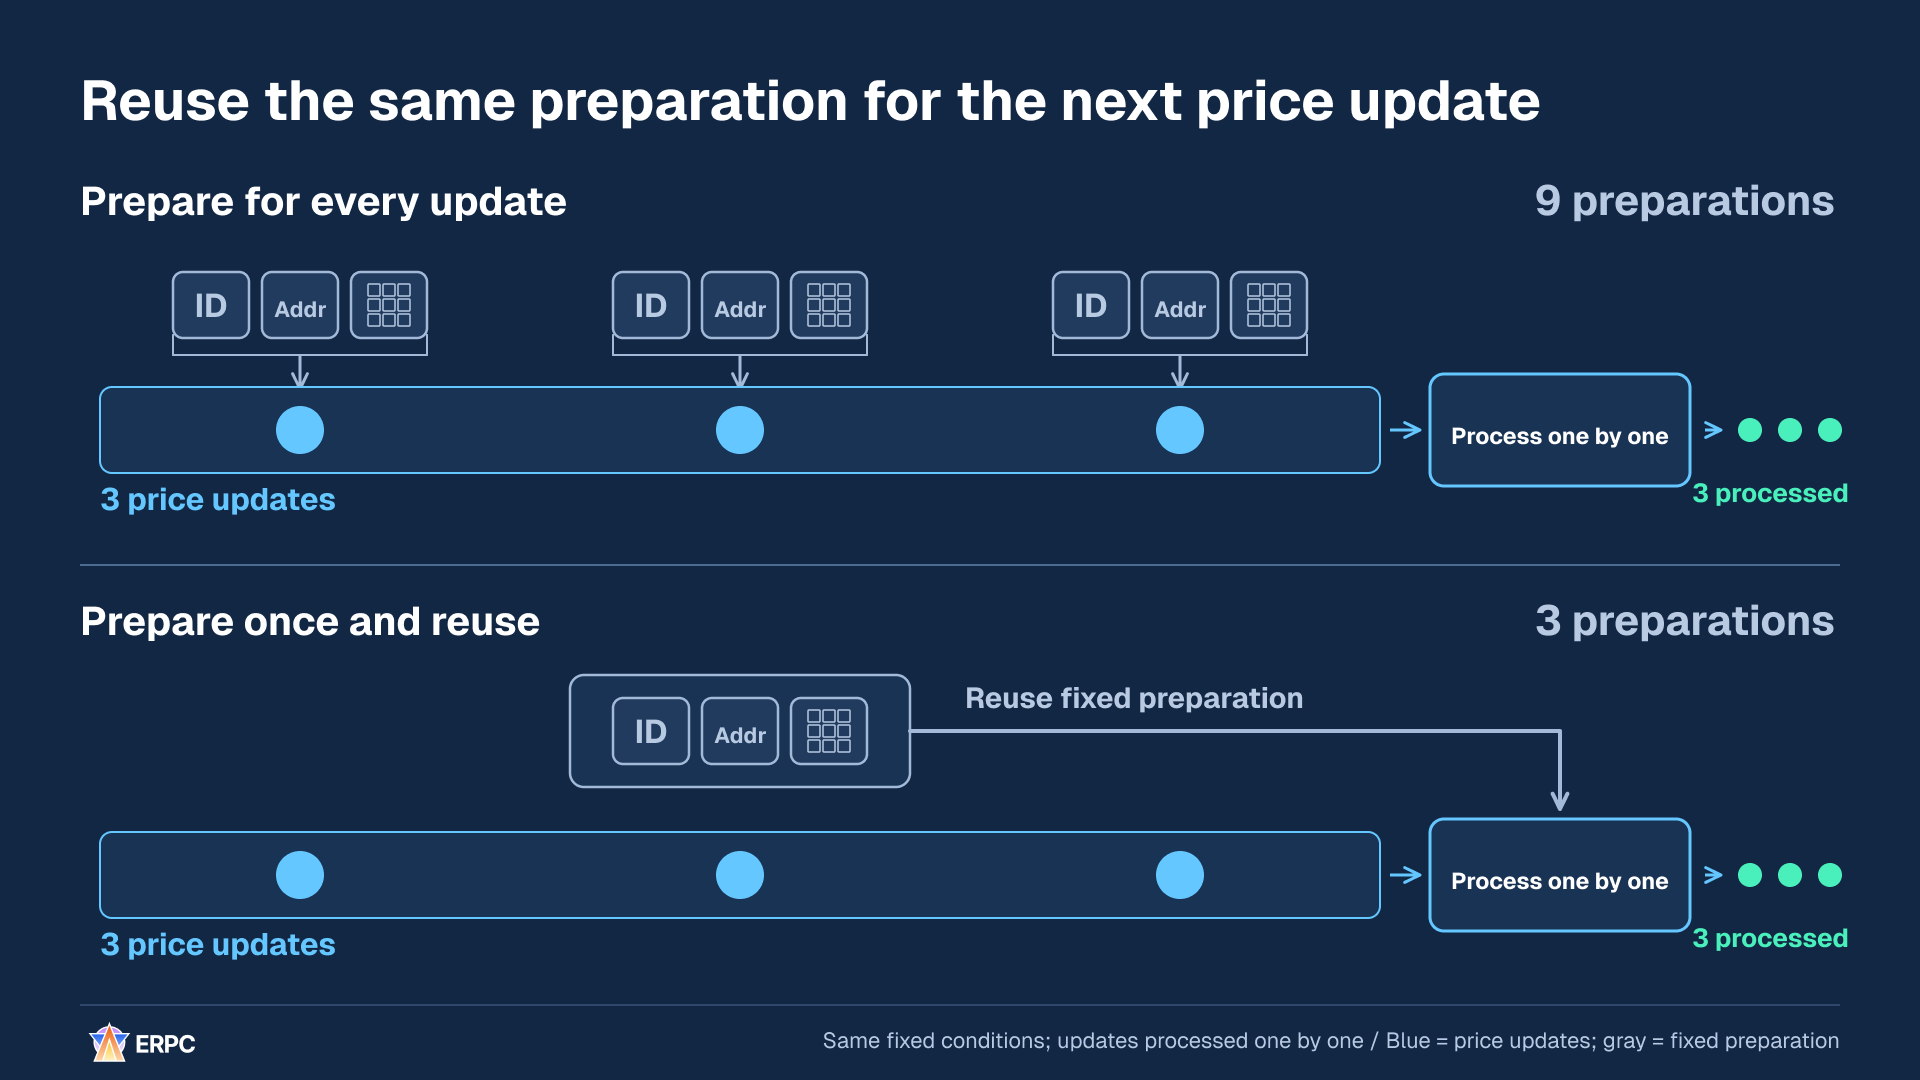
El número de eventos sigue siendo tres, mientras la preparación fija baja de nueve a tres operaciones en este ejemplo.
La comparación supone que las condiciones fijas no cambian y que la memoria de trabajo puede reutilizarse de forma secuencial y segura. Su contenido sigue actualizándose para el evento actual en cada ocasión. Si varias operaciones se ejecutan simultáneamente, usa regiones independientes para cada una o un pool que gestione el acceso, de modo que no sobrescriban la misma memoria.
Ampliemos el ejemplo a 1.000 eventos. Preparar tres tipos de elementos para cada evento requiere 3.000 operaciones; completar una vez la preparación compartida requiere tres. Ambos diseños reciben 1.000 eventos, los procesan uno por uno y producen 1.000 salidas. Distingue el número de preparaciones del número de eventos procesados.
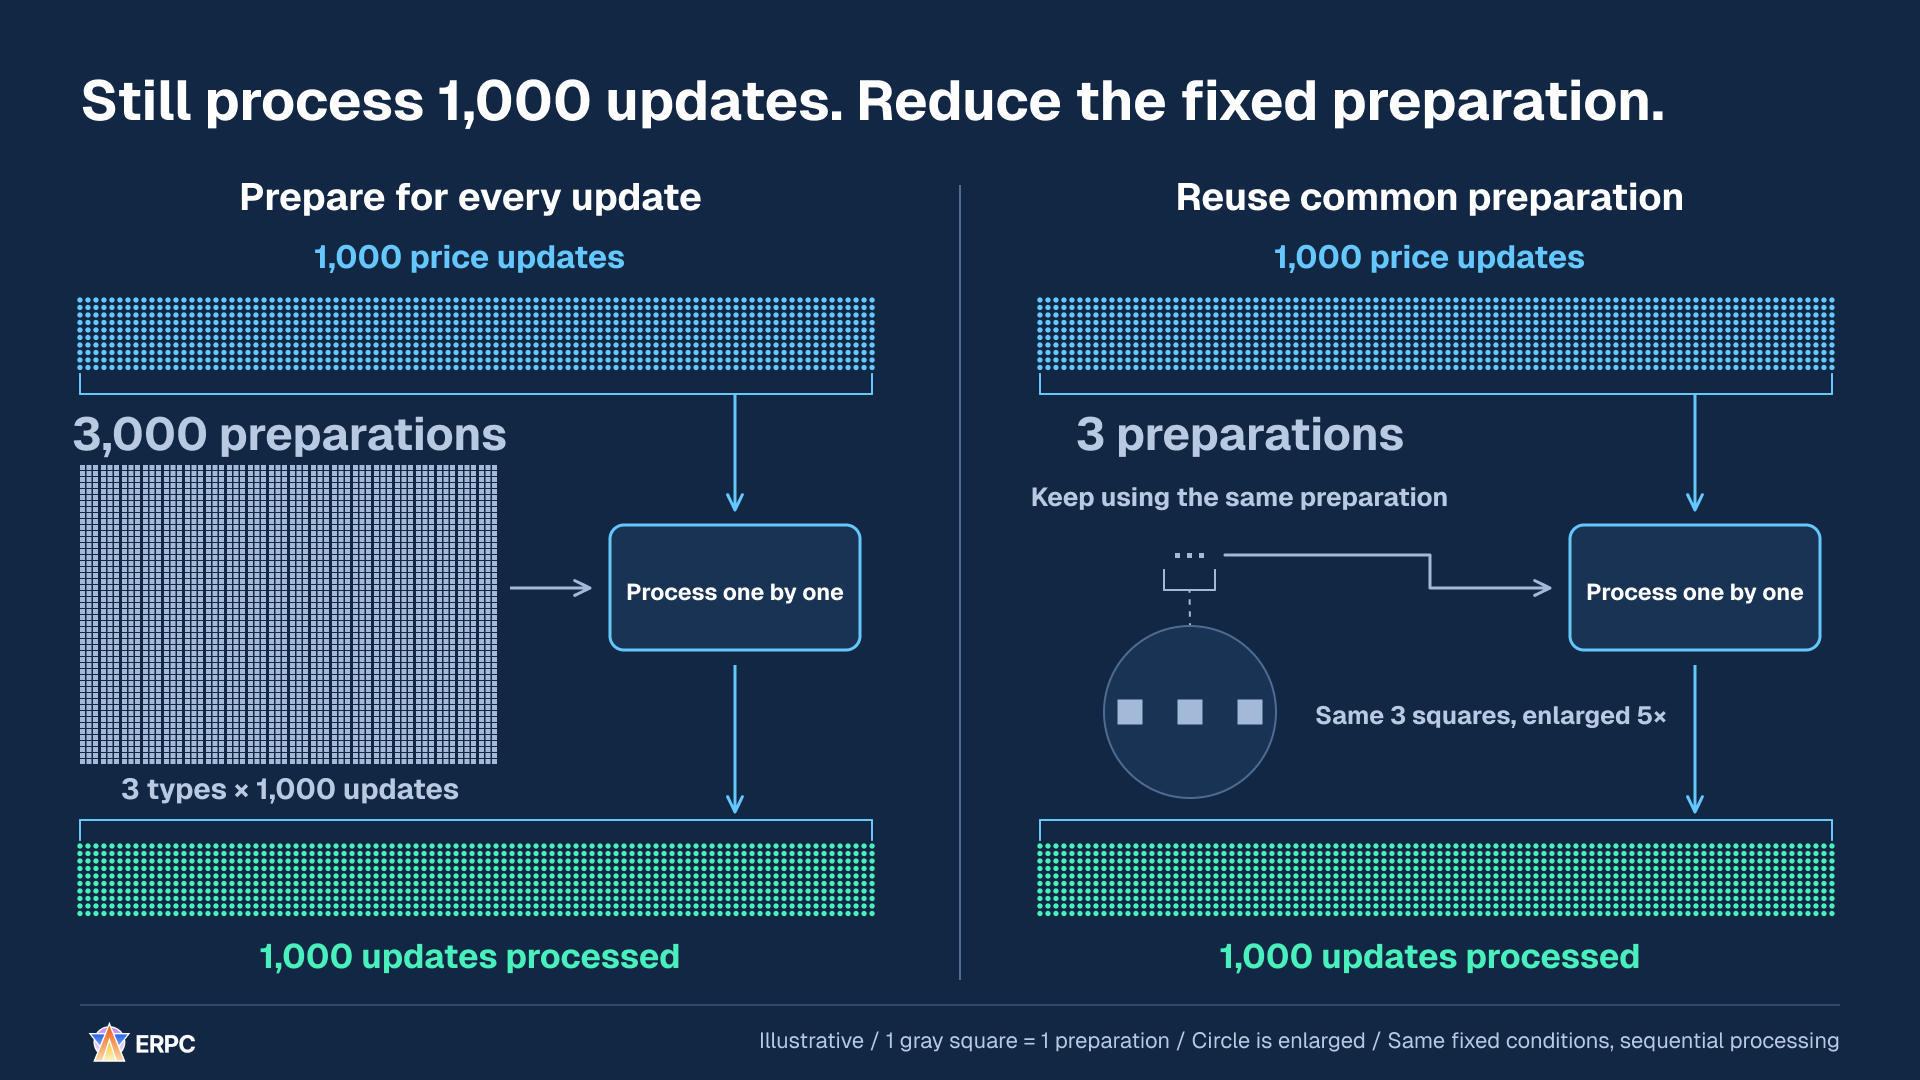
Lo que disminuye es la preparación fija repetida. La validación, las decisiones, las firmas y otras tareas siguen siendo necesarias, por lo que la proporción entre esos números no representa la aceleración de toda la aplicación.
Define las condiciones bajo las que la reutilización sigue siendo válida. Si cambia una entrada utilizada para derivar la dirección fija, hay que recalcularla. Los precios, las cantidades, los saldos, el estado de las cuentas referenciadas, los límites de riesgo y los blockhashes deben ser válidos cuando la decisión los utiliza. Si la aplicación mantiene un estado local actualizado continuamente, verifica su versión, actualidad y validez. Eso no exige necesariamente volver a obtenerlo todo mediante RPC para cada decisión.
getLatestBlockhash de Solana devuelve un blockhash y su lastValidBlockHeight. Al comprobar el vencimiento, distingue entre altura de bloque y slot.[7] Finaliza el mensaje antes de firmarlo. Si lo modificas después de la firma, genera firmas para el contenido actualizado.[19]
Para reutilizar la preparación fija y reducir el trabajo después de recibir los datos, copia estas instrucciones.
text
Examina el trabajo que repite el mismo análisis, derivación de direcciones o asignación de memoria para cada entrada y adelanta la preparación reutilizable a antes de la recepción.

Lee el README, las instrucciones de desarrollo, las dependencias y el código de recepción → preparación → decisión → construcción del mensaje → firma. Usa el lenguaje, el entorno de ejecución y el SDK existentes. Identifica las entradas, salidas, responsable y período de validez de cada preparación.

1. Guarda entradas reproducibles sin información confidencial. Registra los números de eventos y salidas, el número de ejecuciones y la duración de cada preparación, la memoria asignada y la duración desde la recepción hasta la finalización de la decisión.
2. Identifica preparaciones cuyas entradas no cambien, realízalas durante la inicialización u otra etapa anterior apropiada y reutiliza sus resultados. Implementa claves de reutilización, invalidación y recálculo cuando cambien las entradas o la configuración, y límites para cachés y grupos de buffers.
3. Actualiza la memoria de trabajo reutilizable para la entrada actual. Para trabajo concurrente, usa regiones separadas o préstamos gestionados para evitar que una región se sobrescriba o se devuelva mientras siga en uso.
4. Valida precios, cantidades, saldos, estado de cuentas, condiciones de riesgo y blockhashes según los requisitos de la decisión. Comprueba la versión y la frescura al usar estado local actualizado continuamente. En Solana, distingue la altura de bloque del slot cuando utilices lastValidBlockHeight para comprobar la caducidad de un blockhash. Finaliza el mensaje antes de firmarlo y vuelve a firmar el mensaje actualizado si su contenido cambia después de la firma.
5. Con las mismas entradas, compara el número y la duración de las preparaciones, p50/p95/p99 desde la recepción hasta la finalización de la decisión, CPU y memoria, y las salidas. Reproduce también cambios de entrada o configuración, caducidad y ejecución concurrente para detectar la reutilización de resultados obsoletos y los conflictos de memoria. No interpretes la relación entre números de preparaciones como el factor de aceleración global. Usa un reloj monotónico para medir duraciones dentro de un host e indica los límites de la medición.

Respeta las aprobaciones, permisos y procedimientos de desarrollo existentes. Estas instrucciones por sí solas no otorgan permisos adicionales para cambiar producción, contratar servicios de pago ni realizar operaciones reales. No muestres claves privadas, credenciales ni datos de clientes.

Informa de los cambios, las condiciones de comparación, las mediciones antes y después, las comprobaciones de corrección y las limitaciones restantes. Marca como no medidos los valores que no puedan medirse.
Examina el trabajo que repite el mismo análisis, derivación de direcciones o asignación de memoria para cada entrada y adelanta la preparación reutilizable a antes de la recepción.
Lee el README, las instrucciones de desarrollo, las dependencias y el código de recepción → preparación → decisión → construcción del mensaje → firma. Usa el lenguaje, el entorno de ejecución y el SDK existentes. Identifica las entradas, salidas, responsable y período de validez de cada preparación.
1. Guarda entradas reproducibles sin información confidencial. Registra los números de eventos y salidas, el número de ejecuciones y la duración de cada preparación, la memoria asignada y la duración desde la recepción hasta la finalización de la decisión.
2. Identifica preparaciones cuyas entradas no cambien, realízalas durante la inicialización u otra etapa anterior apropiada y reutiliza sus resultados. Implementa claves de reutilización, invalidación y recálculo cuando cambien las entradas o la configuración, y límites para cachés y grupos de buffers.
3. Actualiza la memoria de trabajo reutilizable para la entrada actual. Para trabajo concurrente, usa regiones separadas o préstamos gestionados para evitar que una región se sobrescriba o se devuelva mientras siga en uso.
4. Valida precios, cantidades, saldos, estado de cuentas, condiciones de riesgo y blockhashes según los requisitos de la decisión. Comprueba la versión y la frescura al usar estado local actualizado continuamente. En Solana, distingue la altura de bloque del slot cuando utilices lastValidBlockHeight para comprobar la caducidad de un blockhash. Finaliza el mensaje antes de firmarlo y vuelve a firmar el mensaje actualizado si su contenido cambia después de la firma.
5. Con las mismas entradas, compara el número y la duración de las preparaciones, p50/p95/p99 desde la recepción hasta la finalización de la decisión, CPU y memoria, y las salidas. Reproduce también cambios de entrada o configuración, caducidad y ejecución concurrente para detectar la reutilización de resultados obsoletos y los conflictos de memoria. No interpretes la relación entre números de preparaciones como el factor de aceleración global. Usa un reloj monotónico para medir duraciones dentro de un host e indica los límites de la medición.
Respeta las aprobaciones, permisos y procedimientos de desarrollo existentes. Estas instrucciones por sí solas no otorgan permisos adicionales para cambiar producción, contratar servicios de pago ni realizar operaciones reales. No muestres claves privadas, credenciales ni datos de clientes.
Informa de los cambios, las condiciones de comparación, las mediciones antes y después, las comprobaciones de corrección y las limitaciones restantes. Marca como no medidos los valores que no puedan medirse.5. No sigas decidiendo después de perder actualizaciones necesarias
Considera dos mercados del mismo activo y una aplicación que calcula la diferencia de precios B−A. Durante una desconexión, el mercado A cambia de 100 a 105 y la aplicación pierde esa actualización. Si después de reconectarse solo recibe el precio 104 de B, calcula 104−100, es decir, +4. Con el valor actualizado de A obtiene 104−105, es decir, -1. Incluso cambia el signo.
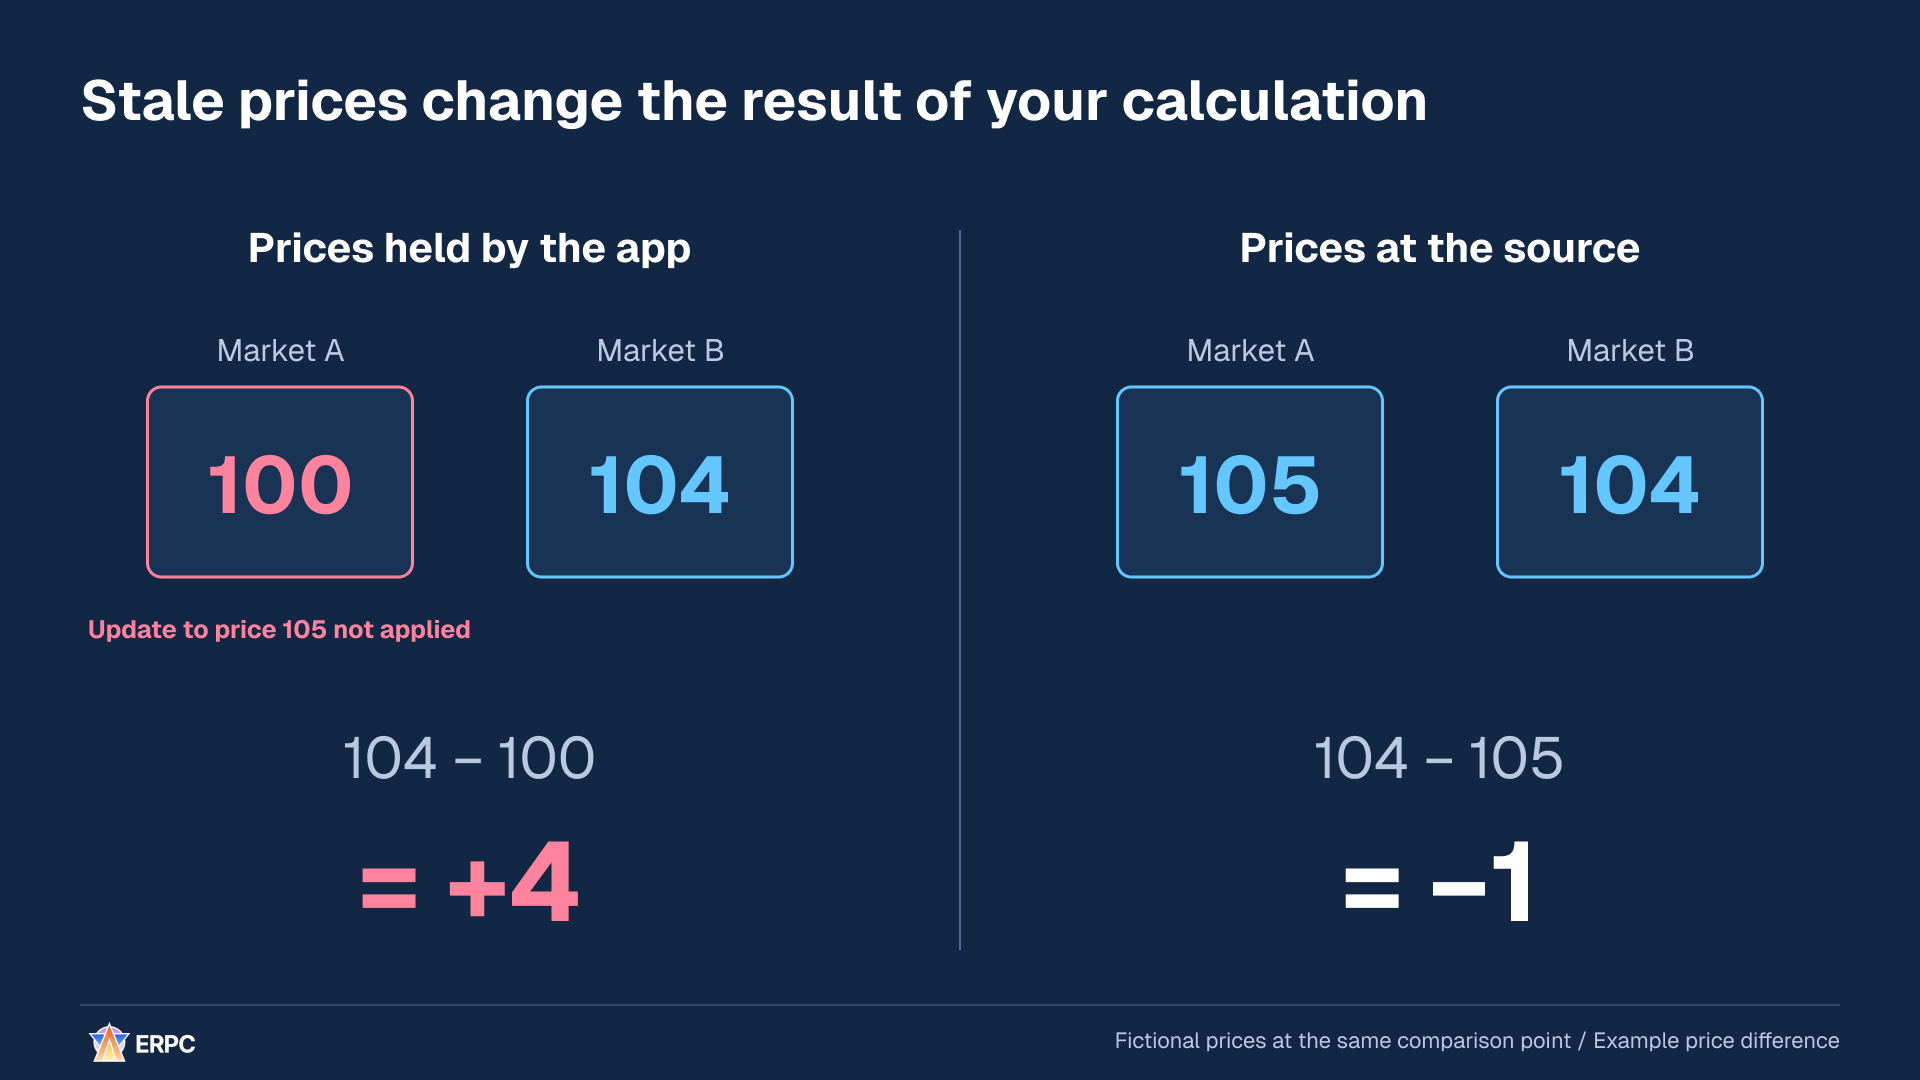
El mismo cálculo cambia según utilice el valor antiguo 100 de A o el valor actualizado 105.
Este modelo solo muestra una diferencia de precios. Excluye comisiones, condiciones de ejecución y otros factores, y no representa beneficios de trading. Su objetivo es mostrar que recuperar la conexión no recupera necesariamente todas las actualizaciones requeridas para decidir.
En este ejemplo, pausa las nuevas decisiones de trading que utilicen los precios de A y B y sustituye el valor antiguo 100 de A por el valor recuperado 105. Después, verifica que se hayan aplicado las actualizaciones necesarias a A y B y que se cumplan las condiciones de orden y actualidad. Reanuda cuando terminen las comprobaciones necesarias; si no pueden completarse, mantén la pausa.
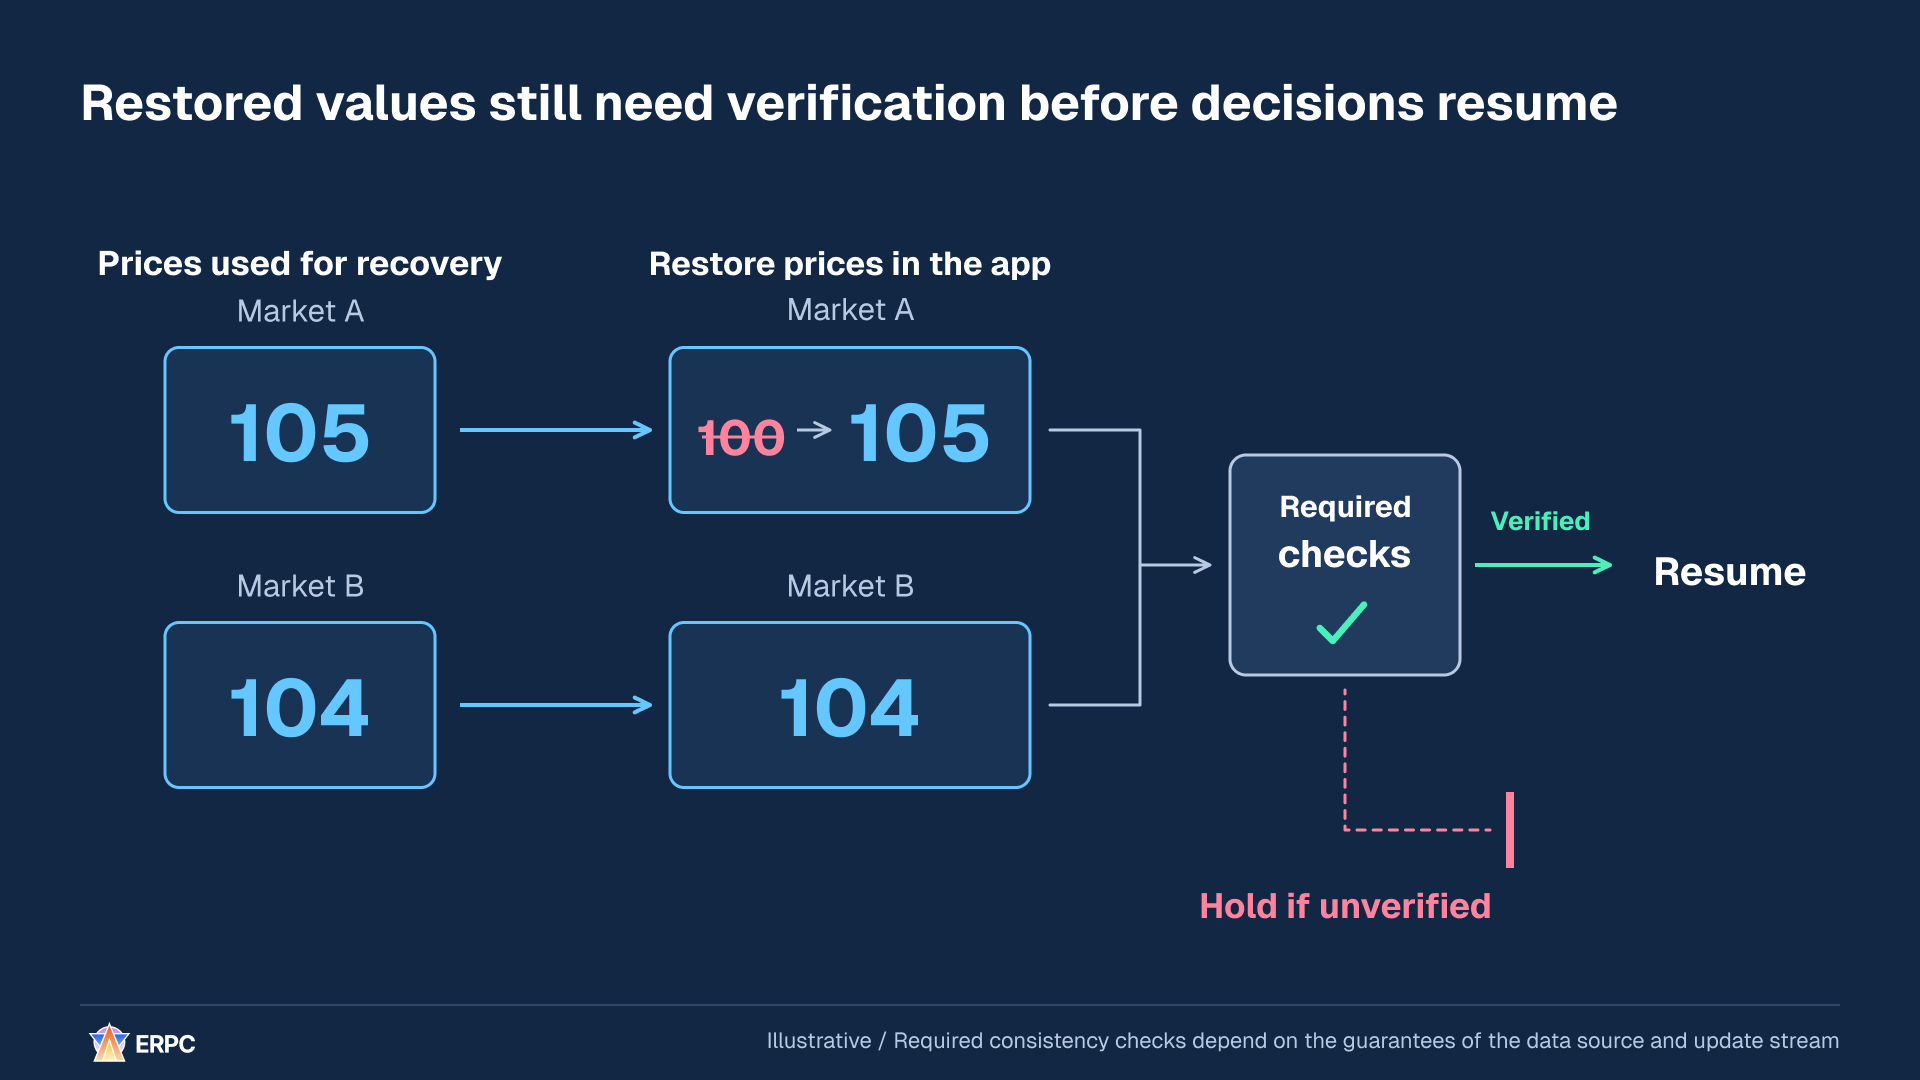
Separa la actualización de los valores de la comprobación de que pueden utilizarse para decidir.
Un mecanismo habitual de recuperación es una instantánea o snapshot: una representación del estado en un momento concreto. Al conectarlo con un flujo continuo de actualizaciones, determina cuáles ya están incluidas y cuáles deben aplicarse a continuación. Así evitas aplicar dos veces una diferencia ya incluida o perder una actualización en el límite. El método específico debe seguir las garantías de la API elegida para el inicio de suscripciones, identificación, nueva obtención y reproducción.
Los mensajes de Yellowstone incluyen campos como slot y write_version.[16] Su mera presencia no garantiza una secuencia utilizable entre proveedores ni una detección completa de actualizaciones ausentes. No conviertas directamente una diferencia de slots en un número de actualizaciones perdidas o en segundos de latencia. Verifica que el estado se haya reconectado conforme a las garantías del proveedor seleccionado.
Ten en cuenta también los cálculos iniciados antes de la recuperación. Una operación que comenzó con un estado antiguo y termina después podría sobrescribir el nuevo estado con su resultado. Una opción es asignar un número de generación al estado durante las recuperaciones y rechazar los resultados de generaciones anteriores. Si utilizas estado processed, incluye también los rollbacks (cuando ese estado deja de adoptarse) como motivo para revisar el estado.[6]
Para recuperar un estado válido antes de reanudar las decisiones tras una reconexión, copia estas instrucciones.
text
Evita que esta aplicación reanude decisiones de trading sobre un estado desactualizado solo porque la conexión ha vuelto. Implementa la recuperación del estado necesario antes de reanudar las decisiones.

Lee el README, las instrucciones de desarrollo, las dependencias y el código de suscripción, obtención inicial, aplicación de actualizaciones, reconexión y decisión. Usa el lenguaje, el entorno de ejecución y el SDK existentes. Verifica el proveedor, el commitment, la semántica de las actualizaciones y las garantías reales de orden, identificación, nueva obtención y reproducción.

1. Distingue el estado de la conexión, la validez de los datos y el permiso para reanudar decisiones. Si se confirma que faltan actualizaciones necesarias o que la frescura es insuficiente, pausa las nuevas decisiones de trading que dependan de ese estado mientras continúan la recepción, las actualizaciones y la recuperación necesarias.
2. Si utilizas un snapshot, establece a partir de las garantías del proveedor qué actualizaciones contiene y su límite con el flujo posterior. Evita la doble aplicación de deltas, los huecos en el límite y un orden de aplicación incorrecto. No rellenes con supuestos las carencias de esas garantías. No trates slot ni write_version como una secuencia incondicional para detectar actualizaciones ausentes.
3. No reanudes solo porque se hayan obtenido valores. Implementa comprobaciones de las actualizaciones, el orden, la frescura y la coherencia necesarios para las decisiones afectadas, y mantenlas pausadas mientras no puedan completarse esas comprobaciones. Usa generaciones o un mecanismo equivalente para impedir que se apliquen o envíen cálculos o propuestas de órdenes antiguos si un trabajo iniciado antes de la recuperación termina más tarde. Al reanudar, toma nuevas decisiones a partir del estado validado. Si utilizas estado processed, gestiona la invalidación y la recuperación tras un rollback.
4. Con entradas reproducibles sin información confidencial, reproduce actualizaciones perdidas durante una desconexión, duplicados, actualizaciones reordenadas, datos desactualizados, reconexiones repetidas y finalización de trabajo de una generación antigua. Verifica que las decisiones permanezcan pausadas desde la recuperación de la conexión hasta que termine la validación y que el estado validado coincida con el resultado esperado.
5. Registra el tiempo de recuperación, el número de intentos de decisión suprimidos por un estado inválido y la duración de la pausa, las actualizaciones reaplicadas o excluidas, la duración normal desde la recepción hasta la finalización de la decisión, CPU y memoria. No excluyas silenciosamente de las mediciones los períodos de pausa ni las actualizaciones ausentes. Indica los límites de la medición y lo que puede o no puede detectarse. Usa un reloj monotónico para medir duraciones dentro de un host.

Respeta las aprobaciones, permisos y procedimientos de desarrollo existentes. Estas instrucciones por sí solas no otorgan permisos adicionales para cambiar producción, contratar servicios de pago ni realizar operaciones reales. No muestres claves privadas, credenciales ni datos de clientes.

Informa de los cambios, las condiciones de comparación, las mediciones antes y después, las comprobaciones de corrección y las limitaciones restantes. Marca como no medidos los valores que no puedan medirse.
Evita que esta aplicación reanude decisiones de trading sobre un estado desactualizado solo porque la conexión ha vuelto. Implementa la recuperación del estado necesario antes de reanudar las decisiones.
Lee el README, las instrucciones de desarrollo, las dependencias y el código de suscripción, obtención inicial, aplicación de actualizaciones, reconexión y decisión. Usa el lenguaje, el entorno de ejecución y el SDK existentes. Verifica el proveedor, el commitment, la semántica de las actualizaciones y las garantías reales de orden, identificación, nueva obtención y reproducción.
1. Distingue el estado de la conexión, la validez de los datos y el permiso para reanudar decisiones. Si se confirma que faltan actualizaciones necesarias o que la frescura es insuficiente, pausa las nuevas decisiones de trading que dependan de ese estado mientras continúan la recepción, las actualizaciones y la recuperación necesarias.
2. Si utilizas un snapshot, establece a partir de las garantías del proveedor qué actualizaciones contiene y su límite con el flujo posterior. Evita la doble aplicación de deltas, los huecos en el límite y un orden de aplicación incorrecto. No rellenes con supuestos las carencias de esas garantías. No trates slot ni write_version como una secuencia incondicional para detectar actualizaciones ausentes.
3. No reanudes solo porque se hayan obtenido valores. Implementa comprobaciones de las actualizaciones, el orden, la frescura y la coherencia necesarios para las decisiones afectadas, y mantenlas pausadas mientras no puedan completarse esas comprobaciones. Usa generaciones o un mecanismo equivalente para impedir que se apliquen o envíen cálculos o propuestas de órdenes antiguos si un trabajo iniciado antes de la recuperación termina más tarde. Al reanudar, toma nuevas decisiones a partir del estado validado. Si utilizas estado processed, gestiona la invalidación y la recuperación tras un rollback.
4. Con entradas reproducibles sin información confidencial, reproduce actualizaciones perdidas durante una desconexión, duplicados, actualizaciones reordenadas, datos desactualizados, reconexiones repetidas y finalización de trabajo de una generación antigua. Verifica que las decisiones permanezcan pausadas desde la recuperación de la conexión hasta que termine la validación y que el estado validado coincida con el resultado esperado.
5. Registra el tiempo de recuperación, el número de intentos de decisión suprimidos por un estado inválido y la duración de la pausa, las actualizaciones reaplicadas o excluidas, la duración normal desde la recepción hasta la finalización de la decisión, CPU y memoria. No excluyas silenciosamente de las mediciones los períodos de pausa ni las actualizaciones ausentes. Indica los límites de la medición y lo que puede o no puede detectarse. Usa un reloj monotónico para medir duraciones dentro de un host.
Respeta las aprobaciones, permisos y procedimientos de desarrollo existentes. Estas instrucciones por sí solas no otorgan permisos adicionales para cambiar producción, contratar servicios de pago ni realizar operaciones reales. No muestres claves privadas, credenciales ni datos de clientes.
Informa de los cambios, las condiciones de comparación, las mediciones antes y después, las comprobaciones de corrección y las limitaciones restantes. Marca como no medidos los valores que no puedan medirse.Compara las fortalezas de los lenguajes en seis dimensiones
Implementar estos cinco diseños exige decidir quién actualiza los datos, dónde se asigna memoria, qué se copia y qué operaciones esperan. El cálculo rápido, el control de las demoras repentinas y la rapidez para crear prototipos son fortalezas diferentes. Compara los lenguajes según la parte que quieres mejorar.
Comparar tiempos de ejecución en un benchmark publicado
Estas mediciones publicadas, fechadas el 1 de agosto de 2025, ejecutan un cálculo de cinco cuerpos durante 500.000 pasos. El tiempo medio de ejecución es el tiempo promedio desde el inicio del programa hasta su finalización. Incluye el arranque y la optimización del código durante la ejecución, pero excluye la compilación previa. 1.000 ms equivalen a un segundo.[27][29]
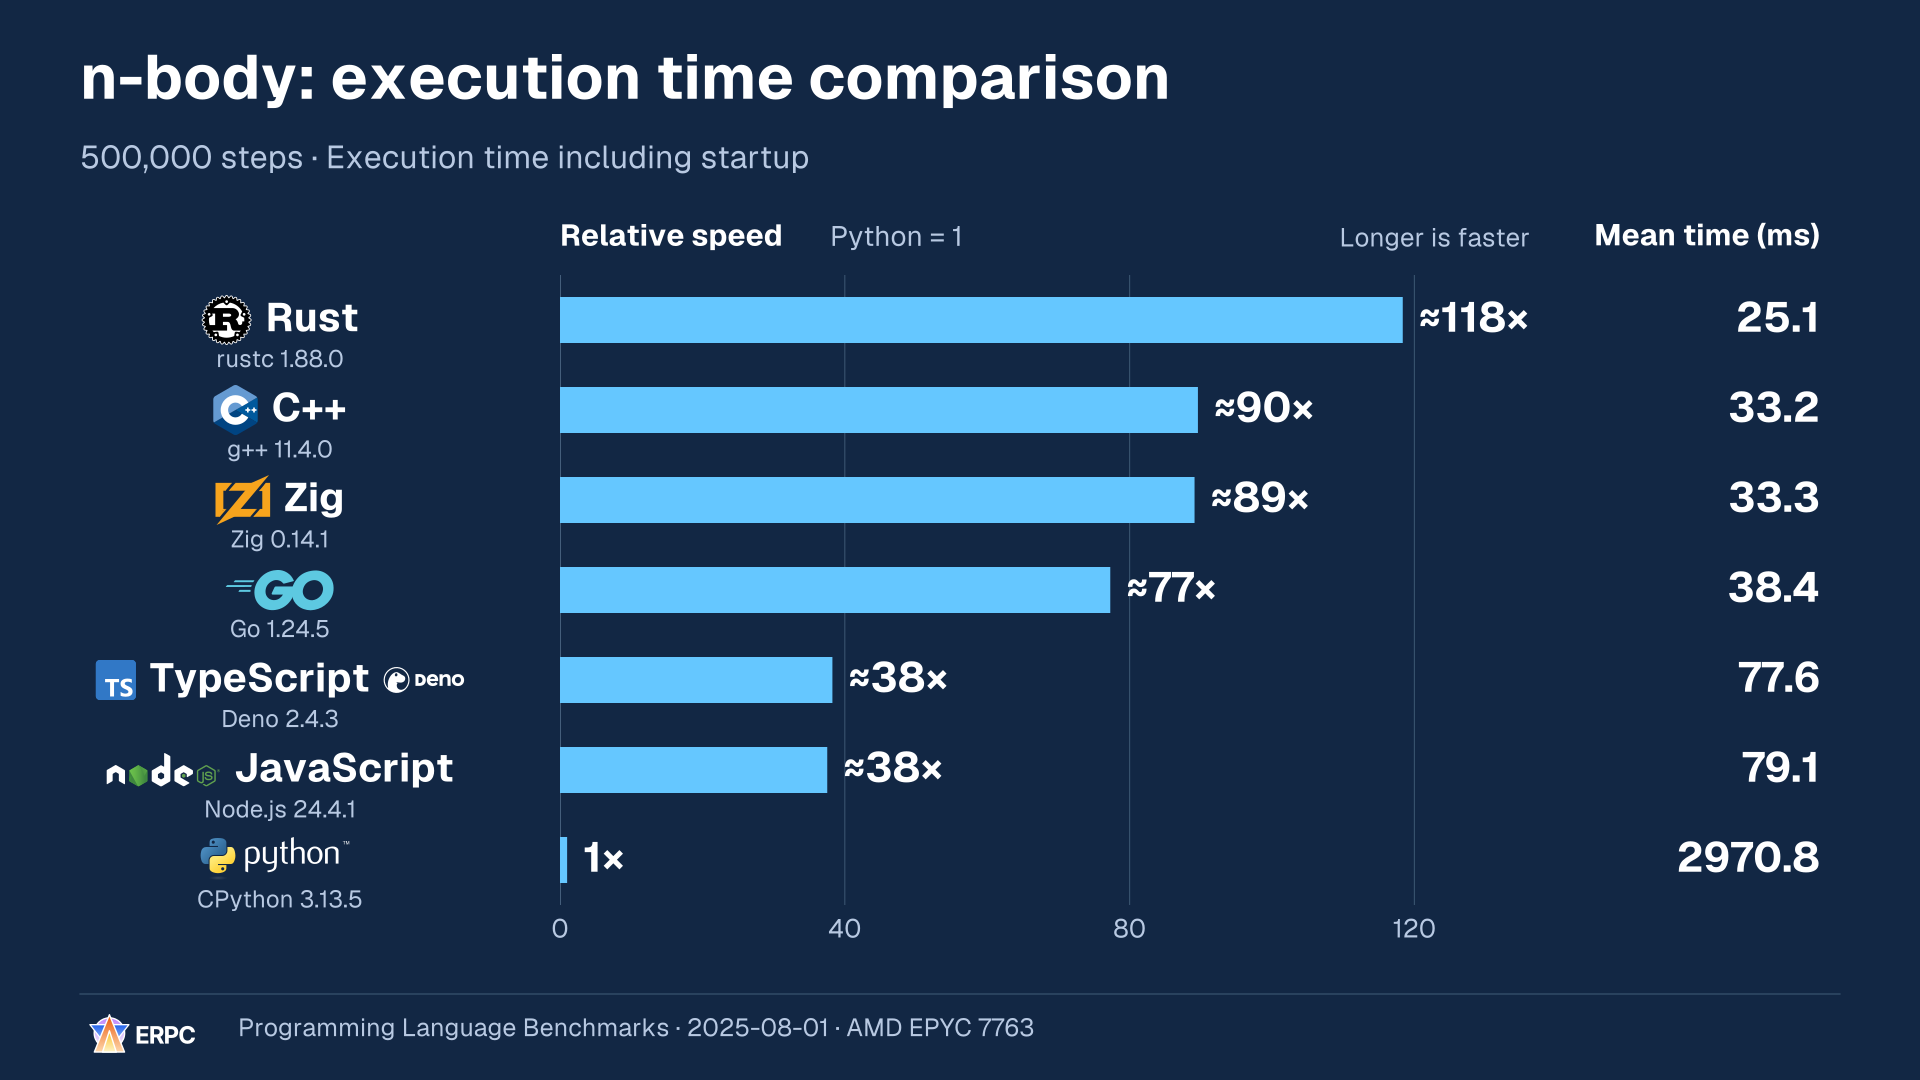
| Lenguaje / entorno | Tiempo medio de ejecución | Velocidad relativa (Python = 1) |
|---|---|---|
| Rust / rustc 1.88.0 | 25.1 ms | ≈118 |
| C++ / g++ 11.4.0 | 33.2 ms | ≈90 |
| Zig / Zig 0.14.1 | 33.3 ms | ≈89 |
| Go / Go 1.24.5 | 38.4 ms | ≈77 |
| TypeScript / Deno 2.4.3 | 77.6 ms | ≈38 |
| JavaScript / Node.js 24.4.1 | 79.1 ms | ≈38 |
| Python / CPython 3.13.5 | 2970.8 ms | 1 |
Las velocidades relativas se calculan con los tiempos medios sin redondear y con Python = 1. Para cada familia de lenguaje y entorno elegimos el menor promedio publicado entre las implementaciones estables cuyo cálculo numérico usa un hilo, sin intrínsecos SIMD explícitos, tipos vectoriales ni bibliotecas numéricas externas. El código y las optimizaciones difieren; Zig usa ReleaseFast. TypeScript se ejecuta como un archivo que incluye Deno/V8, mientras JavaScript usa Node.js.[28]
Interpreta los valores cercanos como resultados comparables, sin convertir esta única tarea en una clasificación general de los lenguajes. No mide directamente el tiempo de procesamiento de un bot que sigue funcionando después del arranque ni la demora hasta que una orden llega a su destino.
El entorno registrado es Linux en un AMD EPYC 7763 con cuatro núcleos disponibles. El código de medición publicado está configurado para tres repeticiones por condición y crea un proceso nuevo cada vez. No se pudieron verificar el commit exacto de aquella ejecución ni las observaciones individuales, por lo que se presentan los promedios publicados.[28][29]
Comparar las fortalezas de diseño en seis dimensiones
Los siguientes diagramas son guías editoriales de selección de tres niveles para un cliente Solana fuera de la cadena. La dimensión Velocidad de cálculo considera opciones para acelerar lecturas intensivas de datos y cálculos escritos directamente en el lenguaje y la implementación comparados. No clasifica aplicaciones enteras dominadas por esperas de red ni cálculos delegados a bibliotecas externas aceleradas.
Rust, Go, C++ y Zig son candidatos sólidos para la ejecución nativa optimizada. Esto no afirma que tengan la misma velocidad; un orden más preciso requiere medir la carga real. V8 también convierte las funciones ejecutadas con frecuencia en código máquina. Describir JavaScript como lento simplemente porque se interpreta sería inexacto.[20][21]
Tres dimensiones, Velocidad de cálculo, Control de latencia y Control de memoria, describen el cálculo y el control. Ayuda a la seguridad, Facilidad de prototipado y SDK Solana describen el apoyo al desarrollo. No todos los seis ejes representan velocidad de procesamiento.
Todos los hexágonos usan los mismos ejes y escala. Cuanto más hacia fuera, mayor es la fortaleza cualitativa en esa dimensión. No son velocidades ni relaciones medidas: un nivel 3 no significa tres veces un nivel 1. Compara las dimensiones concretas que quieres mejorar, en lugar de tratar el área del polígono como una puntuación global.
| Dimensión | Qué compara |
|---|---|
| Velocidad de cálculo | Opciones para acelerar lecturas intensivas de datos y cálculos propios dentro de la implementación comparada |
| Control de latencia | Hasta qué punto pueden mantenerse directamente fuera del procesamiento importante tareas como la asignación y recuperación de memoria y la optimización del código en ejecución, para limitar demoras repentinas |
| Control de memoria | Hasta qué punto puedes diseñar directamente la disposición de los datos, su propiedad y duración de vida, la asignación, la reutilización y la recuperación de memoria |
| Ayuda a la seguridad | Apoyo de las funciones del lenguaje, los entornos de ejecución y las herramientas estándar para evitar errores de duración de vida y memoria compartida |
| Facilidad de prototipado | Facilidad para ejecutar una aplicación pequeña y probar cambios; una valoración editorial que depende de la experiencia y del código existente |
| SDK Solana | Facilidad con la que la documentación oficial de Solana conduce a SDK de cliente y ejemplos para el uso previsto |
Las dimensiones de control evalúan opciones directas de diseño, la seguridad evalúa el apoyo disponible y la dimensión SDK evalúa el acceso desde la documentación oficial. Un mismo nivel puede representar mecanismos y garantías diferentes.[8][13][20][21][26]
La vista general compara seis lenguajes en tres columnas y dos filas: Rust, Go, TypeScript, Python, C++ y Zig. Compara las dimensiones que te interesan y después consulta los diagramas individuales y las explicaciones siguientes para comprobar los supuestos sobre el entorno de ejecución y los usos adecuados.
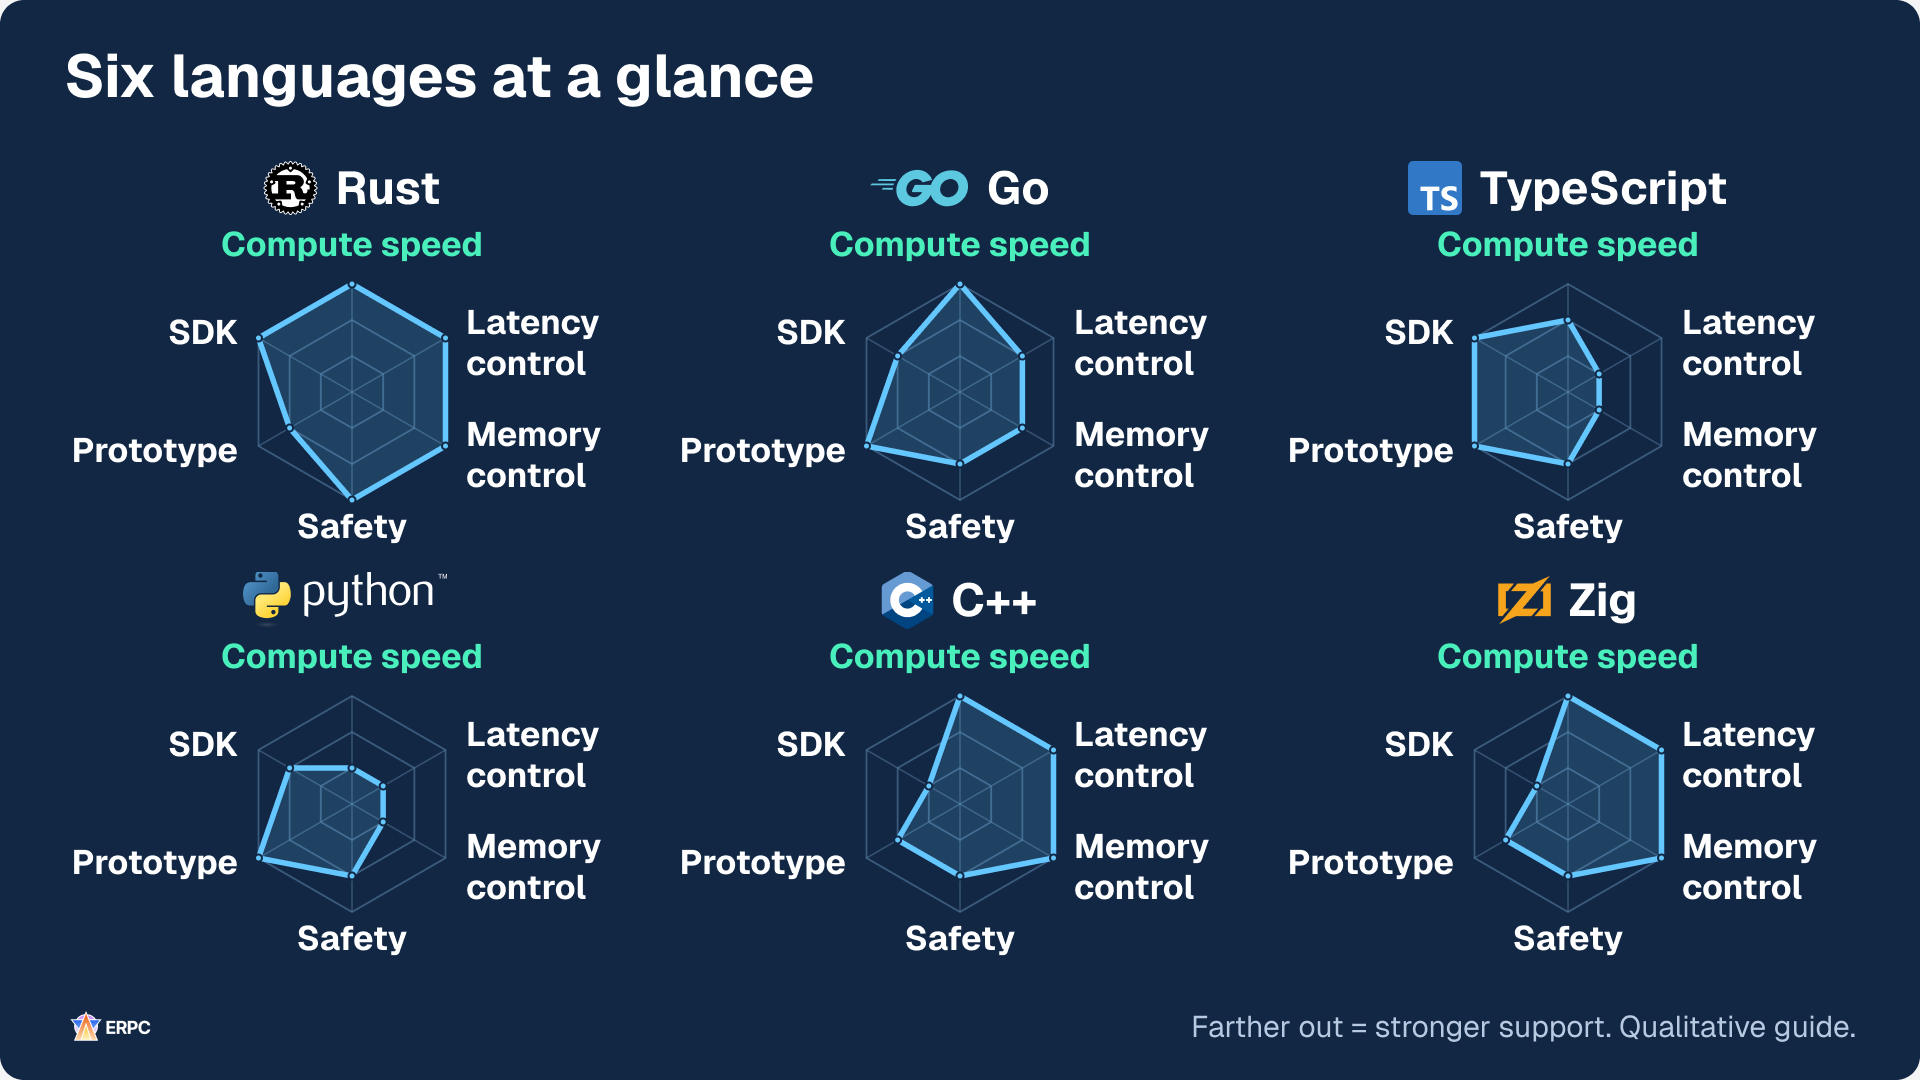
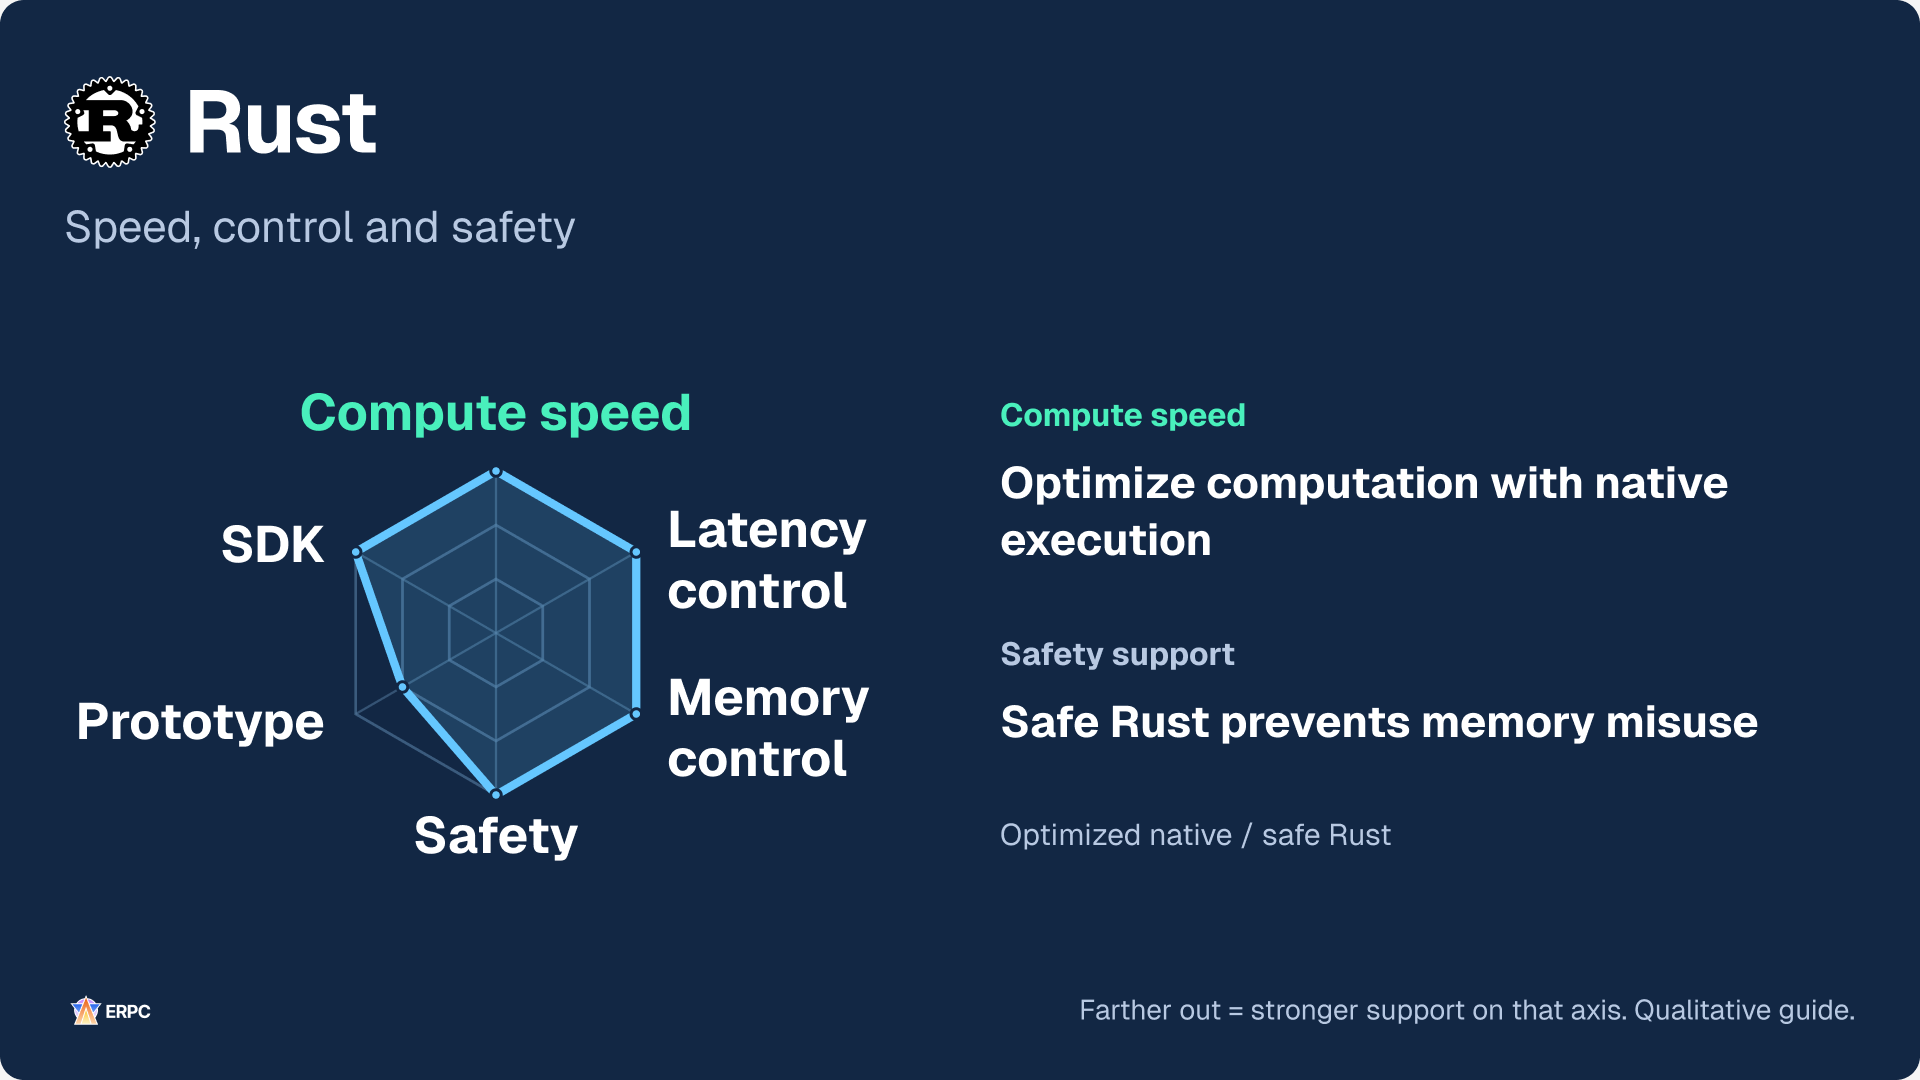
Rust combina el control de la disposición, asignación y reutilización en rutas importantes con comprobaciones de propiedad y préstamos. Su gestión habitual de memoria no requiere GC por trazado.[8] Las garantías de Safe Rust contra data races no garantizan la ausencia de condiciones de carrera generales, interbloqueos ni errores en la lógica de decisión. El código unsafe y las interfaces con otros lenguajes requieren una verificación aparte.[22] Siguen existiendo copias, asignaciones, liberaciones, bloqueos y esperas del sistema operativo, por lo que hay que probar con las entradas y la carga reales.
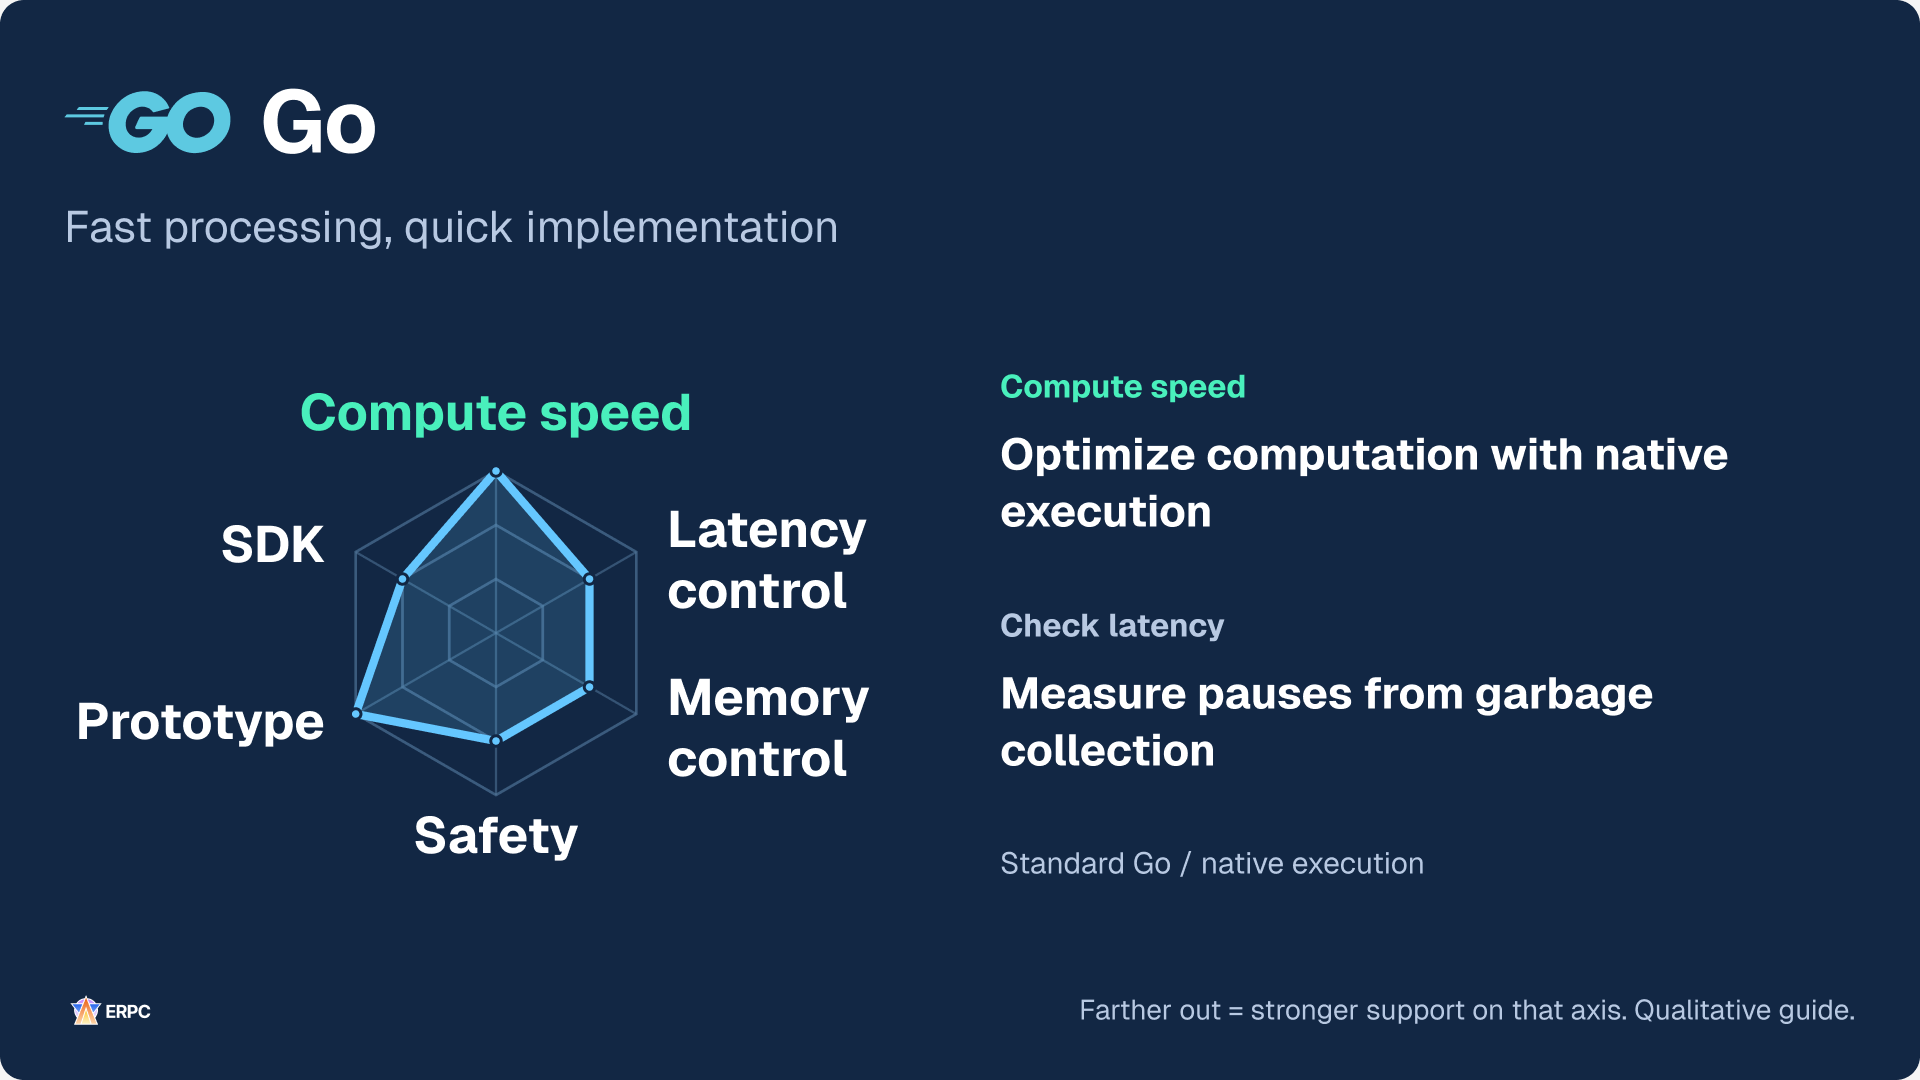
Go también es un candidato para la ejecución compilada nativa. Facilita la construcción de servicios y procesos concurrentes, mientras su entorno de ejecución se ocupa de la gestión de memoria y otras operaciones.[20] La mayor parte del trabajo del GC avanza concurrentemente, pero hay que medir las asignaciones y los costes de la recolección en CPU, memoria y latencia. Su potencial para procesar en CPU es una consideración distinta del control directo sobre el momento de liberar memoria.[13]
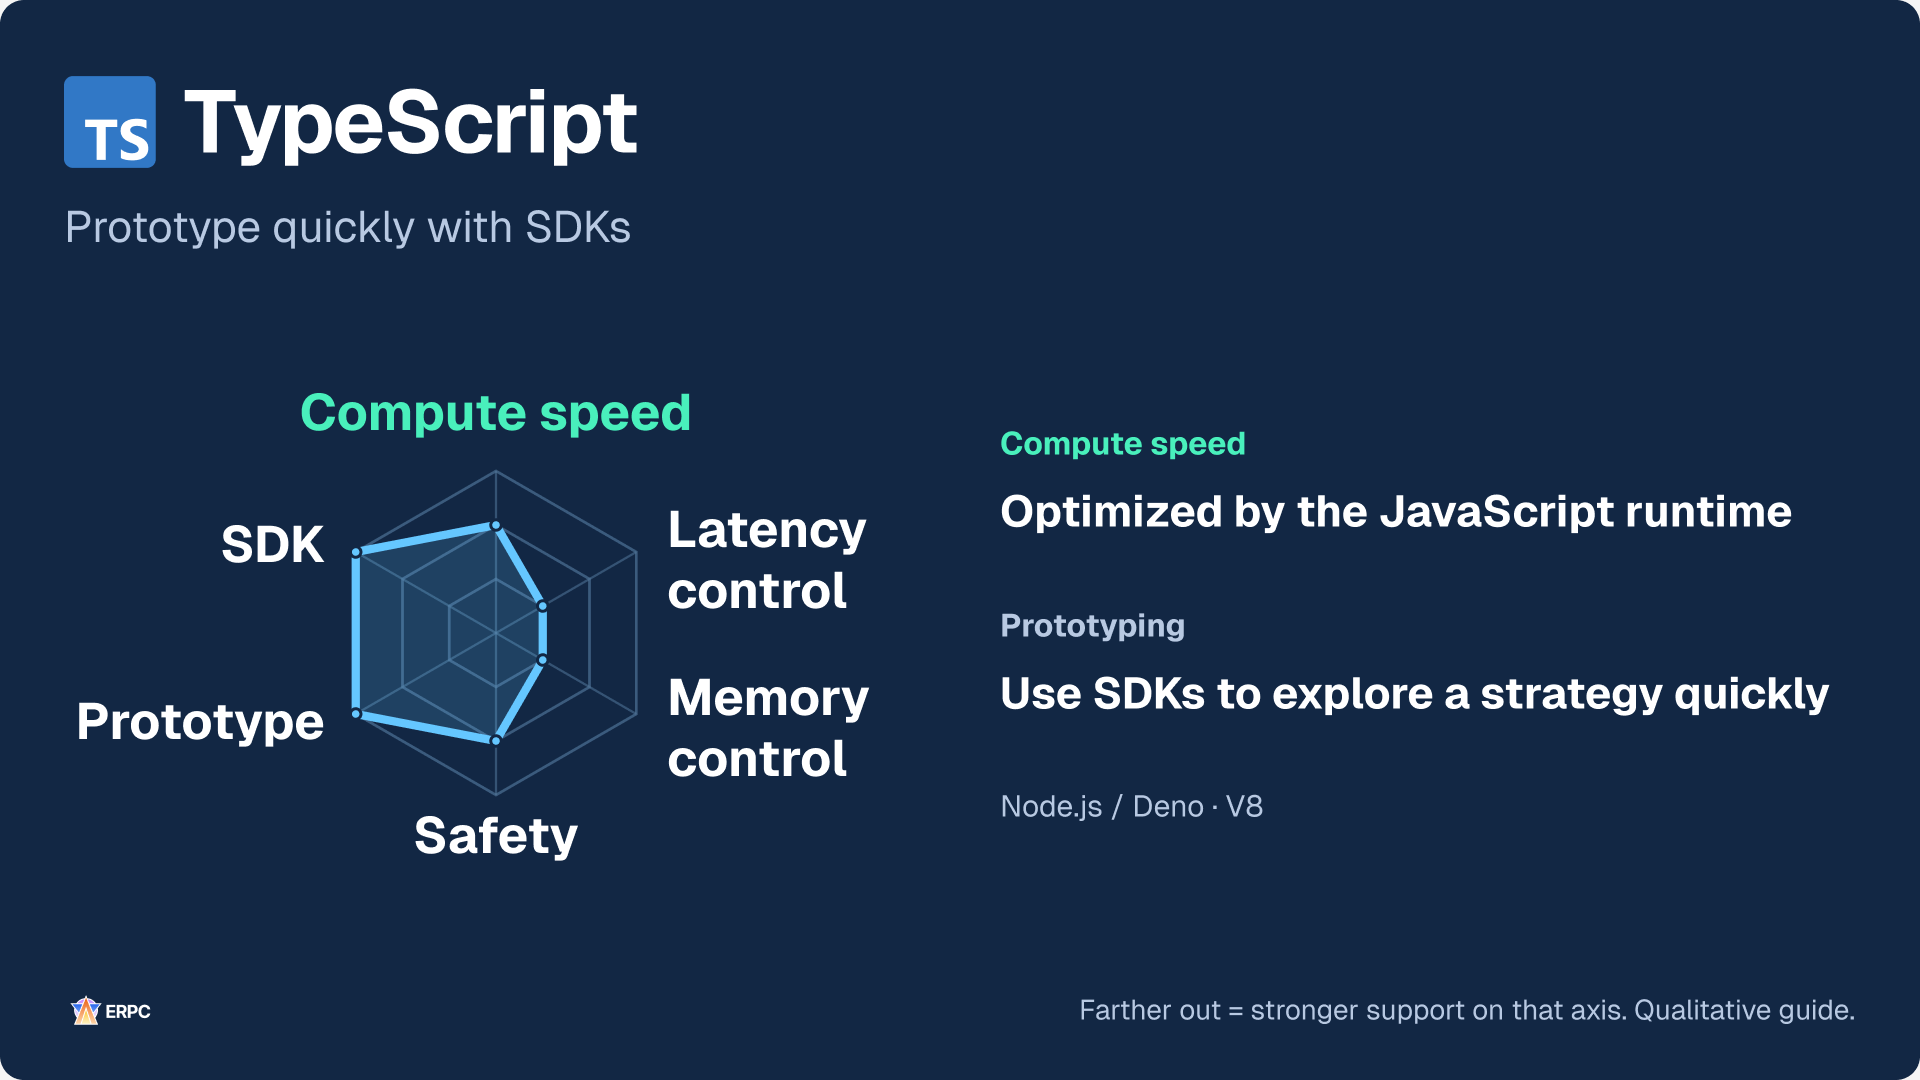
TypeScript es un lenguaje; Node.js y Deno son entornos de ejecución. Este diagrama considera JavaScript ejecutado por V8. Las anotaciones de tipo se eliminan en ejecución, por lo que añadir tipos no acelera por sí mismo el trabajo CPU. Los datos externos siguen necesitando validación en tiempo de ejecución.[9][10][21] Estas opciones pueden atender integración de API, configuración, monitorización, interfaces Web y procesamiento de flujos que cumpla el rendimiento requerido.
Node.js worker_threads y Deno Web Workers pueden trasladar trabajo CPU a otro contexto de ejecución. La documentación de Node.js recomienda un grupo de workers en lugar de crear uno para cada tarea. Incluye la conversión, la copia y la espera para entregar el trabajo, además del cálculo en el destino.[11][12]
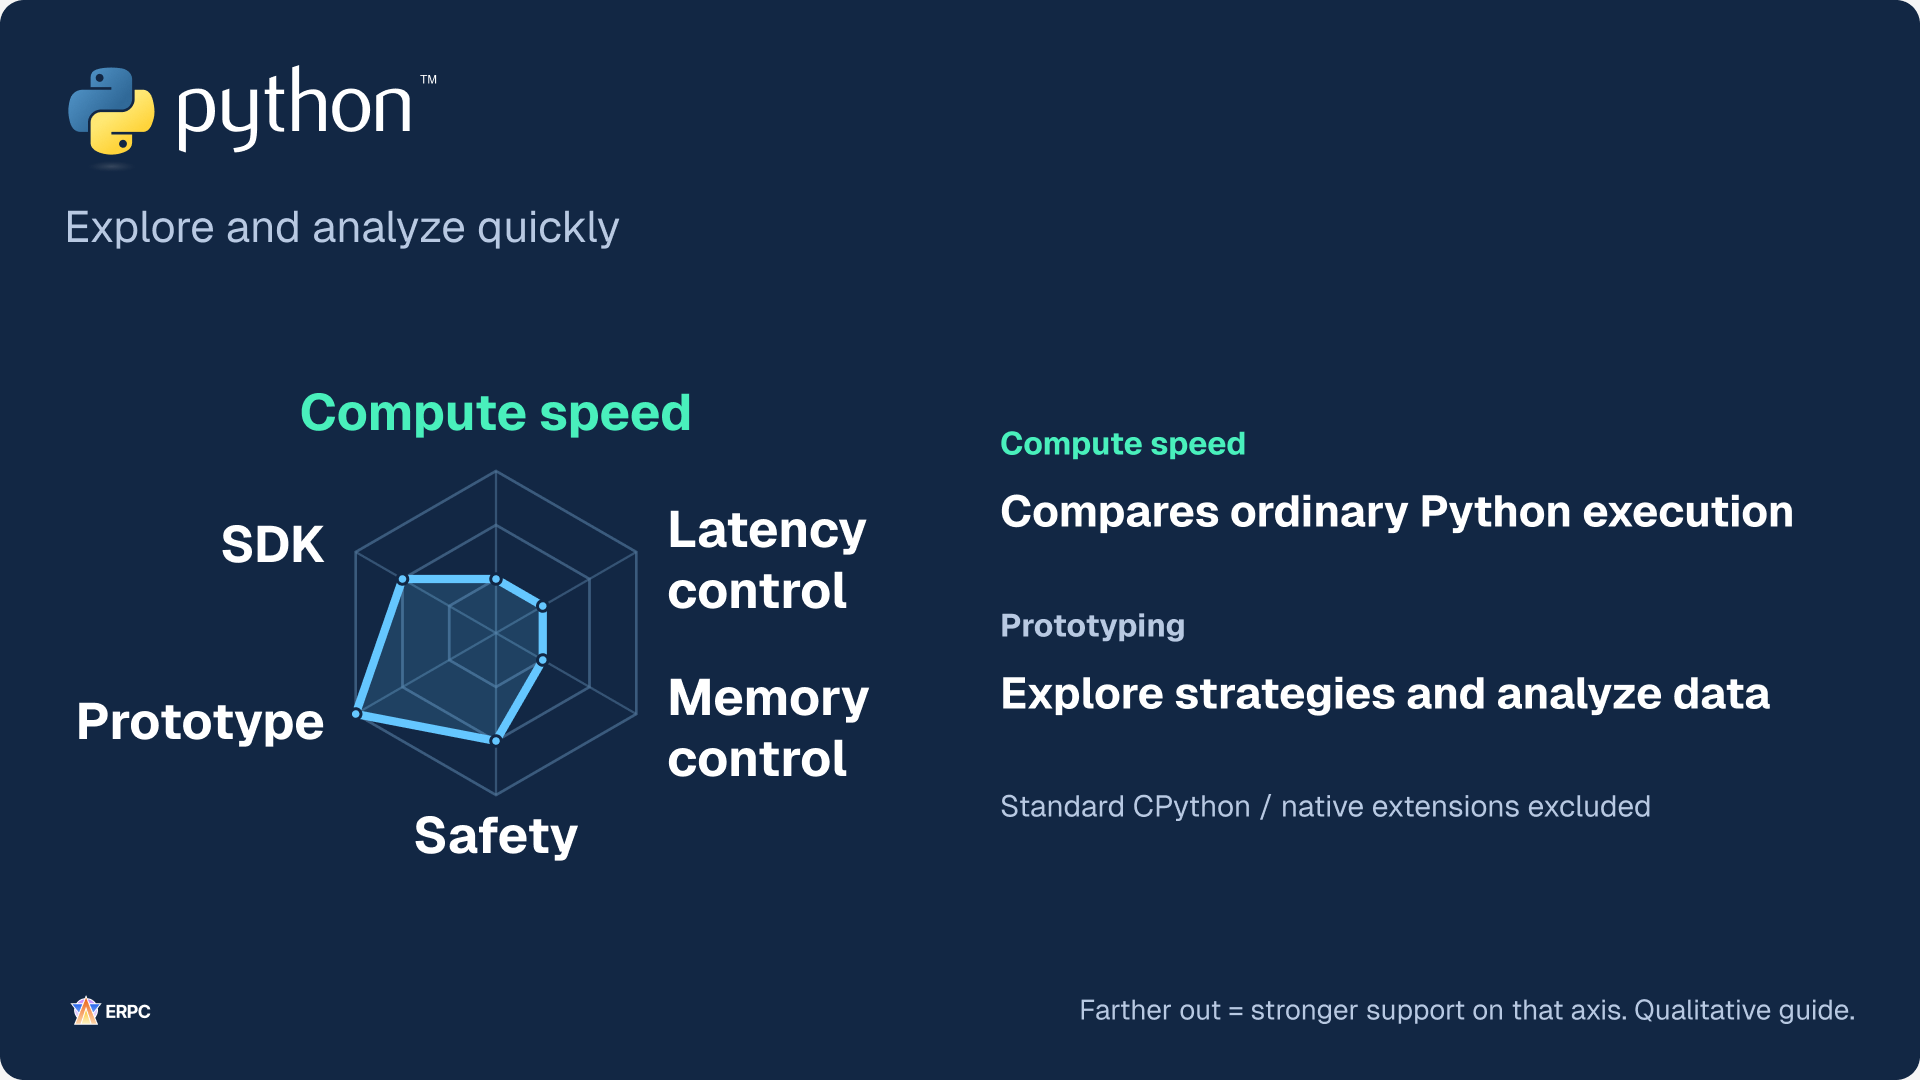
Python es un candidato para investigación, análisis, validación y trabajo con bibliotecas existentes. La valoración CPU de este gráfico se refiere a bucles escritos en Python y ejecutados dentro de CPython ordinario. Los cálculos delegados a código compilado, como las operaciones NumPy, son un caso diferente.[23] Comprueba la configuración real, incluidas las compilaciones free-threaded, en vez de decidir solo por el nombre del lenguaje.[14] Si trasladas una parte a Rust u otra implementación, mide las conversiones y copias en el límite y verifica el beneficio para la aplicación completa.
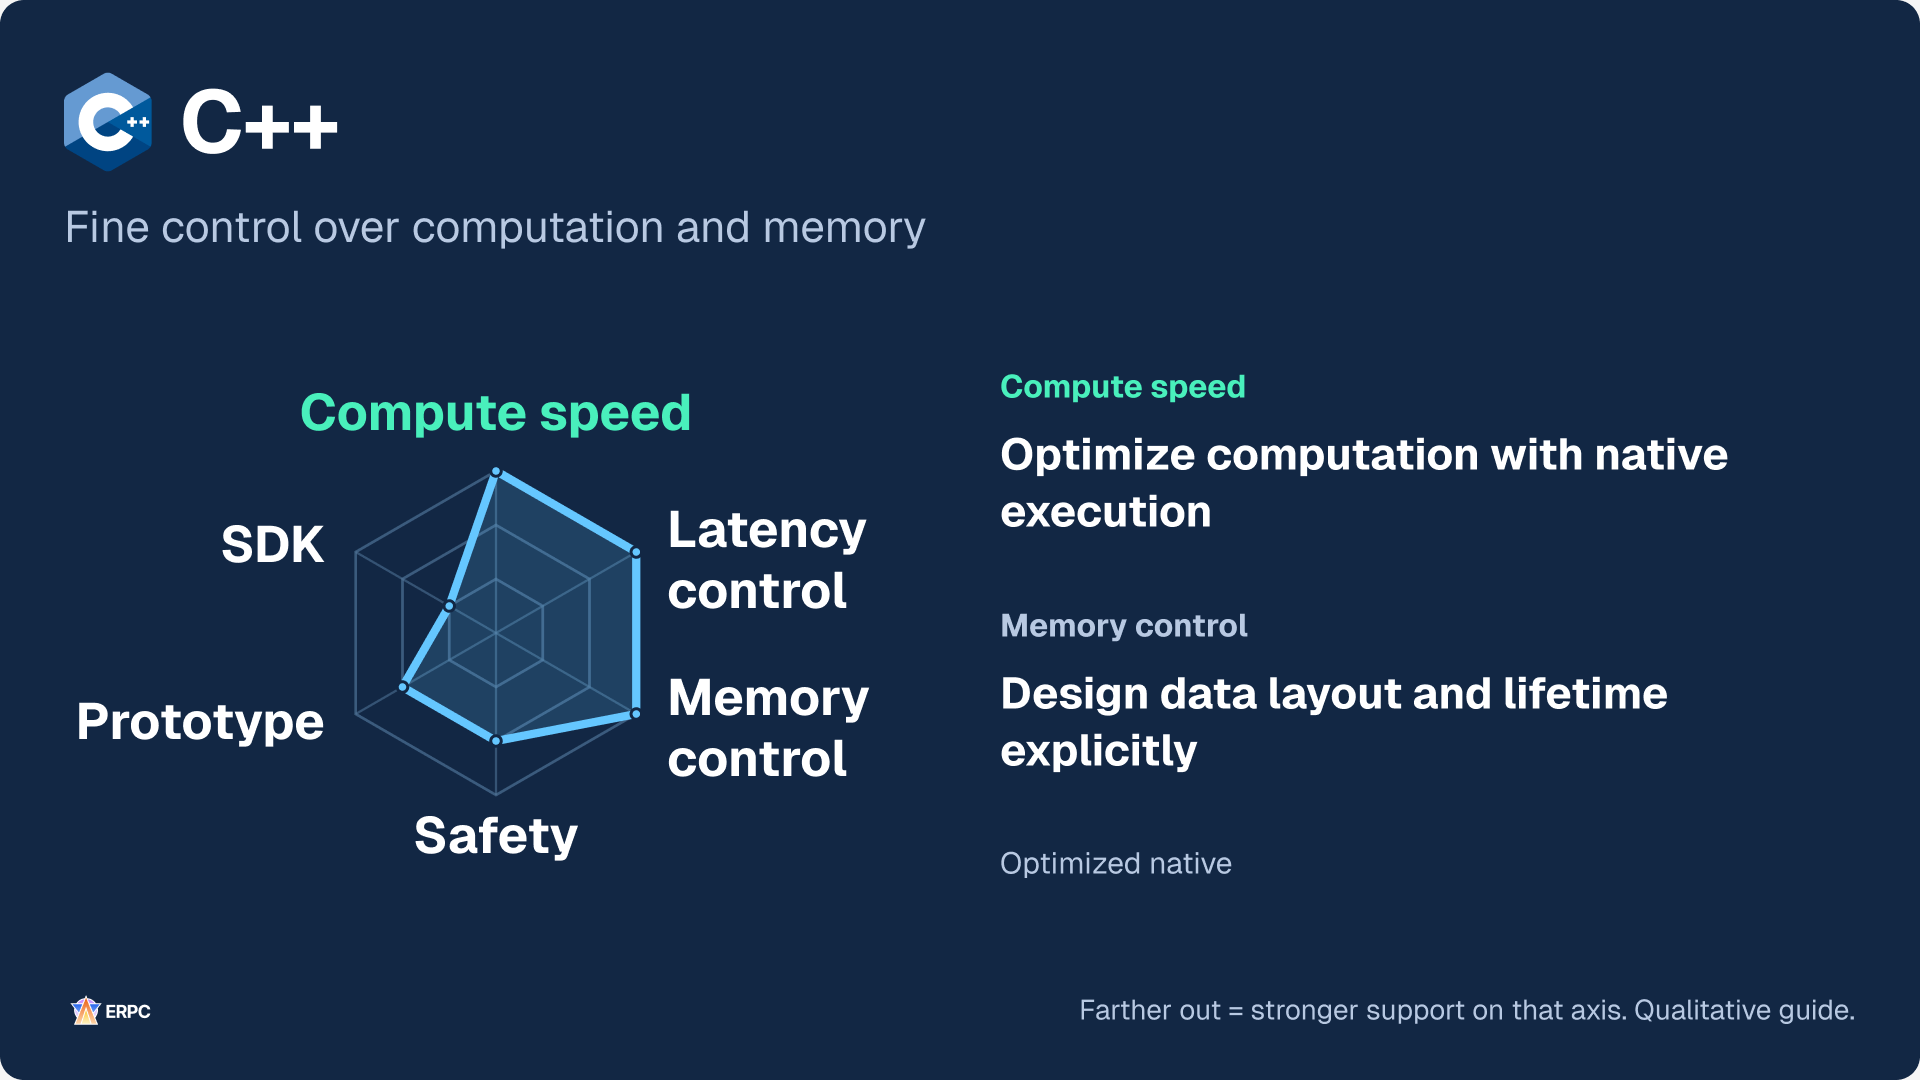
C++ combina control de bajo nivel con abstracciones y bibliotecas existentes. RAII y los punteros inteligentes ayudan a gestionar la duración de vida de los recursos, pero su uso no garantiza toda la seguridad de las duraciones de vida o de la memoria compartida.[24] Su nivel intermedio de seguridad tampoco implica las mismas garantías que la memoria gestionada en opciones como Go.
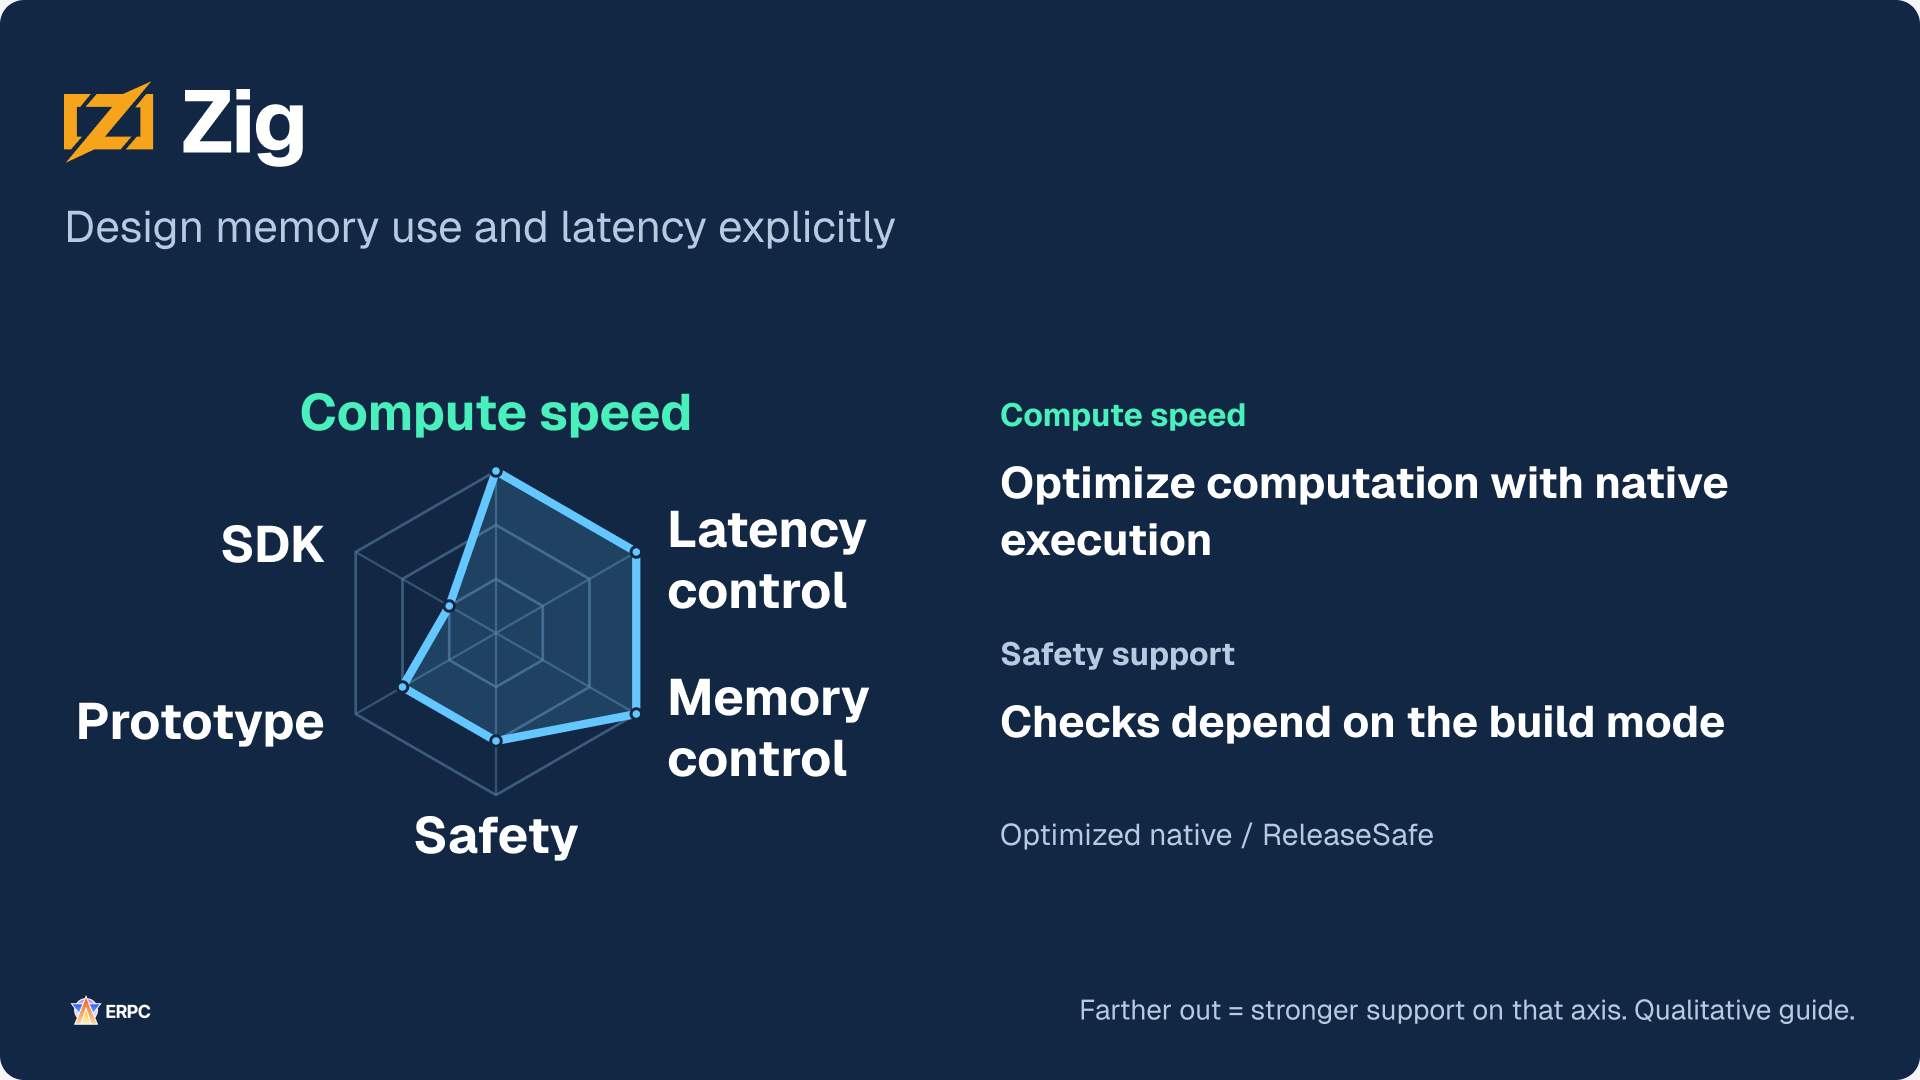
Zig permite estructurar explícitamente la asignación y la elección del asignador. Este perfil presupone las comprobaciones de ReleaseSafe. ReleaseFast y ReleaseSmall tienen comprobaciones predeterminadas diferentes, y ReleaseSafe no detecta todas las formas de comportamiento inválido.[25] Compartir la forma del polígono con C++ no implica mecanismos idénticos.
La dimensión SDK Solana utiliza los itinerarios de documentación oficial de TypeScript y Rust, y los clientes Go y Python enumerados allí. No clasifica la cantidad general ni la calidad de las bibliotecas ni afirma que C++ y Zig carezcan de ellas. Para el SDK elegido, comprueba las API necesarias, el seguimiento de mantenimiento y la compatibilidad con el entorno de ejecución seleccionado, incluido Deno.[26]
Mide dónde consume tiempo tu aplicación y elige las fortalezas que esa parte necesita. Reduce primero las esperas y el trabajo repetido en el lenguaje actual. Si necesitas un control más preciso, trasladar la parte correspondiente a otro lenguaje sigue siendo una opción.
Compara los cambios en las mismas condiciones
Las instrucciones de cada sección cubren la implementación y validación de su mejora. Si aplicas varias mejoras, conserva la relación entre cada cambio y sus resultados de medición. Aplicar cambios juntos dificulta distinguir cuál influyó en cada resultado.
Compara antes y después con las mismas entradas, condiciones de suscripción, carga y requisitos de salida. Para el tiempo entre recepción y decisión completada, observa la mediana p50 junto con p95 y p99. El p99 es un umbral dentro del cual termina el 99% de los eventos medidos. Permite ver la parte más lenta de la distribución además del procesamiento habitual.
Sumar el p99 de cada etapa no produce el p99 de extremo a extremo. Mide directamente para cada evento la duración completa desde la recepción hasta terminar la decisión, junto con las esperas en cola, el uso de CPU y memoria, las actualizaciones ausentes o descartadas y la concordancia entre los resultados de decisión.
Para medir tiempo transcurrido dentro de un mismo host, usa un reloj monotónico que no retroceda al corregirse la hora de calendario. Si un SDK invoca un callback solo después de decodificar, también hubo procesamiento antes del inicio del callback. Especifica exactamente dónde empieza y termina cada medición para separar la latencia de entrega de la latencia interna de la aplicación.
Comprueba también lo que sucede después del envío. Una respuesta satisfactoria de sendTransaction no garantiza el procesamiento ni la confirmación por parte del clúster.[15] Relacionar recepción, decisión, aceptación del envío y resultado observado en la cadena ayuda a elegir el siguiente punto que mejorar.
Convierte una entrega rápida en decisiones a tiempo
Tanto la entrega rápida como la capacidad de la aplicación para terminar las decisiones necesarias a tiempo son importantes. ERPC sigue mejorando su infraestructura de entrega y elaborando información que ayuda a mejorar el software que se ejecuta sobre ella.
Valida primero los cambios de la aplicación en el mismo entorno. Después, cuando sea necesario, compara el mismo código en distintas ubicaciones o con distintos recursos para distinguir sus efectos. Al usar la facturación por horas de ERPC, define de antemano la hipótesis, las condiciones de comparación y la duración de uso, y consulta los precios y la disponibilidad actuales en el Dashboard.
Referencias y enlaces relacionados
- [1] Tokio / Tareas intensivas de CPU y bloqueo
- [2] Node.js / No bloquear el bucle de eventos
- [3] gRPC / Control de flujo
- [4] Yellowstone gRPC / Mensajes y especificaciones de suscripción
- [5] LMAX Disruptor / Diseño y uso
- [6] Solana / Commitment
- [7] Solana / getLatestBlockhash
- [8] Rust / Propiedad
- [9] TypeScript / Comportamiento en ejecución y eliminación de tipos
- [10] Deno / TypeScript
- [11] Node.js / Worker threads
- [12] Deno / Web Workers
- [13] Go / Recolector de basura
- [14] Python / Free threading
- [15] Solana / sendTransaction
- [16] Yellowstone gRPC / Definiciones de mensajes
- [17] Rust / std::sync::Mutex
- [18] Tokio / Estado compartido y partición de mutexes
- [19] Solana / Estructura de transacciones y firmas
- [20] Go / Preguntas frecuentes
- [21] V8 / Visión general
- [22] Rust / Data races y condiciones de carrera
- [23] NumPy / ¿Qué es NumPy?
- [24] C++ / Directrices fundamentales
- [25] Zig / Referencia del lenguaje
- [26] Solana / SDK de cliente
- [27] Programming-Language-Benchmarks / nbody
- [28] Programming-Language-Benchmarks / Measurement code (2025-07-31): execution, defaults, aggregation, Zig build, Deno configuration.
- [29] Programming-Language-Benchmarks / Published measurement data (2025-08-01)
- Logotipos y fuentes: Rust © Rust Foundation (CC BY 4.0, forma y colores sin cambios); Zig © Zig project (CC BY-SA 4.0, forma y colores sin cambios).
- Otros logotipos: Go © The Go Authors; TypeScript © Microsoft; Python © Python Software Foundation; C++ by Jeremy Kratz / Standard C++ Foundation; Node.js / OpenJS Foundation and Node.js contributors; Deno / Deno Land Inc..
- ERPC
- ERPC Web Dashboard