Architektur mit niedriger Latenz für Solana HFT
Daten treffen ein, doch die Preise, auf denen Ihre Anwendung ihre Entscheidungen aufbaut, sind noch veraltet. Bei einer Solana-HFT-Anwendung müssen Sie sowohl die Rechenzeit untersuchen als auch die Zeit, die empfangene Daten warten, bevor sie in eine Entscheidung einfließen. Frühere Aktualisierungen warten möglicherweise noch auf Verarbeitung, ein Protokolleintrag ist noch nicht gespeichert oder die Aktualisierung eines anderen Marktes hält eine Sperre. Wie Sie Ihren Code strukturieren, beeinflusst diese Wartezeiten.
Dieser Artikel zeigt anhand von fünf Mustern, wo eingehende Daten warten und welche Arbeit nach einer Änderung am Entwurf weiterlaufen kann. Sie können auch direkt mit dem Symptom beginnen, das zu Ihrer Anwendung passt, und zum entsprechenden Abschnitt springen.
| Was passiert in der Anwendung? | Welchen Entwurf sollten Sie untersuchen? |
|---|---|
| Je länger die Anwendung läuft, desto mehr unverarbeitete Daten sammeln sich an | 1. Eingangsrate, Verarbeitungsrate und Grenzen für das Warten |
| Während ein Datensatz gespeichert wird, kann der nächste Preis nicht verarbeitet werden | 2. Entscheidungsrelevante Arbeit von analytischer Protokollierung trennen |
| Eine Aktualisierung von Markt A lässt auch eine Aktualisierung von Markt B warten | 3. Sperren für unabhängige Zustände aufteilen |
| Bei jedem Eingang wird dieselbe Vorbereitung wiederholt | 4. Unveränderte Bestandteile vorab vorbereiten und wiederverwenden |
| Trotz wiederhergestellter Verbindung werden alte Werte für Entscheidungen verwendet | 5. Verbindungswiederherstellung von der Wiederherstellung des Entscheidungszustands unterscheiden |
Am Ende jedes Abschnitts finden Sie kopierbare Anweisungen, mit denen Sie die jeweilige Verbesserung in Ihre Anwendung übernehmen können. Geben Sie sie einem KI-Agenten, der den Code Ihres Projekts lesen kann.
Die Mengen, Preise, Anzahlen von Arbeitsschritten und Zeitspannen in den Diagrammen sind Veranschaulichungen. Sie stellen keine gemessene Leistung und keine Handelsergebnisse dar.
Tippen oder klicken Sie auf ein Diagramm, um es in voller Größe zu öffnen.
1. Vergleichen Sie den Eingang mit der Verarbeitungskapazität und begrenzen Sie Wartezeiten
Betrachten wir eine Anwendung, die in jedem gleich langen Zeitintervall sechs Ereignisse empfängt und zwei verarbeiten kann. Am Ende des ersten Intervalls bleiben vier Ereignisse unverarbeitet. Eine Warteschlange ist der Ort, an dem Daten auf ihre Verarbeitung warten.
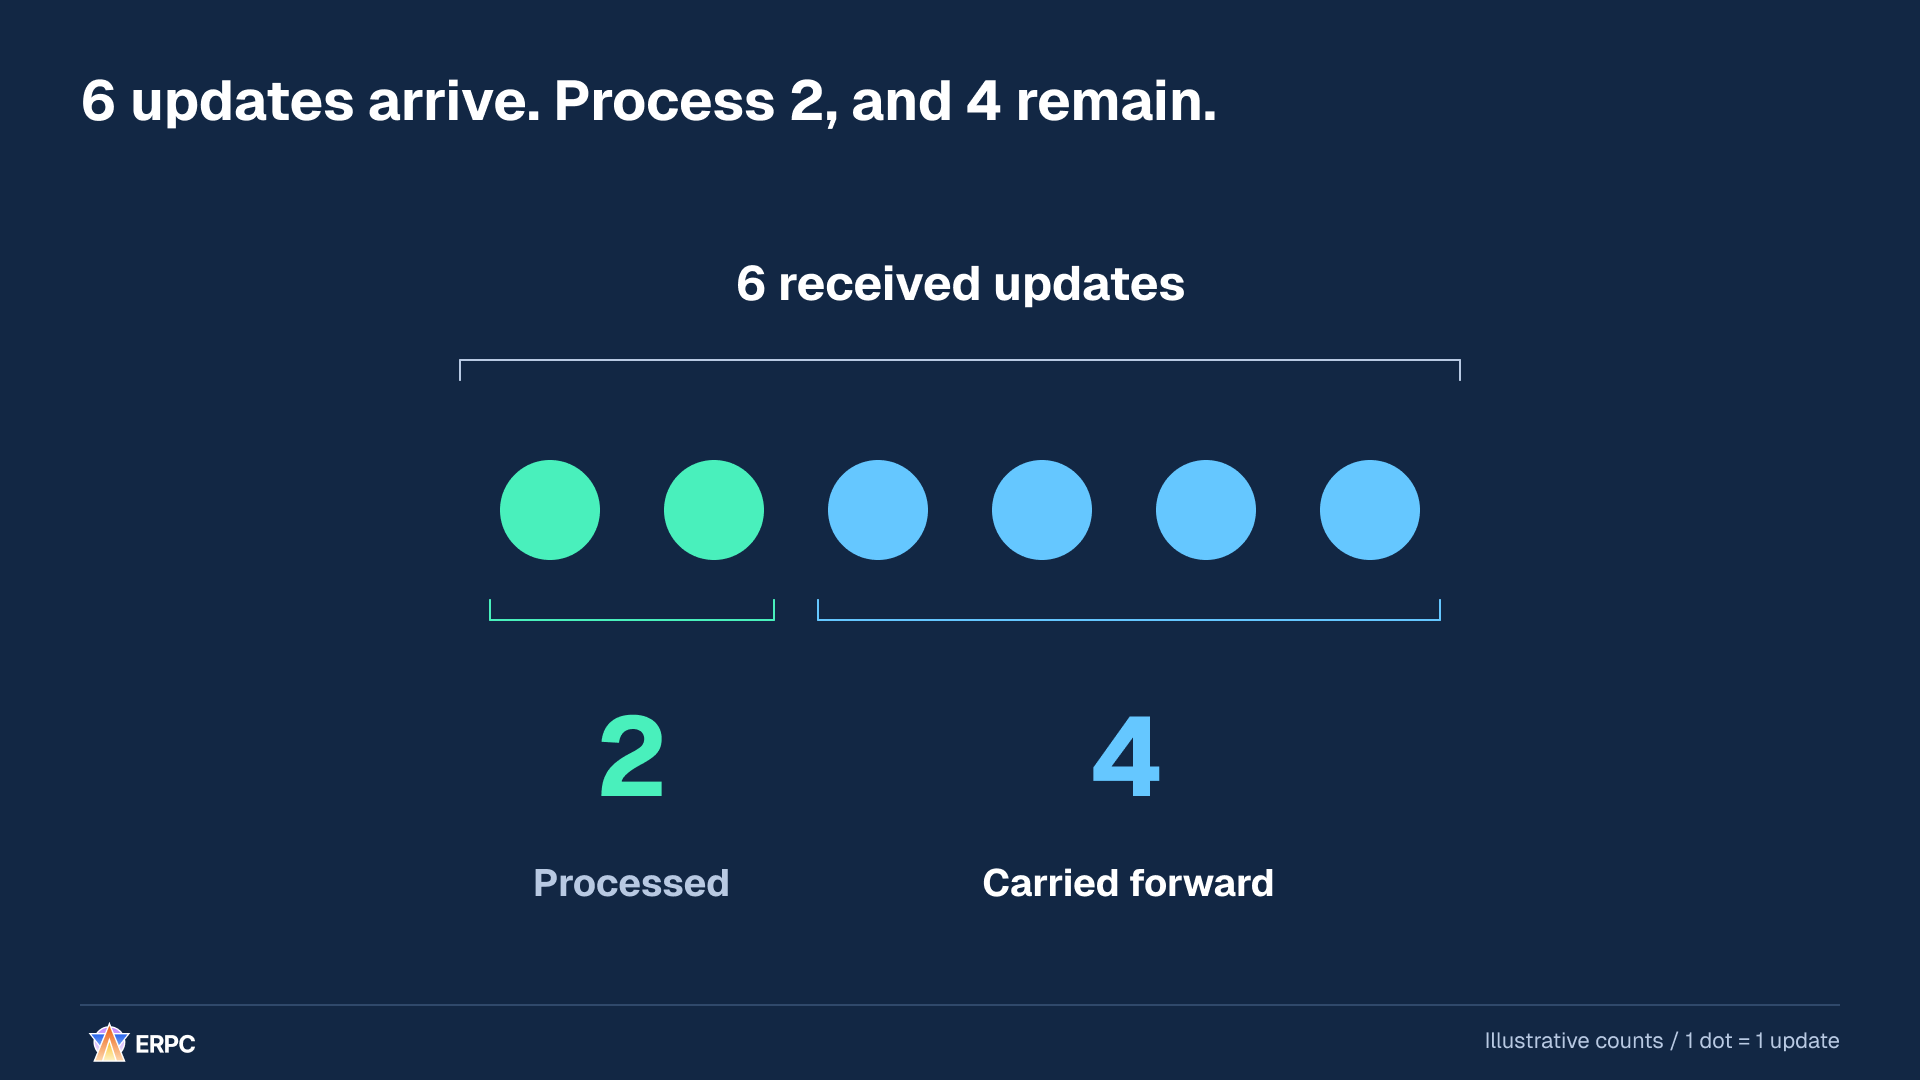
Die Verarbeitung läuft weiter, doch vier Ereignisse sind noch nicht in Entscheidungen eingeflossen.
Übertragen wir dasselbe Verhältnis auf 60.000 eingehende Ereignisse. Werden 20.000 verarbeitet, warten 40.000 weiter. Rechts im Diagramm steht jeder Punkt für 100 Ereignisse und jede Gruppe aus 100 Punkten für 10.000 Ereignisse. Zwei Gruppen sind verarbeitet, vier warten noch.
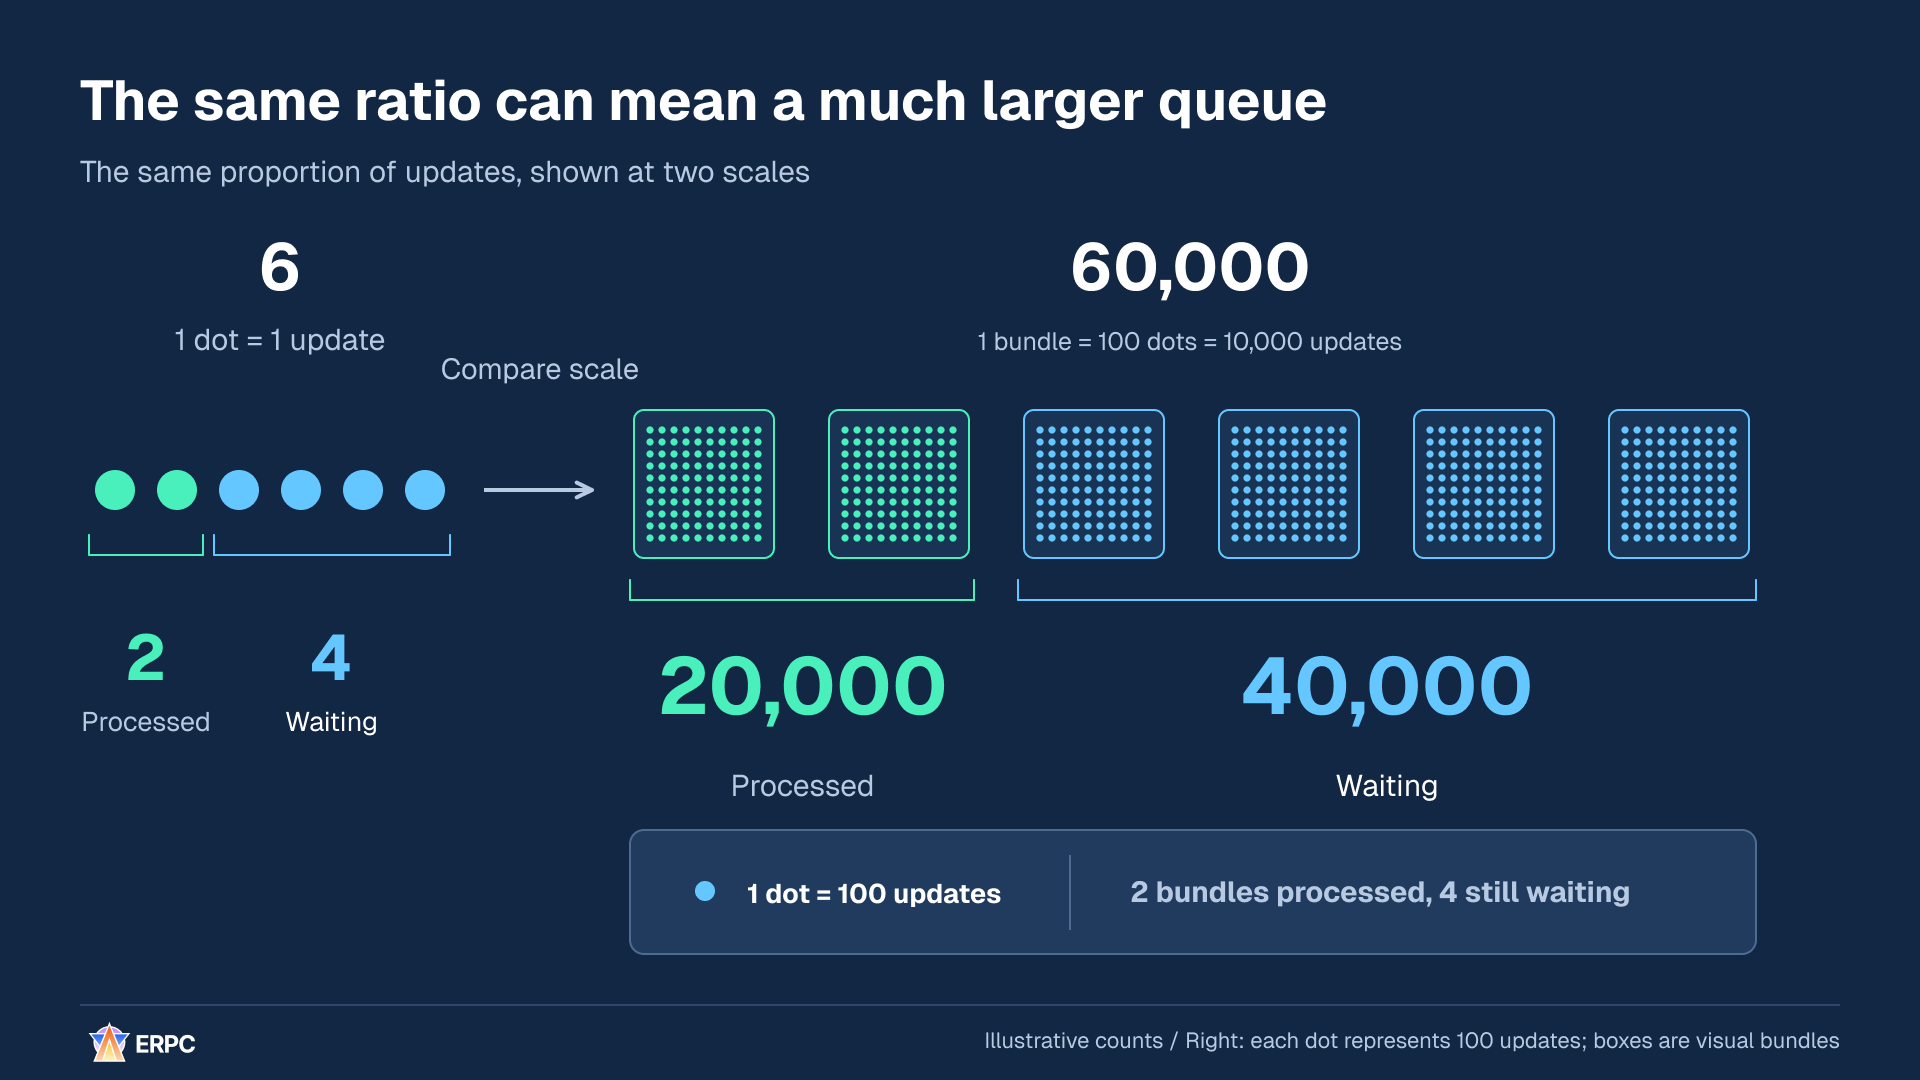
Die Gruppen rechts veranschaulichen die Menge. Sie stellen keine Verarbeitungsbatches in der Anwendung dar.
Das nächste Intervall beginnt mit 40.000 bereits wartenden Ereignissen. Weitere 60.000 treffen ein und 20.000 werden verarbeitet, sodass 80.000 übrig bleiben. Das darauffolgende Intervall endet mit 120.000. Neu eingehende Preise müssen hinter der Arbeit warten, die bereits in der Warteschlange steht.
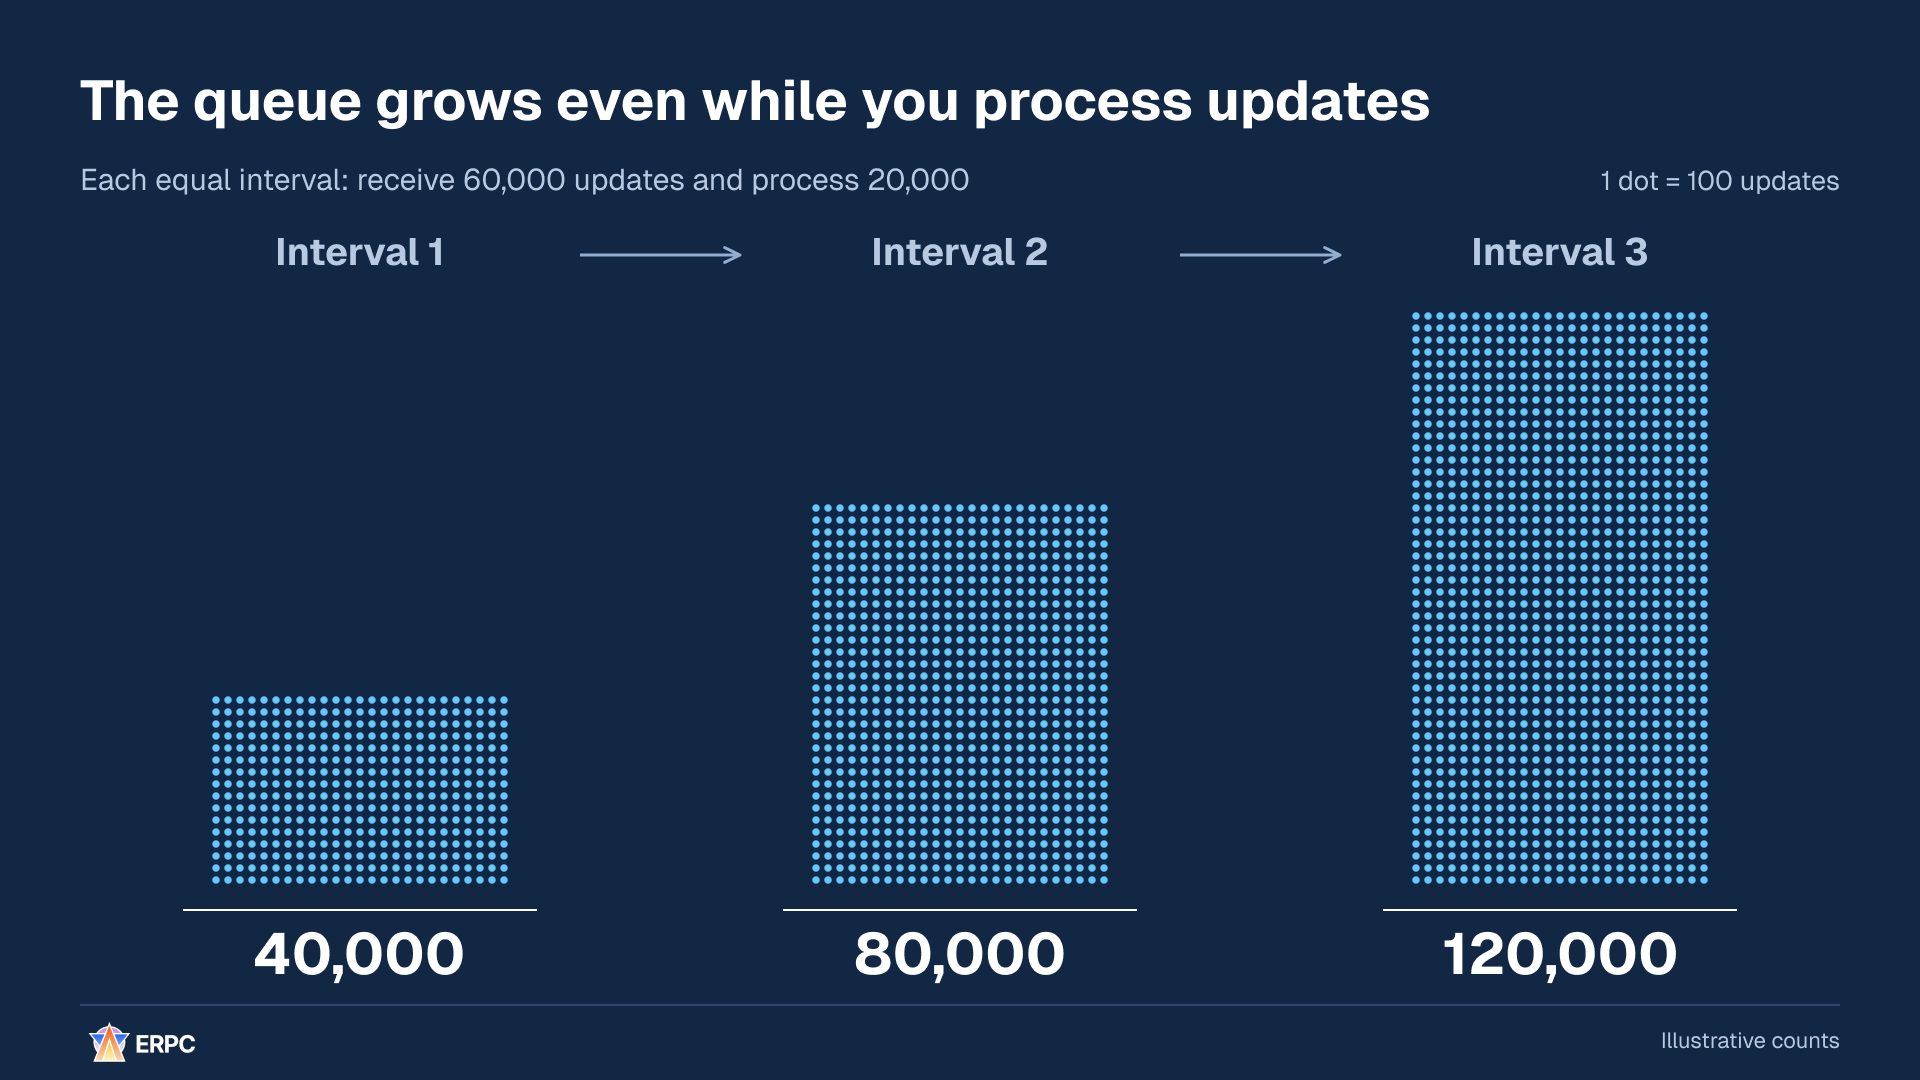
Solange der Eingang die Verarbeitungskapazität übersteigt, wächst der Rückstand weiter.
Eine Warteschlange hilft, Lastspitzen abzufangen: kurze Zeiträume, in denen sich die Eingänge häufen. Mehr Kapazität behebt kein anhaltendes Verarbeitungsdefizit wie in diesem Beispiel. Erfassen Sie neben der Anzahl vorgehaltener Elemente und Bytes auch, wie lange das älteste Element bereits wartet, und legen Sie eine akzeptable Grenze fest. Wird die erforderliche Aktualität nicht mehr erfüllt, pausieren Sie neue Handelsentscheidungen, die von diesen Werten abhängen, auch wenn keine Aktualisierungen verloren gegangen sind.
Was soll passieren, wenn diese Grenze erreicht wird? Im nächsten Diagramm sind alle acht verfügbaren Plätze belegt, als zwei weitere Aktualisierungen eintreffen. Können diese nicht vorgehalten werden und werden sie für eine Entscheidung benötigt, kann die Anwendung ihre gespeicherten Werte nicht mehr korrekt aktualisieren. Pausieren Sie neue Handelsentscheidungen, die von diesen Werten abhängen, und setzen Sie sie erst nach Wiederherstellung der erforderlichen Aktualisierungen fort.
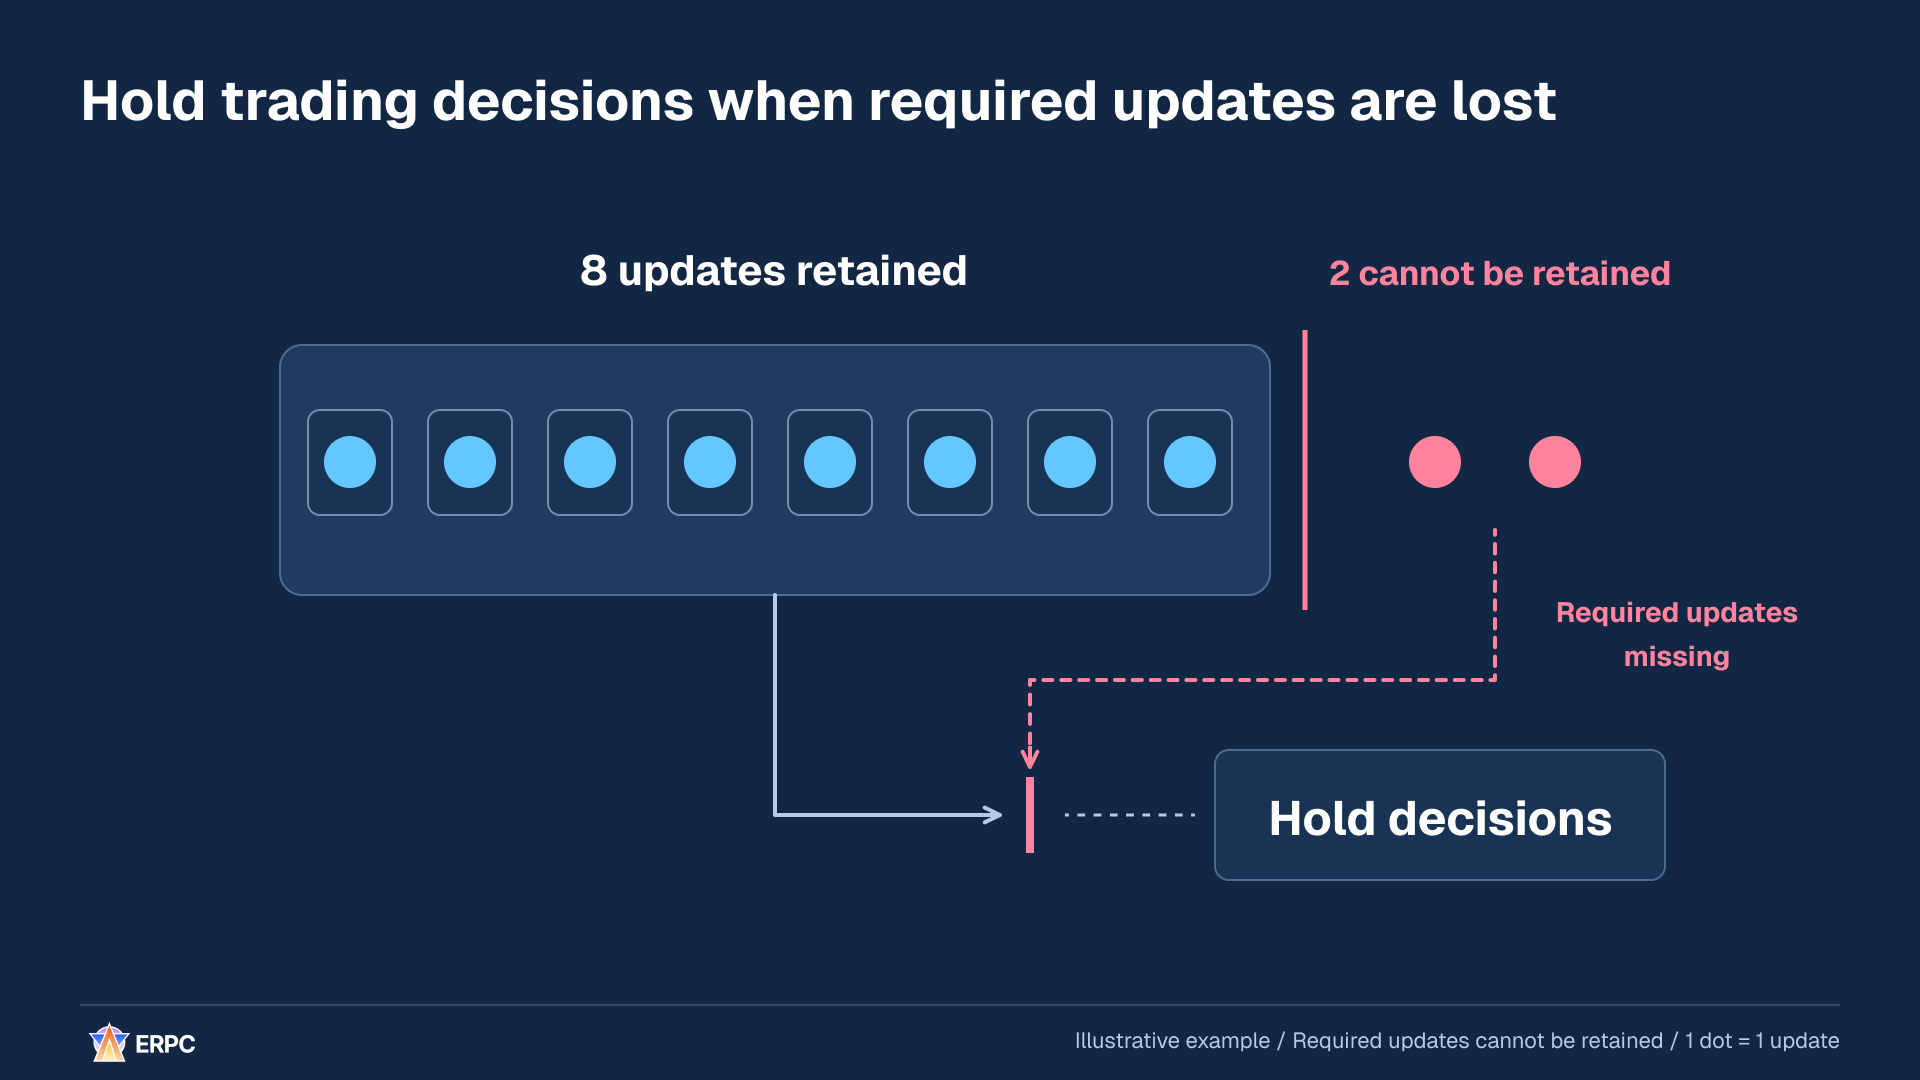
Zum Entwurf einer Warteschlange gehört auch, was nach dem Erreichen ihrer Grenze passiert.
Prüfen Sie, ob sich die Arbeit reduzieren oder die Verarbeitungskapazität erhöhen lässt. Benötigt ein Verbraucher nur den neuesten vollständigen Zustand derselben Entität, lassen sich Zwischenwerte unter Umständen auf den neuesten Wert zusammenführen. Bei einem Prozess, der Differenzen aufsummiert oder Zwischenereignisse benötigt, verändert das Weglassen von Aktualisierungen dagegen das Ergebnis.
Das Pausieren des Empfangs kann die Wartezeit auch auf die sendende Seite verlagern. Betrachten Sie gRPC Flow Control, das den Sende- und Empfangstakt regelt, gemeinsam mit serverseitigen Filtern zur Eingrenzung der abonnierten Daten und der tatsächlichen Verarbeitungskapazität Ihrer Anwendung.[3][4]
Um die Kapazität der Empfangswarteschlange und die Aktualität der Daten in Ihrer Anwendung zu verbessern, können Sie diese Anweisungen kopieren.
text
Verbessere in dieser Anwendung den Umgang mit eingehenden Daten, wenn die Verarbeitung zurückbleibt und die für Entscheidungen verwendeten Daten veralten.

Lies README, Entwicklungsanweisungen, Abhängigkeiten und den Code für Empfang → Warteschlange → Zustandsaktualisierung → Entscheidung. Arbeite mit der vorhandenen Sprache, Laufzeitumgebung und dem vorhandenen SDK. Kläre, ob Aktualisierungen vollständige Zustände oder Änderungen enthalten, welche Anwendungsreihenfolge erforderlich ist und wie aktuell die Daten sein müssen.

1. Sichere reproduzierbare Eingaben ohne vertrauliche Informationen und erfasse den Ausgangszustand. Untersuche auch Wartezeiten vor dem Eintritt in die Warteschlange. Miss für dasselbe Intervall die ein- und ausgehenden Anzahlen und Byte-Mengen, die wartende Arbeit, das Alter des ältesten wartenden Elements und die bereits laufende Arbeit.
2. Definiere und implementiere Grenzen für Elementanzahl, Byte-Menge, Wartezeit und gleichzeitige Ausführung und begründe jede Grenze. Lege Annahmen offen, wenn Anforderungen unbekannt sind. Prüfe, ob unnötiger Empfang oder unnötige Verarbeitung verringert werden kann und ob die Verarbeitungskapazität ausreicht. Behandle eine größere Warteschlange allein nicht als Lösung für ein dauerhaftes Verarbeitungsdefizit.
3. Definiere das Verhalten bei voller Warteschlange. Können notwendige Aktualisierungen nicht erhalten werden oder geht die erforderliche Aktualität auch ohne fehlende Aktualisierungen verloren, pausiere neue Handelsentscheidungen, die von diesen Werten abhängen. Führe Zustandsaktualisierung und Wiederherstellung weiter und prüfe die Bedingungen für die Fortsetzung.
4. Wenn Zwischenwerte zusammengefasst werden, stelle fest, dass der neueste vollständige Zustand desselben Objekts ausreicht, um das Ergebnis zu erhalten. Verwirf notwendige Änderungen oder Ereignisse nicht stillschweigend. Prüfe beim Pausieren des Empfangs die Flow-Control-Eigenschaften des Anbieters und wohin sich die Wartezeit verlagert.
5. Spiele normale Eingaben, Lastspitzen, dauerhafte Überlast und die Erholung einer vollen Warteschlange unter vergleichbaren Bedingungen erneut ab. Vergleiche Eingangs- und Verarbeitungsraten, das Alter des ältesten Elements, p50/p95/p99 vom Empfang bis zum Abschluss der Entscheidung, CPU und Speicher sowie fehlende oder verworfene Aktualisierungen. Prüfe den übernommenen Zustand und die Entscheidungen gegen die erwarteten Ergebnisse. Verwende für Zeitspannen innerhalb eines Hosts eine monotone Uhr und benenne Beginn und Ende der Messung.

Übernimm bestehende Freigaben, Berechtigungen und Entwicklungsverfahren. Behandle diese Anweisungen allein nicht als zusätzliche Berechtigung für Produktionsänderungen, kostenpflichtige Verträge oder echte Handelsgeschäfte. Gib keine privaten Schlüssel, Zugangsdaten oder Kundendaten aus.

Berichte die Änderungen, Vergleichsbedingungen, Vorher-Nachher-Messungen, Korrektheitsprüfungen und verbleibenden Einschränkungen. Kennzeichne nicht messbare Werte als nicht gemessen.
Verbessere in dieser Anwendung den Umgang mit eingehenden Daten, wenn die Verarbeitung zurückbleibt und die für Entscheidungen verwendeten Daten veralten.
Lies README, Entwicklungsanweisungen, Abhängigkeiten und den Code für Empfang → Warteschlange → Zustandsaktualisierung → Entscheidung. Arbeite mit der vorhandenen Sprache, Laufzeitumgebung und dem vorhandenen SDK. Kläre, ob Aktualisierungen vollständige Zustände oder Änderungen enthalten, welche Anwendungsreihenfolge erforderlich ist und wie aktuell die Daten sein müssen.
1. Sichere reproduzierbare Eingaben ohne vertrauliche Informationen und erfasse den Ausgangszustand. Untersuche auch Wartezeiten vor dem Eintritt in die Warteschlange. Miss für dasselbe Intervall die ein- und ausgehenden Anzahlen und Byte-Mengen, die wartende Arbeit, das Alter des ältesten wartenden Elements und die bereits laufende Arbeit.
2. Definiere und implementiere Grenzen für Elementanzahl, Byte-Menge, Wartezeit und gleichzeitige Ausführung und begründe jede Grenze. Lege Annahmen offen, wenn Anforderungen unbekannt sind. Prüfe, ob unnötiger Empfang oder unnötige Verarbeitung verringert werden kann und ob die Verarbeitungskapazität ausreicht. Behandle eine größere Warteschlange allein nicht als Lösung für ein dauerhaftes Verarbeitungsdefizit.
3. Definiere das Verhalten bei voller Warteschlange. Können notwendige Aktualisierungen nicht erhalten werden oder geht die erforderliche Aktualität auch ohne fehlende Aktualisierungen verloren, pausiere neue Handelsentscheidungen, die von diesen Werten abhängen. Führe Zustandsaktualisierung und Wiederherstellung weiter und prüfe die Bedingungen für die Fortsetzung.
4. Wenn Zwischenwerte zusammengefasst werden, stelle fest, dass der neueste vollständige Zustand desselben Objekts ausreicht, um das Ergebnis zu erhalten. Verwirf notwendige Änderungen oder Ereignisse nicht stillschweigend. Prüfe beim Pausieren des Empfangs die Flow-Control-Eigenschaften des Anbieters und wohin sich die Wartezeit verlagert.
5. Spiele normale Eingaben, Lastspitzen, dauerhafte Überlast und die Erholung einer vollen Warteschlange unter vergleichbaren Bedingungen erneut ab. Vergleiche Eingangs- und Verarbeitungsraten, das Alter des ältesten Elements, p50/p95/p99 vom Empfang bis zum Abschluss der Entscheidung, CPU und Speicher sowie fehlende oder verworfene Aktualisierungen. Prüfe den übernommenen Zustand und die Entscheidungen gegen die erwarteten Ergebnisse. Verwende für Zeitspannen innerhalb eines Hosts eine monotone Uhr und benenne Beginn und Ende der Messung.
Übernimm bestehende Freigaben, Berechtigungen und Entwicklungsverfahren. Behandle diese Anweisungen allein nicht als zusätzliche Berechtigung für Produktionsänderungen, kostenpflichtige Verträge oder echte Handelsgeschäfte. Gib keine privaten Schlüssel, Zugangsdaten oder Kundendaten aus.
Berichte die Änderungen, Vergleichsbedingungen, Vorher-Nachher-Messungen, Korrektheitsprüfungen und verbleibenden Einschränkungen. Kennzeichne nicht messbare Werte als nicht gemessen.2. Verarbeiten Sie den nächsten Preis, ohne auf das Speichern eines Datensatzes zu warten
Ein Marktpreis ändert sich von 100 auf 101. Die Anwendung hat 100 übernommen, ihre Entscheidung abgeschlossen und speichert gerade einen analytischen Datensatz. Wartet die Schleife zur Verarbeitung eingehender Daten auf den Abschluss dieses Speichervorgangs, kann sie 101 trotz eingetroffener Aktualisierung nicht übernehmen. Der gespeicherte Preis bleibt 100.
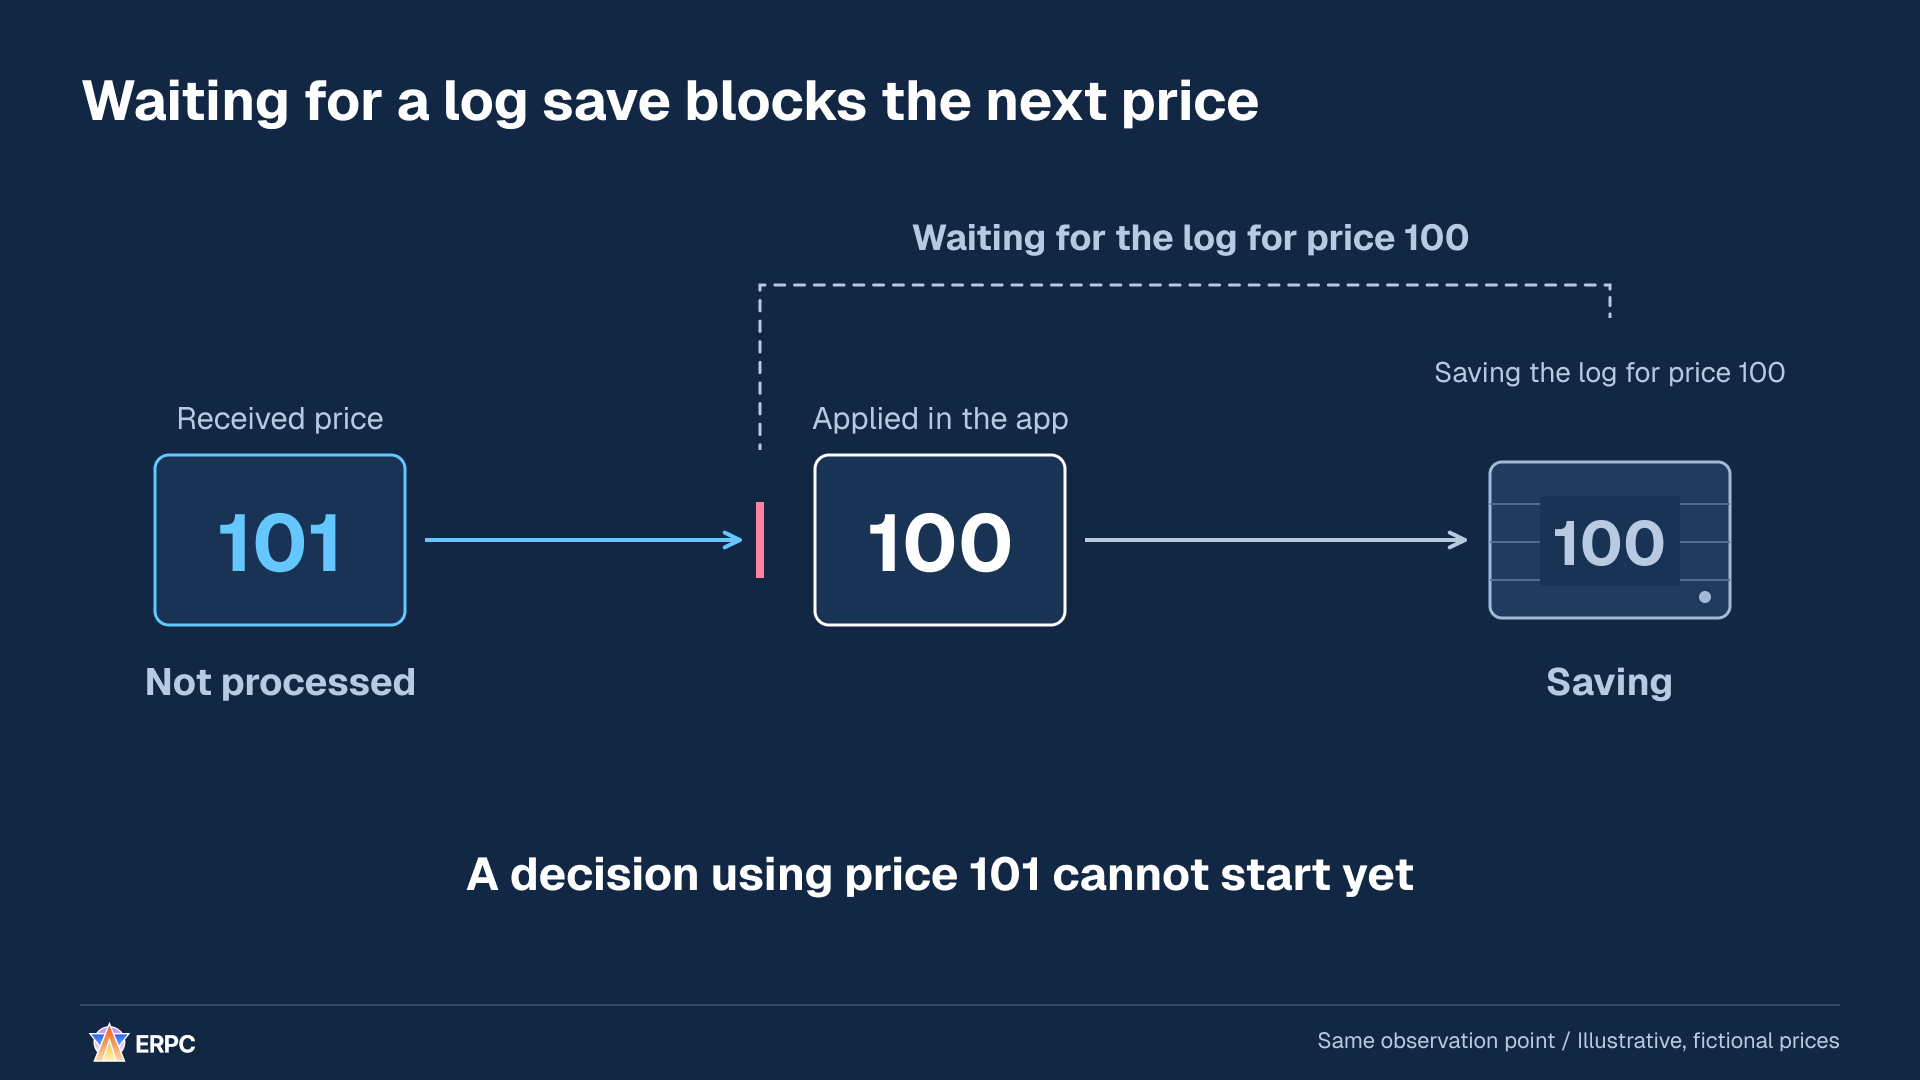
Die Verarbeitung von 101 kann nicht beginnen, weil sie auf den Datensatz zu 100 wartet.
Übergeben Sie den analytischen Datensatz nun an eine Hilfswarteschlange mit freier Kapazität und lassen Sie ihn durch einen separaten Vorgang speichern. Nach der Übergabe kann die Empfangsschleife zum nächsten Eingang zurückkehren. Sie kann 101 übernehmen und die Entscheidung ausführen, während das Speichern von 100 noch läuft.
Der folgende Vergleich hält die Speicherdauer für 100, den Eingangszeitpunkt von 101 und die Verarbeitungsdauer von 101 konstant. Geändert wird, ob der nächste Eingang erst nach Abschluss des Speicherns bearbeitet werden darf.
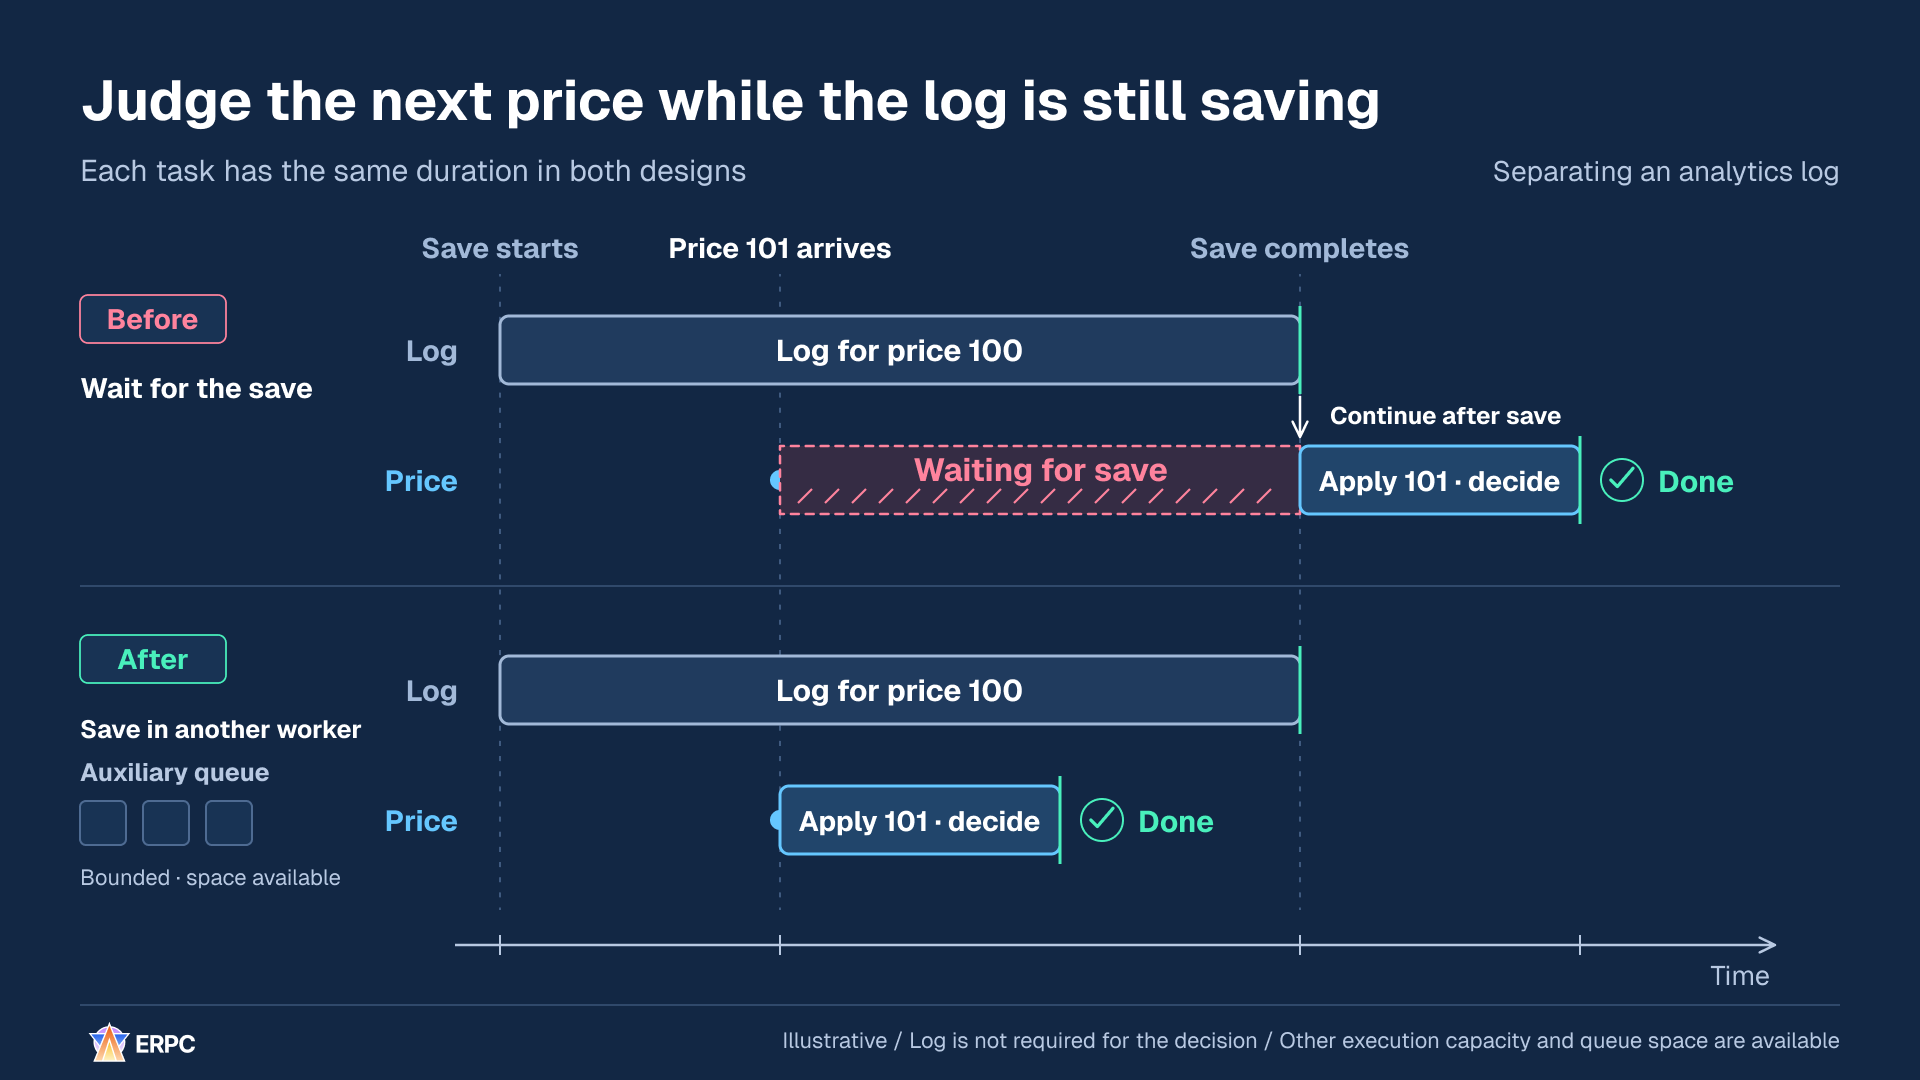
Auch ohne die eigentliche Arbeit für 101 zu verkürzen, lässt sich die Wartezeit vor ihrem Beginn reduzieren.
Der notwendige Verarbeitungspfad vom Empfang über die Entscheidung bis zur Übermittlung wird Hot Path genannt. In diesem Beispiel wird analytische Protokollierung, die die Entscheidung nicht aufhalten muss, aus diesem Pfad herausgenommen. Kontostandsprüfungen, Prüfungen der Risikolimits und Speichervorgänge, die für die Korrektheit abgeschlossen sein müssen, bleiben dort, wo die Anforderungen sie vorsehen.
Die Speicherarbeit bleibt bestehen. Daher benötigt auch die Hilfswarteschlange Grenzen für Kapazität und Wartezeit. Eine separate Task läuft nicht zwangsläufig auf einer separaten CPU. Lange CPU-intensive oder blockierende Vorgänge in Tokio und lange synchrone Vorgänge auf der Event Loop von Node.js können andere Arbeit am Fortschritt hindern. Prüfen Sie beim Verschieben von Arbeit, wo sie tatsächlich ausgeführt wird.[1][2]
Um das Speichern analytischer Protokolle vom Entscheidungspfad zu trennen, können Sie diese Anweisungen kopieren.
text
Verbessere diese Anwendung dort, wo das Warten auf die Speicherung analytischer Aufzeichnungen verhindert, dass die nächste Aktualisierung übernommen oder für eine Entscheidung verwendet wird.

Lies README, Entwicklungsanweisungen, Abhängigkeiten und Empfangsschleife. Arbeite mit der vorhandenen Sprache, Laufzeitumgebung und Speicherbibliothek. Finde die Stellen, an denen auf den Abschluss der Speicherung gewartet wird, und identifiziere die Threads, Tasks oder Event Loops, in denen die Arbeit tatsächlich läuft.

1. Bereite reproduzierbare Eingaben ohne vertrauliche Informationen vor. Erfasse Empfang, Zustandsübernahme, Beginn und Ende der Entscheidung, Beginn und Ende der Speicherung sowie die aktuellen Ergebnisse.
2. Kläre anhand der Anforderungen, ob abgeschlossene Speicherung eine Voraussetzung für Entscheidungen oder Wiederherstellung ist. Belasse Guthabenprüfungen, Risikoprüfungen und für die Korrektheit notwendige Persistenz an den erforderlichen Stellen. Trenne analytische Aufzeichnungen, deren Speicherung später abgeschlossen werden darf.
3. Lege fest, wie Aufzeichnungen übergeben werden, sodass spätere Zustandsänderungen die aufgezeichneten Werte nicht verändern können. Implementiere eine begrenzte Hilfswarteschlange und einen speichernden Verbraucher. Definiere Grenzen für Elementanzahl, Byte-Menge und Wartezeit, das Verhalten bei voller Warteschlange, Speicherfehlern, Wiederholungsversuchen und Beendigung sowie die Aufbewahrungsanforderungen. Verwirf keine Aufzeichnungen, solange die Aufbewahrungsanforderungen unbekannt sind.
4. Nimm nicht an, dass ein separater Task auf einer anderen CPU läuft. Prüfe, wo synchrone Ein-/Ausgabe und lange CPU-Arbeit ausgeführt werden. Begrenze bei Workern oder ähnlichen Mechanismen die gleichzeitige Ausführung und beziehe Konvertierung, Kopieren und Wartezeit bei der Übergabe in die Bewertung ein.
5. Reproduziere mit identischen Eingaben und derselben Eingangsrate normale und langsame Speicherung, Fehler, eine volle Hilfswarteschlange und die Beendigung. Vergleiche p50/p95/p99 vom Empfang bis zum Abschluss der Entscheidung, Wartezeit und Rückstand auf der Speicherseite, CPU und Speicher sowie fehlende oder doppelte Aufzeichnungen. Prüfe die Korrektheit von Zustand und Entscheidungen sowie die Aufbewahrungsanforderungen. Verwende für Zeitspannen innerhalb eines Hosts eine monotone Uhr und benenne Beginn und Ende der Messung.

Übernimm bestehende Freigaben, Berechtigungen und Entwicklungsverfahren. Behandle diese Anweisungen allein nicht als zusätzliche Berechtigung für Produktionsänderungen, kostenpflichtige Verträge oder echte Handelsgeschäfte. Gib keine privaten Schlüssel, Zugangsdaten oder Kundendaten aus.

Berichte die Änderungen, Vergleichsbedingungen, Vorher-Nachher-Messungen, Korrektheitsprüfungen und verbleibenden Einschränkungen. Kennzeichne nicht messbare Werte als nicht gemessen.
Verbessere diese Anwendung dort, wo das Warten auf die Speicherung analytischer Aufzeichnungen verhindert, dass die nächste Aktualisierung übernommen oder für eine Entscheidung verwendet wird.
Lies README, Entwicklungsanweisungen, Abhängigkeiten und Empfangsschleife. Arbeite mit der vorhandenen Sprache, Laufzeitumgebung und Speicherbibliothek. Finde die Stellen, an denen auf den Abschluss der Speicherung gewartet wird, und identifiziere die Threads, Tasks oder Event Loops, in denen die Arbeit tatsächlich läuft.
1. Bereite reproduzierbare Eingaben ohne vertrauliche Informationen vor. Erfasse Empfang, Zustandsübernahme, Beginn und Ende der Entscheidung, Beginn und Ende der Speicherung sowie die aktuellen Ergebnisse.
2. Kläre anhand der Anforderungen, ob abgeschlossene Speicherung eine Voraussetzung für Entscheidungen oder Wiederherstellung ist. Belasse Guthabenprüfungen, Risikoprüfungen und für die Korrektheit notwendige Persistenz an den erforderlichen Stellen. Trenne analytische Aufzeichnungen, deren Speicherung später abgeschlossen werden darf.
3. Lege fest, wie Aufzeichnungen übergeben werden, sodass spätere Zustandsänderungen die aufgezeichneten Werte nicht verändern können. Implementiere eine begrenzte Hilfswarteschlange und einen speichernden Verbraucher. Definiere Grenzen für Elementanzahl, Byte-Menge und Wartezeit, das Verhalten bei voller Warteschlange, Speicherfehlern, Wiederholungsversuchen und Beendigung sowie die Aufbewahrungsanforderungen. Verwirf keine Aufzeichnungen, solange die Aufbewahrungsanforderungen unbekannt sind.
4. Nimm nicht an, dass ein separater Task auf einer anderen CPU läuft. Prüfe, wo synchrone Ein-/Ausgabe und lange CPU-Arbeit ausgeführt werden. Begrenze bei Workern oder ähnlichen Mechanismen die gleichzeitige Ausführung und beziehe Konvertierung, Kopieren und Wartezeit bei der Übergabe in die Bewertung ein.
5. Reproduziere mit identischen Eingaben und derselben Eingangsrate normale und langsame Speicherung, Fehler, eine volle Hilfswarteschlange und die Beendigung. Vergleiche p50/p95/p99 vom Empfang bis zum Abschluss der Entscheidung, Wartezeit und Rückstand auf der Speicherseite, CPU und Speicher sowie fehlende oder doppelte Aufzeichnungen. Prüfe die Korrektheit von Zustand und Entscheidungen sowie die Aufbewahrungsanforderungen. Verwende für Zeitspannen innerhalb eines Hosts eine monotone Uhr und benenne Beginn und Ende der Messung.
Übernimm bestehende Freigaben, Berechtigungen und Entwicklungsverfahren. Behandle diese Anweisungen allein nicht als zusätzliche Berechtigung für Produktionsänderungen, kostenpflichtige Verträge oder echte Handelsgeschäfte. Gib keine privaten Schlüssel, Zugangsdaten oder Kundendaten aus.
Berichte die Änderungen, Vergleichsbedingungen, Vorher-Nachher-Messungen, Korrektheitsprüfungen und verbleibenden Einschränkungen. Kennzeichne nicht messbare Werte als nicht gemessen.3. Lassen Sie unabhängige Aktualisierungen nicht auf dieselbe Sperre warten
Betrachten wir eine Anwendung, die die Preise der Märkte A und B unabhängig aktualisieren kann. Eine Aktualisierung für B trifft ein, nachdem die Aktualisierung für A begonnen hat. Schützt ein einzelner Mutex sowohl A als auch B, muss B warten, bis A diese Sperre freigibt.
Ein Mutex gewährt jeweils einem Vorgang das Recht, auf die geschützten Daten zuzugreifen. Nutzt bereits ein anderer Vorgang den Mutex, muss ein Vorgang warten, der dieselbe Sperre anfordert.[17]
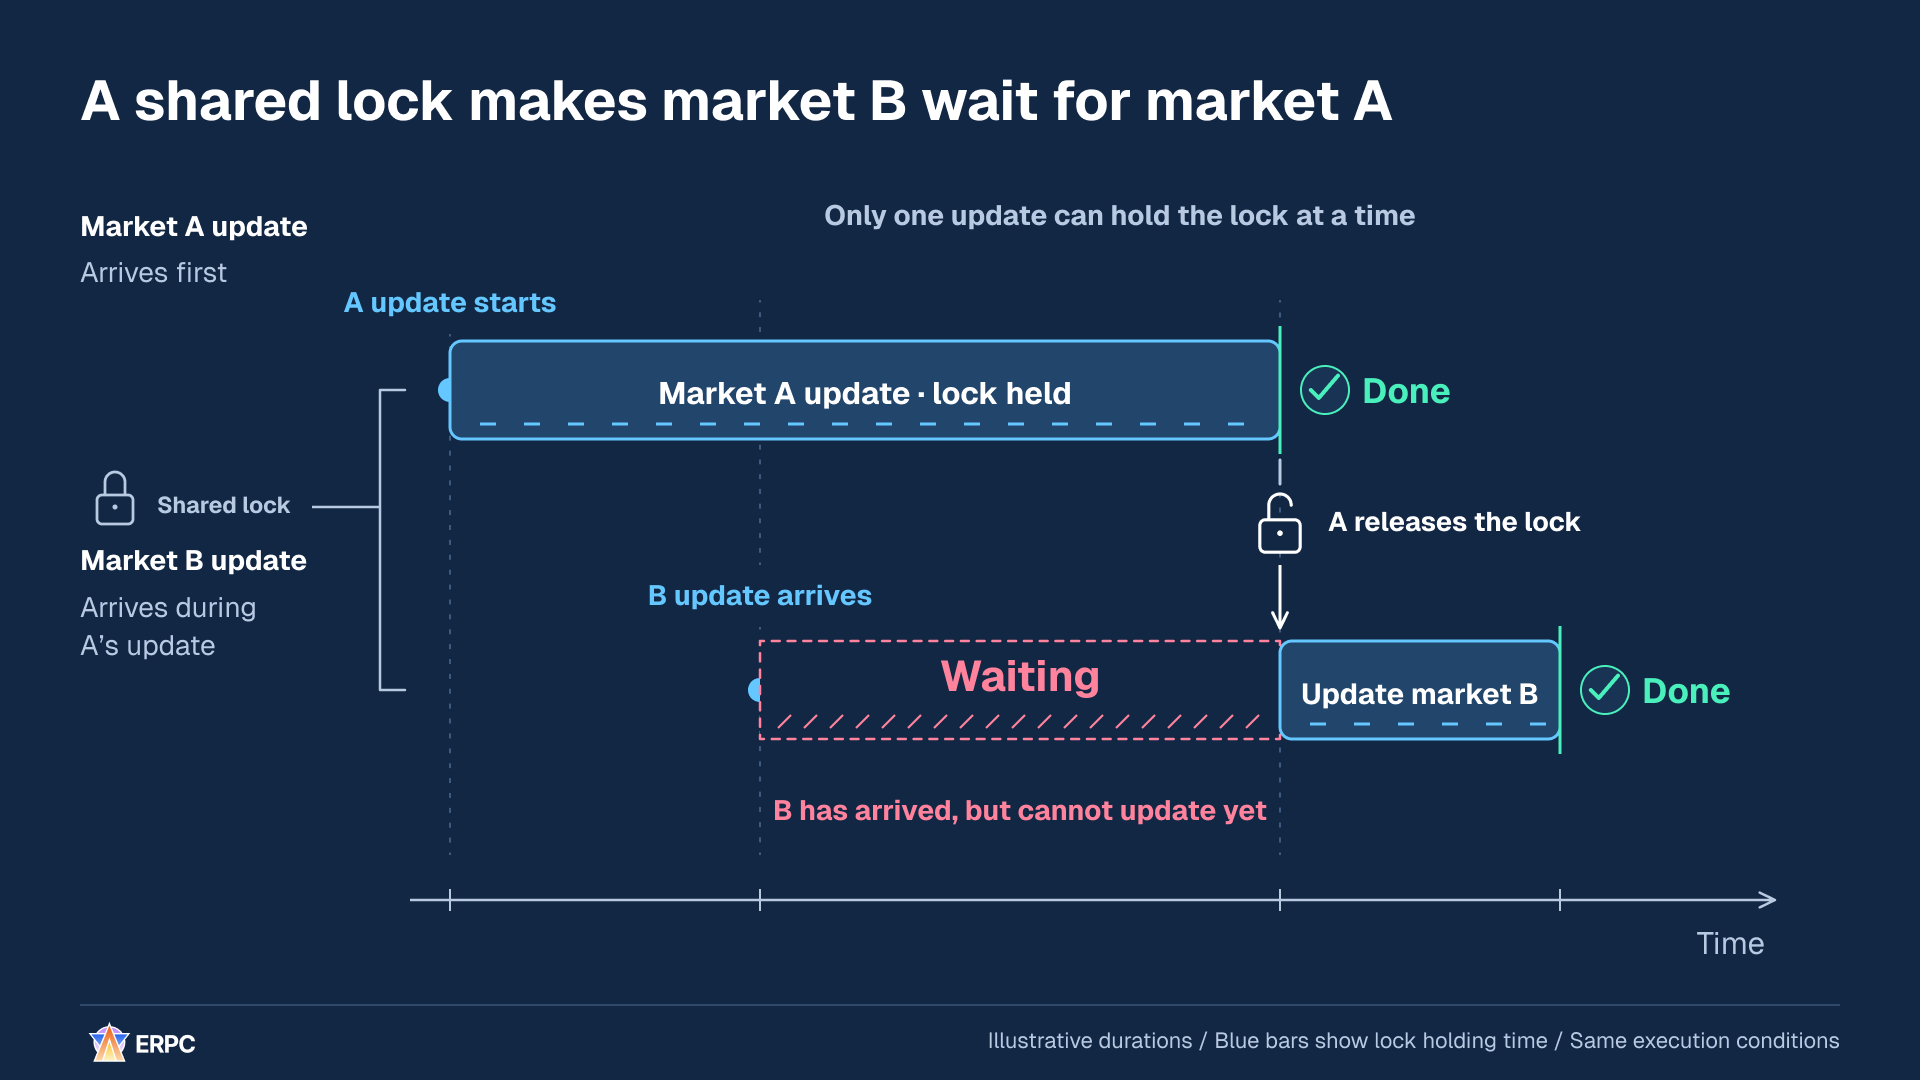
Die Daten von B sind angekommen, warten aber auf die gemeinsame Sperre, die A hält.
Ändern A und B jeweils getrennte Werte, können diese mit getrennten Sperren geschützt werden. Die obere Hälfte des nächsten Diagramms nutzt eine gemeinsame Sperre, die untere getrennte Sperren. Eingangspositionen und Haltezeiten der Sperren für A und B sind in beiden Hälften identisch. Das Beispiel setzt voraus, dass Bs Sperre frei und Ausführungskapazität für B vorhanden ist. Auch das offizielle Tokio-Tutorial beschreibt Mutex Sharding für Daten mit unabhängigen Schlüsseln.[18]
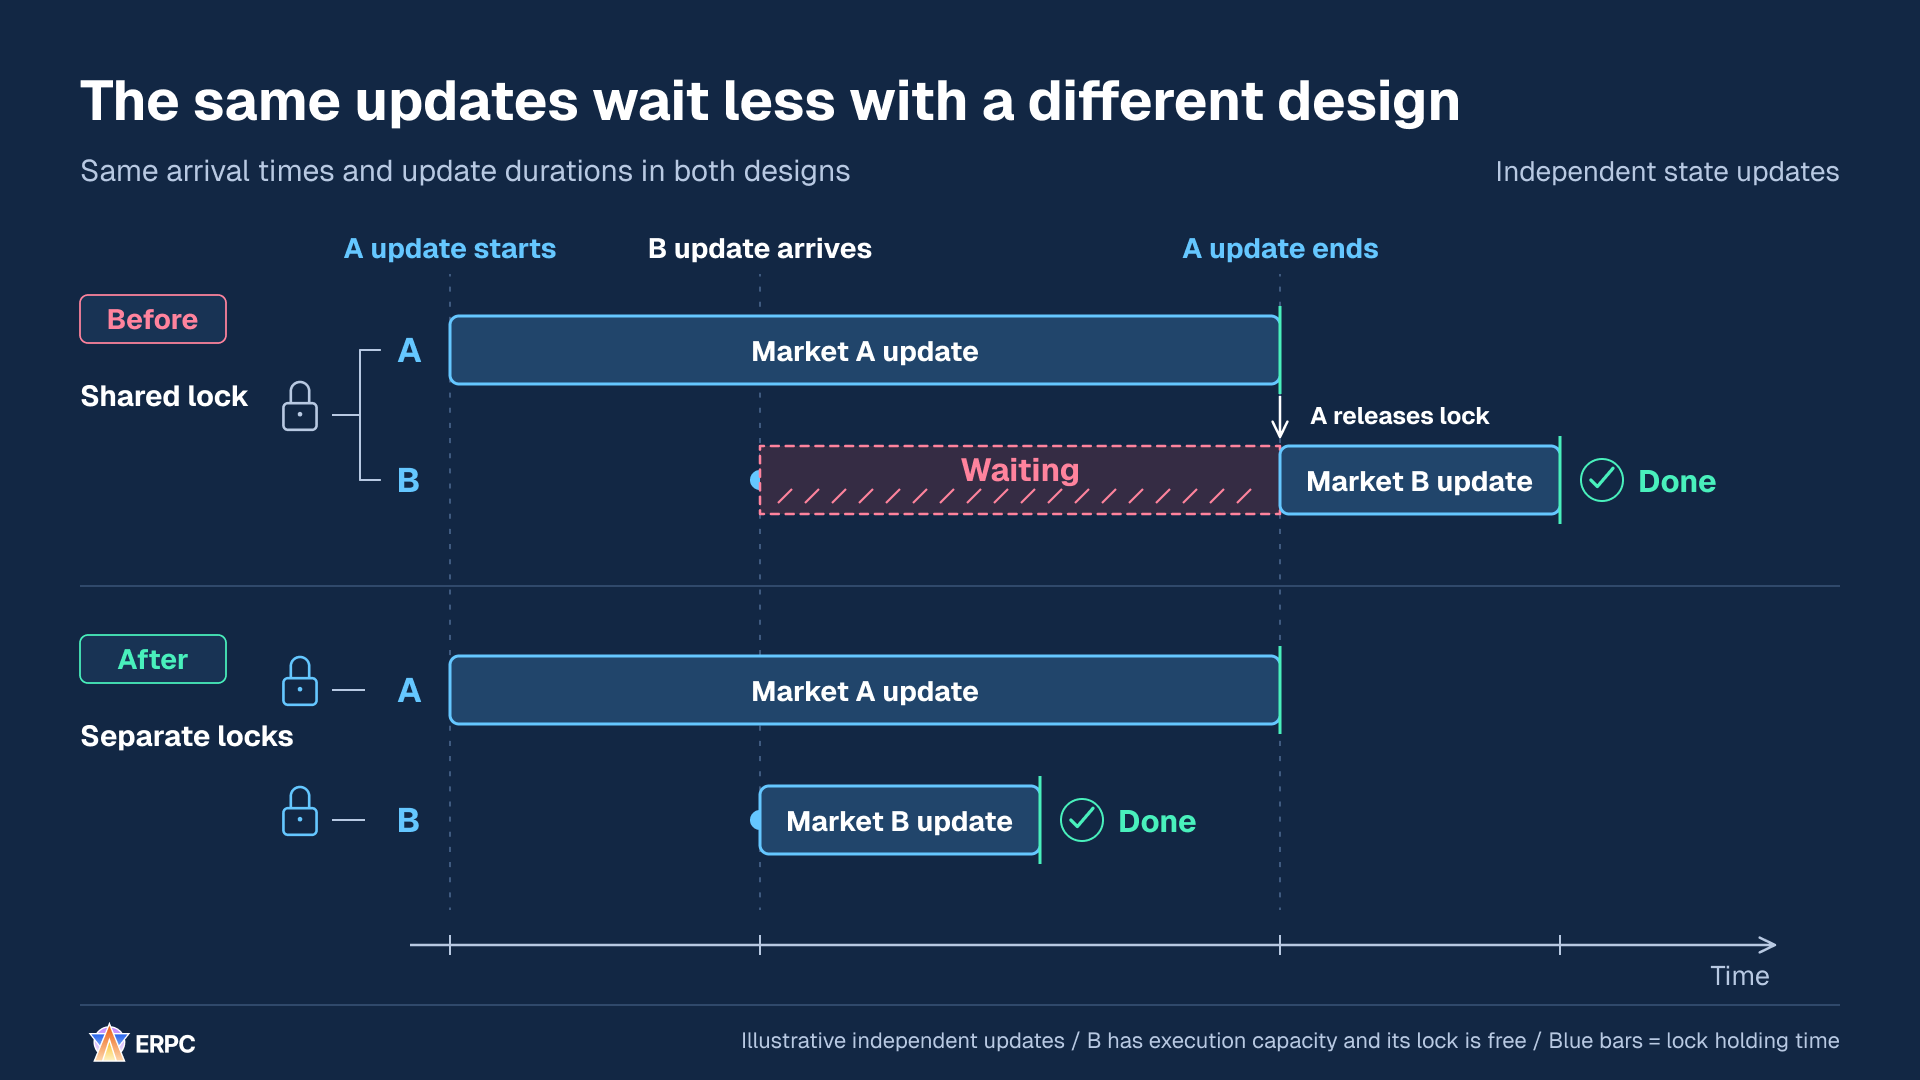
Bs blauer Balken ist gleich lang. Entfernt wurde das rosa Warteintervall davor.
Der blaue Balken reicht vom Erwerb der Sperre bis zu ihrer Freigabe. In diesem Beispiel ist B fertig, während A noch aktualisiert. Getrennte Sperren beseitigen keine Wartezeit, die dadurch entsteht, dass Bs eigene Sperre belegt ist oder andere Arbeit die verfügbaren Ausführungsressourcen beansprucht.
Klären Sie vor dem Aufteilen, welche Aktualisierungen unabhängig sind. Selbst wenn die Preise von A und B getrennt aktualisiert werden können, muss eine Entscheidung, die beide Preise oder einen gemeinsamen Kontostand nutzt, die erforderlichen Werte konsistent lesen können. Auch im selben Thread können sich Werte ändern, während ein Vorgang an einem await unterbrochen ist. Legen Sie fest, welche Versionen eine Entscheidung liest, wie sie diese liest und in welcher Reihenfolge Aktualisierungen angewendet werden.
Lesen A und B beispielsweise denselben Kontostand und erstellen jeweils eine Order, können beide damit rechnen, dieselben Mittel auszugeben. Gemeinsame Werte benötigen weiterhin eigenen Schutz, etwa eine einzige zuständige Instanz, die den Kontostand prüft und die Mittel für jede Order der Reihe nach reserviert.
Eine weitere Möglichkeit ist, jedem Zustand genau eine für Aktualisierungen zuständige Instanz zuzuordnen und ihr Aktualisierungsnachrichten zu senden. Dies ist das Single-Writer-Prinzip. Sperren aufzuteilen und einen einzigen Schreibenden festzulegen sind getrennte Entwurfsentscheidungen. LMAX Disruptor erläutert Single Writer und Verarbeitungsabhängigkeiten; Tokio beschreibt die Zustandsverwaltung über Nachrichten an eine dedizierte Task.[5][18]
Um Wartezeiten an Sperren zwischen unabhängigen Zustandsaktualisierungen zu verringern, können Sie diese Anweisungen kopieren.
text
Verbessere diese Anwendung dort, wo eine Aktualisierung für einen Markt oder Schlüssel eine unabhängige Aktualisierung auf dieselbe gemeinsame Sperre warten lässt.

Lies README, Entwicklungsanweisungen, Abhängigkeiten und den Code, der Zustände liest oder schreibt, Sperren anfordert oder mit await auf andere Arbeit wartet. Nutze die vorhandene Sprache und Laufzeitumgebung. Stelle fest, wer jeden Wert aktualisiert und welche Gruppen von Werten eine Entscheidung liest.

1. Sichere reproduzierbare Eingaben ohne vertrauliche Informationen und erfasse den Ausgangszustand. Protokolliere bei umkämpften Sperren die Eingänge je Schlüssel, die Wartezeit bis zum Erwerb, die Haltedauer, die Aktualisierungsreihenfolge und die für Entscheidungen verwendeten Zustandsversionen.
2. Unterscheide unabhängig aktualisierbare Werte von Werten, deren Konsistenz gemeinsam geschützt werden muss. Teile Sperren um unabhängige Zustände auf und mache die Anwendungsreihenfolge und Schreibverantwortung jedes Schlüssels ausdrücklich. Begrenze die Anzahl der Sperren oder Verarbeitungsverantwortlichen.
3. Schütze marktübergreifende Entscheidungen sowie gemeinsame Guthaben oder Reservierungen von Mitteln. Fasse Guthabenprüfung und Reservierung zu einem abgestimmten Vorgang zusammen, damit mehrere Aufträge nicht jeweils dieselben Mittel als verfügbar voraussetzen. Definiere eine Erwerbsreihenfolge, falls mehrere Sperren benötigt werden.
4. Untersuche Zustandsänderungen über await-Stellen hinweg und die Abschlussreihenfolge bei paralleler Dekodierung. Definiere, welche Versionen eine Entscheidung liest und wie sie diese liest. Lass die Abschlussreihenfolge der Dekodierung nicht die erforderliche Anwendungsreihenfolge ersetzen. Prüfe nach dem Aufteilen der Sperren, ob begrenzte Ausführungsressourcen oder Konkurrenz um denselben Schlüssel weiterhin Wartezeiten verursachen.
5. Spiele dieselben Eingaben in derselben Eingangsreihenfolge mit unabhängigen Schlüsseln, konzentrierten Aktualisierungen eines Schlüssels, konkurrierenden Reservierungen gemeinsamer Mittel sowie unterbrochener und fortgesetzter Arbeit erneut ab. Vergleiche Sperrwartezeiten, p50/p95/p99 vom Empfang bis zum Abschluss der Entscheidung, CPU und Speicher. Prüfe die erforderliche Aktualisierungsreihenfolge, einen konsistenten Entscheidungszustand und das Ausbleiben doppelter Reservierungen. Verwende für Zeitspannen innerhalb eines Hosts eine monotone Uhr und benenne Beginn und Ende der Messung.

Übernimm bestehende Freigaben, Berechtigungen und Entwicklungsverfahren. Behandle diese Anweisungen allein nicht als zusätzliche Berechtigung für Produktionsänderungen, kostenpflichtige Verträge oder echte Handelsgeschäfte. Gib keine privaten Schlüssel, Zugangsdaten oder Kundendaten aus.

Berichte die Änderungen, Vergleichsbedingungen, Vorher-Nachher-Messungen, Korrektheitsprüfungen und verbleibenden Einschränkungen. Kennzeichne nicht messbare Werte als nicht gemessen.
Verbessere diese Anwendung dort, wo eine Aktualisierung für einen Markt oder Schlüssel eine unabhängige Aktualisierung auf dieselbe gemeinsame Sperre warten lässt.
Lies README, Entwicklungsanweisungen, Abhängigkeiten und den Code, der Zustände liest oder schreibt, Sperren anfordert oder mit await auf andere Arbeit wartet. Nutze die vorhandene Sprache und Laufzeitumgebung. Stelle fest, wer jeden Wert aktualisiert und welche Gruppen von Werten eine Entscheidung liest.
1. Sichere reproduzierbare Eingaben ohne vertrauliche Informationen und erfasse den Ausgangszustand. Protokolliere bei umkämpften Sperren die Eingänge je Schlüssel, die Wartezeit bis zum Erwerb, die Haltedauer, die Aktualisierungsreihenfolge und die für Entscheidungen verwendeten Zustandsversionen.
2. Unterscheide unabhängig aktualisierbare Werte von Werten, deren Konsistenz gemeinsam geschützt werden muss. Teile Sperren um unabhängige Zustände auf und mache die Anwendungsreihenfolge und Schreibverantwortung jedes Schlüssels ausdrücklich. Begrenze die Anzahl der Sperren oder Verarbeitungsverantwortlichen.
3. Schütze marktübergreifende Entscheidungen sowie gemeinsame Guthaben oder Reservierungen von Mitteln. Fasse Guthabenprüfung und Reservierung zu einem abgestimmten Vorgang zusammen, damit mehrere Aufträge nicht jeweils dieselben Mittel als verfügbar voraussetzen. Definiere eine Erwerbsreihenfolge, falls mehrere Sperren benötigt werden.
4. Untersuche Zustandsänderungen über await-Stellen hinweg und die Abschlussreihenfolge bei paralleler Dekodierung. Definiere, welche Versionen eine Entscheidung liest und wie sie diese liest. Lass die Abschlussreihenfolge der Dekodierung nicht die erforderliche Anwendungsreihenfolge ersetzen. Prüfe nach dem Aufteilen der Sperren, ob begrenzte Ausführungsressourcen oder Konkurrenz um denselben Schlüssel weiterhin Wartezeiten verursachen.
5. Spiele dieselben Eingaben in derselben Eingangsreihenfolge mit unabhängigen Schlüsseln, konzentrierten Aktualisierungen eines Schlüssels, konkurrierenden Reservierungen gemeinsamer Mittel sowie unterbrochener und fortgesetzter Arbeit erneut ab. Vergleiche Sperrwartezeiten, p50/p95/p99 vom Empfang bis zum Abschluss der Entscheidung, CPU und Speicher. Prüfe die erforderliche Aktualisierungsreihenfolge, einen konsistenten Entscheidungszustand und das Ausbleiben doppelter Reservierungen. Verwende für Zeitspannen innerhalb eines Hosts eine monotone Uhr und benenne Beginn und Ende der Messung.
Übernimm bestehende Freigaben, Berechtigungen und Entwicklungsverfahren. Behandle diese Anweisungen allein nicht als zusätzliche Berechtigung für Produktionsänderungen, kostenpflichtige Verträge oder echte Handelsgeschäfte. Gib keine privaten Schlüssel, Zugangsdaten oder Kundendaten aus.
Berichte die Änderungen, Vergleichsbedingungen, Vorher-Nachher-Messungen, Korrektheitsprüfungen und verbleibenden Einschränkungen. Kennzeichne nicht messbare Werte als nicht gemessen.4. Bereiten Sie unveränderte Bestandteile vorab vor, um die Arbeit nach dem Eingang zu verringern
Angenommen, jede Preisaktualisierung veranlasst die Anwendung, dieselbe feste ID zu parsen, aus denselben Eingaben eine feste Adresse abzuleiten und Arbeitsspeicher zu reservieren. Dieser Arbeitsbereich wird auch Puffer genannt. Werden diese drei Vorbereitungen jedes Mal wiederholt, liegt auch die Vorbereitung unveränderter Informationen auf dem Weg zu jeder Entscheidung.
Vorbereitung, deren Eingaben sich nicht ändern, kann vor dem Dateneingang abgeschlossen und wiederverwendet werden. Nach dem Eingang prüft die Anwendung die für dieses Ereignis geänderten Informationen, erstellt die endgültige zu sendende Nachricht und signiert deren Inhalt.
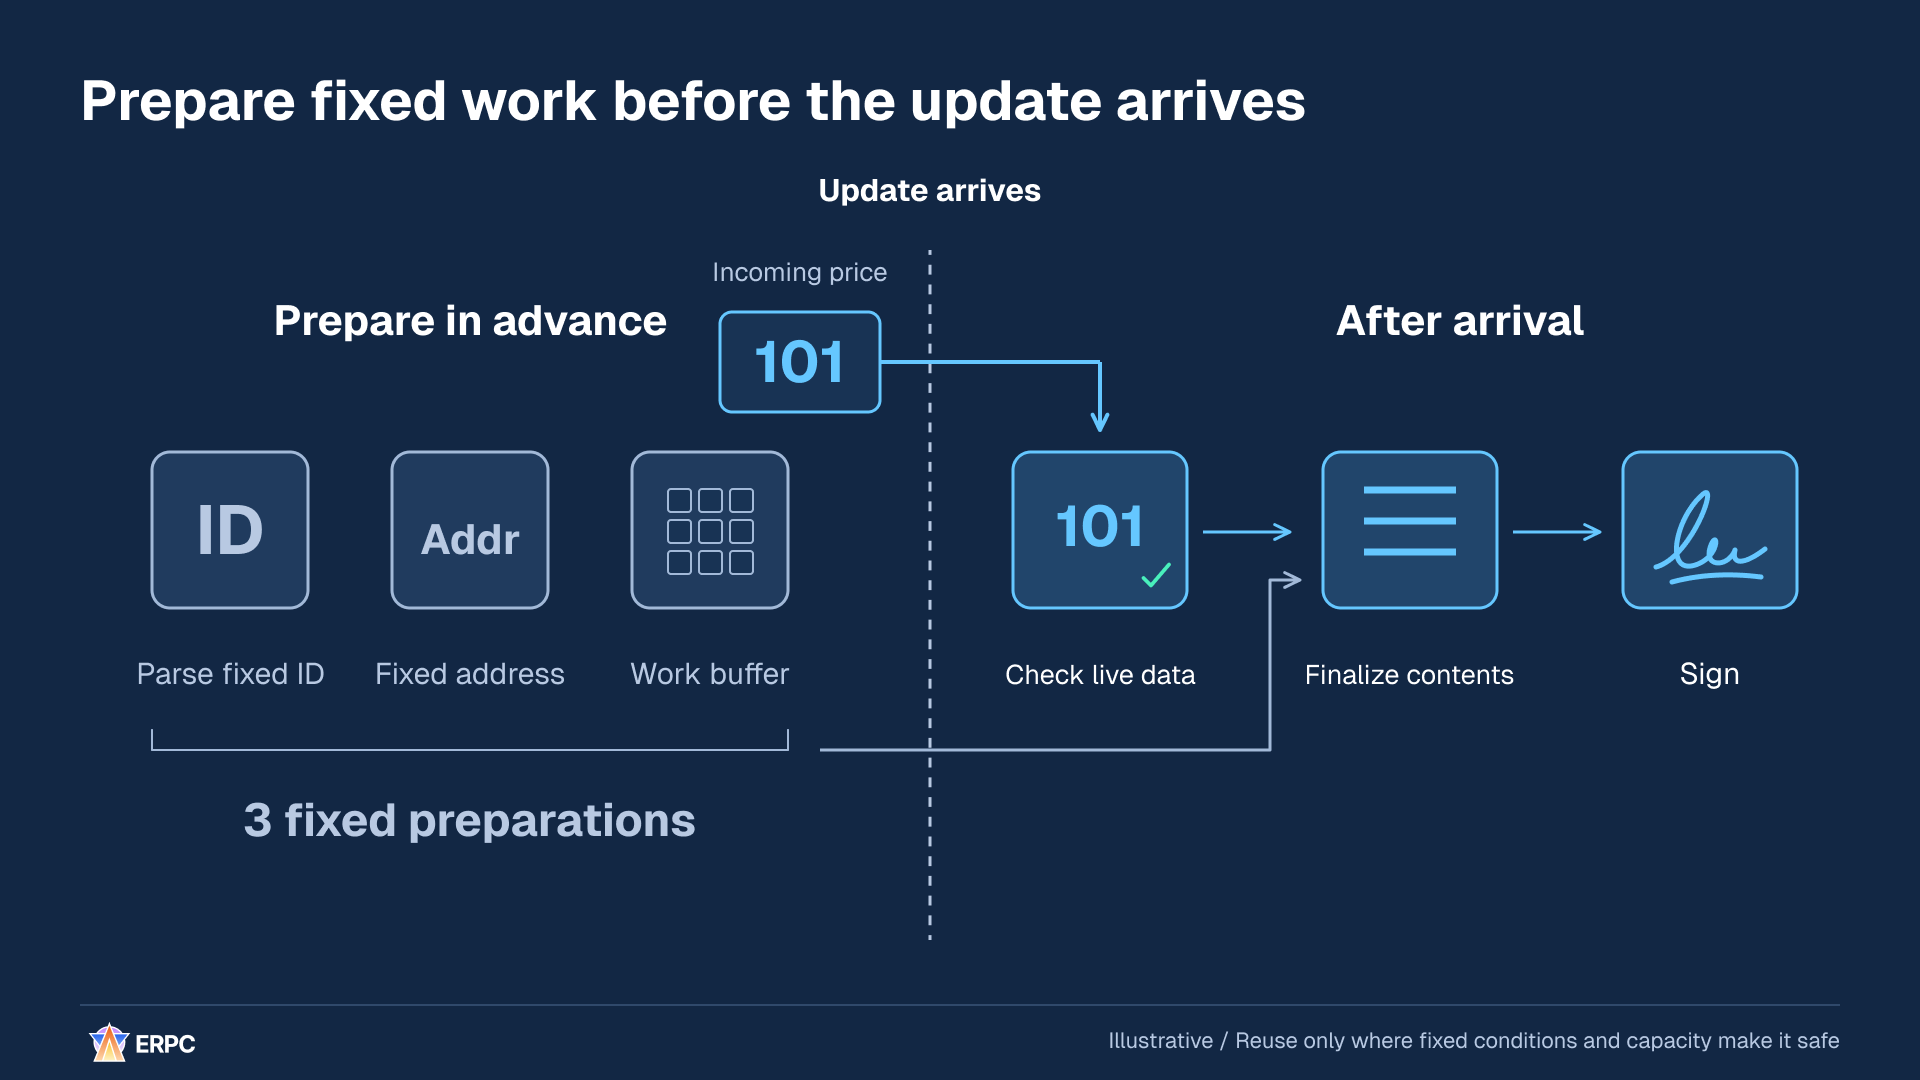
Verlagern Sie unveränderte Vorbereitung nach vorn und behalten Sie die Prüfung des aktuellen Inhalts und die Signierung nach dem Eingang bei.
Zählen wir, was sich bei drei Aktualisierungen verändert. Drei Arten von Bestandteilen für jedes Ereignis vorzubereiten erfordert neun Vorbereitungsvorgänge. Dieselben drei Arten einmal vorzubereiten und anschließend nacheinander wiederzuverwenden erfordert drei. Beide Entwürfe empfangen weiterhin drei Ereignisse, verarbeiten sie einzeln und erzeugen drei Ausgaben.
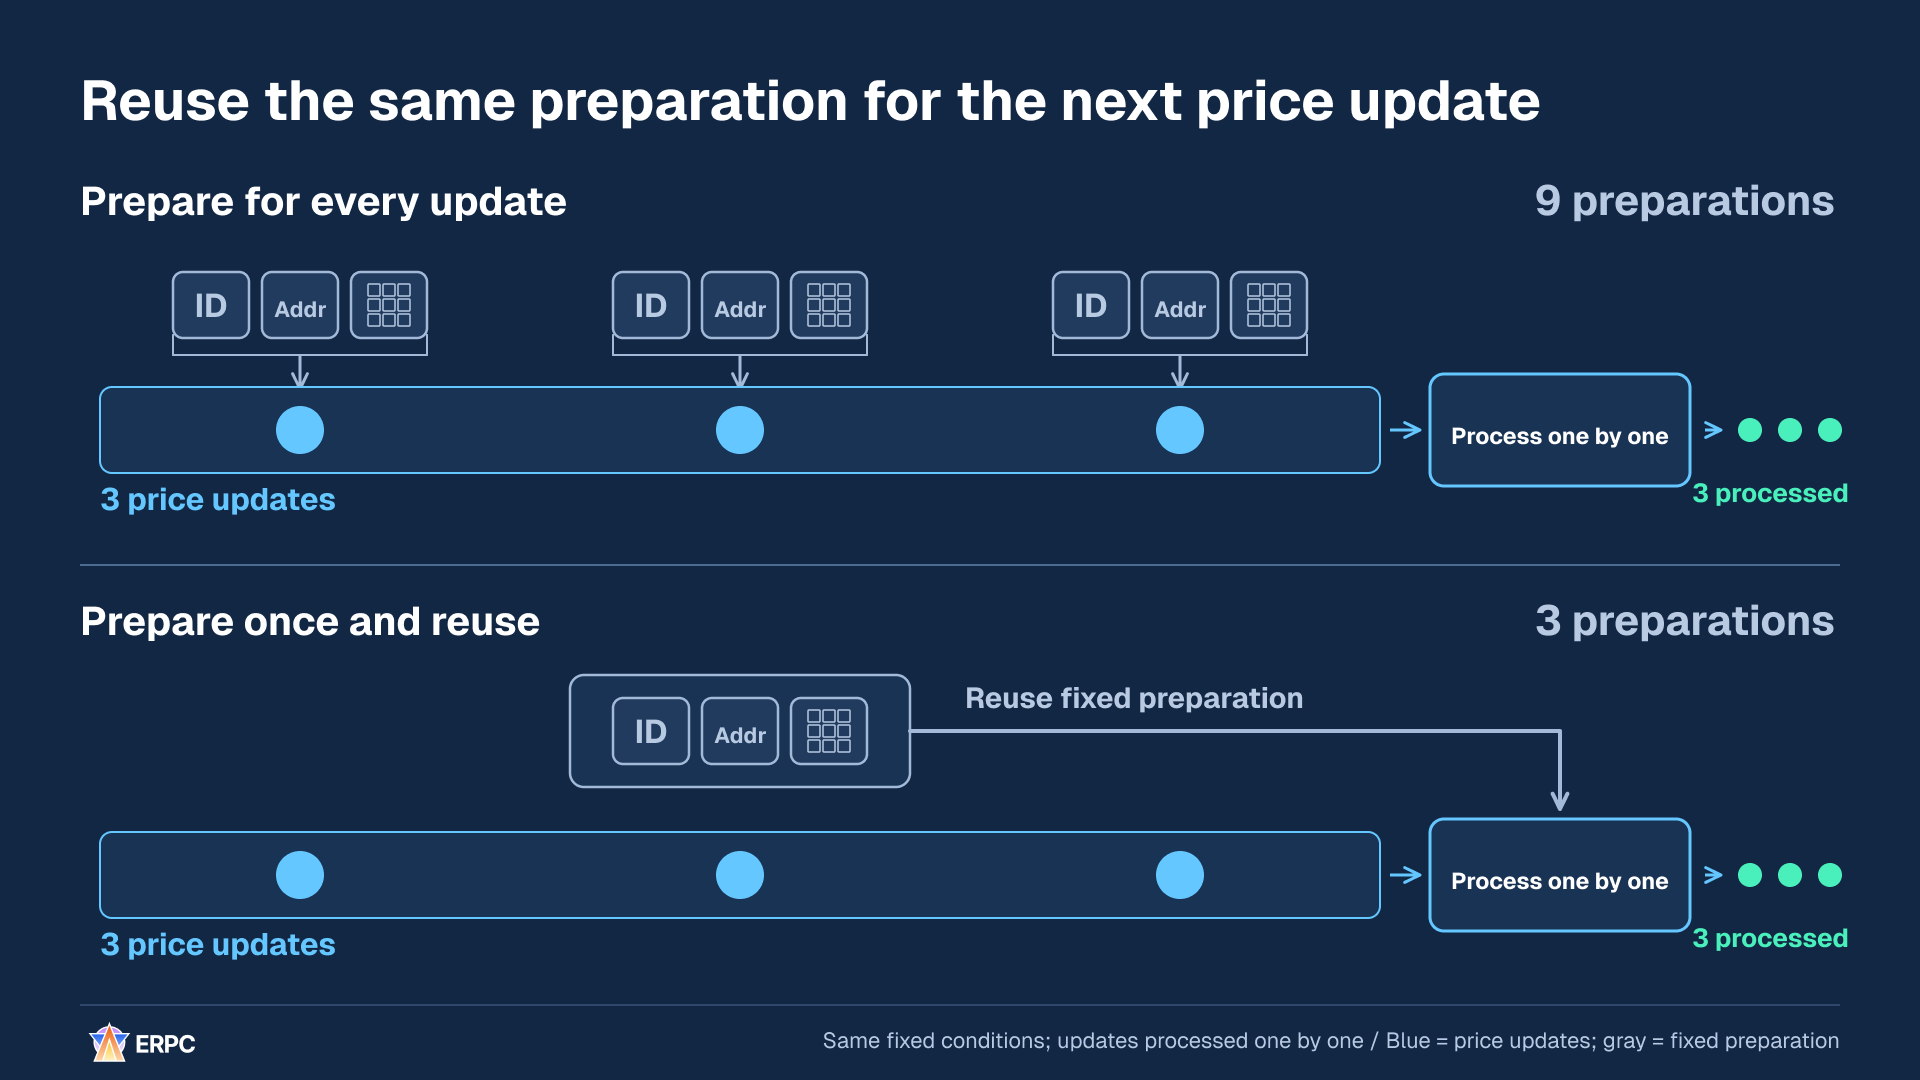
Die Zahl der Ereignisse bleibt drei, während die feste Vorbereitung in diesem Beispiel von neun auf drei Vorgänge sinkt.
Der Vergleich setzt voraus, dass die festen Bedingungen unverändert bleiben und der Arbeitsbereich sicher nacheinander wiederverwendet werden kann. Sein Inhalt wird weiterhin jedes Mal für das aktuelle Ereignis angepasst. Laufen mehrere Vorgänge gleichzeitig, verwenden Sie getrennte Bereiche pro Vorgang oder einen Pool mit geregeltem Zugriff, damit sie nicht denselben Speicher überschreiben.
Erweitern wir das Beispiel auf 1.000 Ereignisse. Werden für jedes Ereignis drei Arten von Bestandteilen vorbereitet, sind 3.000 Vorbereitungsvorgänge nötig. Die gemeinsame Vorbereitung einmal auszuführen erfordert drei. Beide Entwürfe empfangen 1.000 Ereignisse, verarbeiten sie einzeln und erzeugen 1.000 Ausgaben. Unterscheiden Sie die Anzahl der Vorbereitungen von der Anzahl verarbeiteter Ereignisse.
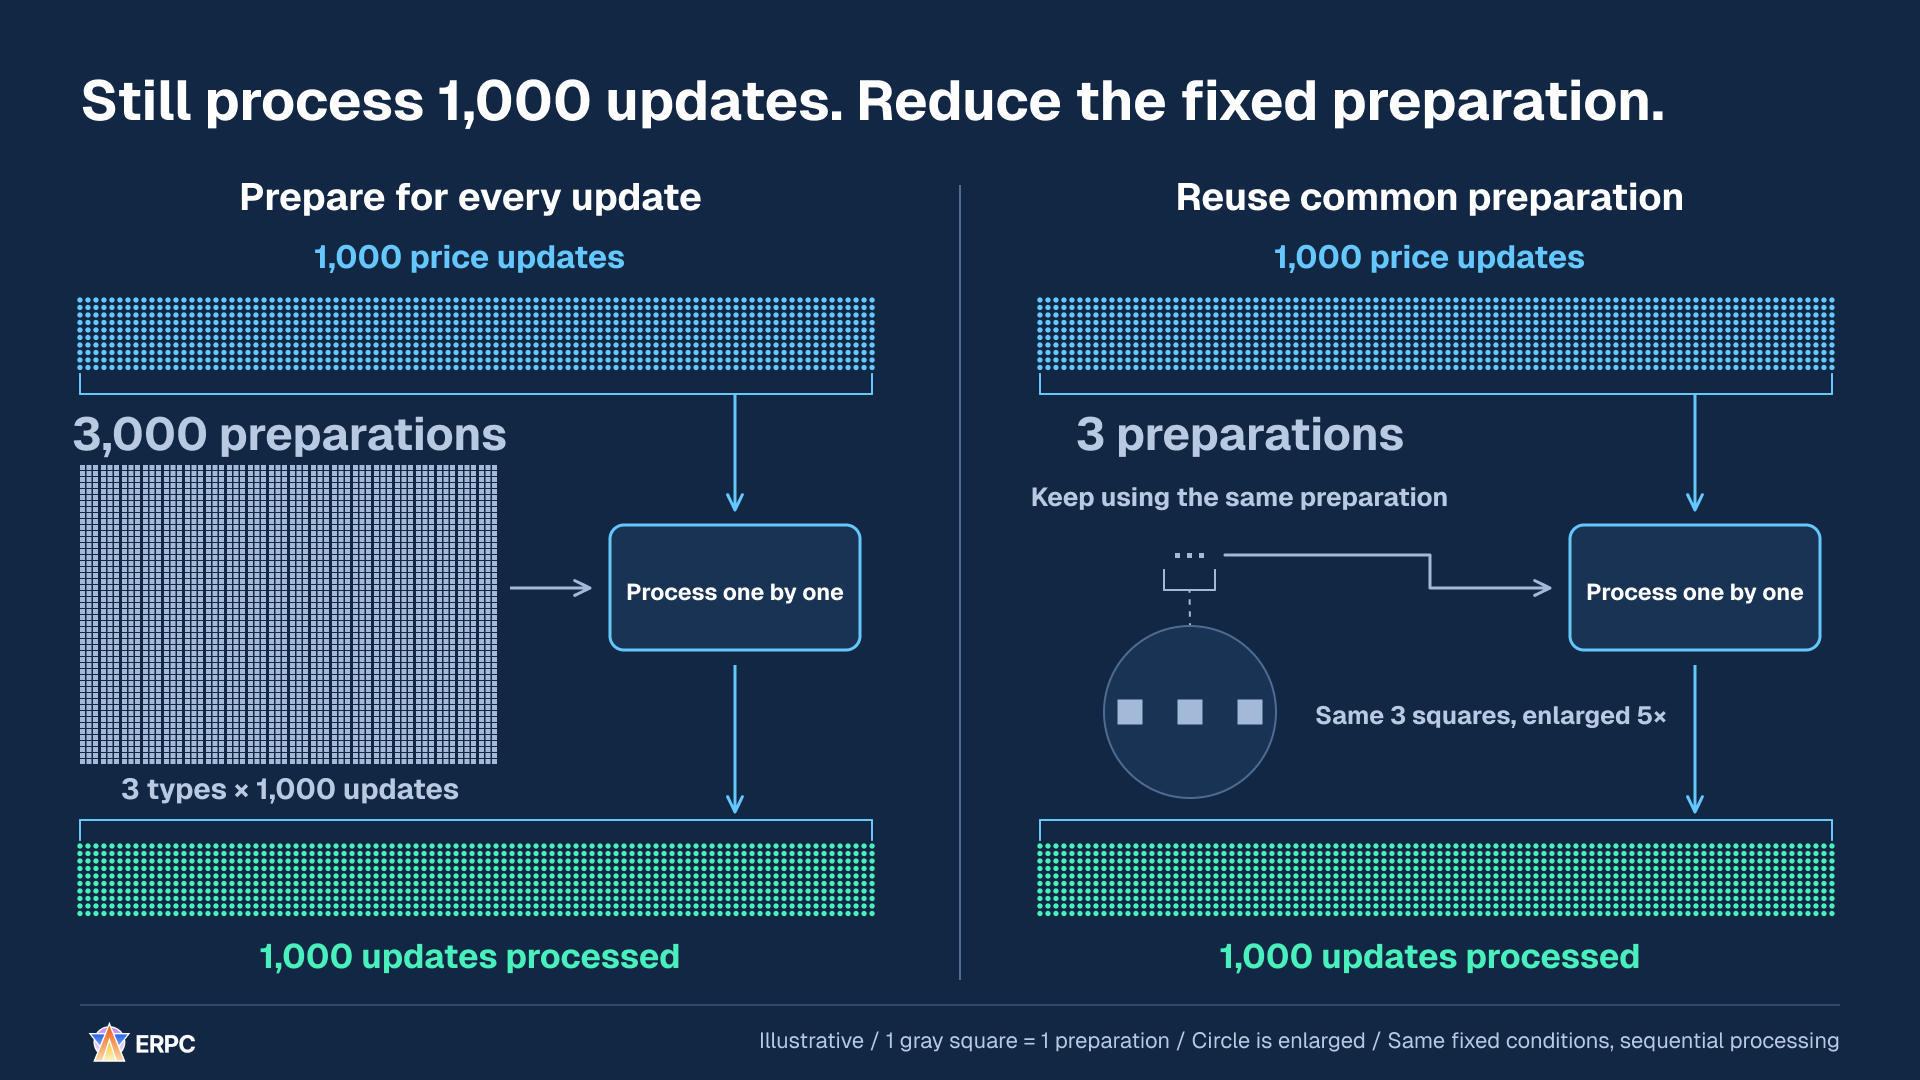
Reduziert wird die wiederholte feste Vorbereitung. Validierung, Entscheidungen, Signierung und andere Arbeit bleiben bestehen. Das Verhältnis dieser Anzahlen ist daher kein Beschleunigungsfaktor für die gesamte Anwendung.
Definieren Sie die Bedingungen, unter denen Wiederverwendung gültig bleibt. Ändert sich eine Eingabe für die Ableitung der festen Adresse, muss die Adresse neu berechnet werden. Preise, Mengen, Kontostände, referenzierte Account-Zustände, Risikolimits und Blockhashes müssen gültig sein, wenn die Entscheidung sie verwendet. Hält die Anwendung fortlaufend aktualisierten lokalen Zustand vor, prüfen Sie dessen Version, Aktualität und Gültigkeit. Dafür muss nicht zwangsläufig für jede Entscheidung alles erneut per RPC abgerufen werden.
Solanas getLatestBlockhash liefert einen Blockhash und den zugehörigen lastValidBlockHeight. Unterscheiden Sie bei der Ablaufprüfung zwischen Blockhöhe und Slot.[7] Legen Sie die Nachricht vor dem Signieren endgültig fest. Wird sie nach dem Signieren geändert, erzeugen Sie Signaturen für den aktualisierten Inhalt.[19]
Um feste Vorbereitungen wiederzuverwenden und die Arbeit nach dem Empfang zu verringern, können Sie diese Anweisungen kopieren.
text
Untersuche Arbeit, die für jede Eingabe dasselbe Parsing, dieselbe Adressableitung oder dieselbe Speicherallokation wiederholt, und verlagere wiederverwendbare Vorbereitung vor den Empfang.

Lies README, Entwicklungsanweisungen, Abhängigkeiten und den Code für Empfang → Vorbereitung → Entscheidung → Nachrichtenerstellung → Signatur. Nutze die vorhandene Sprache, Laufzeitumgebung und das vorhandene SDK. Identifiziere Eingaben, Ausgaben, Verantwortlichen und Gültigkeitsdauer jeder Vorbereitung.

1. Sichere reproduzierbare Eingaben ohne vertrauliche Informationen. Erfasse Ereignis- und Ausgabeanzahl, Ausführungsanzahl und Dauer jeder Vorbereitung, allokierten Speicher und die Zeit vom Empfang bis zum Abschluss der Entscheidung.
2. Identifiziere Vorbereitungen mit unveränderten Eingaben, führe sie bei der Initialisierung oder in einer anderen geeigneten früheren Phase aus und verwende ihre Ergebnisse erneut. Implementiere Wiederverwendungsschlüssel, Ungültigmachung und Neuberechnung bei Änderungen von Eingaben oder Konfiguration sowie Grenzen für Caches und Pufferpools.
3. Aktualisiere wiederverwendbaren Arbeitsspeicher für die aktuelle Eingabe. Nutze bei gleichzeitiger Arbeit getrennte Bereiche oder verwaltete Ausleihen, damit ein Bereich während seiner Nutzung weder überschrieben noch zurückgegeben wird.
4. Prüfe Preise, Mengen, Guthaben, Kontozustand, Risikobedingungen und Blockhashes gemäß den Anforderungen der Entscheidung. Prüfe bei fortlaufend aktualisiertem lokalem Zustand Version und Aktualität. Unterscheide bei Solana Blockhöhe und Slot, wenn lastValidBlockHeight zur Prüfung des Blockhash-Ablaufs verwendet wird. Schließe die Nachricht vor dem Signieren ab und signiere die aktualisierte Nachricht erneut, wenn sich ihr Inhalt nach dem Signieren ändert.
5. Vergleiche bei identischen Eingaben Vorbereitungsanzahl und -dauer, p50/p95/p99 vom Empfang bis zum Abschluss der Entscheidung, CPU und Speicher sowie Ausgaben. Reproduziere auch geänderte Eingaben oder Konfigurationen, Ablauf der Gültigkeit und gleichzeitige Ausführung, um die Wiederverwendung veralteter Ergebnisse und Speicherkonflikte zu prüfen. Behandle das Verhältnis der Vorbereitungsanzahlen nicht als Beschleunigungsfaktor der gesamten Anwendung. Verwende für Zeitspannen innerhalb eines Hosts eine monotone Uhr und benenne Beginn und Ende der Messung.

Übernimm bestehende Freigaben, Berechtigungen und Entwicklungsverfahren. Behandle diese Anweisungen allein nicht als zusätzliche Berechtigung für Produktionsänderungen, kostenpflichtige Verträge oder echte Handelsgeschäfte. Gib keine privaten Schlüssel, Zugangsdaten oder Kundendaten aus.

Berichte die Änderungen, Vergleichsbedingungen, Vorher-Nachher-Messungen, Korrektheitsprüfungen und verbleibenden Einschränkungen. Kennzeichne nicht messbare Werte als nicht gemessen.
Untersuche Arbeit, die für jede Eingabe dasselbe Parsing, dieselbe Adressableitung oder dieselbe Speicherallokation wiederholt, und verlagere wiederverwendbare Vorbereitung vor den Empfang.
Lies README, Entwicklungsanweisungen, Abhängigkeiten und den Code für Empfang → Vorbereitung → Entscheidung → Nachrichtenerstellung → Signatur. Nutze die vorhandene Sprache, Laufzeitumgebung und das vorhandene SDK. Identifiziere Eingaben, Ausgaben, Verantwortlichen und Gültigkeitsdauer jeder Vorbereitung.
1. Sichere reproduzierbare Eingaben ohne vertrauliche Informationen. Erfasse Ereignis- und Ausgabeanzahl, Ausführungsanzahl und Dauer jeder Vorbereitung, allokierten Speicher und die Zeit vom Empfang bis zum Abschluss der Entscheidung.
2. Identifiziere Vorbereitungen mit unveränderten Eingaben, führe sie bei der Initialisierung oder in einer anderen geeigneten früheren Phase aus und verwende ihre Ergebnisse erneut. Implementiere Wiederverwendungsschlüssel, Ungültigmachung und Neuberechnung bei Änderungen von Eingaben oder Konfiguration sowie Grenzen für Caches und Pufferpools.
3. Aktualisiere wiederverwendbaren Arbeitsspeicher für die aktuelle Eingabe. Nutze bei gleichzeitiger Arbeit getrennte Bereiche oder verwaltete Ausleihen, damit ein Bereich während seiner Nutzung weder überschrieben noch zurückgegeben wird.
4. Prüfe Preise, Mengen, Guthaben, Kontozustand, Risikobedingungen und Blockhashes gemäß den Anforderungen der Entscheidung. Prüfe bei fortlaufend aktualisiertem lokalem Zustand Version und Aktualität. Unterscheide bei Solana Blockhöhe und Slot, wenn lastValidBlockHeight zur Prüfung des Blockhash-Ablaufs verwendet wird. Schließe die Nachricht vor dem Signieren ab und signiere die aktualisierte Nachricht erneut, wenn sich ihr Inhalt nach dem Signieren ändert.
5. Vergleiche bei identischen Eingaben Vorbereitungsanzahl und -dauer, p50/p95/p99 vom Empfang bis zum Abschluss der Entscheidung, CPU und Speicher sowie Ausgaben. Reproduziere auch geänderte Eingaben oder Konfigurationen, Ablauf der Gültigkeit und gleichzeitige Ausführung, um die Wiederverwendung veralteter Ergebnisse und Speicherkonflikte zu prüfen. Behandle das Verhältnis der Vorbereitungsanzahlen nicht als Beschleunigungsfaktor der gesamten Anwendung. Verwende für Zeitspannen innerhalb eines Hosts eine monotone Uhr und benenne Beginn und Ende der Messung.
Übernimm bestehende Freigaben, Berechtigungen und Entwicklungsverfahren. Behandle diese Anweisungen allein nicht als zusätzliche Berechtigung für Produktionsänderungen, kostenpflichtige Verträge oder echte Handelsgeschäfte. Gib keine privaten Schlüssel, Zugangsdaten oder Kundendaten aus.
Berichte die Änderungen, Vergleichsbedingungen, Vorher-Nachher-Messungen, Korrektheitsprüfungen und verbleibenden Einschränkungen. Kennzeichne nicht messbare Werte als nicht gemessen.5. Treffen Sie keine weiteren Entscheidungen, wenn notwendige Aktualisierungen fehlen
Betrachten wir zwei Märkte für denselben Vermögenswert. Die Anwendung berechnet die Preisdifferenz B−A. Während die Verbindung unterbrochen ist, ändert sich Markt A von 100 auf 105 und die Anwendung verpasst diese Aktualisierung. Empfängt sie nach dem Wiederverbinden nur Bs Preis von 104, berechnet sie 104−100, also +4. Mit dem aktualisierten Wert von A ergibt sich 104−105, also -1. Sogar das Vorzeichen ändert sich.
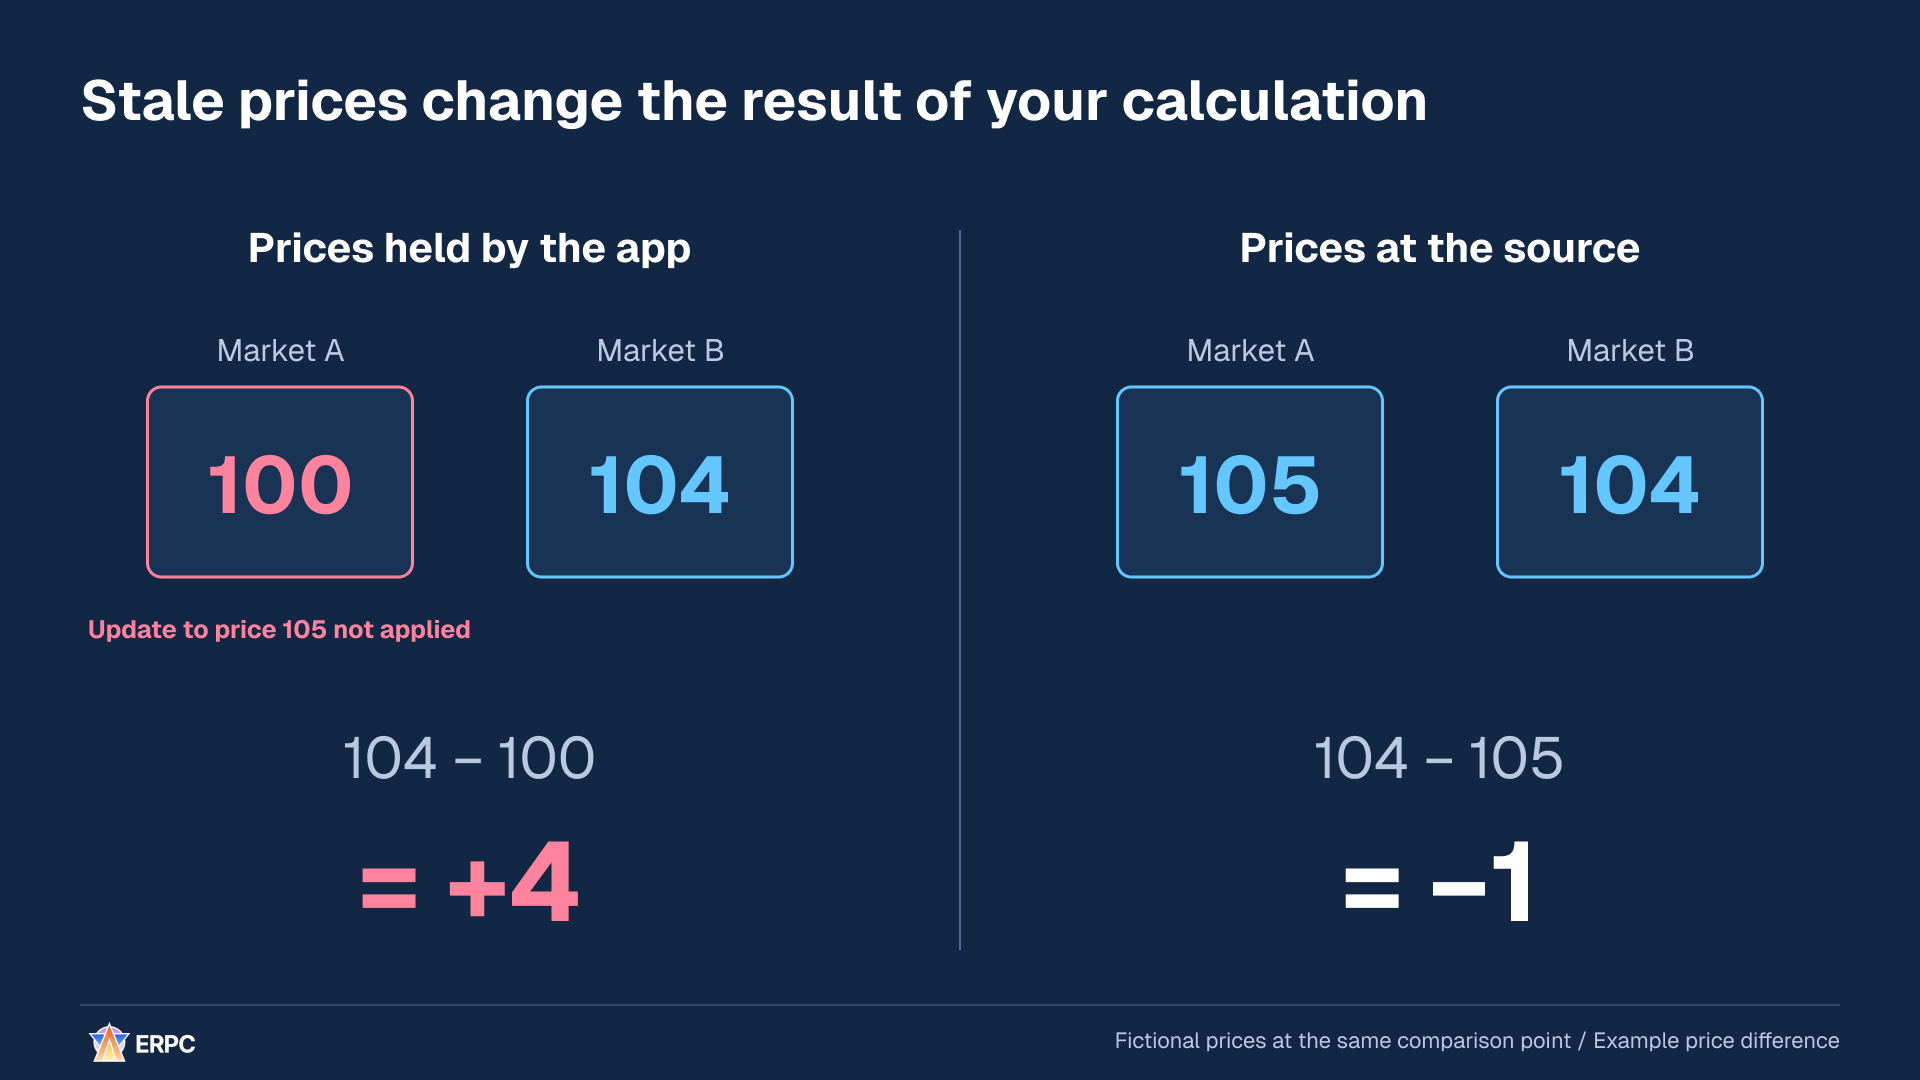
Dieselbe Berechnung fällt unterschiedlich aus, je nachdem, ob sie As alten Wert 100 oder den aktualisierten Wert 105 nutzt.
Dieses Modell zeigt nur eine Preisdifferenz. Gebühren, Ausführungsbedingungen und andere Faktoren sind nicht enthalten; es stellt keinen Handelsgewinn dar. Entscheidend ist, dass eine wiederhergestellte Verbindung nicht zwangsläufig alle für eine Entscheidung nötigen Aktualisierungen wiederherstellt.
Pausieren Sie in diesem Beispiel neue Handelsentscheidungen, die die Preise von A und B nutzen, und ersetzen Sie As alten Wert 100 durch den wiederhergestellten Wert 105. Prüfen Sie dann, ob die erforderlichen Aktualisierungen auf A und B angewendet wurden und die Bedingungen für Reihenfolge und Aktualität erfüllt sind. Setzen Sie Entscheidungen nach Abschluss der notwendigen Prüfungen fort; können diese nicht abgeschlossen werden, bleibt die Pause bestehen.
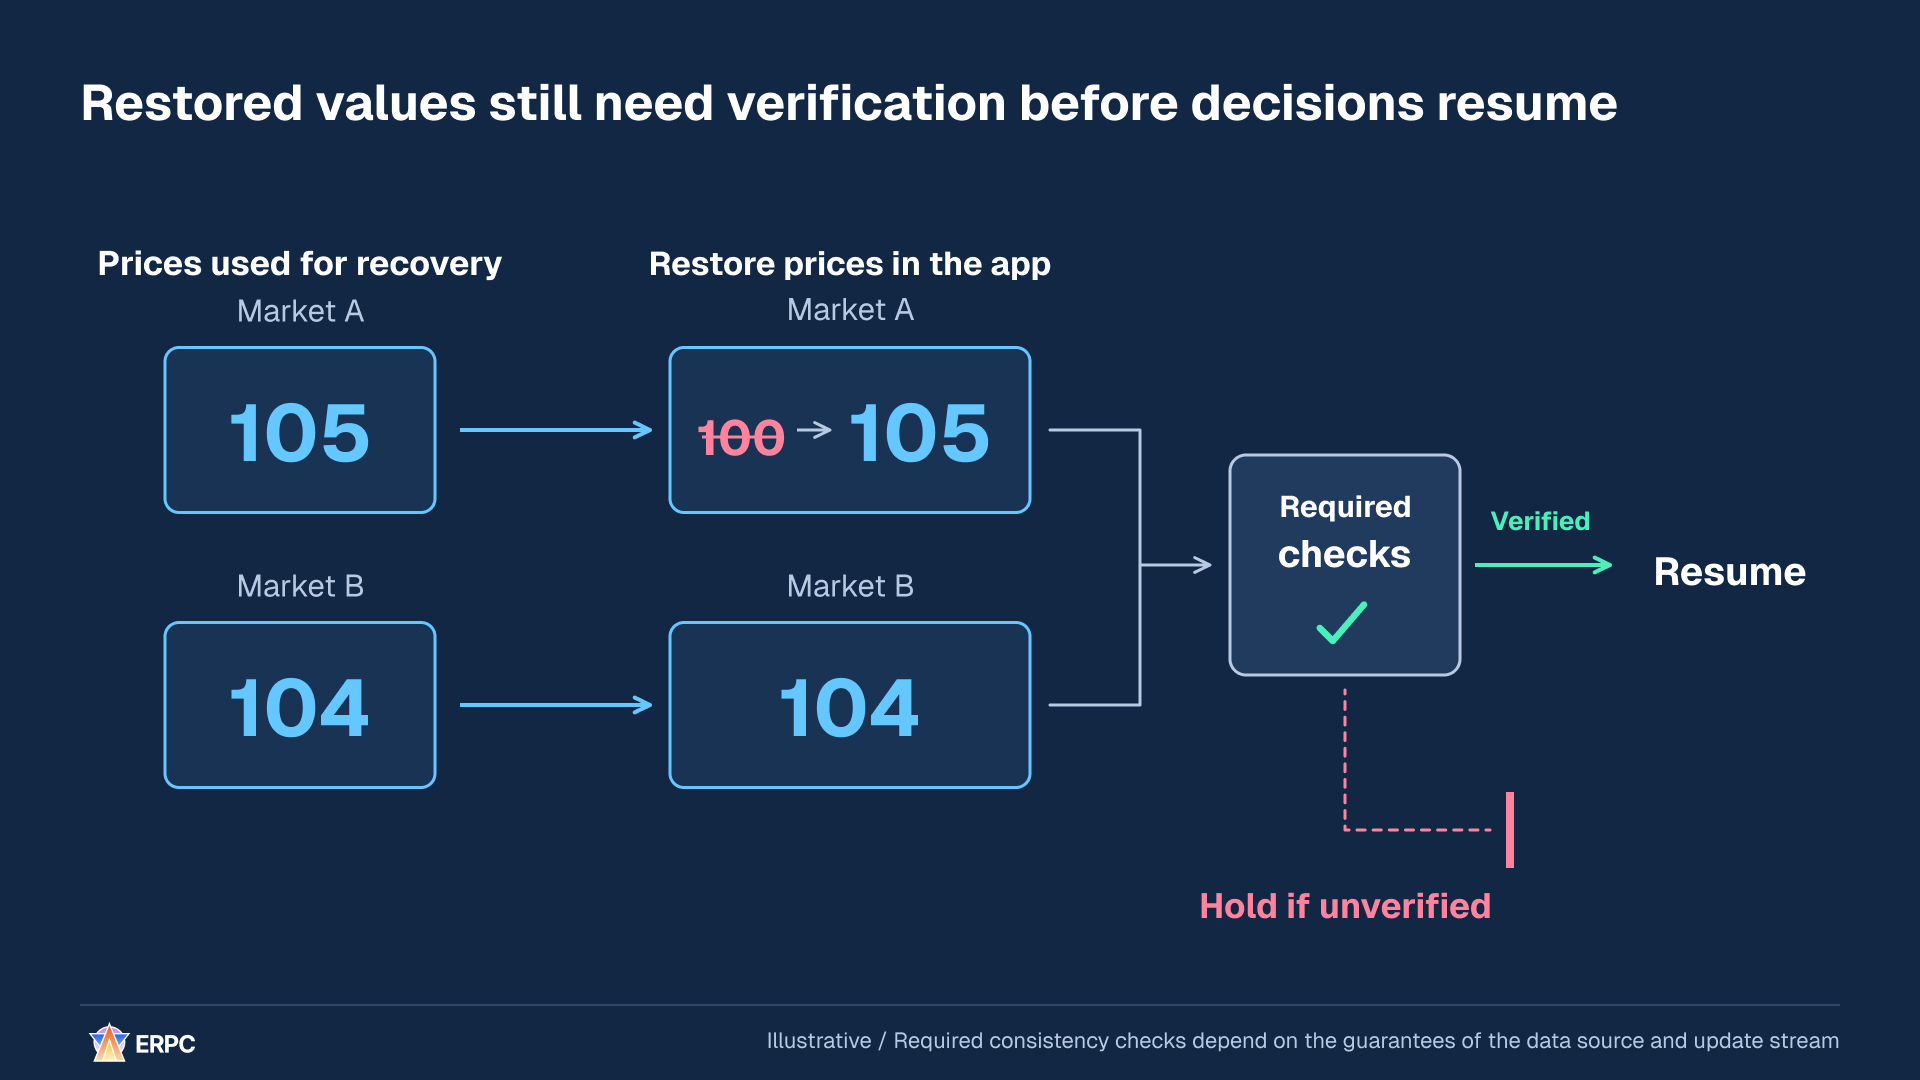
Trennen Sie das Aktualisieren von Werten von der Prüfung, ob diese Werte für Entscheidungen verwendet werden dürfen.
Ein häufiges Wiederherstellungsverfahren ist ein Snapshot: eine Momentaufnahme des Zustands zu einem bestimmten Zeitpunkt. Beim Anschluss an einen kontinuierlichen Aktualisierungsstrom muss geklärt werden, welche Aktualisierungen bereits im Snapshot enthalten sind und welche späteren angewendet werden sollen. So wird verhindert, dass eine enthaltene Differenz doppelt angewendet wird oder eine Aktualisierung an der Grenze verloren geht. Das konkrete Verfahren muss den Garantien der gewählten API für Abonnementbeginn, Identifikation, erneuten Abruf und Wiederholung entsprechen.
Yellowstone-Nachrichten enthalten Felder wie slot und write_version.[16] Allein ihre Existenz garantiert weder eine anbieterübergreifend verwendbare Reihenfolge noch vollständige Lückenerkennung. Wandeln Sie eine Slot-Differenz nicht direkt in eine Anzahl fehlender Aktualisierungen oder Sekunden Latenz um. Prüfen Sie entsprechend den Garantien des gewählten Anbieters, ob der Zustand korrekt wieder angeschlossen wurde.
Berücksichtigen Sie auch Berechnungen, die vor der Wiederherstellung begonnen haben. Ein Vorgang, der mit altem Zustand startete und erst nach der Wiederherstellung endet, könnte den neuen Zustand mit seinem Ergebnis überschreiben. Eine Möglichkeit ist, dem Zustand über die Wiederherstellung hinweg eine Generationsnummer zuzuordnen und Ergebnisse älterer Generationen abzulehnen. Bei processed-Zustand sollten auch Rollbacks (bei denen dieser Zustand nicht weiter übernommen wird) Anlass sein, den Zustand neu zu prüfen.[6]
Um nach einer Wiederverbindung einen gültigen Zustand wiederherzustellen, bevor Entscheidungen fortgesetzt werden, können Sie diese Anweisungen kopieren.
text
Verhindere, dass diese Anwendung Handelsentscheidungen mit veraltetem Zustand allein deshalb fortsetzt, weil die Verbindung wiederhergestellt ist. Implementiere die Wiederherstellung des erforderlichen Zustands, bevor Entscheidungen weiterlaufen.

Lies README, Entwicklungsanweisungen, Abhängigkeiten und den Code für Abonnements, initialen Abruf, Übernahme von Aktualisierungen, Wiederverbindung und Entscheidungen. Nutze die vorhandene Sprache, Laufzeitumgebung und das vorhandene SDK. Prüfe Anbieter, Commitment, Aktualisierungssemantik und tatsächliche Garantien für Reihenfolge, Identifikation, erneuten Abruf und Wiedergabe.

1. Trenne Verbindungsstatus, Datengültigkeit und Erlaubnis zur Fortsetzung von Entscheidungen. Stehen fehlende notwendige Aktualisierungen oder unzureichende Aktualität fest, pausiere neue Handelsentscheidungen, die von diesem Zustand abhängen, während notwendiger Empfang, Aktualisierung und Wiederherstellung weiterlaufen.
2. Kläre bei Verwendung eines Snapshots anhand der Garantien des Anbieters, welche Aktualisierungen er enthält und wo seine Grenze zum anschließenden Stream liegt. Verhindere doppelte Anwendung von Änderungen, Lücken an der Grenze und eine falsche Anwendungsreihenfolge. Ergänze fehlende Garantien nicht durch Annahmen. Behandle slot oder write_version nicht als bedingungslos gültige Sequenz zur Erkennung fehlender Aktualisierungen.
3. Setze Entscheidungen nicht allein deshalb fort, weil Werte abgerufen wurden. Implementiere Prüfungen der für die betroffenen Entscheidungen erforderlichen Aktualisierungen, Reihenfolge, Aktualität und Konsistenz. Halte diese Entscheidungen pausiert, solange die Prüfungen nicht abgeschlossen werden können. Nutze Generationen oder einen gleichwertigen Mechanismus, damit alte Berechnungen oder Auftragsvorschläge weder übernommen noch gesendet werden, wenn vor der Wiederherstellung gestartete Arbeit erst später endet. Triff bei der Fortsetzung neue Entscheidungen aus dem geprüften Zustand. Berücksichtige bei processed-Zustand die Ungültigmachung und Wiederherstellung nach einem Rollback.
4. Reproduziere mit Eingaben ohne vertrauliche Informationen während einer Trennung verpasste Aktualisierungen, Duplikate, umgeordnete Aktualisierungen, veraltete Daten, wiederholte Wiederverbindungen und den Abschluss von Arbeit aus einer alten Generation. Prüfe, dass Entscheidungen vom Rückkehrzeitpunkt der Verbindung bis zum Abschluss der Prüfung pausiert bleiben und dass der geprüfte Zustand dem erwarteten Ergebnis entspricht.
5. Erfasse Wiederherstellungszeit, Anzahl der durch ungültigen Zustand unterdrückten Entscheidungsversuche, Pausendauer, erneut angewendete oder ausgeschlossene Aktualisierungen, normale Zeit vom Empfang bis zum Abschluss der Entscheidung sowie CPU und Speicher. Schließe pausierte Zeiträume oder fehlende Aktualisierungen nicht stillschweigend aus den Messungen aus. Benenne die Messgrenzen sowie das, was erkannt und nicht erkannt werden kann. Verwende für Zeitspannen innerhalb eines Hosts eine monotone Uhr.

Übernimm bestehende Freigaben, Berechtigungen und Entwicklungsverfahren. Behandle diese Anweisungen allein nicht als zusätzliche Berechtigung für Produktionsänderungen, kostenpflichtige Verträge oder echte Handelsgeschäfte. Gib keine privaten Schlüssel, Zugangsdaten oder Kundendaten aus.

Berichte die Änderungen, Vergleichsbedingungen, Vorher-Nachher-Messungen, Korrektheitsprüfungen und verbleibenden Einschränkungen. Kennzeichne nicht messbare Werte als nicht gemessen.
Verhindere, dass diese Anwendung Handelsentscheidungen mit veraltetem Zustand allein deshalb fortsetzt, weil die Verbindung wiederhergestellt ist. Implementiere die Wiederherstellung des erforderlichen Zustands, bevor Entscheidungen weiterlaufen.
Lies README, Entwicklungsanweisungen, Abhängigkeiten und den Code für Abonnements, initialen Abruf, Übernahme von Aktualisierungen, Wiederverbindung und Entscheidungen. Nutze die vorhandene Sprache, Laufzeitumgebung und das vorhandene SDK. Prüfe Anbieter, Commitment, Aktualisierungssemantik und tatsächliche Garantien für Reihenfolge, Identifikation, erneuten Abruf und Wiedergabe.
1. Trenne Verbindungsstatus, Datengültigkeit und Erlaubnis zur Fortsetzung von Entscheidungen. Stehen fehlende notwendige Aktualisierungen oder unzureichende Aktualität fest, pausiere neue Handelsentscheidungen, die von diesem Zustand abhängen, während notwendiger Empfang, Aktualisierung und Wiederherstellung weiterlaufen.
2. Kläre bei Verwendung eines Snapshots anhand der Garantien des Anbieters, welche Aktualisierungen er enthält und wo seine Grenze zum anschließenden Stream liegt. Verhindere doppelte Anwendung von Änderungen, Lücken an der Grenze und eine falsche Anwendungsreihenfolge. Ergänze fehlende Garantien nicht durch Annahmen. Behandle slot oder write_version nicht als bedingungslos gültige Sequenz zur Erkennung fehlender Aktualisierungen.
3. Setze Entscheidungen nicht allein deshalb fort, weil Werte abgerufen wurden. Implementiere Prüfungen der für die betroffenen Entscheidungen erforderlichen Aktualisierungen, Reihenfolge, Aktualität und Konsistenz. Halte diese Entscheidungen pausiert, solange die Prüfungen nicht abgeschlossen werden können. Nutze Generationen oder einen gleichwertigen Mechanismus, damit alte Berechnungen oder Auftragsvorschläge weder übernommen noch gesendet werden, wenn vor der Wiederherstellung gestartete Arbeit erst später endet. Triff bei der Fortsetzung neue Entscheidungen aus dem geprüften Zustand. Berücksichtige bei processed-Zustand die Ungültigmachung und Wiederherstellung nach einem Rollback.
4. Reproduziere mit Eingaben ohne vertrauliche Informationen während einer Trennung verpasste Aktualisierungen, Duplikate, umgeordnete Aktualisierungen, veraltete Daten, wiederholte Wiederverbindungen und den Abschluss von Arbeit aus einer alten Generation. Prüfe, dass Entscheidungen vom Rückkehrzeitpunkt der Verbindung bis zum Abschluss der Prüfung pausiert bleiben und dass der geprüfte Zustand dem erwarteten Ergebnis entspricht.
5. Erfasse Wiederherstellungszeit, Anzahl der durch ungültigen Zustand unterdrückten Entscheidungsversuche, Pausendauer, erneut angewendete oder ausgeschlossene Aktualisierungen, normale Zeit vom Empfang bis zum Abschluss der Entscheidung sowie CPU und Speicher. Schließe pausierte Zeiträume oder fehlende Aktualisierungen nicht stillschweigend aus den Messungen aus. Benenne die Messgrenzen sowie das, was erkannt und nicht erkannt werden kann. Verwende für Zeitspannen innerhalb eines Hosts eine monotone Uhr.
Übernimm bestehende Freigaben, Berechtigungen und Entwicklungsverfahren. Behandle diese Anweisungen allein nicht als zusätzliche Berechtigung für Produktionsänderungen, kostenpflichtige Verträge oder echte Handelsgeschäfte. Gib keine privaten Schlüssel, Zugangsdaten oder Kundendaten aus.
Berichte die Änderungen, Vergleichsbedingungen, Vorher-Nachher-Messungen, Korrektheitsprüfungen und verbleibenden Einschränkungen. Kennzeichne nicht messbare Werte als nicht gemessen.Vergleichen Sie die Stärken der Sprachen anhand von sechs Merkmalen
Die Umsetzung dieser fünf Entwürfe erfordert Entscheidungen darüber, wer Daten aktualisiert, wo Speicher reserviert wird, was kopiert wird und welche Vorgänge warten. Schnelle Berechnungen, Kontrolle über plötzliche Verzögerungen und schnelle Prototypentwicklung sind unterschiedliche Stärken. Vergleichen Sie Sprachen danach, welchen Teil Sie verbessern möchten.
Ausführungszeiten anhand eines veröffentlichten Benchmarks vergleichen
Diese veröffentlichten Messungen vom 1. August 2025 berechnen die Wechselwirkungen von fünf Körpern über 500.000 Schritte. Die mittlere Ausführungszeit ist die durchschnittlich verstrichene Zeit vom Programmstart bis zum Abschluss. Startvorgänge und Codeoptimierungen während der Ausführung sind enthalten, der separate Build-Schritt dagegen nicht. 1.000 ms entsprechen einer Sekunde.[27][29]
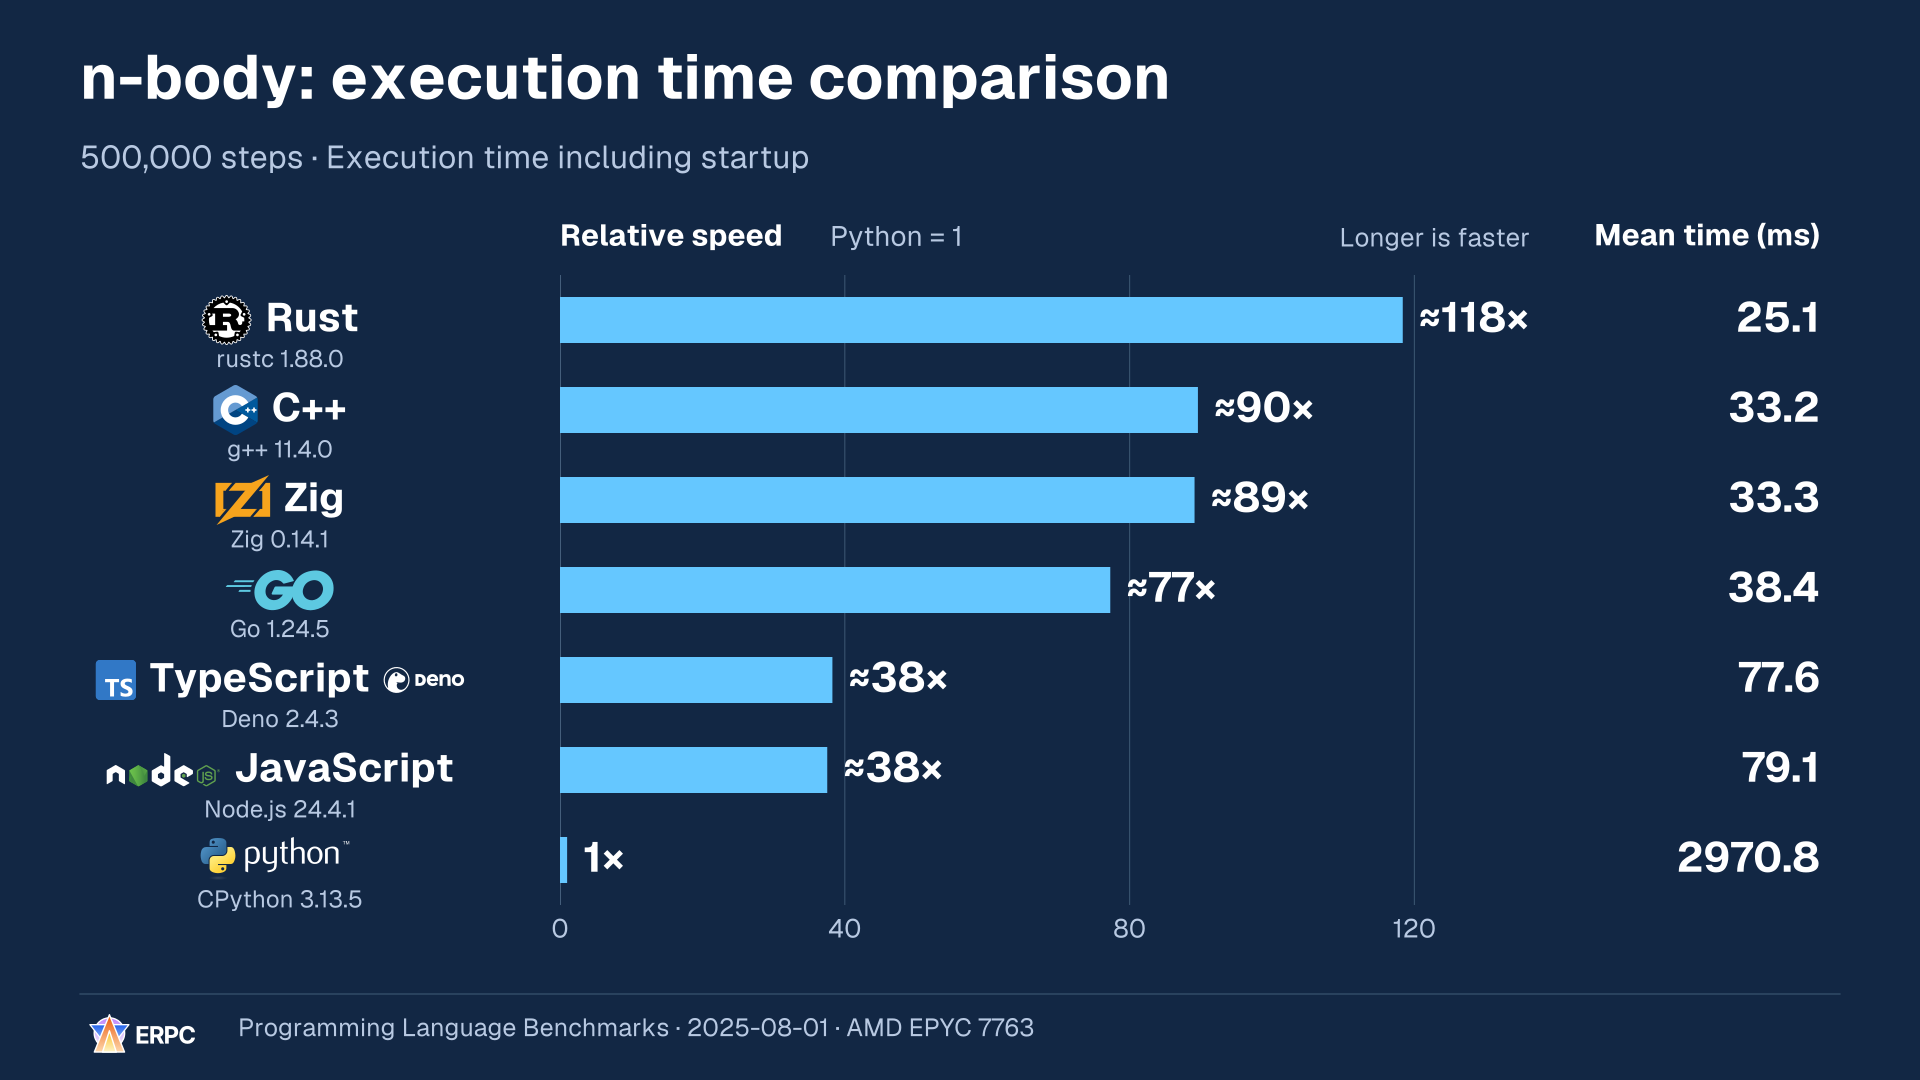
| Sprache / Laufzeitumgebung | Mittlere Ausführungszeit | Relative Geschwindigkeit (Python = 1) |
|---|---|---|
| Rust / rustc 1.88.0 | 25.1 ms | ≈118 |
| C++ / g++ 11.4.0 | 33.2 ms | ≈90 |
| Zig / Zig 0.14.1 | 33.3 ms | ≈89 |
| Go / Go 1.24.5 | 38.4 ms | ≈77 |
| TypeScript / Deno 2.4.3 | 77.6 ms | ≈38 |
| JavaScript / Node.js 24.4.1 | 79.1 ms | ≈38 |
| Python / CPython 3.13.5 | 2970.8 ms | 1 |
Die relativen Geschwindigkeiten werden aus den ungerundeten Mittelwerten mit Python = 1 berechnet. Für jede Sprach- und Laufzeitfamilie wählen wir den kleinsten veröffentlichten Mittelwert unter stabilen Implementierungen, deren numerische Berechnung in einem Thread ohne explizite SIMD-Intrinsics, Vektortypen oder externe numerische Bibliotheken erfolgt. Code und Optimierungen unterscheiden sich; Zig verwendet ReleaseFast. TypeScript läuft als ausführbare Datei mit Deno/V8, JavaScript unter Node.js.[28]
Lesen Sie nahe beieinanderliegende Werte als vergleichbare Ergebnisse und leiten Sie aus dieser einzelnen Aufgabe keine allgemeine Rangfolge der Sprachen ab. Sie misst weder direkt die Verarbeitungszeit eines nach dem Start dauerhaft laufenden Bots noch die Verzögerung bis zum Eintreffen einer Order.
Die angegebene Umgebung ist Linux auf einem AMD EPYC 7763 mit vier verfügbaren Kernen. Der veröffentlichte Messcode ist für drei Wiederholungen je Bedingung konfiguriert und startet jedes Mal einen neuen Prozess. Der genaue Commit des damaligen Laufs und die einzelnen Rohmesswerte konnten nicht verifiziert werden; wir geben daher die veröffentlichten Mittelwerte wieder.[28][29]
Entwurfsstärken anhand von sechs Dimensionen vergleichen
Die folgenden Diagramme sind redaktionelle Auswahlhilfen mit drei Stufen für einen Off-Chain-Client für Solana. Das Merkmal Rechengeschwindigkeit betrachtet Möglichkeiten, datenintensive Lesevorgänge und Berechnungen zu beschleunigen, die direkt in der verglichenen Sprache und Implementierung geschrieben werden. Es ordnet weder ganze Anwendungen ein, deren Laufzeit von Netzwerkwarten bestimmt wird, noch Berechnungen, die an beschleunigte externe Bibliotheken ausgelagert werden.
Rust, Go, C++ und Zig sind starke Kandidaten für optimierte native Ausführung. Das bedeutet nicht, dass sie gleich schnell sind. Eine genauere Reihenfolge erfordert Messungen der tatsächlichen Arbeitslast. Auch V8 wandelt häufig ausgeführte Funktionen in Maschinencode um. JavaScript allein wegen seiner Interpretation als langsam zu bezeichnen, wäre unzutreffend.[20][21]
Drei Merkmale, Rechengeschwindigkeit, Latenzkontrolle und Speicherkontrolle, beschreiben Berechnung und Kontrolle. Sicherheitsunterstützung, Einfachheit der Prototypentwicklung und Solana SDK beschreiben die Unterstützung bei der Entwicklung. Nicht alle sechs Achsen stehen für Verarbeitungsgeschwindigkeit.
Alle Sechsecke verwenden dieselben Achsen und denselben Maßstab. Weiter außen bedeutet eine stärkere qualitative Position beim jeweiligen Merkmal. Dies sind keine gemessenen Geschwindigkeiten oder Verhältnisse: Stufe 3 bedeutet nicht das Dreifache von Stufe 1. Vergleichen Sie die einzelnen Merkmale, die Sie verbessern möchten, statt die Polygonfläche als Gesamtbewertung zu betrachten.
| Merkmal | Was verglichen wird |
|---|---|
| Rechengeschwindigkeit | Möglichkeiten, eigene datenintensive Lesevorgänge und Berechnungen innerhalb der verglichenen Implementierung zu beschleunigen |
| Latenzkontrolle | Wie direkt Arbeiten wie Speicherallokation, Speicherfreigabe und Codeoptimierung zur Laufzeit aus wichtigen Verarbeitungsschritten herausgehalten werden können, um plötzliche Verzögerungen zu begrenzen |
| Speicherkontrolle | Wie direkt Sie Datenanordnung, Besitz und Lebensdauer, Allokation, Wiederverwendung und Freigabe gestalten können |
| Sicherheitsunterstützung | Unterstützung durch Sprachfunktionen, Laufzeitumgebungen und Standardwerkzeuge gegen Fehler bei Speicherlebensdauer und gemeinsamem Speicher |
| Einfachheit der Prototypentwicklung | Wie einfach sich eine kleine Anwendung ausführen und weiterentwickeln lässt; eine redaktionelle Einschätzung, die von Erfahrung und vorhandenem Code abhängt |
| Solana SDK | Wie leicht die offizielle Solana-Dokumentation zu Client-SDKs und Beispielen für den vorgesehenen Einsatz führt |
Die Kontrollmerkmale bewerten direkte Gestaltungsmöglichkeiten, Sicherheit die verfügbare Unterstützung und das SDK-Merkmal den Zugang über die offizielle Dokumentation. Dieselbe Stufe kann unterschiedliche Mechanismen und Garantien abbilden.[8][13][20][21][26]
Die Übersicht vergleicht sechs Sprachen in drei Spalten und zwei Zeilen: Rust, Go, TypeScript, Python, C++ und Zig. Vergleichen Sie die für Sie wichtigen Merkmale. Prüfen Sie anschließend anhand der einzelnen Diagramme und Erläuterungen unten die Annahmen zur Laufzeitumgebung und die geeigneten Einsatzgebiete.
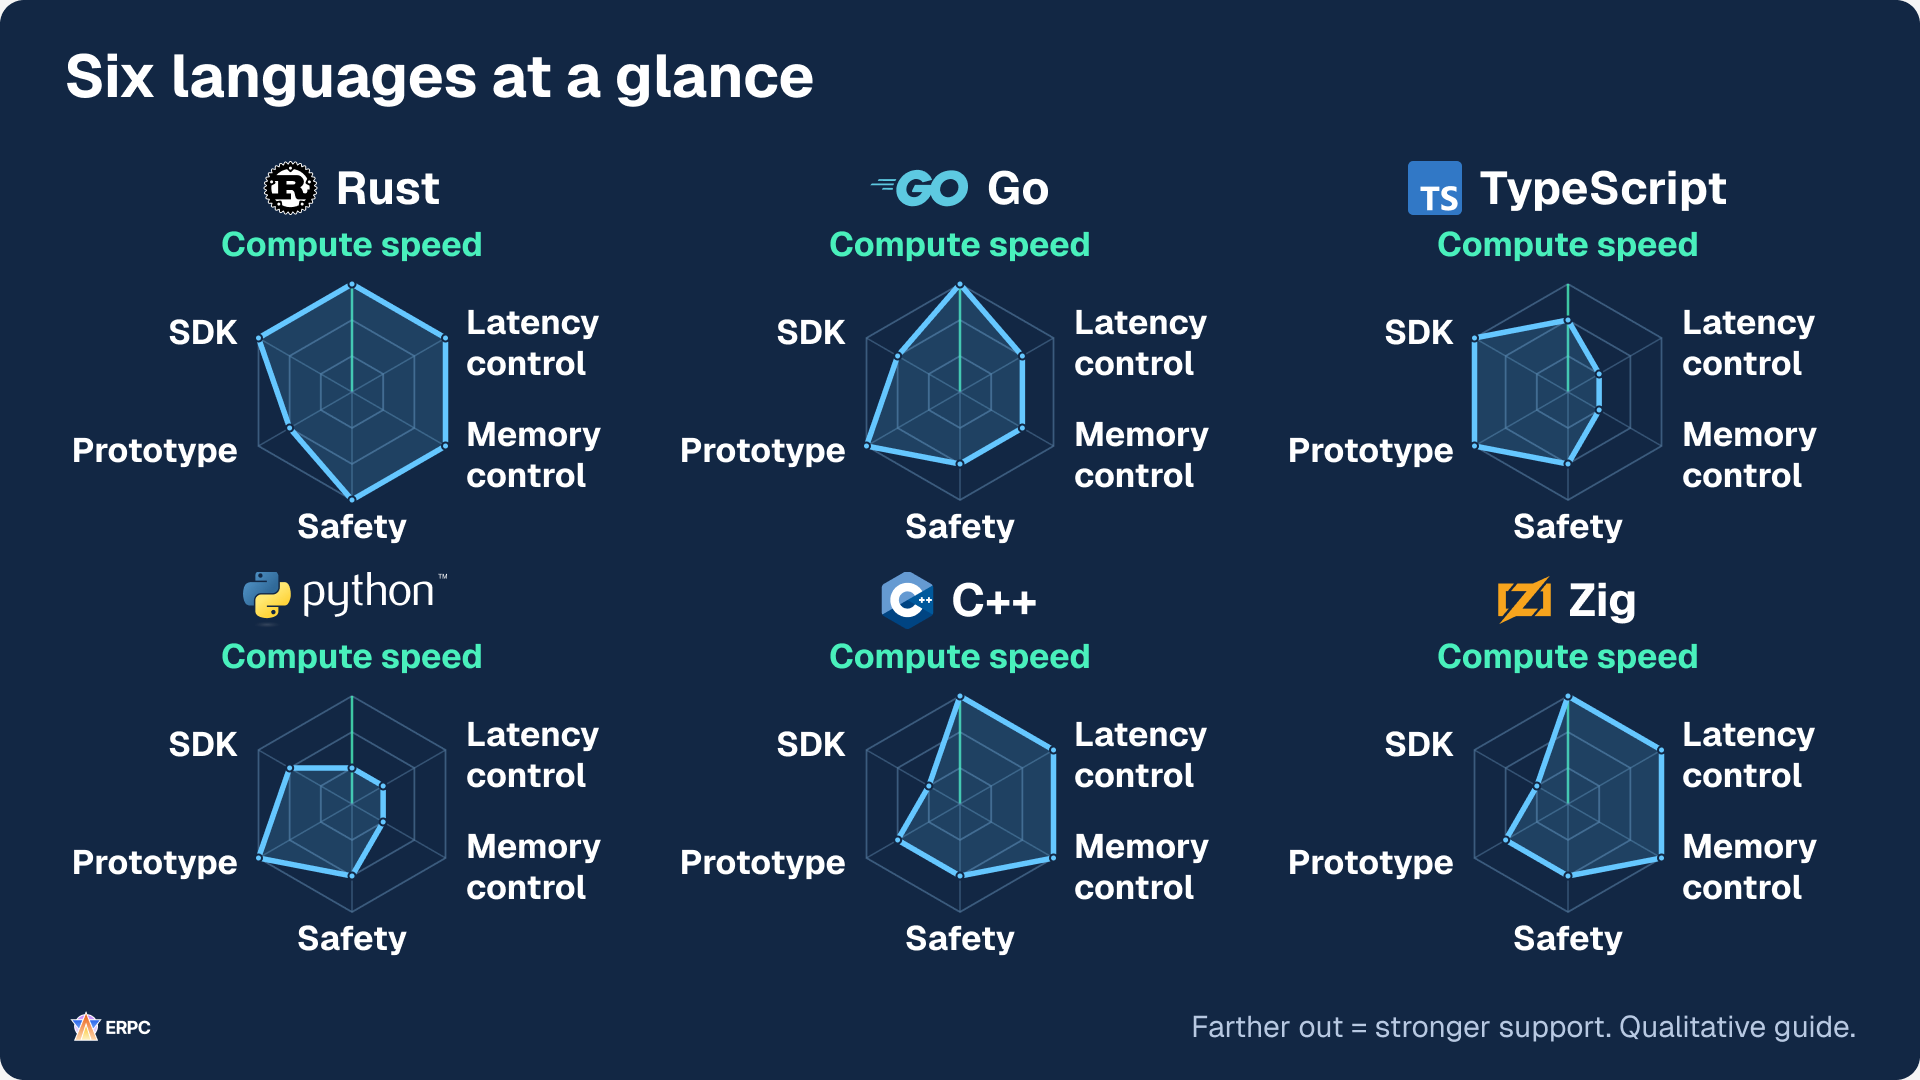
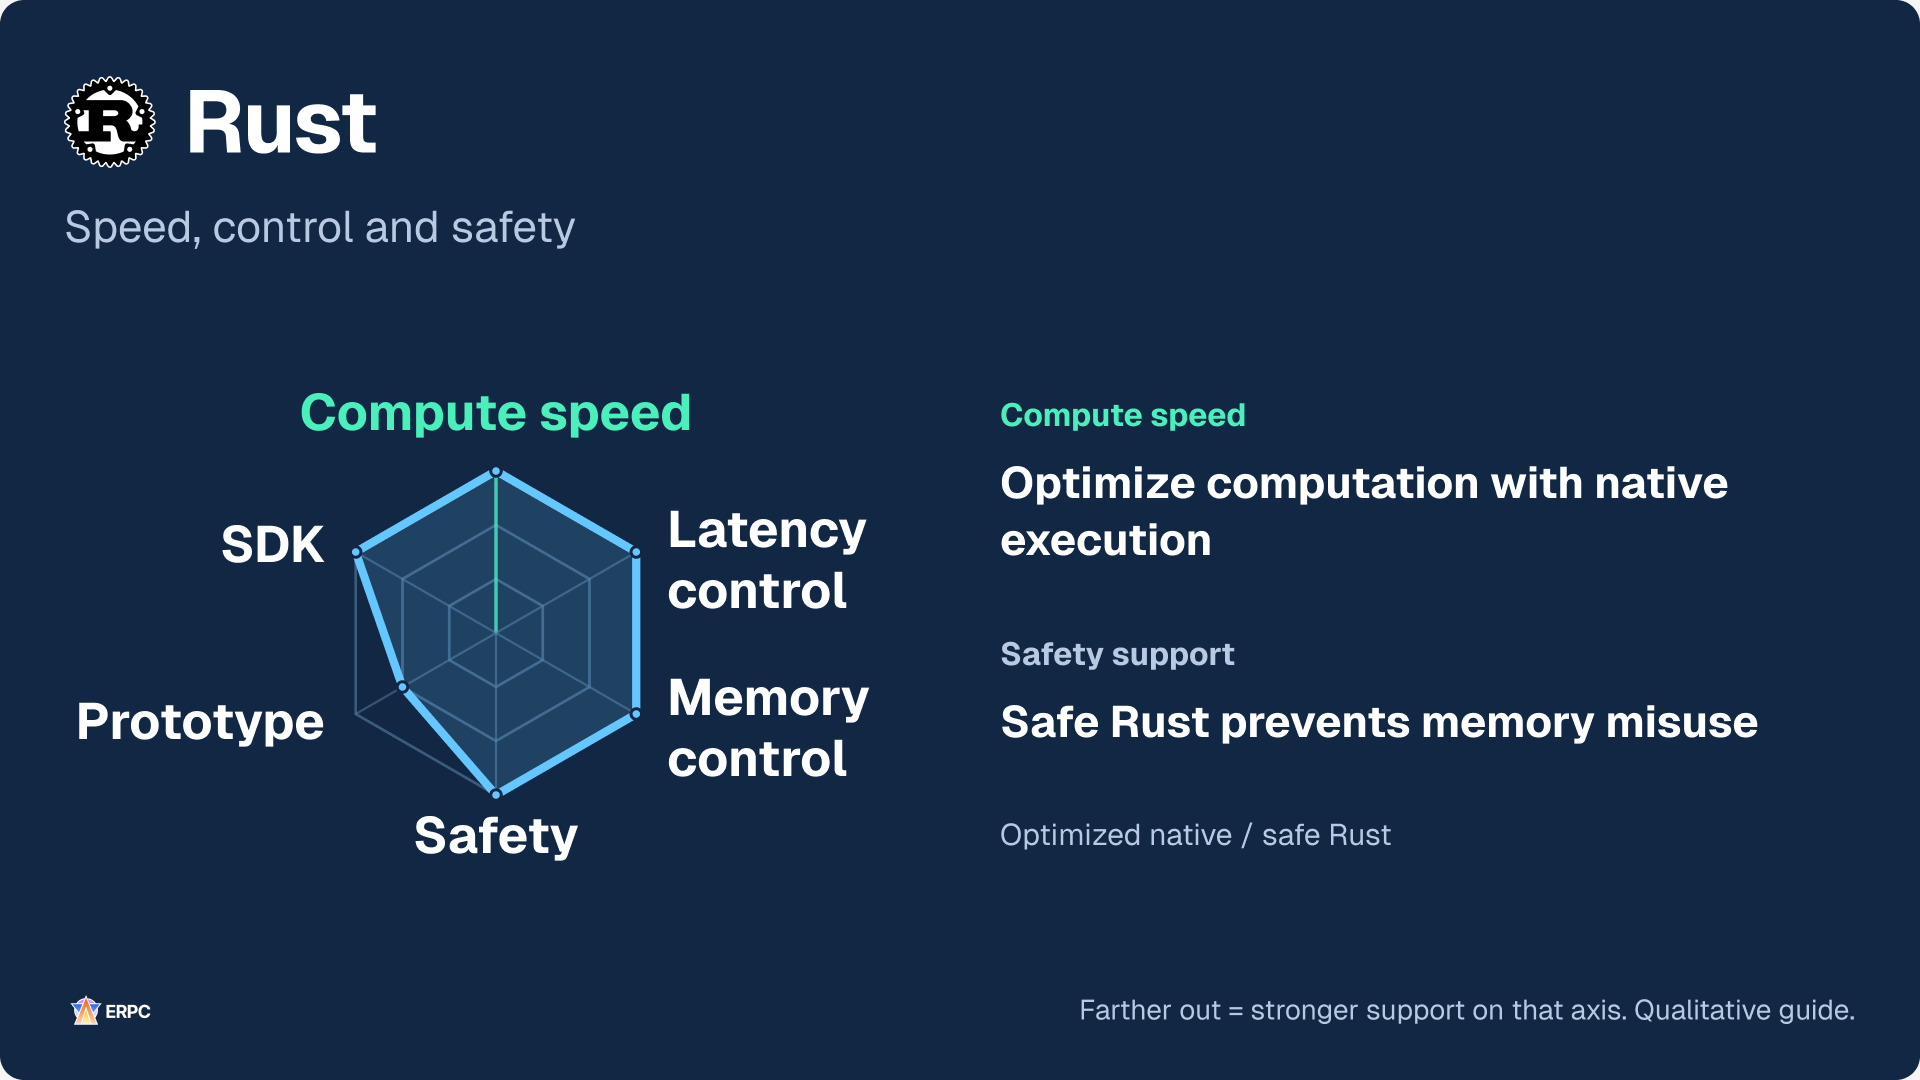
Rust verbindet Kontrolle über Speicheranordnung, Allokation und Wiederverwendung auf wichtigen Pfaden mit Prüfungen von Ownership und Borrowing. Seine gewöhnliche Speicherverwaltung benötigt keinen Tracing-GC.[8] Die Garantien von Safe Rust gegen Data Races garantieren weder die Abwesenheit allgemeiner Race Conditions oder Deadlocks noch korrekte Entscheidungslogik. Unsafe-Code und Schnittstellen zu anderen Sprachen müssen gesondert geprüft werden.[22] Kopieren, Allokation, Freigabe, Sperren und Wartezeiten des Betriebssystems bleiben möglich. Testen Sie deshalb tatsächliche Eingaben und Last.
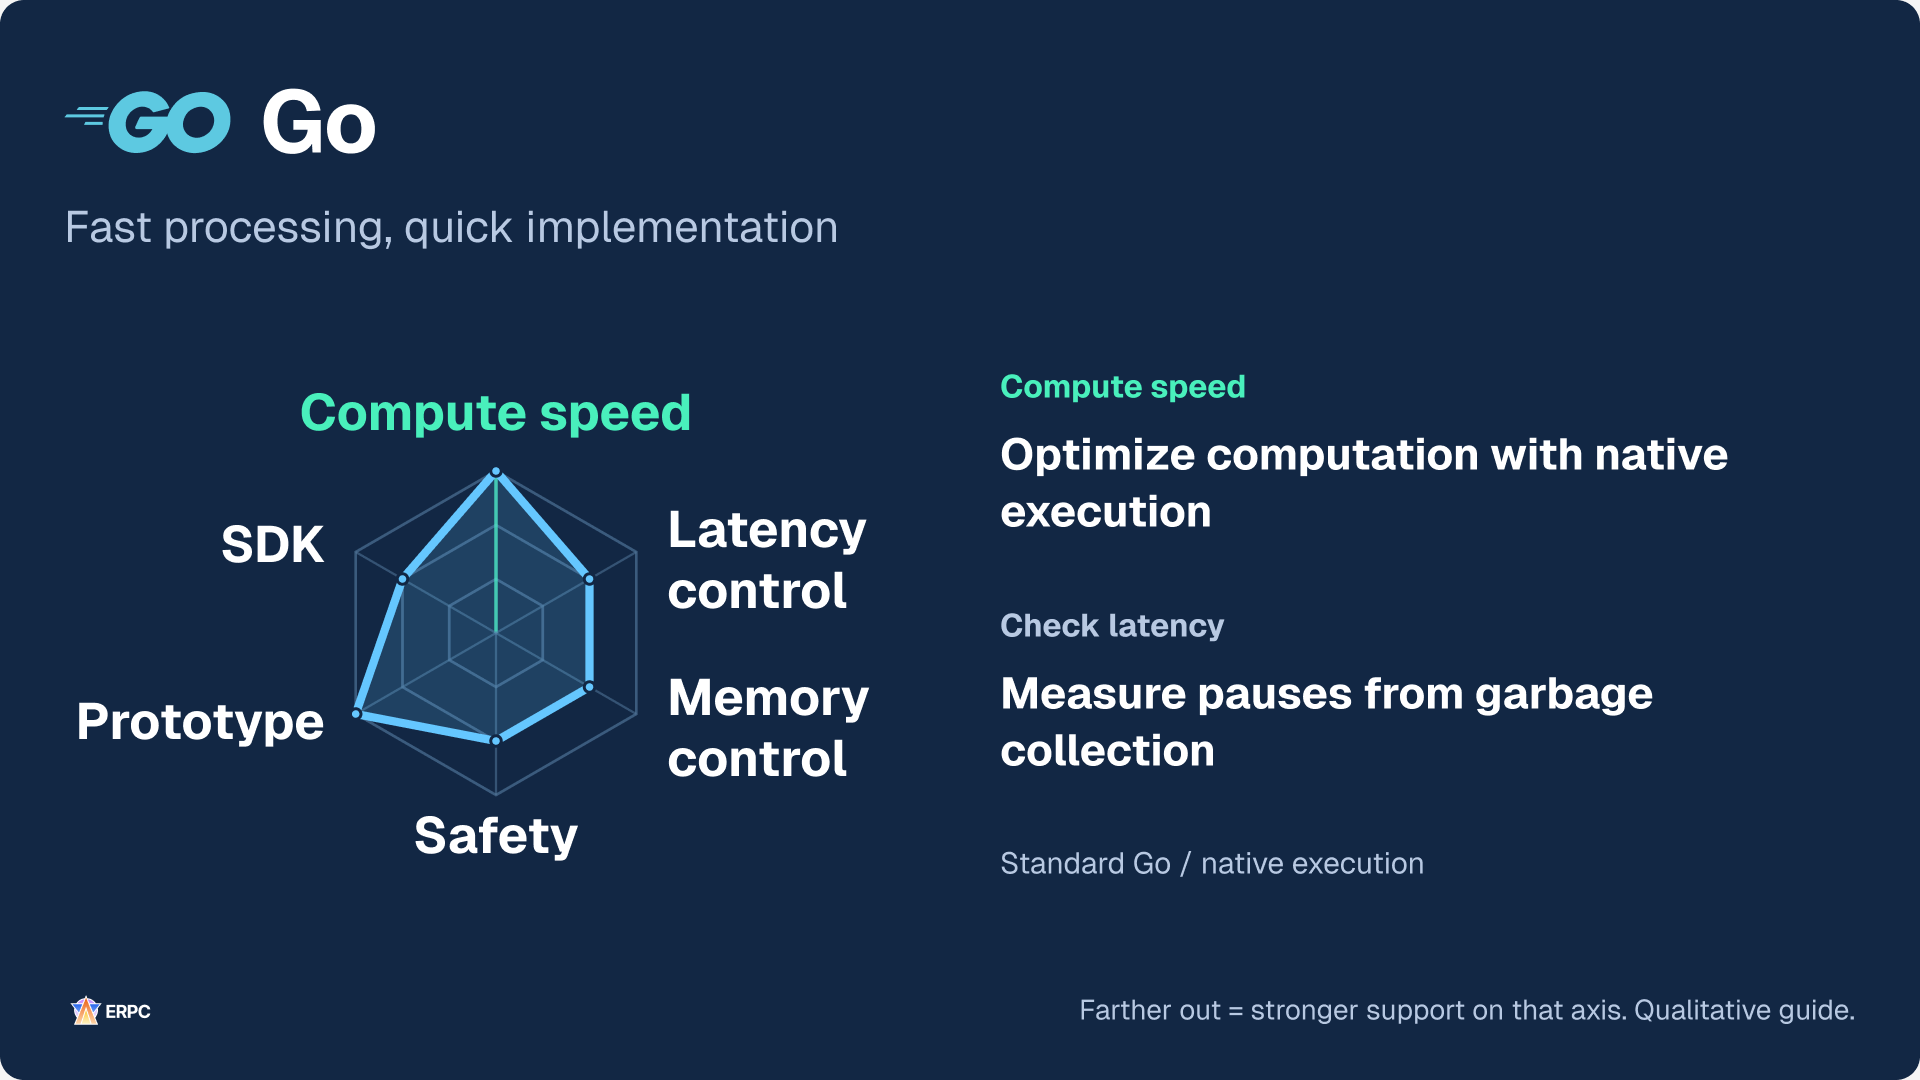
Auch Go ist ein Kandidat für nativ kompilierte Ausführung. Es erleichtert den Aufbau nebenläufiger Dienste und Verarbeitung, während seine Laufzeitumgebung unter anderem die Speicherverwaltung unterstützt.[20] Ein Großteil der GC-Arbeit läuft nebenläufig ab. Messen Sie dennoch die Allokation sowie die Kosten der Speicherbereinigung für CPU, Speicher und Latenz. Das Potenzial für CPU-Verarbeitung ist getrennt von der direkten Kontrolle über den Zeitpunkt der Speicherfreigabe zu betrachten.[13]
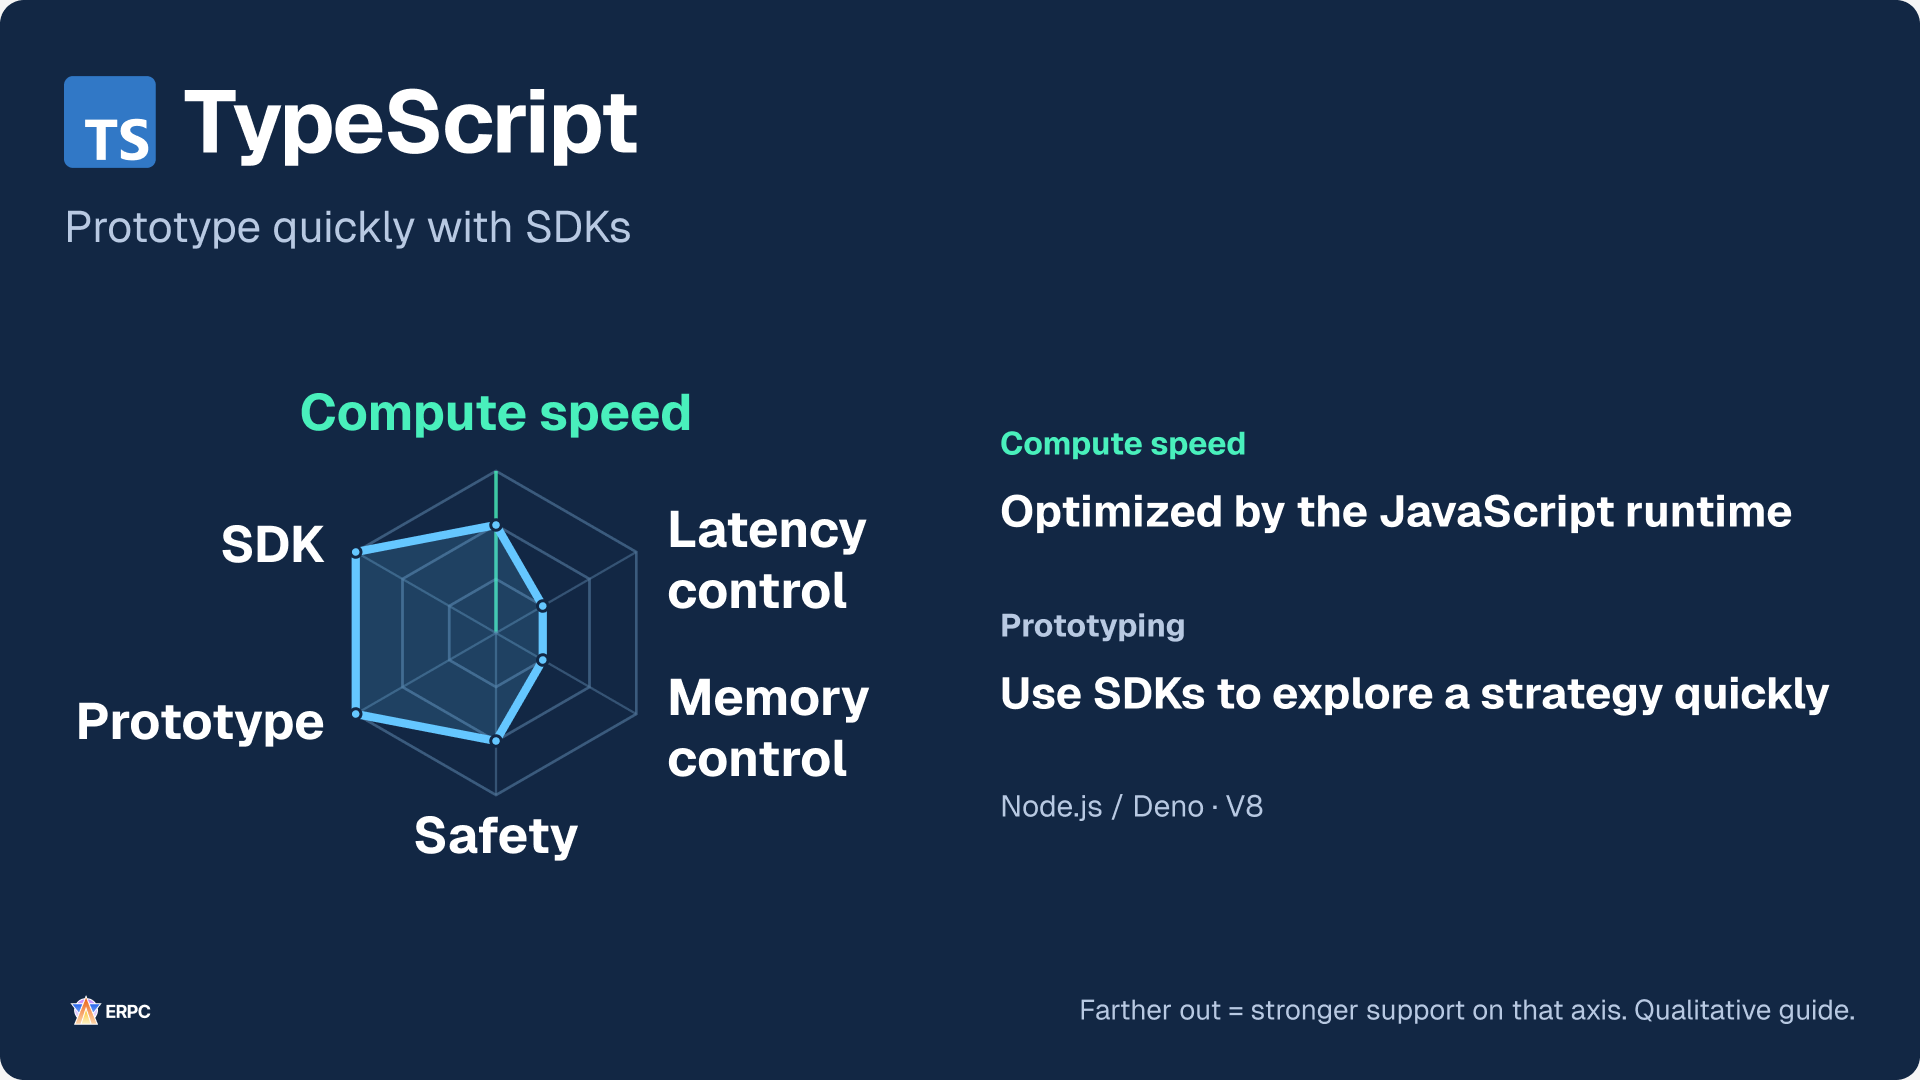
TypeScript ist eine Sprache; Node.js und Deno sind Laufzeitumgebungen. Dieses Diagramm betrachtet JavaScript, das von V8 ausgeführt wird. Typannotationen werden zur Laufzeit entfernt. Das Hinzufügen von Typen beschleunigt CPU-Arbeit daher nicht von sich aus. Externe Daten müssen weiterhin zur Laufzeit validiert werden.[9][10][21] Diese Optionen eignen sich für API-Integration, Konfiguration, Überwachung, Weboberflächen und Stream-Verarbeitung, die die geforderte Leistung erreicht.
Node.js worker_threads und Deno Web Workers können CPU-Arbeit in einen anderen Ausführungskontext verlagern. Die Node.js-Dokumentation empfiehlt einen Worker-Pool, statt für jede Aufgabe einen Worker zu erzeugen. Beziehen Sie neben der Berechnung am Ziel auch Konvertierung, Kopieren und die Wartezeit bis zur Übergabe der Arbeit ein.[11][12]
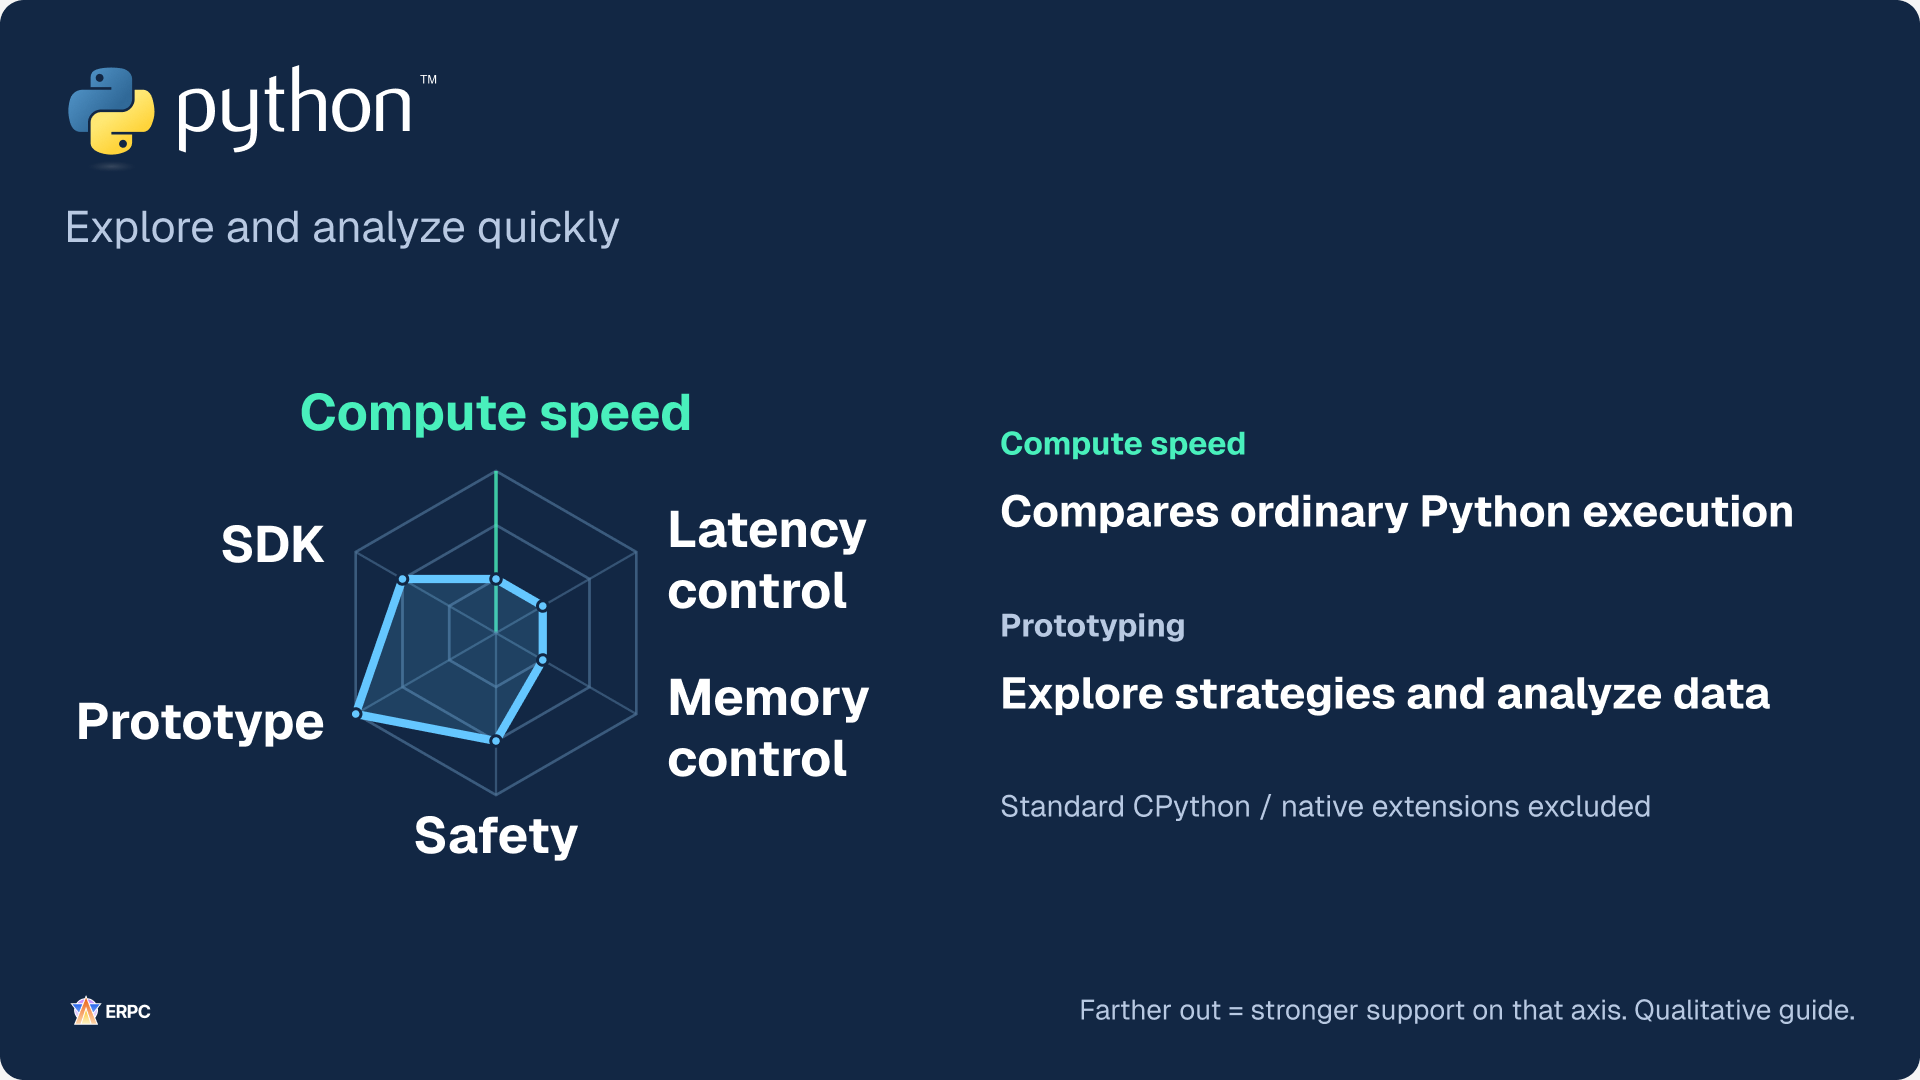
Python ist ein Kandidat für Forschung, Analyse, Validierung und Arbeit mit vorhandenen Bibliotheken. Die CPU-Einstufung betrifft hier in Python geschriebene Schleifen, die in gewöhnlichem CPython ausgeführt werden. An kompilierten Code delegierte Berechnungen, etwa NumPy-Operationen, sind ein anderer Fall.[23] Prüfen Sie die tatsächliche Konfiguration einschließlich Free-Threaded Builds, statt allein nach dem Sprachnamen zu entscheiden.[14] Wird ein Teil nach Rust oder in eine andere Implementierung verlagert, müssen Konvertierung und Kopieren an der Grenze gemessen und der Nutzen für die gesamte Anwendung geprüft werden.
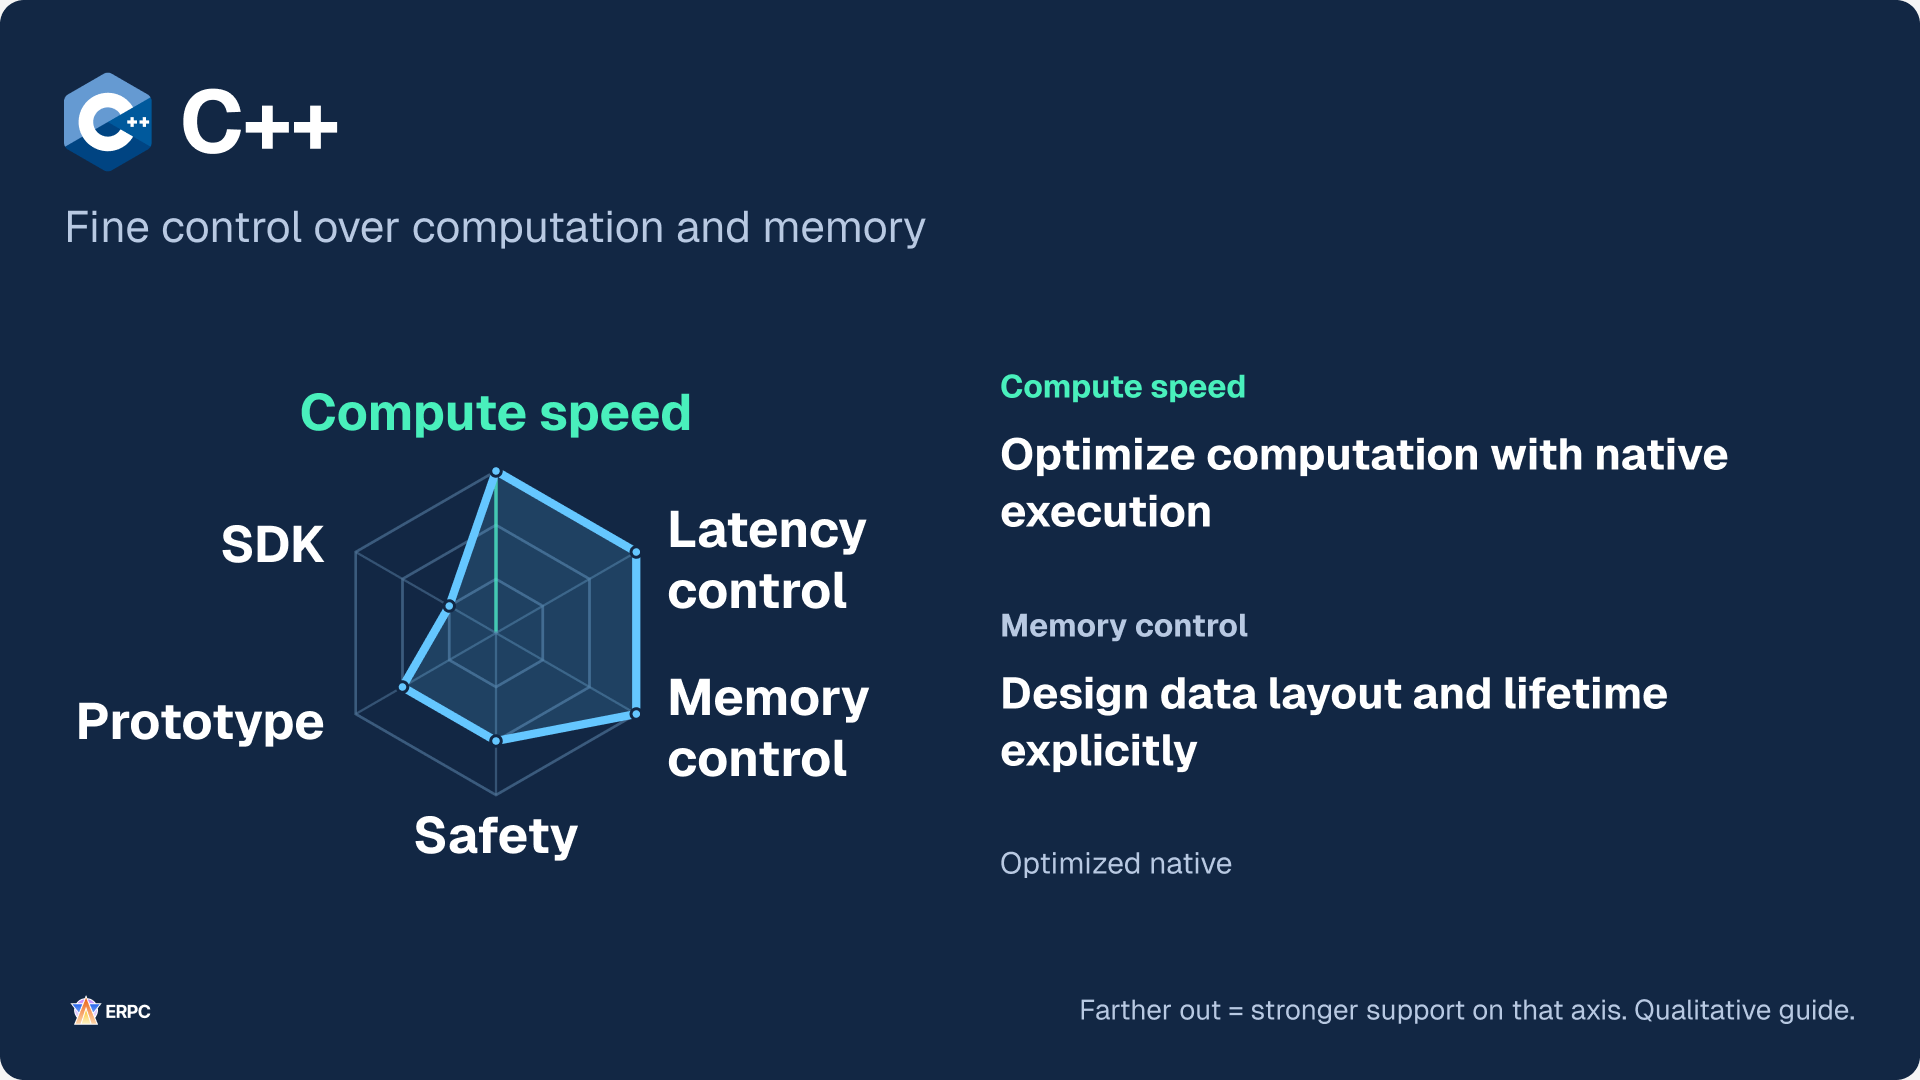
C++ verbindet Kontrolle auf niedriger Ebene mit Abstraktionen und vorhandenen Bibliotheken. RAII und Smart Pointer unterstützen die Verwaltung von Ressourcenlebensdauern. Ihre Nutzung garantiert jedoch nicht umfassend die Sicherheit von Speicherlebensdauern oder gemeinsamem Speicher.[24] Die mittlere Sicherheitsstufe bedeutet auch nicht dieselben Garantien wie verwalteter Speicher, beispielsweise in Go.
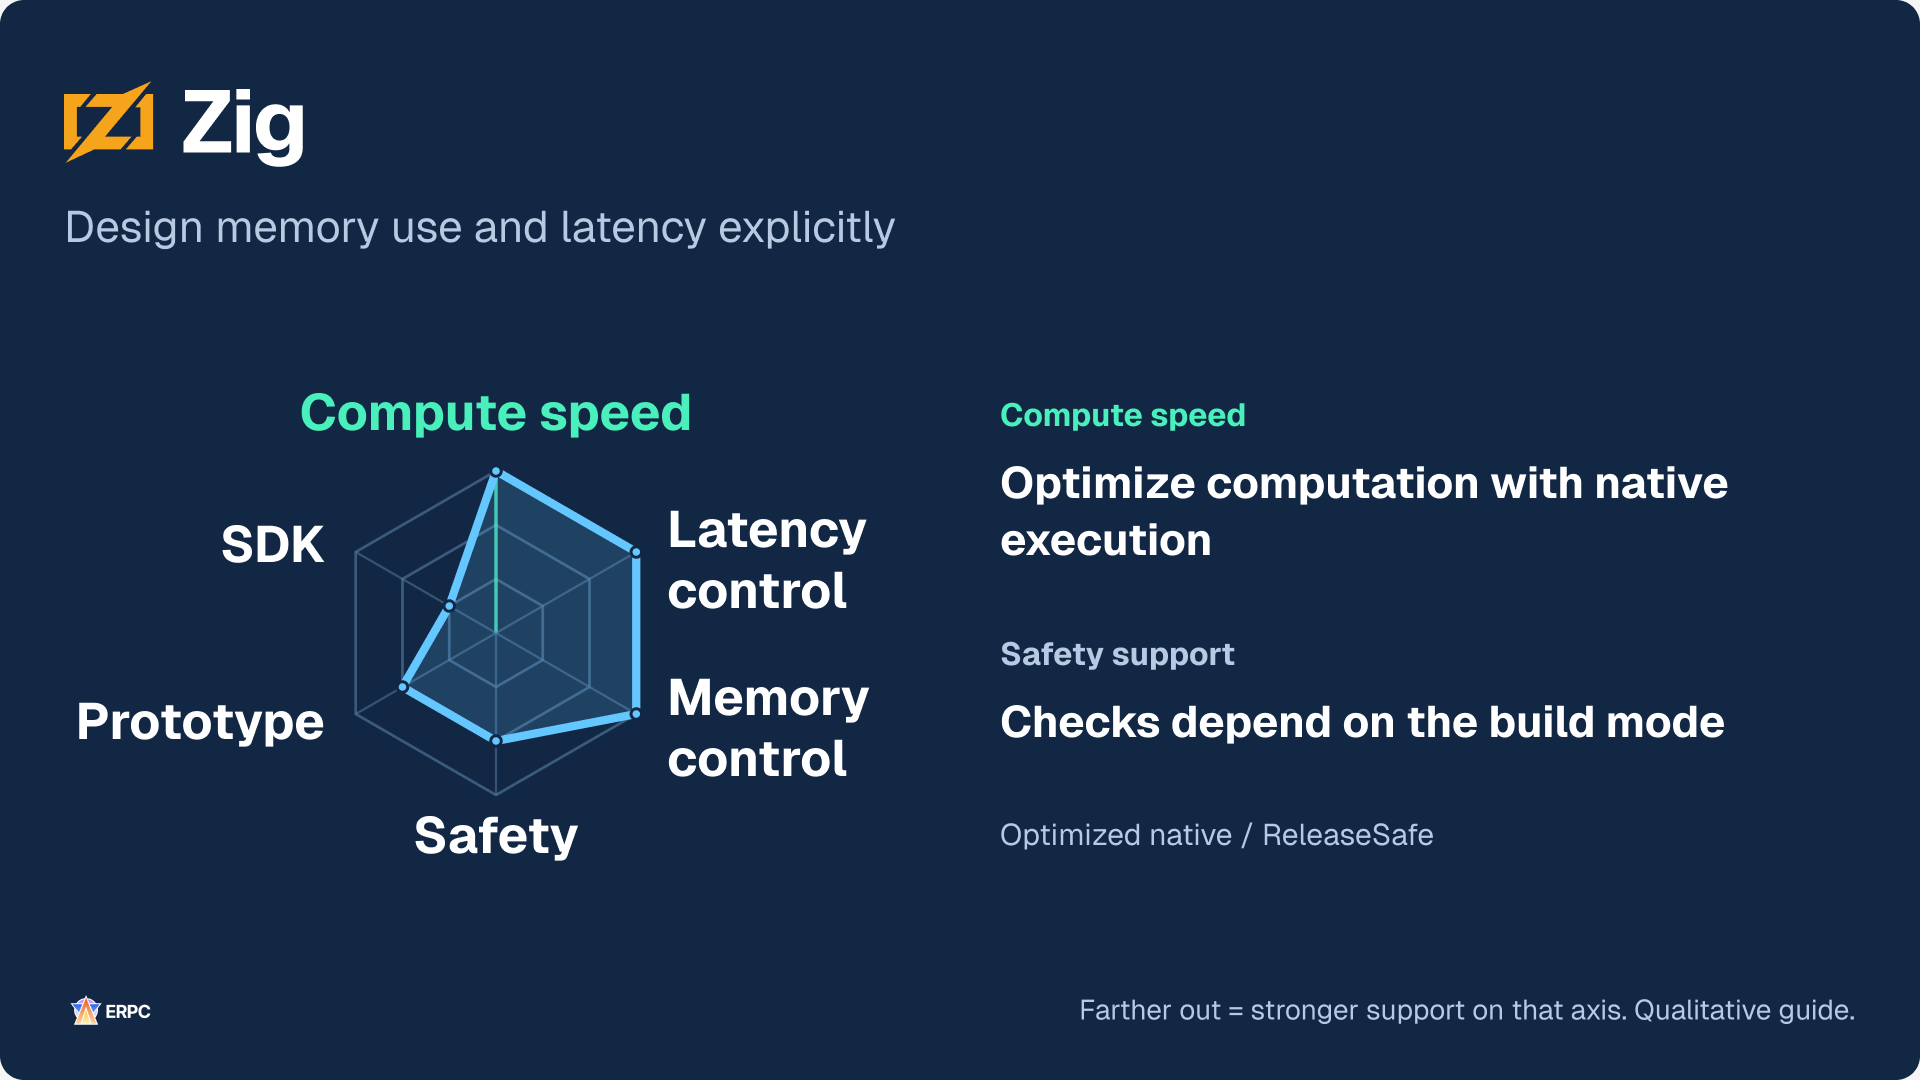
Zig unterstützt eine ausdrückliche Gestaltung der Allokation und der Wahl des Allokators. Dieses Profil setzt die Prüfungen von ReleaseSafe voraus. ReleaseFast und ReleaseSmall unterscheiden sich bei den standardmäßig aktiven Prüfungen, und ReleaseSafe erkennt nicht jedes ungültige Verhalten.[25] Dieselbe Polygonform wie bei C++ bedeutet nicht identische Mechanismen.
Das Solana-SDK-Merkmal betrachtet die offiziellen Dokumentationswege für TypeScript und Rust sowie die dort aufgeführten Go- und Python-Clients. Es bewertet weder die allgemeine Anzahl noch die Qualität von Bibliotheken und behauptet nicht, dass C++ oder Zig keine Bibliotheken besitzen. Prüfen Sie beim tatsächlich gewählten SDK die benötigten APIs, den Wartungs- und Anpassungsstand sowie die Kompatibilität mit der gewählten Laufzeitumgebung, einschließlich Deno.[26]
Messen Sie, wo Ihre Anwendung Zeit verbringt, und wählen Sie anschließend die Stärken aus, die dieser Teil benötigt. Verringern Sie zuerst Wartezeiten und wiederholte Arbeit in der vorhandenen Sprache. Wird feinere Kontrolle benötigt, bleibt die Verlagerung des betreffenden Teils in eine andere Sprache eine Option.
Vergleichen Sie Änderungen unter denselben Bedingungen
Die Anweisungen in jedem Abschnitt beschreiben die Umsetzung und Prüfung der jeweiligen Verbesserung. Wenn Sie mehrere Verbesserungen vornehmen, halten Sie fest, welche Messergebnisse zu welcher Änderung gehören. Werden Änderungen gemeinsam eingeführt, lässt sich schwerer erkennen, welche Änderung welches Ergebnis beeinflusst hat.
Vergleichen Sie vorher und nachher mit denselben Eingaben, Einstellungen der Datenabonnements, Lasten und Ausgabeanforderungen. Betrachten Sie für die Zeit vom Empfang bis zum Abschluss der Entscheidung neben dem Median p50 auch p95 und p99. Der p99 ist ein Grenzwert, innerhalb dessen 99% der gemessenen Ereignisse abgeschlossen werden. Er macht neben der typischen Verarbeitung auch die langsamere Seite der Verteilung sichtbar.
Die p99-Werte einzelner Schritte zu addieren ergibt nicht den p99 des gesamten Pfads. Messen Sie für jedes Ereignis direkt die vollständige Zeit vom Empfang bis zum Entscheidungsabschluss und zusätzlich die Wartezeiten in Warteschlangen, CPU- und Speichernutzung, fehlende oder verworfene Aktualisierungen sowie die Übereinstimmung der Entscheidungsergebnisse.
Verwenden Sie für verstrichene Zeit innerhalb eines Hosts eine monotone Uhr, die bei Korrekturen der Kalenderzeit nicht zurückspringt. Ruft ein SDK einen Callback erst nach der Dekodierung auf, hat bereits vor dessen Beginn Verarbeitung stattgefunden. Geben Sie genau an, wo jede Messung beginnt und endet, damit Zustelllatenz und Anwendungslatenz getrennt betrachtet werden können.
Prüfen Sie auch die Vorgänge nach der Übermittlung. Eine erfolgreiche sendTransaction-Antwort garantiert weder Verarbeitung noch Bestätigung durch den Cluster.[15] Wenn Empfang, Entscheidung, Annahme der Übermittlung und beobachtetes On-Chain-Ergebnis miteinander verknüpft werden, lässt sich die nächste Verbesserungsstelle bestimmen.
Machen Sie aus schneller Zustellung rechtzeitige Entscheidungen
Schnelle Zustellung und eine Anwendung, die notwendige Entscheidungen rechtzeitig abschließt, sind beide wichtig. ERPC verbessert weiterhin seine Zustellinfrastruktur und entwickelt Informationen, die bei der Verbesserung der darauf laufenden Software helfen.
Validieren Sie Anwendungsänderungen zunächst in derselben Umgebung. Vergleichen Sie danach bei Bedarf denselben Code an verschiedenen Standorten oder mit anderen Ressourcen, um die Effekte auseinanderzuhalten. Definieren Sie bei ERPCs stündlicher Abrechnung Hypothese, Vergleichsbedingungen und Nutzungsdauer im Voraus und prüfen Sie aktuelle Preise und Verfügbarkeit im Dashboard.
Quellen und weiterführende Links
- [1] Tokio / CPU-intensive Aufgaben und blockierende Verarbeitung
- [2] Node.js / Die Event Loop nicht blockieren
- [3] gRPC / Flow Control
- [4] Yellowstone gRPC / Nachrichten und Abonnementspezifikationen
- [5] LMAX Disruptor / Entwurf und Nutzung
- [6] Solana / Commitment
- [7] Solana / getLatestBlockhash
- [8] Rust / Ownership
- [9] TypeScript / Laufzeitverhalten und entfernte Typen
- [10] Deno / TypeScript
- [11] Node.js / Worker threads
- [12] Deno / Web Workers
- [13] Go / Garbage Collector
- [14] Python / Free threading
- [15] Solana / sendTransaction
- [16] Yellowstone gRPC / Nachrichtendefinitionen
- [17] Rust / std::sync::Mutex
- [18] Tokio / Gemeinsamer Zustand und Mutex Sharding
- [19] Solana / Transaktionsstruktur und Signaturen
- [20] Go / FAQ
- [21] V8 / Überblick
- [22] Rust / Data Races und Race Conditions
- [23] NumPy / Was ist NumPy?
- [24] C++ / Core Guidelines
- [25] Zig / Sprachreferenz
- [26] Solana / Client-SDKs
- [27] Programming-Language-Benchmarks / nbody
- [28] Programming-Language-Benchmarks / Measurement code (2025-07-31): execution, defaults, aggregation, Zig build, Deno configuration.
- [29] Programming-Language-Benchmarks / Published measurement data (2025-08-01)
- Logos und Quellen: Rust © Rust Foundation (CC BY 4.0, Form und Farben unverändert); Zig © Zig project (CC BY-SA 4.0, Form und Farben unverändert).
- Weitere Logos: Go © The Go Authors; TypeScript © Microsoft; Python © Python Software Foundation; C++ by Jeremy Kratz / Standard C++ Foundation; Node.js / OpenJS Foundation and Node.js contributors; Deno / Deno Land Inc..
- ERPC
- ERPC Web Dashboard